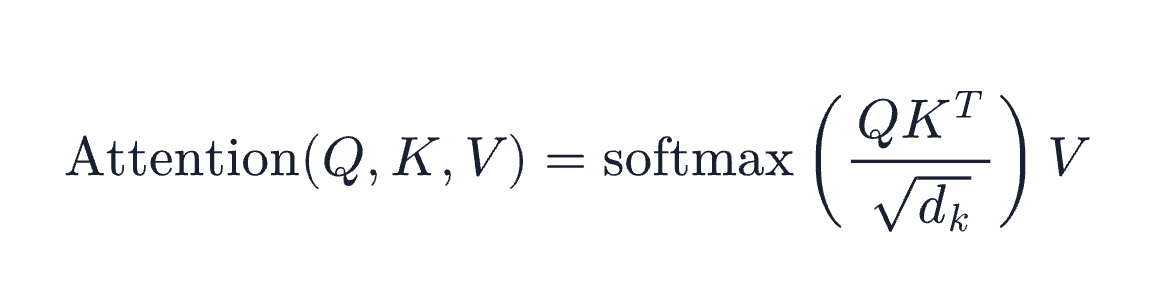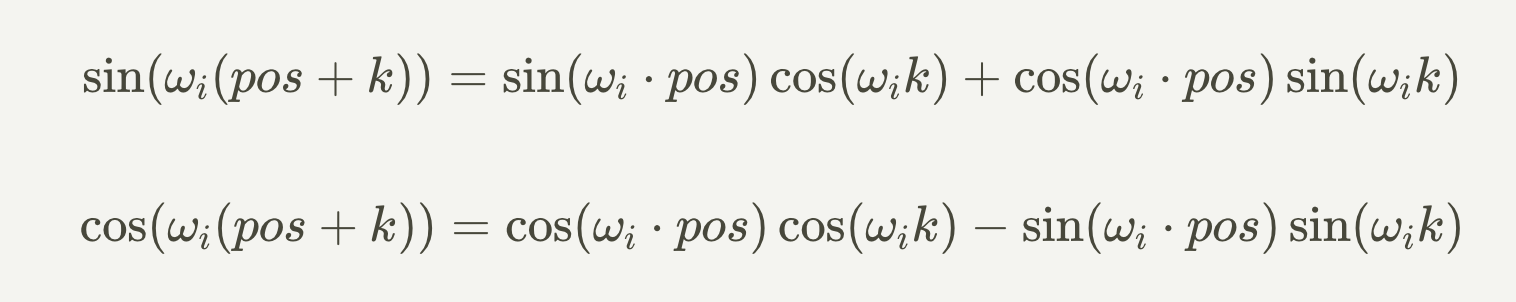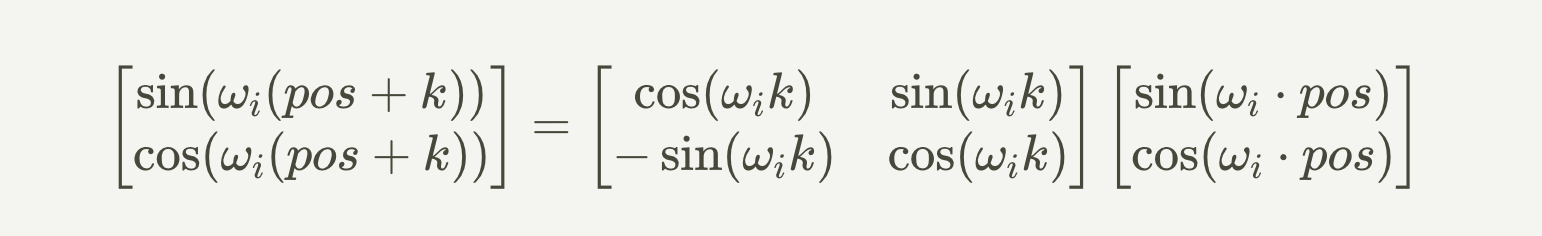Fork me on GitHub

2026年8月

学习大模型推理的 KV Cache

在上一篇中,我们把一次前向传播完整走了一遍:token 先查表变成向量,然后逐层经过 Transformer Block,每层里用 Q、K、V 三个向量做自注意力,最后从词表分布里挑出下一个 token。我们也知道了生成是自回归(Autoregressive)的,也就是一个 token 一个 token 地依次生成,每生成一个新 token 都要跑一次前向。

上一篇的结尾我们留了一个问题:生成第 t 个 token 时,注意力需要用到前 t-1 个 token 的 K 和 V,而这些 K、V 在前面的步骤里其实已经算过了,值也不会变。如果每一步都把整段序列重新跑一遍前向,这些历史 K、V 就被白白重算了无数遍。今天我们就来解决这个问题,主角是大模型推理里最重要的一项优化:KV Cache(键值缓存),也就是把每层每个 token 的 K、V 向量缓存起来,避免重复计算。

从重复计算说起

我们再回忆一下注意力计算的过程:每个 token 的向量经过三个投影矩阵,得到 Query、Key、Value 三个向量。位置 i 的 token 要和它前面的所有位置做注意力,方式是用自己的 Query 去和每个位置的 Key 算相似度,再对 Value 加权求和。

关键在于,有了上一篇讲的因果掩码,位置 i 的表示只由它自己和它前面的 token 决定,后面生成什么内容都影响不到它。所以一个 token 的 K、V 一旦算出来,就是永远不变的常量。

假设 prompt 有 10 个 token,要生成 100 个新 token,每一步的做法是把目前已经有的全部 token 重新送进模型:

  • 第 1 步:输入 10 个 token,算出第 11 个
  • 第 2 步:输入 11 个 token,算出第 12 个
  • 第 3 步:输入 12 个 token,算出第 13 个
  • ……

第 2 步重算了前 10 个 token 的 K、V,第 3 步又重算了前 11 个。越到后面,每一步重算的量越大。生成 n 个 token,总的计算量大体是 1 + 2 + … + n 的累加,也就是 O(n²) 的复杂度。序列一长,这些重复计算就成了推理速度的主要瓶颈。

KV Cache 工作原理

既然历史 token 的 K、V 是不变的,办法就很直接了:算过一次就存下来,后面每一步直接用。

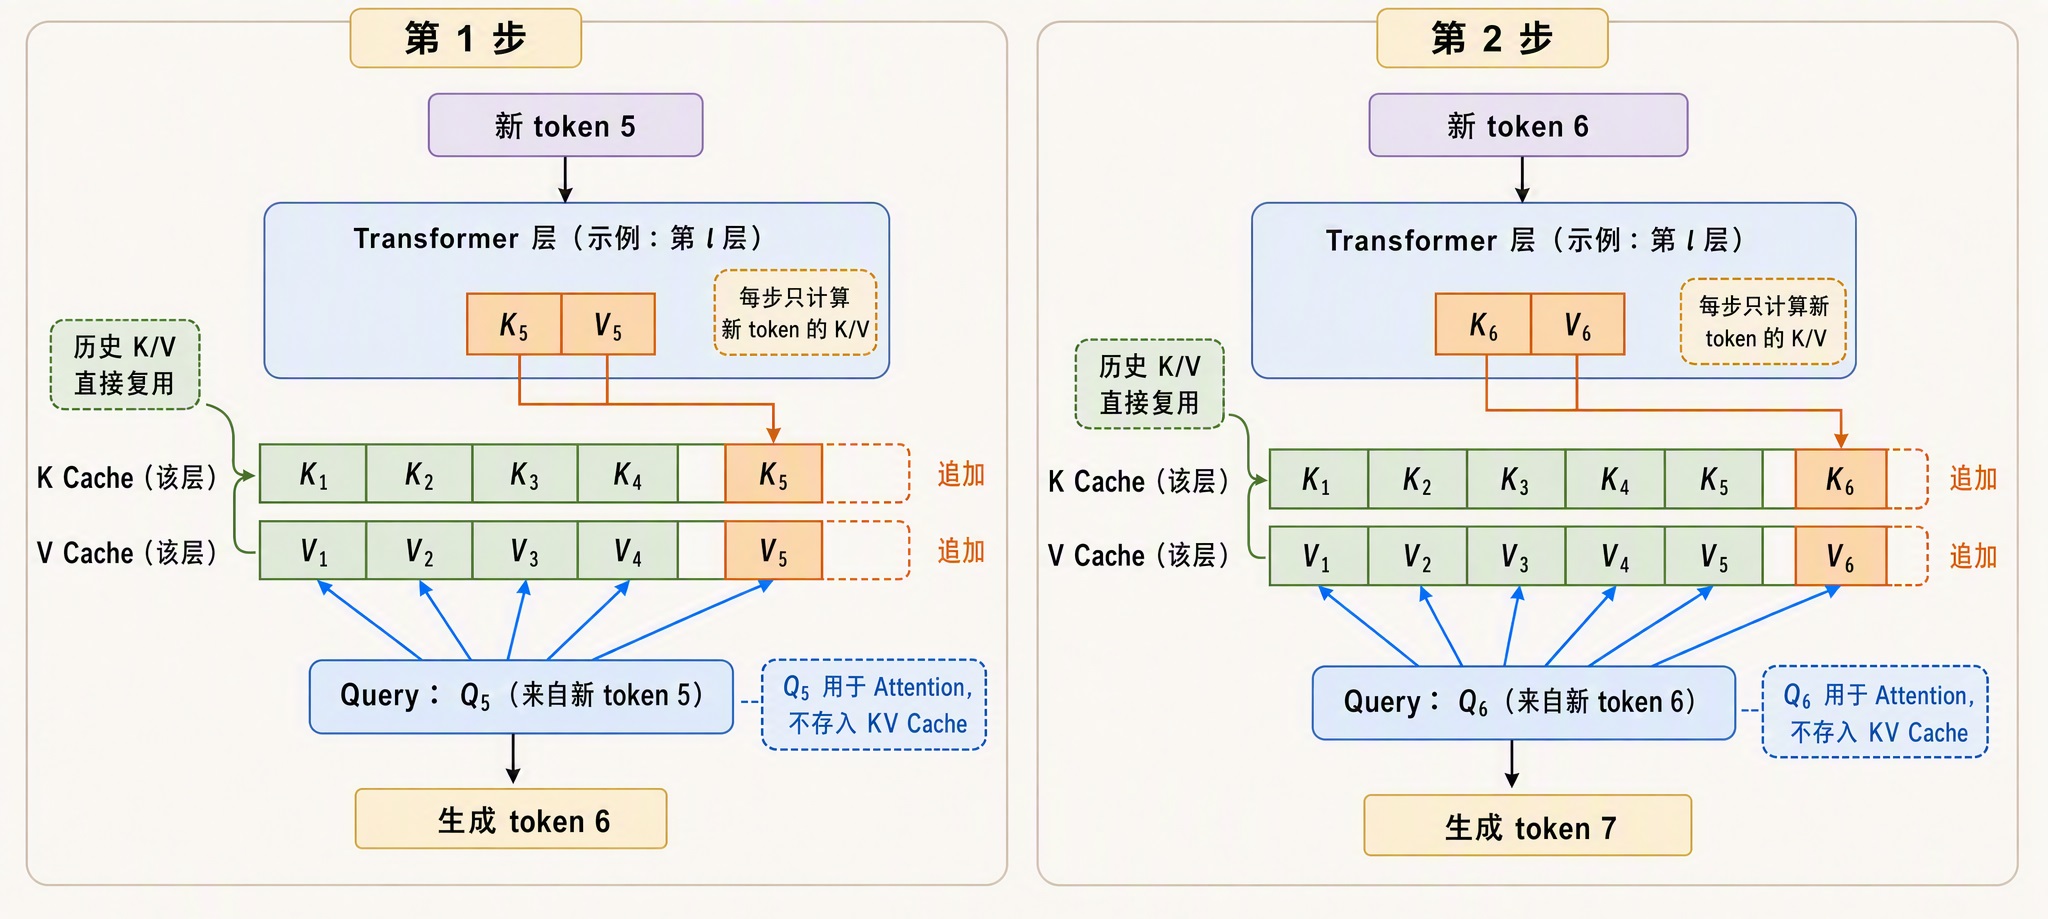
具体来说,每跑一步前向时,把每一层算出的 K、V 向量按 token 顺序追加到一块缓存里。下一步只需要把新生成的这一个 token 送进模型:它经过每一层时,算出自己新的 K、V 追加进缓存,再用自己的 Q 去和缓存里已有的全部 K、V 做注意力。历史 token 的 K、V 一次都不用重算。

逐 token 生成的循环里,缓存的追加过程如下图所示:

kv-cache-append-loop.jpg

有了这个缓存,每一步前向只处理 1 个新 token,生成 n 个 token 的总计算量从 O(n²) 降到了 O(n)。序列越长,省得越多,这也是长文本生成能跑得动的前提。

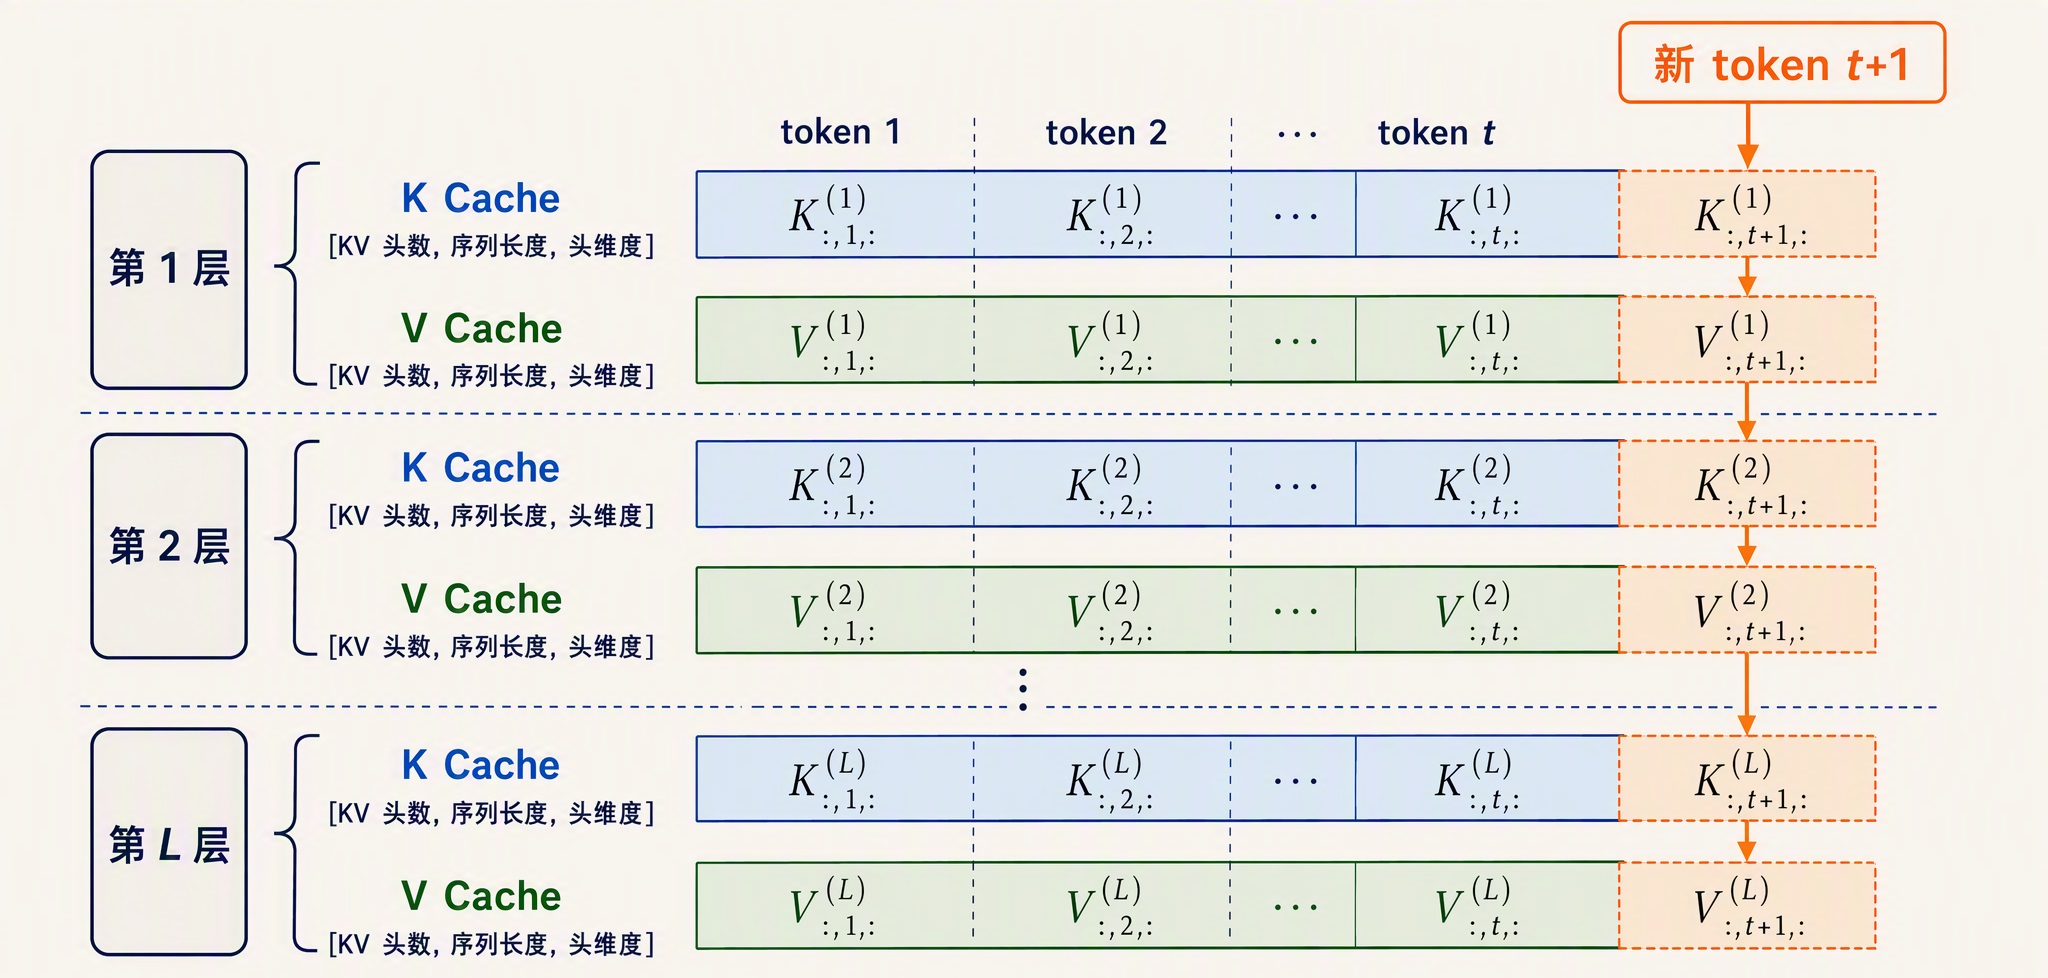
注意缓存是每一层各有一份的。模型有 L 层,就有 L 份 K 缓存和 L 份 V 缓存,每层缓存里按序列顺序存着所有历史 token 在该层的 K、V 向量。

缓存的整体结构如下图所示,每一层都维护着一份随序列增长的 K、V 矩阵:

kv-cache-layer-structure.jpg

可以把这个机制想象成一本笔记本:模型每读一个 token,就在每一层对应的页上记下它的 K、V,后面再提到它时直接翻笔记,不用重新理解一遍。

缓存与不缓存的对比如下:

对比项不用 KV Cache用 KV Cache
每步前向输入全部历史 token仅 1 个新 token
历史 K/V每步重算从缓存直接读
生成 n 个 token 的总计算量O(n²)O(n)
额外显存开销随序列长度线性增长

可以看到,天下没有免费的午餐,计算量省下来了,代价是多了一块不断增长的显存占用。这是典型的以空间换时间

KV Cache 显存占用

KV Cache 的大小可以精确推导。每个 token 在每一层要存一个 K 向量和一个 V 向量,每个向量的大小是 KV 头数乘上头维度。把各部分乘起来,一个请求的 KV Cache 占用为:

KV Cache 字节数 = 2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数

我们逐项解释下:

  • 2:K 和 V 各存一份
  • 层数:每层都有独立的缓存
  • KV 头数 × 头维度:一个 K 或 V 向量的元素个数,比如 32 个头、每头 128 维,就是 4096 个元素
  • 序列长度:prompt 长度加上已生成的 token 数,缓存随它线性增长
  • 每元素字节数:由存储精度决定,FP16(16 位浮点)是 2 字节,FP8 是 1 字节

拿一个 7B 模型为例,32 层、32 个 KV 头、128 头维度、FP16 精度,跑 4096 的上下文,显存占用为:

2 × 32 × 32 × 128 × 4096 × 2 字节 = 2147483648 字节 = 2 GiB

kv-cache-memory-formula.png

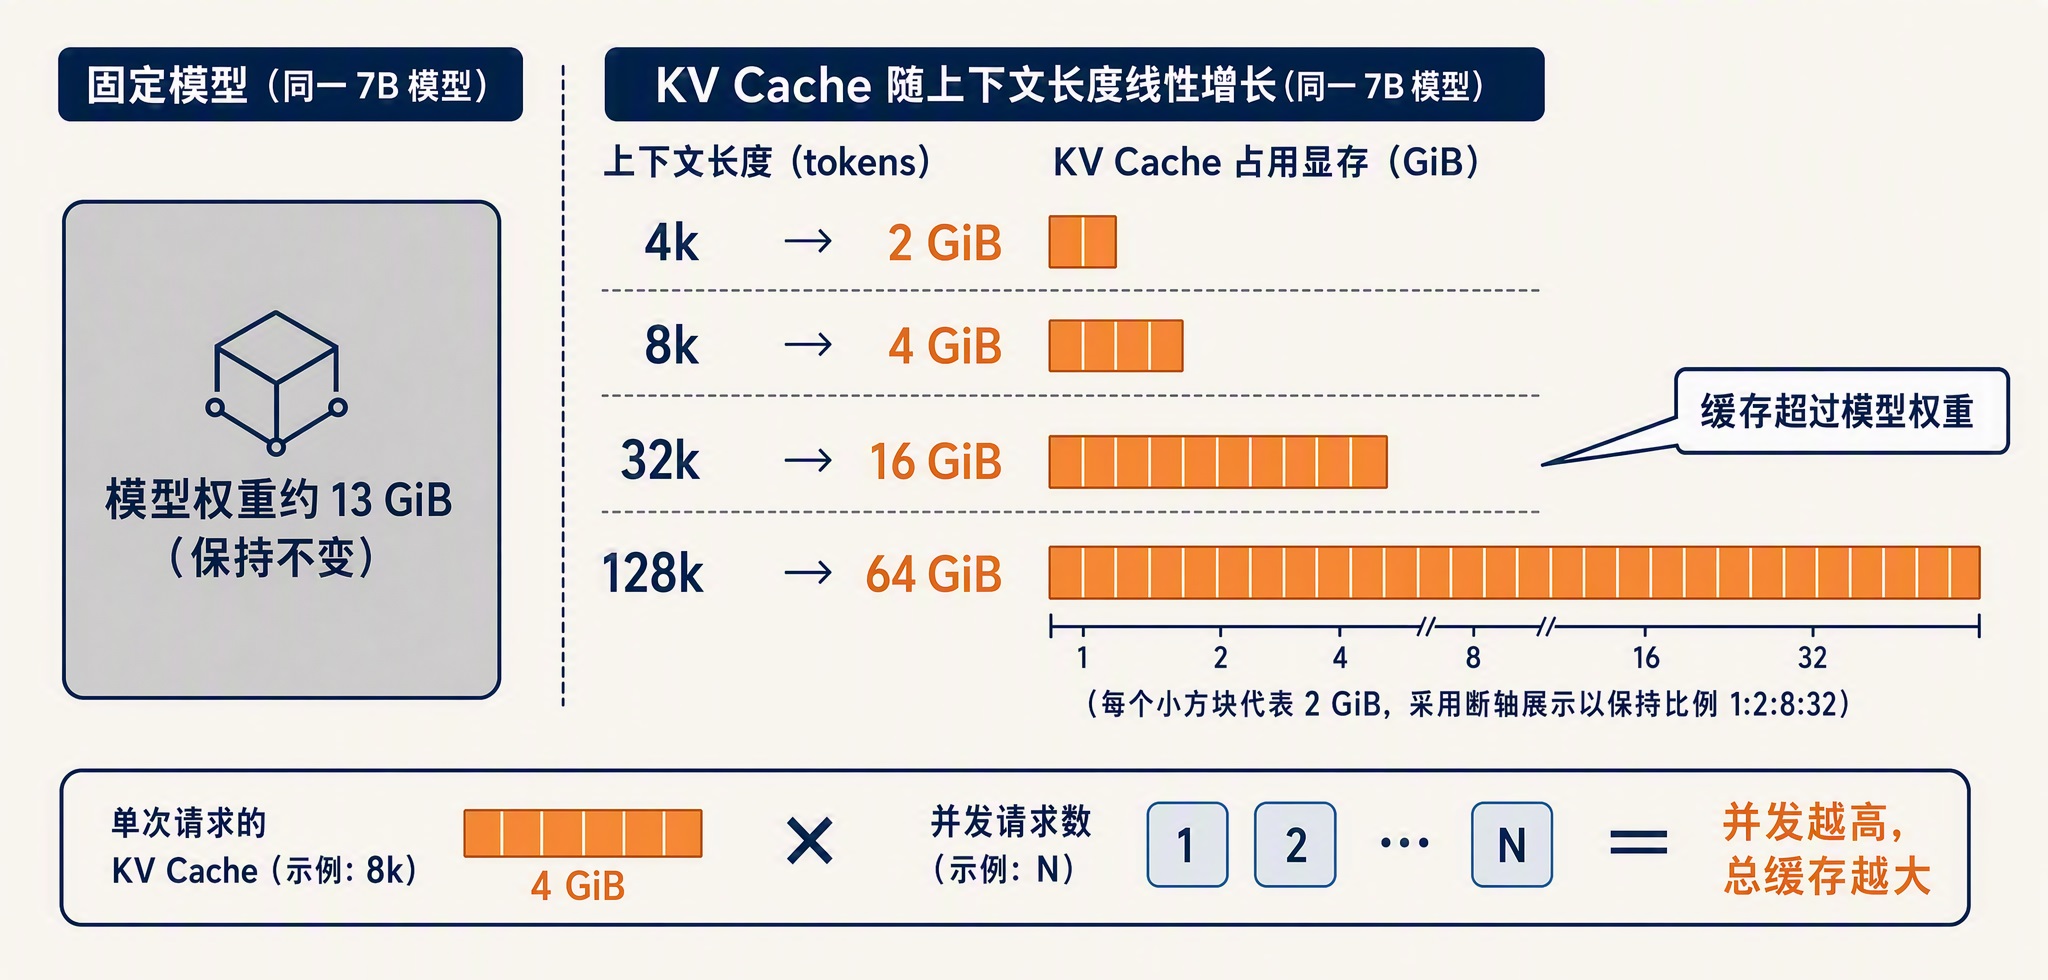
一个请求,光 KV Cache 就要 2 GiB。这个数是什么概念?7B 模型 FP16 的权重本身大约是 13 GiB,也就是说一条 4k 序列的缓存相当于模型权重的七分之一。

缓存随序列长度线性增长,把几个常见上下文长度都代入公式,同一个模型的显存占用是这样的:

上下文长度单请求 KV Cache相当于模型权重(约 13 GiB)
4k2 GiB约 1/7
8k4 GiB约 2/7
32k16 GiB超过权重本身
128k64 GiB近 5 倍权重

32k 上下文时缓存已经比模型权重还大,128k 时是权重的好几倍。

不仅如此,还有两个放大因素。一是这个公式是单个请求的账,服务端同时处理多少个并发请求,缓存总量就乘多少。二是序列长度在生成过程中一直涨,prompt 4k 不代表缓存停在 4k 对应的大小,生成的每个 token 都在往里追加。

下面这张图直观地画出了缓存随上下文长度的增长:

kv-cache-memory-growth.jpg

现在可以理解为什么长上下文的服务成本高了。上下文窗口从 4k 扩到 128k,模型本身没变,但每个请求的 KV Cache 膨胀了 32 倍。显存就那么多,缓存吃得越多,能同时容纳的并发请求就越少,服务的吞吐和成本都直接受影响。KV Cache 也因此成了推理时显存占用的大头。

给 KV Cache 瘦身

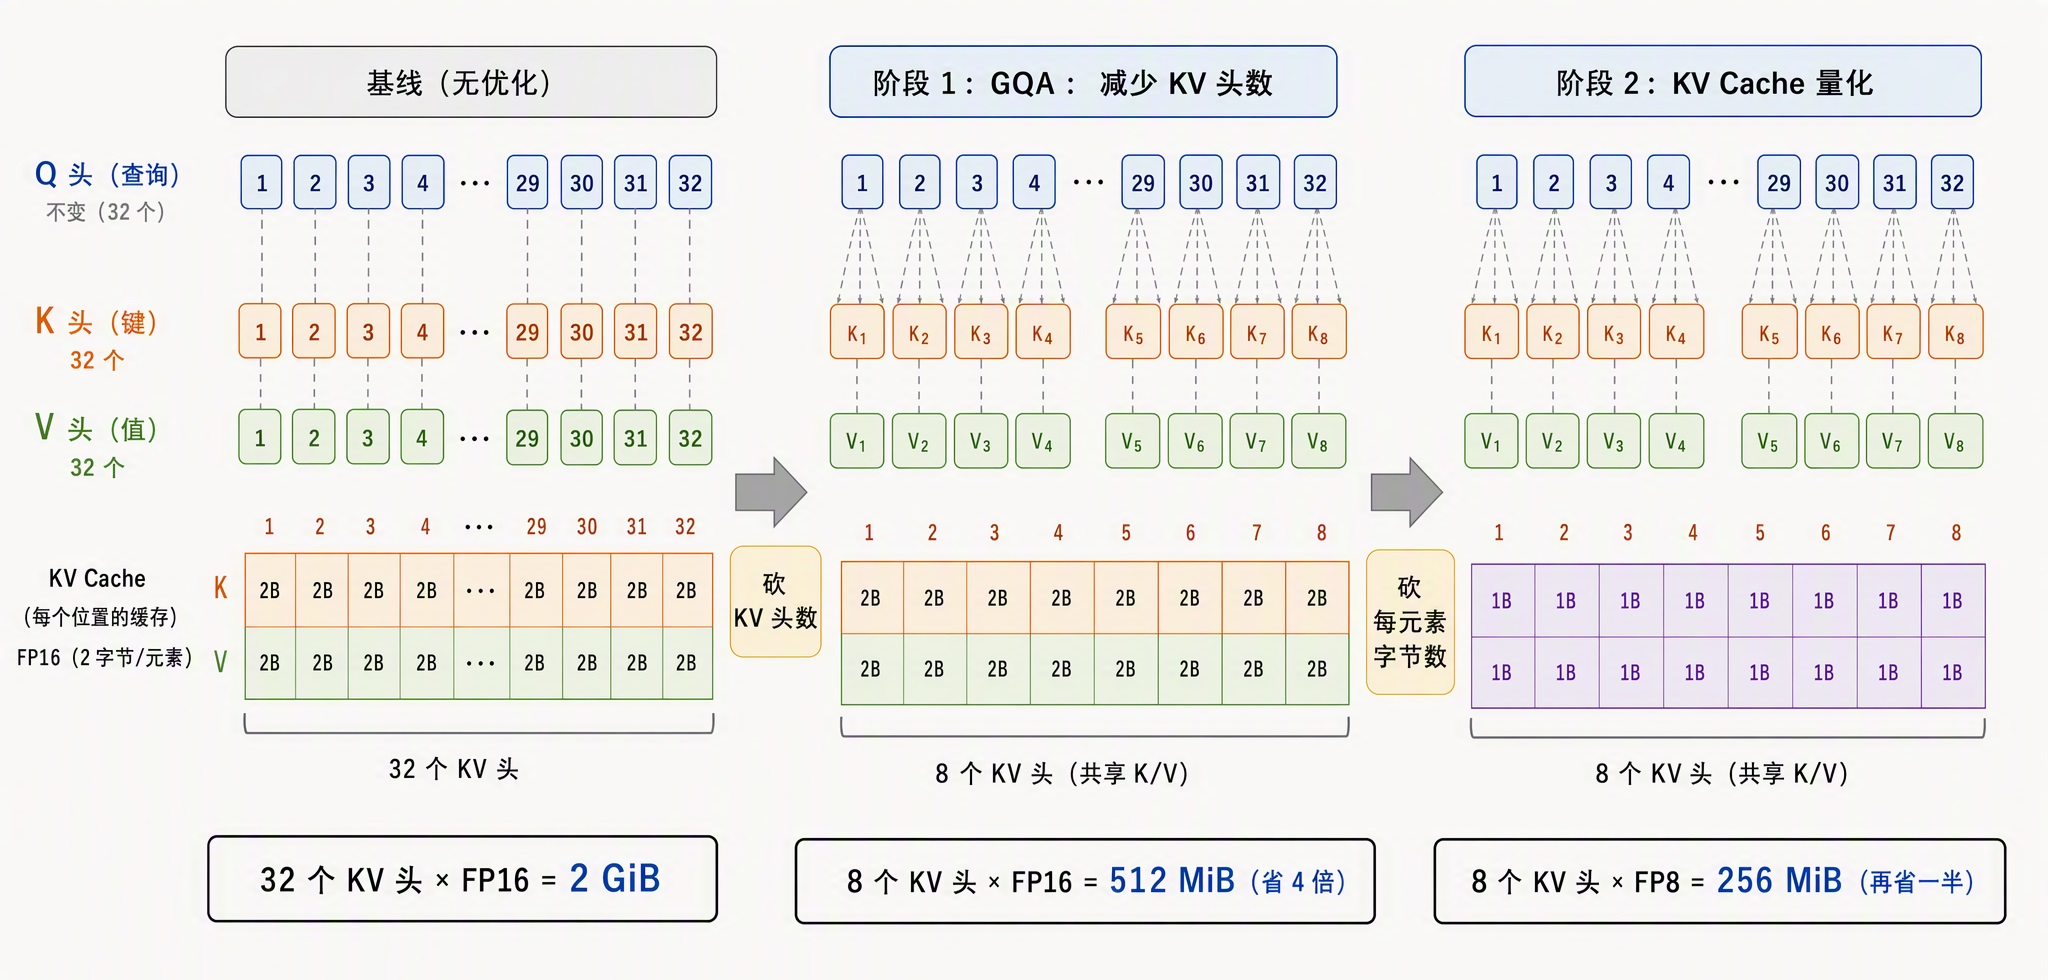
既然显存紧张,自然就有人想办法压缩 KV Cache。看公式的各个因子,有两条路最直接。

第一条是砍 KV 头数,这就是上一篇讲过的 GQA(Grouped-Query Attention,分组查询注意力)。标准的多头注意力里每个 Q 头配一个独立的 KV 头,GQA 让多个 Q 头共享一组 K、V,KV 头数就降下来了。还是上面那个 7B 模型,如果把 KV 头数从 32 砍到 8,其他不变,KV Cache 直接省 4 倍,4k 上下文从 2 GiB 降到 512 MiB。这也是现在主流开源模型(Llama 3、Qwen3、Gemma 等)几乎清一色用 GQA 的原因,它用很小的效果损失换来缓存的大幅缩水。GQA 出自 Google 2023 年的 GQA 论文,感兴趣的同学可以翻一翻。

第二条是砍 每元素字节数,也就是给 KV Cache 做量化。权重可以量化,缓存同样可以:从 FP16 降到 FP8 或 INT8,每个元素从 2 字节变 1 字节,缓存再省一半。两条路叠加,32 头变 8 头再乘上 FP8,缓存能压到原来的八分之一。transformers 的官方文档里就有量化缓存(Quantized Cache)的用法,vLLM 也支持 FP8 的 KV Cache。

kv-cache-compression.jpg

除了这两条路,还有滑动窗口(只保留最近的一段缓存)、跨层共享缓存等更激进的方案,核心思想都一样:缓存里的信息有冗余,不必全量精确保留。

实战 KV Cache

概念讲完,我们亲手跑一下,看看缓存长什么样。用 Hugging Face transformers 加载一个小模型 Qwen3-0.6B,它的配置是 28 层、8 个 KV 头、128 头维度,正好是个 GQA 模型。

transformers 的前向接口有个 use_cache 参数,打开后模型的输出里会带上 past_key_values,这就是 KV Cache。新版 transformers 把它封装成了 DynamicCache 对象,第 i 层的 K、V 分别通过 layers[i].keyslayers[i].values 访问。我们先对 prompt 做一次完整前向,再拿生成的新 token 做一次增量前向,对比两次缓存的形状:

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, dtype="auto")

prompt = "The quick brown fox"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# 第一次前向:处理完整 prompt
with torch.no_grad():
    out1 = model(**inputs, use_cache=True)
past1 = out1.past_key_values
print("缓存层数:", len(past1))
print("第 0 层 K 形状:", past1.layers[0].keys.shape)
print("第 0 层 V 形状:", past1.layers[0].values.shape)

# 第二次前向:只输入新 token,带上已有缓存
next_token = torch.argmax(out1.logits[0, -1, :]).reshape(1, 1)
with torch.no_grad():
    out2 = model(next_token, past_key_values=past1, use_cache=True)
past2 = out2.past_key_values
print("第二次前向后第 0 层 K 形状:", past2.layers[0].keys.shape)
print("第二次前向后第 0 层 V 形状:", past2.layers[0].values.shape)

运行结果如下:

缓存层数: 28
第 0 层 K 形状: torch.Size([1, 8, 4, 128])
第 0 层 V 形状: torch.Size([1, 8, 4, 128])
第二次前向后第 0 层 K 形状: torch.Size([1, 8, 5, 128])
第二次前向后第 0 层 V 形状: torch.Size([1, 8, 5, 128])

可以看到几个和理论完全对应的点:

  1. 缓存有 28 份:和模型的层数一致,每层独立存自己的 K、V
  2. 每层形状是 [batch, KV 头数, 序列长度, 头维度]:Qwen3-0.6B 是 8 个 KV 头、128 头维度,prompt 切成了 4 个 token,所以是 [1, 8, 4, 128]
  3. 第二次前向只输入了 1 个 token,但缓存从 4 涨到了 5:新 token 的 K、V 被追加到了历史缓存后面,注意力是在完整的 5 个 token 上算的

对照前面的显存公式,Qwen3-0.6B 每个 token 的缓存是 2 × 28 × 8 × 128 × 2 字节,约 112 KB,4k 上下文大约 448 MiB。

细心的读者会注意到,第一次前向和第二次前向有个明显的不对称:第一次一次性处理了 prompt 的全部 4 个 token,往缓存里写了 4 份 K、V;第二次只处理 1 个 token,缓存只涨了 1 格。这正是第一篇讲过的 Prefill 和 Decode 两个阶段:Prefill 一次性吃完整段 prompt、顺手填满缓存,Decode 每步只处理一个新 token、并往缓存里追加一格。

kv-cache-shape-prefill-decode.png

如果想更贴近底层地看这个机制,Sebastian Raschka 写过一篇 Understanding and Coding the KV Cache in LLMs,不用框架封装,从零手写了一个带 KV Cache 的生成循环,感兴趣的同学可以看看。

小结

今天我们学习了大模型推理中至关重要的 KV Cache 机制:

  1. 问题:自回归生成时,历史 token 的 K、V 是不变的常量,朴素做法每步重算整段序列,总计算量 O(n²)
  2. KV Cache 的思想:每层缓存所有历史 token 的 K、V,每步只为新 token 算一次并追加,总计算量降到 O(n),是典型的以空间换时间
  3. 显存占用:缓存大小 = 2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数。一个 7B 模型跑 4k 上下文,单请求约 2 GiB,32k 就是 16 GiB,长上下文和并发都会放大这块开销
  4. 瘦身手段:GQA 砍 KV 头数,量化砍每元素字节数,两者可以叠加
  5. 动手验证:transformers 里 use_cache=True 会返回 past_key_values,形状为 [batch, KV 头数, 序列长度, 头维度],随生成步数逐 token 增长

KV Cache 解决了计算重复的问题,但它自己成了显存大户。一个自然的问题是:既然每一步的缓存用量差别这么大,prefill 阶段一次性写入几千个 token 的 K、V,decode 阶段一步只写一个,这两个阶段的特征是不是应该分开对待?推理系统正是这么做的,这就是 Prefill 与 Decode 两个阶段的划分。我们明天继续。

参考


学习大模型推理的前向传播:Transformer 与注意力机制

在上一篇中,我们把一段文本切成了 token,查嵌入表把每个 token 变成向量,又讲了两种注入位置信息的做法:正弦编码直接加在嵌入向量上,RoPE 则作用在注意力计算里的 Q 和 K 上。到这里,一段文本已经变成一串带语义的向量,到达了模型的入口。

不过这串向量还只是原材料。接下来它要穿过几十层结构完全相同的 Transformer Block(Transformer 块),每过一层就被改写一次,最后被映射成词表大小的分数,模型才能从中挑出下一个 token。这个从输入向量一路算到输出分数的过程,就是 前向传播(Forward Pass)。它是整个推理过程的核心计算,今天我们就来学习这块知识。

前向传播全景

先看整体路线图:
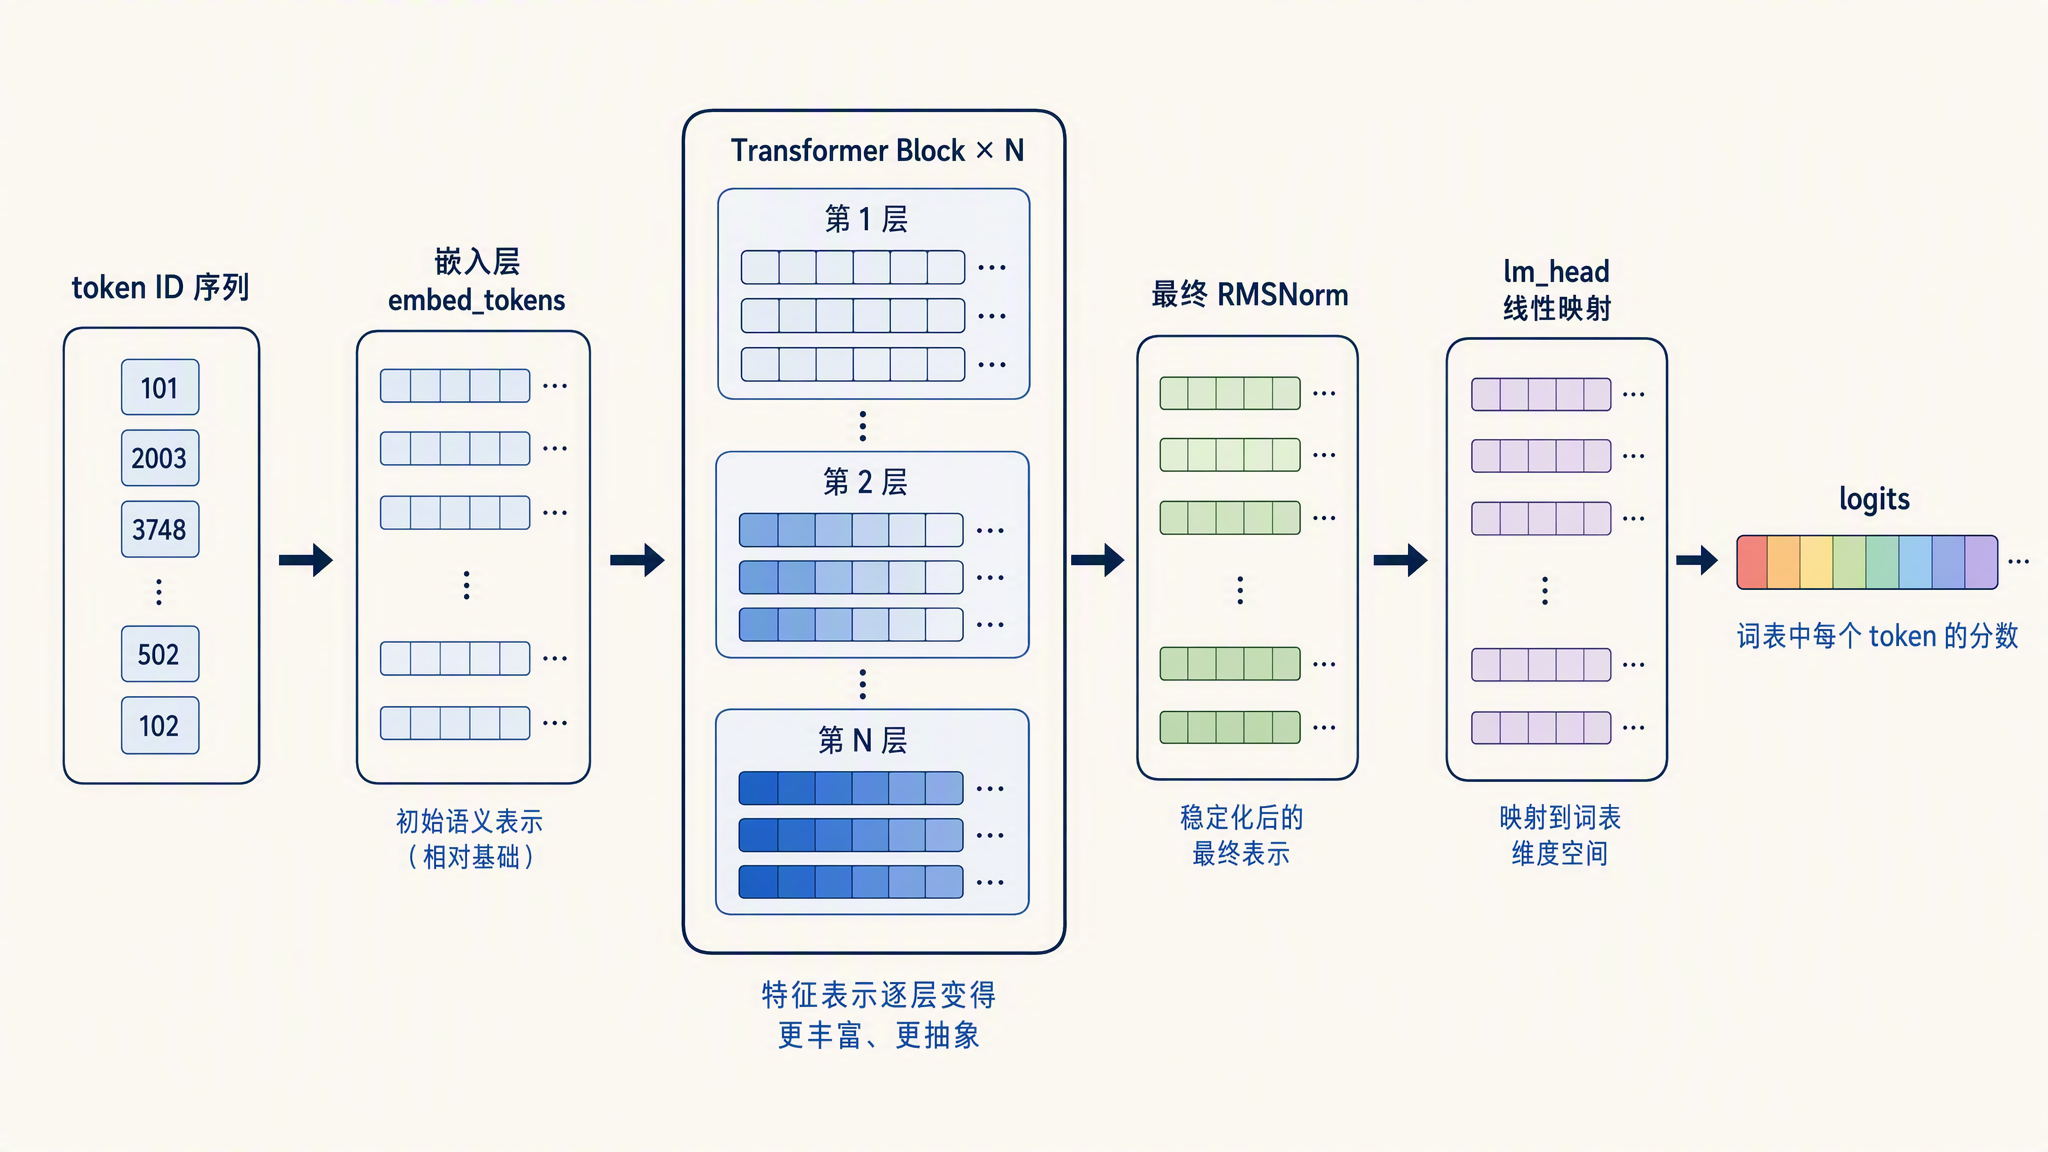
forward-pass-overview.png

以 Qwen3-0.6B 为例走一遍这条链路:token id 先经过嵌入层,查表变成 1024 维的向量;然后向量依次穿过 28 层 Transformer Block,每一层的输入输出都是 1024 维,形状不变,内容却被改写一次;走出最后一层后先过一次 RMSNorm,最后由 lm_head 把 1024 维映射成 151936 个分数,词表里每个候选 token 各得一分。可以看到,向量只在首尾两头改变形状,中间的加工全部在 Block 里完成。

整条链路里,真正让模型变聪明的就是中间那 N 层 Block。Qwen3-0.6B 这样的小模型就有 28 层,更大的模型可以有 60 层、80 层甚至更多。每一层结构相同、参数不同,向量每过一层就被加工一次,表示越来越抽象。

今天的主要任务就是把一个 Block 拆开,看清里面的两个核心组件:注意力机制和前馈网络。

原始 Transformer 的结构

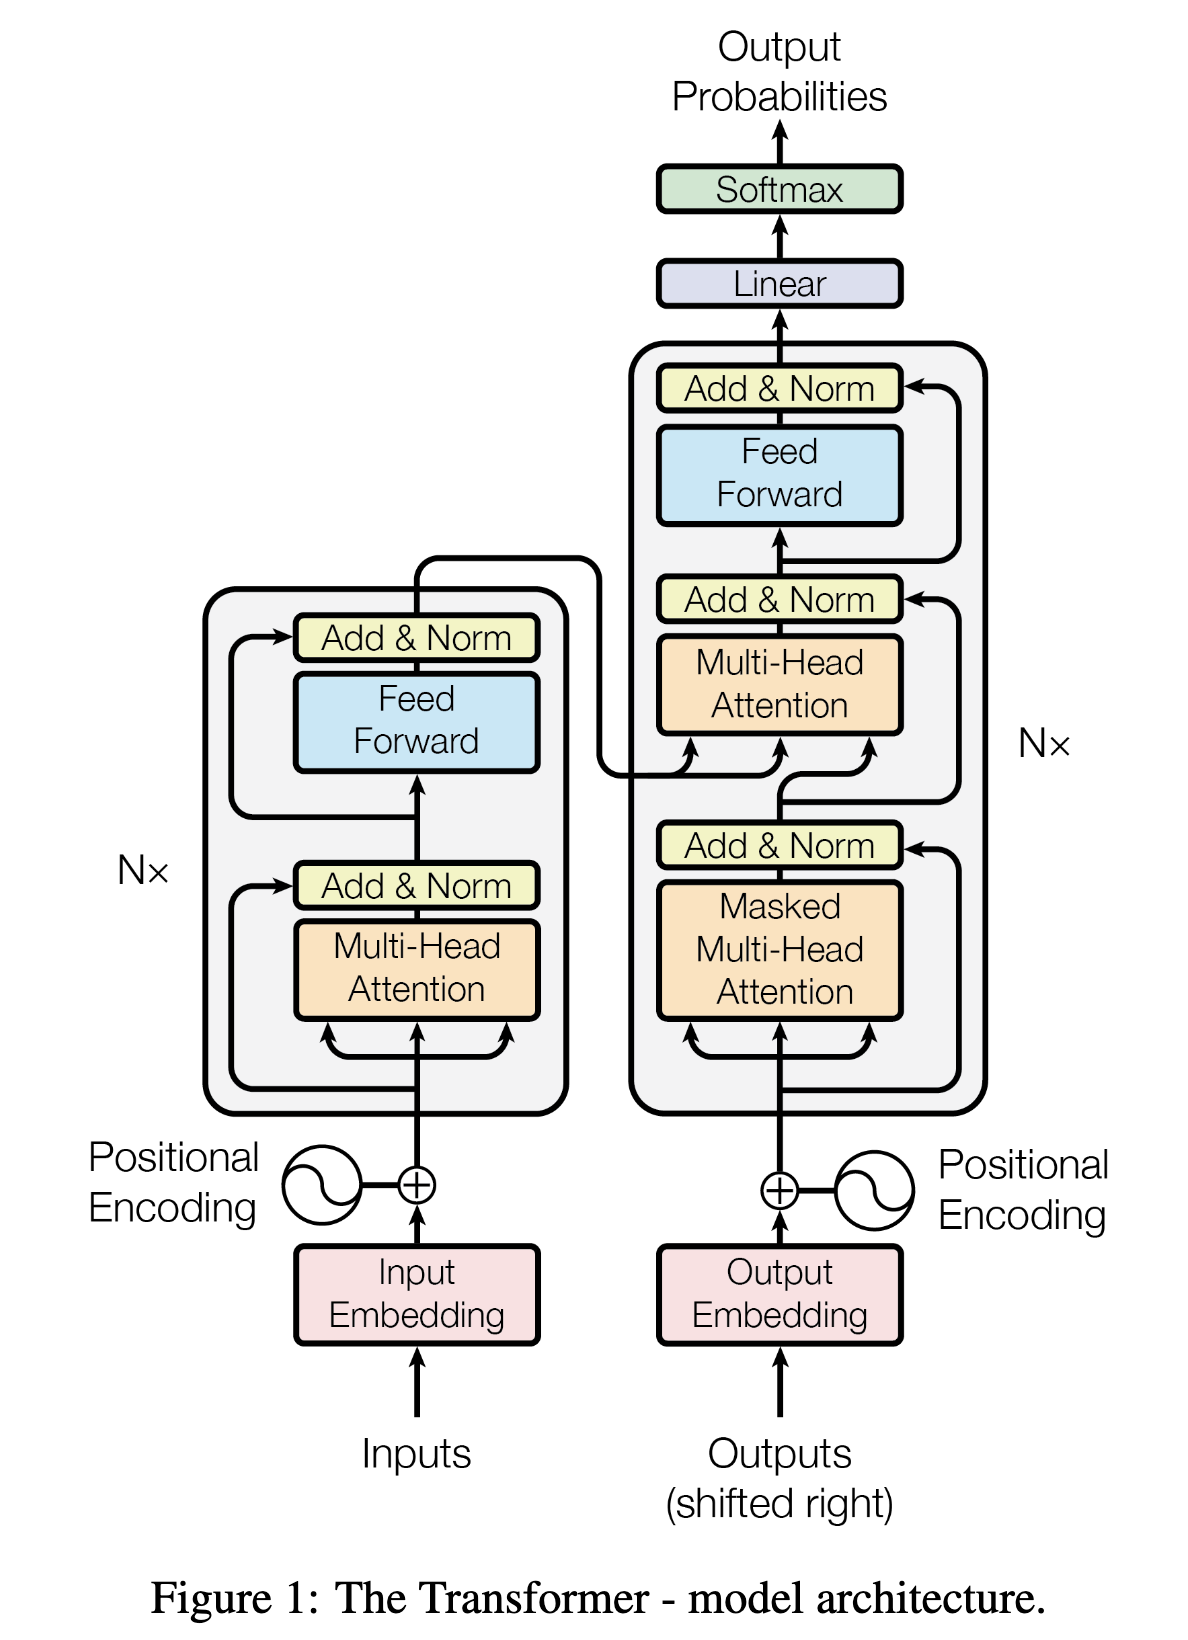
今天主流大模型的 Block 不是凭空设计的,它是从 2017 年 Transformer 原始论文 Attention Is All You Need 的架构一路演化来的。先看原文的经典架构图:
transformer.png

原始 Transformer 是为机器翻译设计的,整个模型分成左右两半。左边是 编码器(Encoder),负责读入源语言句子;右边是 解码器(Decoder),负责逐个生成目标语言的词。图底部的嵌入层加位置编码,就是上一篇讲的内容;最上方的 Linear 加 Softmax,则对应今天的 lm_head 和 softmax,我们后面学习。

重点看中间的 Block。编码器的 Block 分两段:多头注意力加前馈网络;解码器的 Block 分三段:带掩码的多头注意力、交叉注意力、前馈网络。交叉注意力(Cross Attention) 让解码器在生成每个词时参考编码器读到的源句子。每一段后面都跟着一个 Add & Norm,Add 是把子层的输出和输入做残差相加,Norm 是对相加的结果做 LayerNorm 归一化。注意这个顺序:先相加、再归一化,归一化作用在残差相加之后的主干上,这个写法叫 Post-Norm(后置归一化)

不过,如今的大模型几乎都去掉了编码器,也就是 decoder-only(仅解码器) 架构。核心原因是它的预训练目标很简单,就是不断地预测下一个 token,海量文本不需要任何标注就能直接训练,规模容易堆上去。理解类任务也都可以改写成续写的形式,把问题写进输入、让模型接着写答案,一个模型就可以同时覆盖理解和生成。翻译这类原本适合编码器-解码器架构的任务,用续写同样能完成,编码器-解码器架构慢慢就成了少数派。

编码器没了,交叉注意力自然也被拿掉,一个 Block 就剩下两段:带掩码的多头注意力加前馈网络。接下来就看看这个两段式 Block 在今天的大模型里长什么样。

一个 Block 的内部结构

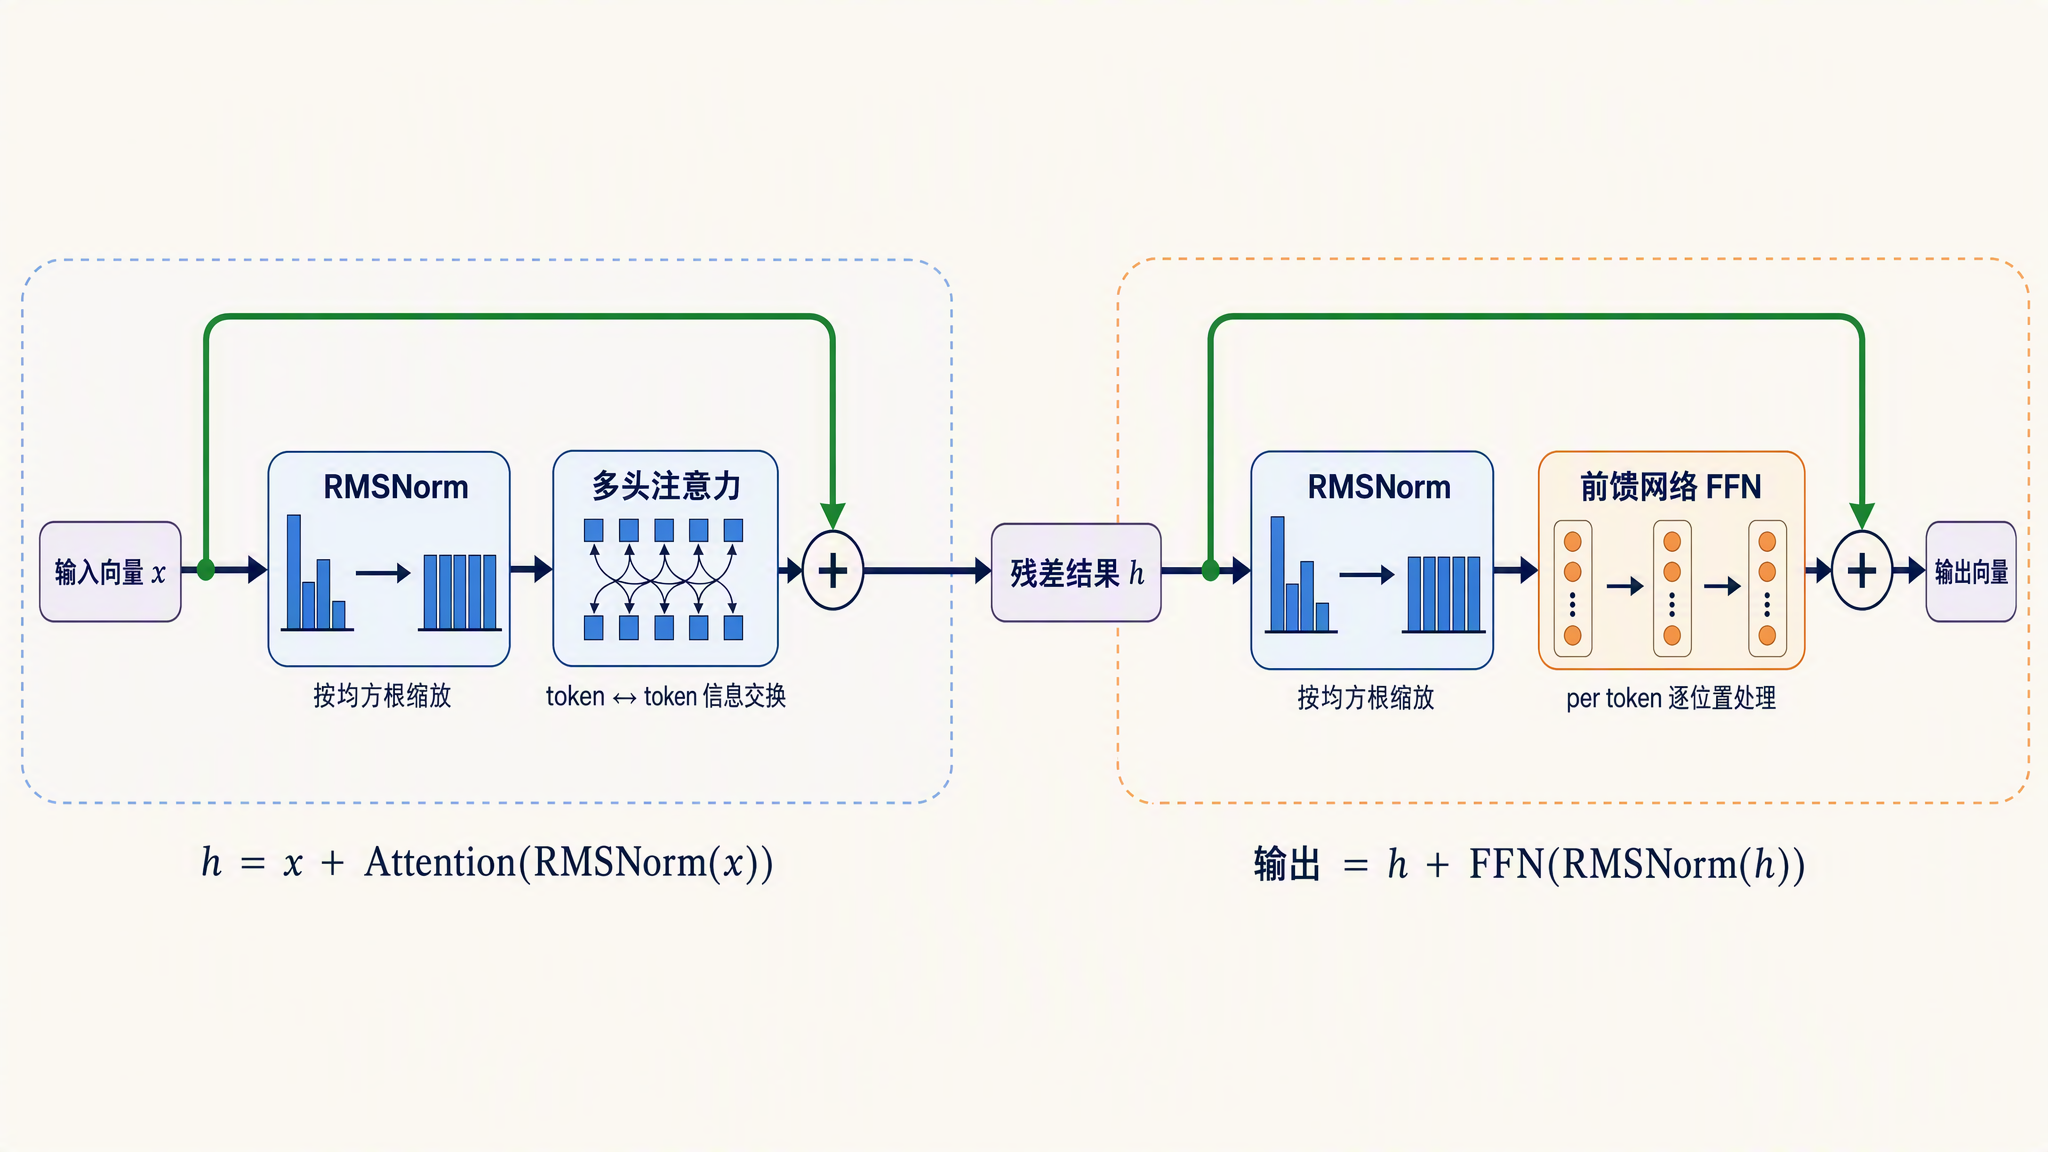
从原始架构到今天的主流开源大模型(LLaMA、Qwen、DeepSeek 等),Block 又做了两处改进:LayerNorm 换成了 RMSNorm,归一化从子层之后挪到了子层之前,也就是 Pre-Norm(前置归一化)。改完之后,各家的 Block 长得几乎一模一样:
transformer-block-prenorm.png

先不管具体怎么算,沿着箭头把这张图走一遍。一个 Block 分成前后两个阶段:前半段让 token 通过注意力交换信息,后半段让每个 token 进入前馈网络单独加工。

输入向量 x 先经过 RMSNorm,再进入多头注意力;注意力的结果和未经处理的 x 相加,得到中间结果 h。接着 h 再经过一次 RMSNorm 和前馈网络,处理结果与原来的 h 相加,得到这个 Block 的最终输出。写成两行就是:

h    = x + Attention(RMSNorm(x))
输出 = h + FFN(RMSNorm(h))

图中的黑色横线是正常的计算路径,绿色线路则绕过子层、直接连到加号。几十个 Block 叠起来时,每一层都重复这两次“先归一化、再计算、最后与原输入相加”的过程。

这条路线里包含三个搭建 Block 骨架的关键概念:绿色旁路叫残差连接,两次缩放操作叫 RMSNorm,而“归一化位于子层之前”的摆放方式就叫 Pre-Norm。下面按这个顺序逐个拆开。

残差连接:给信息留一条直通旁路

先看 残差连接(Residual Connection)。图里两条从上方绕过子层、汇入加号的绿色旁路就是残差连接,写法只有一行:

输出 = 输入 + 子层(输入)

这里的 子层(输入) 表示把输入向量交给子层(注意力或前馈网络)计算后得到的结果,可以把它看成一次函数调用。也就是说,子层不直接输出加工结果,而是输出一个修改量,叠加在原始输入上。原始信息始终原样保留在结果里,子层只需要学习该怎么改。

为什么需要这条旁路?这和训练有关。神经网络训练时靠 梯度(Gradient) 来更新参数,梯度可以理解为从输出端一路传回输入端的修正信号,告诉每个参数该往哪个方向调。这个信号每穿过一层都会被削弱一点,几十层叠下来,传到最前面几层时已经所剩无几,前面的层就学不动了,这就是梯度消失问题。

有了残差连接,情况就不一样了:加法这条路上没有任何变换,修正信号可以顺着旁路几乎无损地传回第一层,深层网络才训得动。这个技巧出自 2015 年何恺明等人的 ResNet 论文,原本用在 152 层的图像网络上,后来被 Transformer 继承,成了所有深层网络的标准配置。

可以打个比方:残差连接像传阅改稿,每个子层都在原稿上批注修改,原稿本身一直在;没有残差连接就像每层都把稿子重写一遍再往下传,传了几十层,原稿早就面目全非了。

RMSNorm:把数值缩放回稳定范围

残差旁路保住了原始信息,但主路径上的数值还需要保持稳定,这就是图中两个归一化模块的作用。向量每过一层子层,数值范围都会漂移,有的维度越乘越大,有的越压越小。几十层累积下来,数值可能大到溢出,也可能小到丢失精度,计算就不稳定了。归一化的作用就是定期把向量拉回一个稳定的数值范围。

前面讲原始 Transformer 时提过,它的 Add & Norm 里用的归一化方法是 LayerNorm(层归一化)。LayerNorm 分两步:先减均值,再除以标准差,相当于把考试成绩换算成标准分。
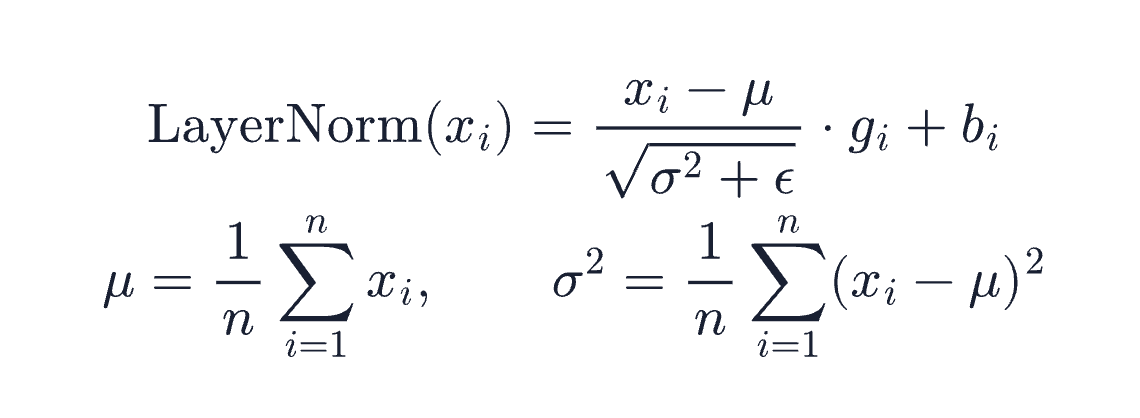
layernorm.png

效果是没啥问题,但每一步都要算均值和标准差两个统计量。后来 2019 年的 RMSNorm 论文 提出了一个简化:砍掉减均值这一步,只保留缩放,相当于直接按总分折算成百分比。少算一个统计量,计算更省,效果不降,现在主流模型都用它替代了 LayerNorm。

RMSNorm(Root Mean Square Layer Normalization,均方根层归一化) 的做法很朴素:算出整个向量的均方根,然后每个维度都除以它,等比缩放:
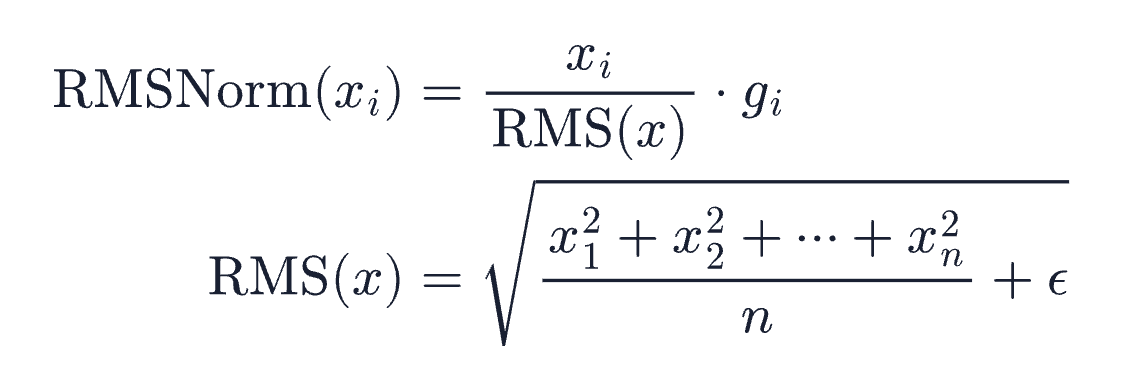
rmsnorm.png

其中 g 是一组可学习的缩放系数,每个维度一个,归一化之后由模型自己决定每个维度再放大多少;ε 是一个很小的数,防止除零。

写成代码也就几行:

import torch

def rms_norm(x, weight, eps=1e-6):
    rms = torch.sqrt(x.pow(2).mean(dim=-1, keepdim=True) + eps)
    return x / rms * weight

x = torch.tensor([1.0, 2.0, 3.0, 4.0])
print(rms_norm(x, torch.ones(4)))

输出结果:

tensor([0.3651, 0.7303, 1.0954, 1.4606])

可以看到,各维度的比例没变,但整体尺度被收回到了 1 附近。不管输入向量的数值飘到多大,过完 RMSNorm 都会回到这个量级。

Pre-Norm:归一化放在子层之前

知道 RMSNorm 做什么之后,最后还要回答一个问题:它应该放在哪里?原始 Transformer 用的是 Post-Norm(后置归一化),先算子层、加残差,最后归一化;现在主流模型用的 Pre-Norm(前置归一化) 则把归一化挪到子层之前:

Post-Norm: 输出 = RMSNorm(输入 + 子层(输入))
Pre-Norm:  输出 = 输入 + 子层(RMSNorm(输入))

两者对比图如下所示:
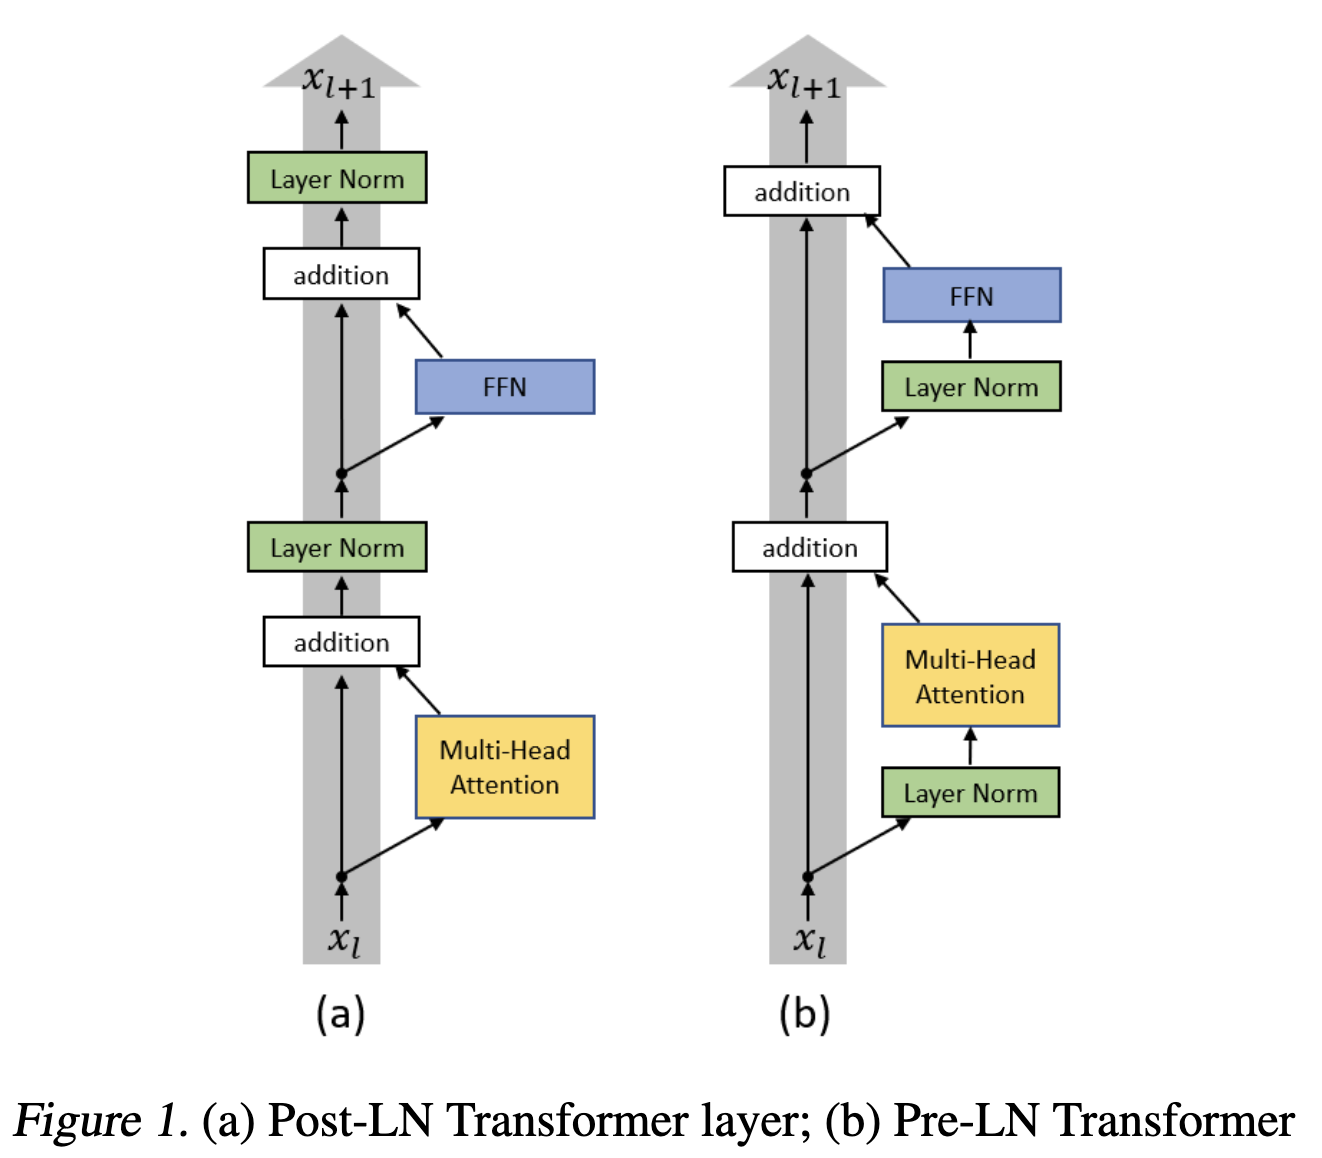
post-vs-pre.png

区别看着只是顺序,影响却不小。Post-Norm 里归一化卡在残差旁路上,修正信号回传时每过一层都要被重新缩放一次,层数一深训练就容易不稳,需要很小心地调参才能训起来。Pre-Norm 把归一化挪进子层内部,残差旁路从第一层直通最后一层,信号回传畅通无阻。微软 2020 年的论文 On Layer Normalization in the Transformer Architecture 从梯度的角度对比了这两种结构,证明了 Pre-Norm 的梯度更稳定,后来的大模型几乎全部采用了 Pre-Norm 结构。

到这里,Block 的骨架就清楚了:残差连接负责保留原始信息和打通信号通路,RMSNorm 负责稳定数值尺度,Pre-Norm 则规定 RMSNorm 要放在子层之前。

搞清楚这些基础概念之后,我们再来看看骨架中真正加工信息的两个核心组件。前半段的注意力机制横向连接整段序列,让不同 token 互相查找和交换信息;后半段的前馈网络(FFN)不再混合 token,而是对每个位置的向量独立做非线性变换。两者一个负责“交流”,一个负责“思考”,共同完成一层 Block 的更新。下面先学习注意力,再回头看前馈网络。

注意力机制

先看第一个核心组件:注意力。它的计算可以拆成几步:给每个 token 生成 Query、Key、Value 三个向量,用 Query 和 Key 算注意力分数,再按分数对 Value 加权求和。下面一步步拆开看。

Query、Key、Value

进入注意力子层后,每个 token 的向量会分别乘以三个投影矩阵,得到三个新向量:Query(查询)Key(键)Value(值)。投影矩阵就是一组可学习的参数,向量乘上去相当于做一次坐标变换,让同一个 token 能够以三种不同的身份参与计算。

可以用查资料来类比这三个角色:

  • Query:这个 token 想找什么信息,相当于读者手里的问题
  • Key:这个 token 能提供什么信息的索引,相当于每本书封底的标签
  • Value:这个 token 实际携带的内容,相当于书的正文

qkv-analogy.jpg

注意力分数就是 Query 和 Key 的点积。点积是把两个向量对应位置相乘再相加,比如 (1, 2) 和 (1, 0) 的点积是 1×1+2×0=1。点积越大,说明两个向量方向越一致,也就是 Query 想找的和 Key 标注的越匹配。得到分数之后,再按分数对所有 token 的 Value 加权求和,信息就完成了交换。

拿到 Q 和 K 之后、算分数之前,其实还有一步:上一篇讲的 RoPE 就是在这里登场的,它按位置把 Q 和 K 的维度两两配对做旋转,位置信息由此进入注意力计算。V 不参与旋转,只负责携带内容。

缩放点积注意力

把上面的过程写成公式,就是原始 Transformer 论文里提出的 缩放点积注意力(Scaled Dot-Product Attention)

attention.png

逐项解释一下:

  • QK^T:拿每个 token 的 Q 和所有 token 的 K 做点积,得到一个 N×N 的分数矩阵,N 是序列长度。矩阵第 i 行第 j 列,表示第 i 个 token 对第 j 个 token 的关注程度
  • √d_k:d_k 是 Key 向量的维度。维度越高,点积的结果天然越大;点积太大,softmax 会被推到梯度接近 0 的饱和区,训练就学不动了。除以 √d_k 可以把分数的方差拉回到 1 附近,让 softmax 工作在敏感区间
  • softmax:对每一行做归一化,把分数变成和为 1 的权重。softmax 的做法是先对每个分数取指数(放大差距、保证非负),再除以整行的总和,这样每个权重都在 0 到 1 之间,加起来正好等于 1
  • V:按权重对所有 token 的 Value 加权求和,得到每个位置融合了上下文之后的新向量
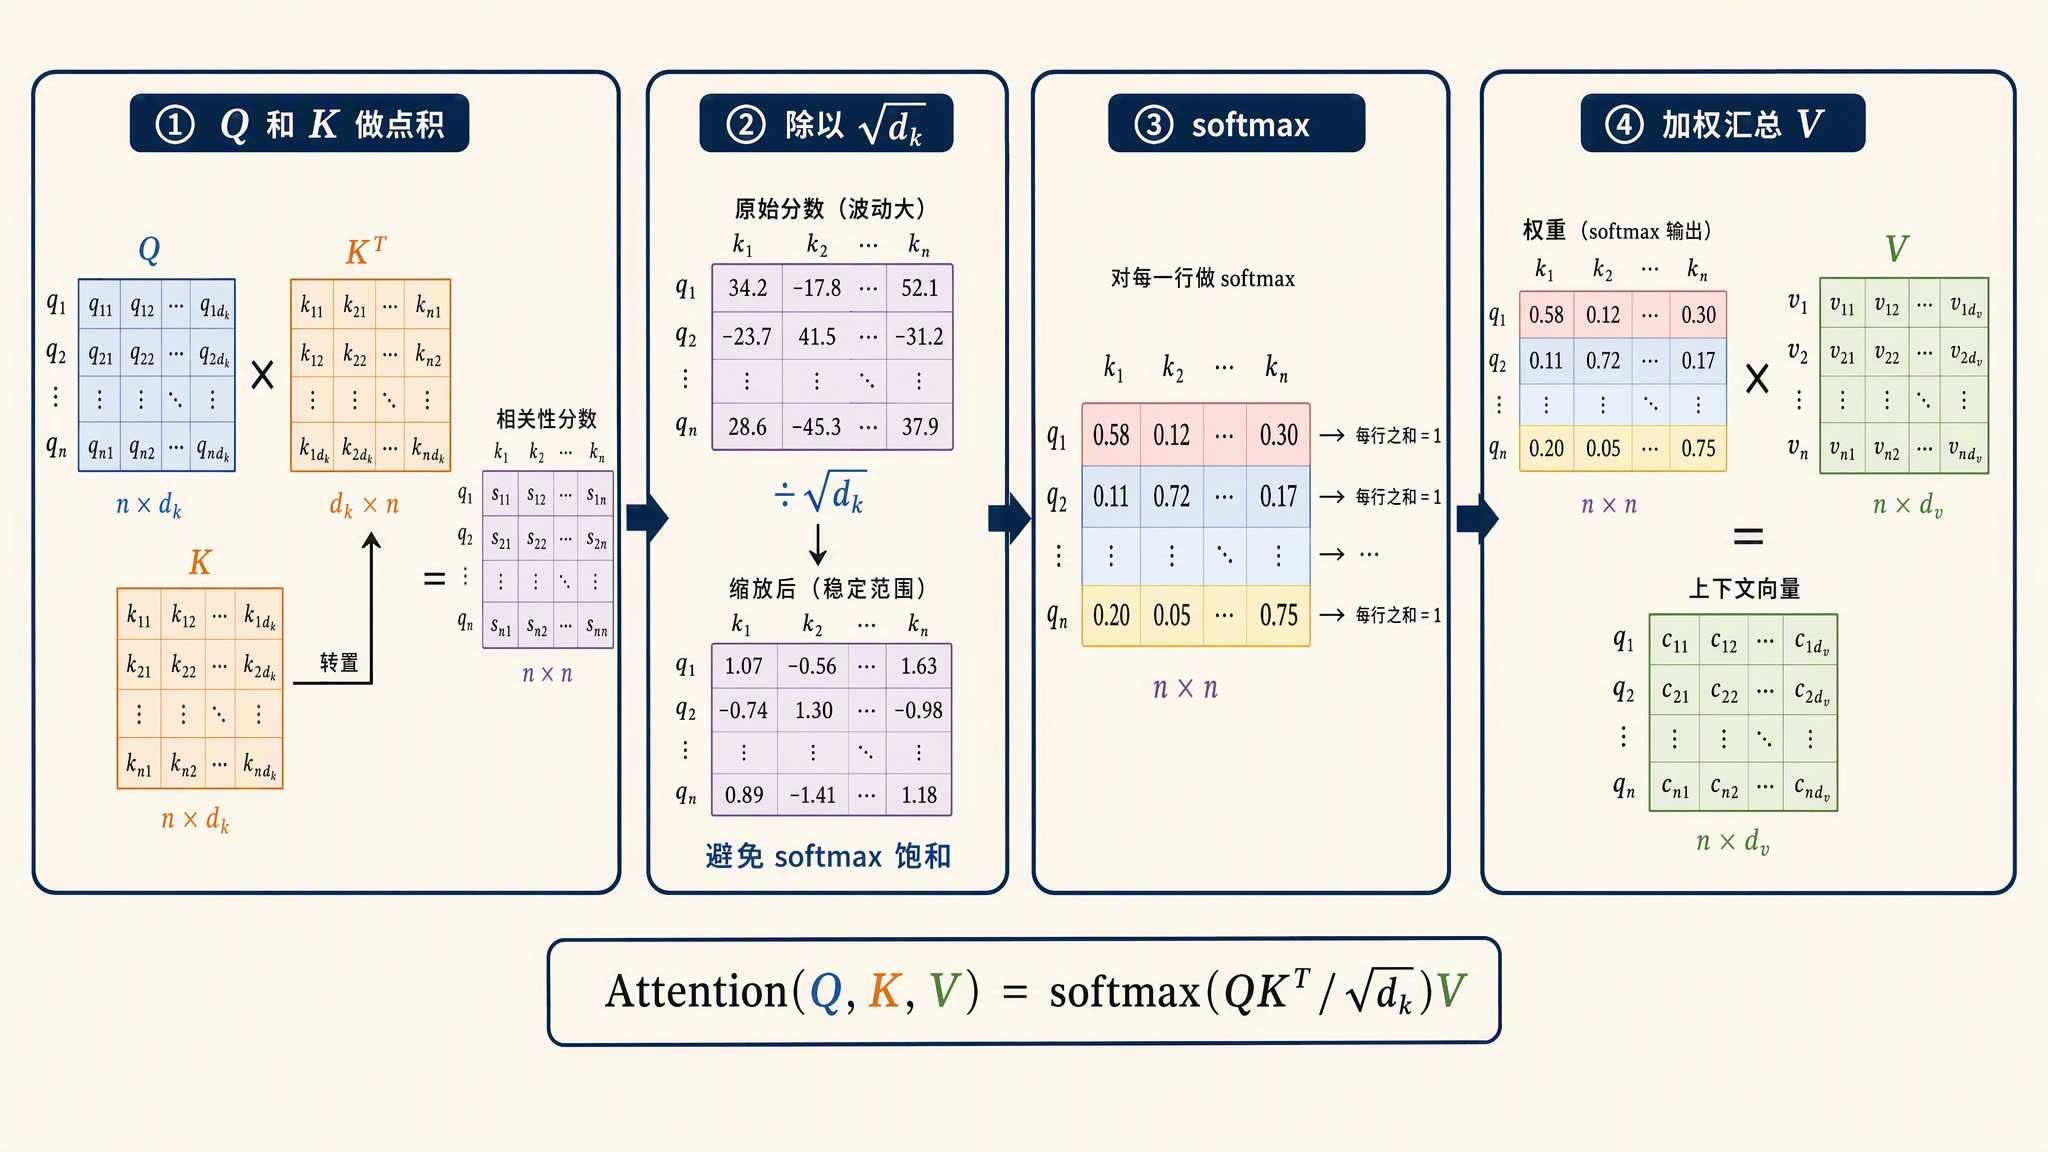
scaled-dot-product-attention.jpg

手算一个小例子

公式看着抽象,我们拿 4 个 token 的小例子亲手算一遍。假设输入是「我 爱 吃 苹果」,为了能手算,把向量的维度压到 2。假设每个 token 的向量过完投影矩阵后,得到的 Q、K、V 如下:

tokenQueryKeyValue
(1, 2)(1, 0)(1, 0)
(2, 1)(0, 1)(0, 1)
(3, 1)(1, 1)(2, 1)
苹果(1, 1)(2, 0)(1, 2)

两两点积,得到 4×4 的注意力分数矩阵:

分数K: 我K: 爱K: 吃K: 苹果
Q: 我1232
Q: 爱2134
Q: 吃3146
Q: 苹果1122

以「吃」这一行为例验算一下:Q(吃) = (3, 1),它和四个 Key 的点积分别是 3×1+1×0=3、3×0+1×1=1、3×1+1×1=4、3×2+1×0=6。

读这一行就能看到一个有意思的现象:「吃」对「苹果」的分数最高(6),其次是它自己(4)和「我」(3),对「爱」几乎不感兴趣(1)。这和我们的语言直觉吻合,一个动词最关心的问题就是谁在吃、吃什么。

接着按公式走。这里 d_k = 2,每个分数先除以 √2 ≈ 1.41,再对整行做 softmax,「吃」这一行的权重变成:

关注对象苹果
权重0.0860.0210.1750.718

可以看到,「吃」把大约 72% 的注意力给了「苹果」,18% 留给自己,9% 给了「我」。最后拿这组权重对四个 token 的 Value 加权求和:0.086×(1, 0) + 0.021×(0, 1) + 0.175×(2, 1) + 0.718×(1, 2) = (1.15, 1.63),这就是「吃」这个位置的新向量,它里面已经揉进了主语和宾语的信息。
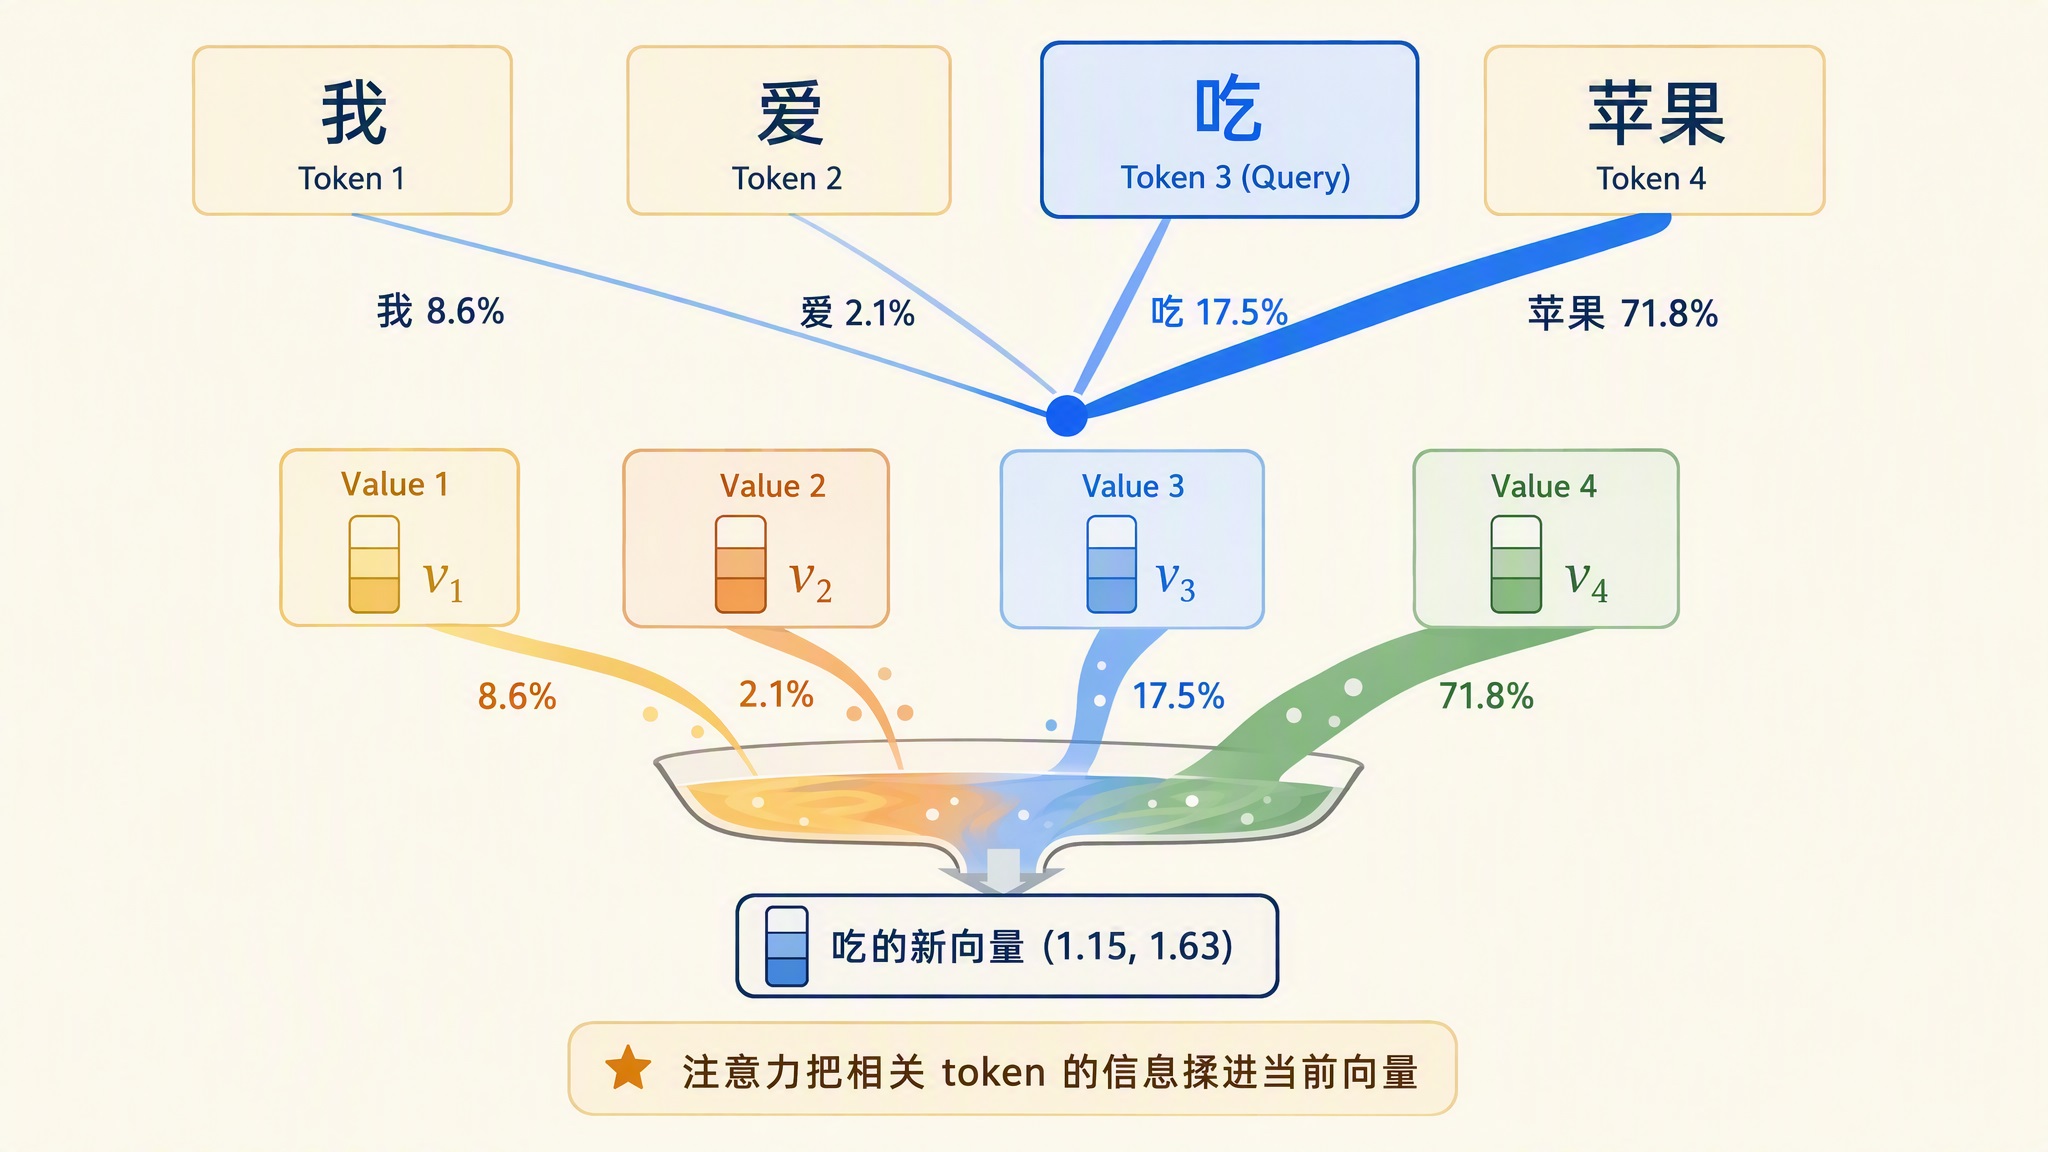
attention-hand-calculation.jpg

因果掩码

上面的例子里有一个破绽:「吃」在算注意力时看到了排在它后面的「苹果」。这在真实生成中是不允许的。模型是一个 token 一个 token 往外生成的,在「吃」这个位置决定下一个词的时候,「苹果」还不存在。如果训练时允许模型看未来,它就学会了抄答案,生成时必然露馅。

解决办法是 因果掩码(Causal Mask):在 softmax 之前,把分数矩阵的上三角全部置为负无穷。负无穷经过 softmax 后权重变成 0,相当于把这些位置直接屏蔽:

分数K: 我K: 爱K: 吃K: 苹果
Q: 我1-inf-inf-inf
Q: 爱21-inf-inf
Q: 吃314-inf
Q: 苹果1122

「我」只能看自己,「爱」能看前两个,「吃」能看前三个。重新算「吃」这一行,只对前三个分数(3、1、4)做缩放和 softmax,权重变成大约 0.306、0.074、0.620,「吃」的注意力就收敛到了它自己和「我」身上。加权求和得到的新向量是 0.306×(1, 0) + 0.074×(0, 1) + 0.620×(2, 1) = (1.55, 0.69),和没加掩码时的 (1.15, 1.63) 对比,「苹果」的贡献被完全挡掉了。

每个位置只看得到自己和左边的 token,这就是 GPT 这类 decoder-only 模型的标准约束。它保证了训练时的计算方式和生成时一致。

多头注意力

上面演示的注意力只有一个头,也就是一套 Q、K、V 投影算一份注意力分数。一个头只能学一种关注模式,比如例子里它学会了动词找宾语,但一句话里值得学的关系还有很多:指代、修饰、搭配、语序。一个头明显不够用。

多头注意力(Multi-Head Attention,MHA) 的做法是把向量切成多份,每一份用各自独立的 Q、K、V 投影并行算一遍注意力,最后把各头的结果拼接起来,再过一次输出投影。每个头有独立的参数,训练后会分化出不同的关注模式。
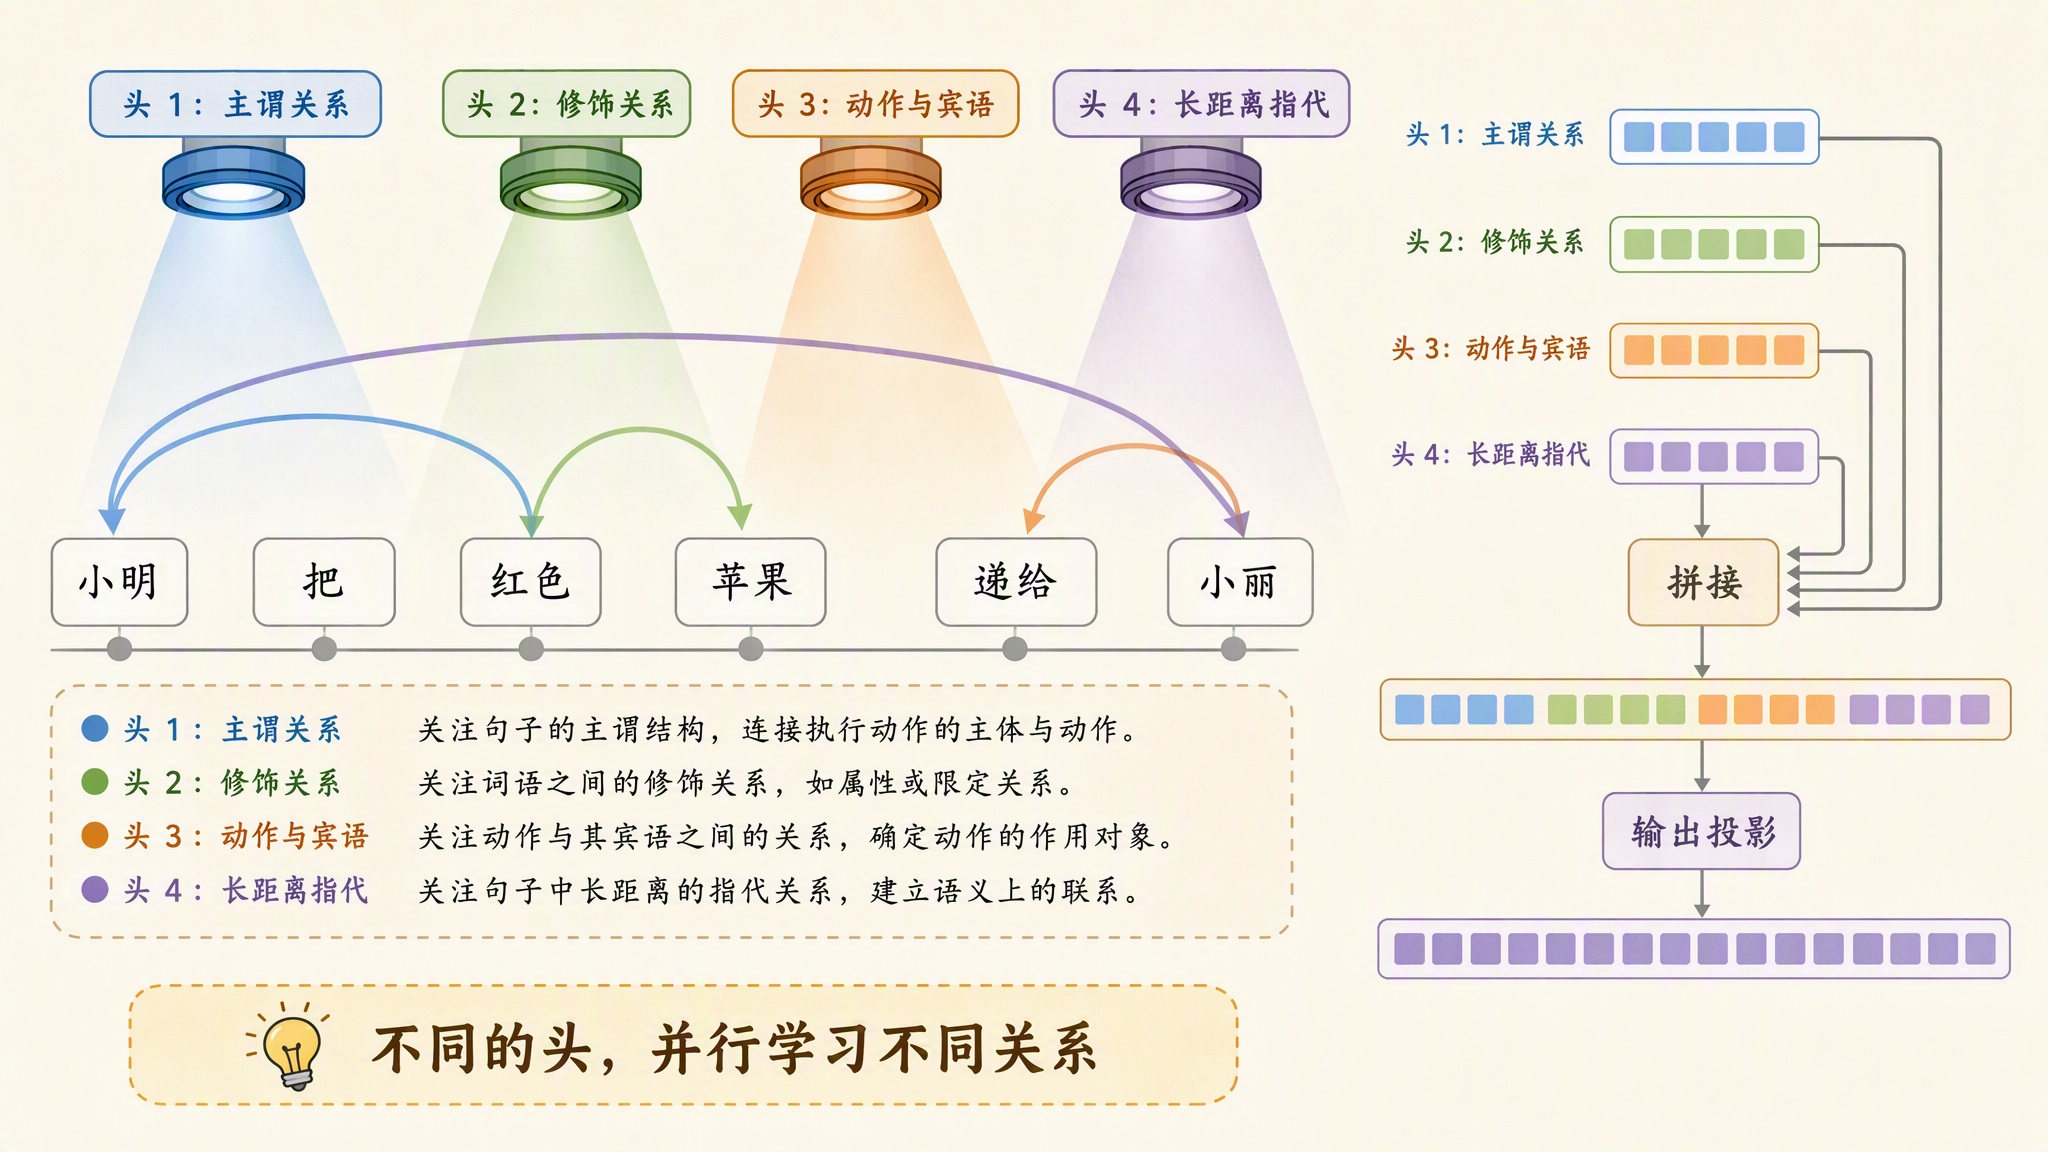
multi-head-attention.jpg

Qwen3-0.6B 有 16 个查询头,每个头的维度是 128,这些配置在 Qwen3 技术报告里都能查到。训练完成后,有的头擅长局部搭配,有的头擅长长距离依赖,各司其职。

从 MHA 到 GQA 到 MLA

多头注意力效果好,但推理时要付出一个代价:每个头都有自己独立的 K 和 V。生成时为了不重算历史,所有历史 token 的 K、V 都要存在显存里,这份缓存就是我们常说的 KV Cache。头越多、层越深、序列越长,缓存就越大,显存很快吃紧。围绕这个矛盾,注意力头数的设计一路演进:

  • MHA:Q、K、V 头数相同,比如 16 个头就配 16 组 K、V。质量最好,缓存最大,早期的 GPT-3 就是这个结构。
  • MQA(Multi-Query Attention,多查询注意力):2019 年 Shazeer 在 Fast Transformer Decoding: One Write-Head is All You Need 里提出,让所有查询头共享同一组 K、V。缓存直接缩小到头数分之一,速度提升明显,但质量有损失。
  • GQA(Grouped-Query Attention,分组查询注意力):2023 年 Google 在 GQA 论文中提出的折中方案,把查询头分成若干组,每组共享一组 K、V。质量接近 MHA,缓存接近 MQA。LLaMA 3、Qwen3、Mistral 用的都是 GQA。
  • MLA(Multi-head Latent Attention,多头潜在注意力):DeepSeek 在 DeepSeek-V2 论文中提出的另一条路,不缓存完整的 K、V,而是把它们低秩压缩成一个隐向量存起来,推理时再还原。按论文的数据,DeepSeek-V2 的 KV 缓存比上一代 DeepSeek 67B 减少了 93.3%,效果还不输 MHA。

四种注意力方案的查询头与 K/V 共享关系如下图所示:
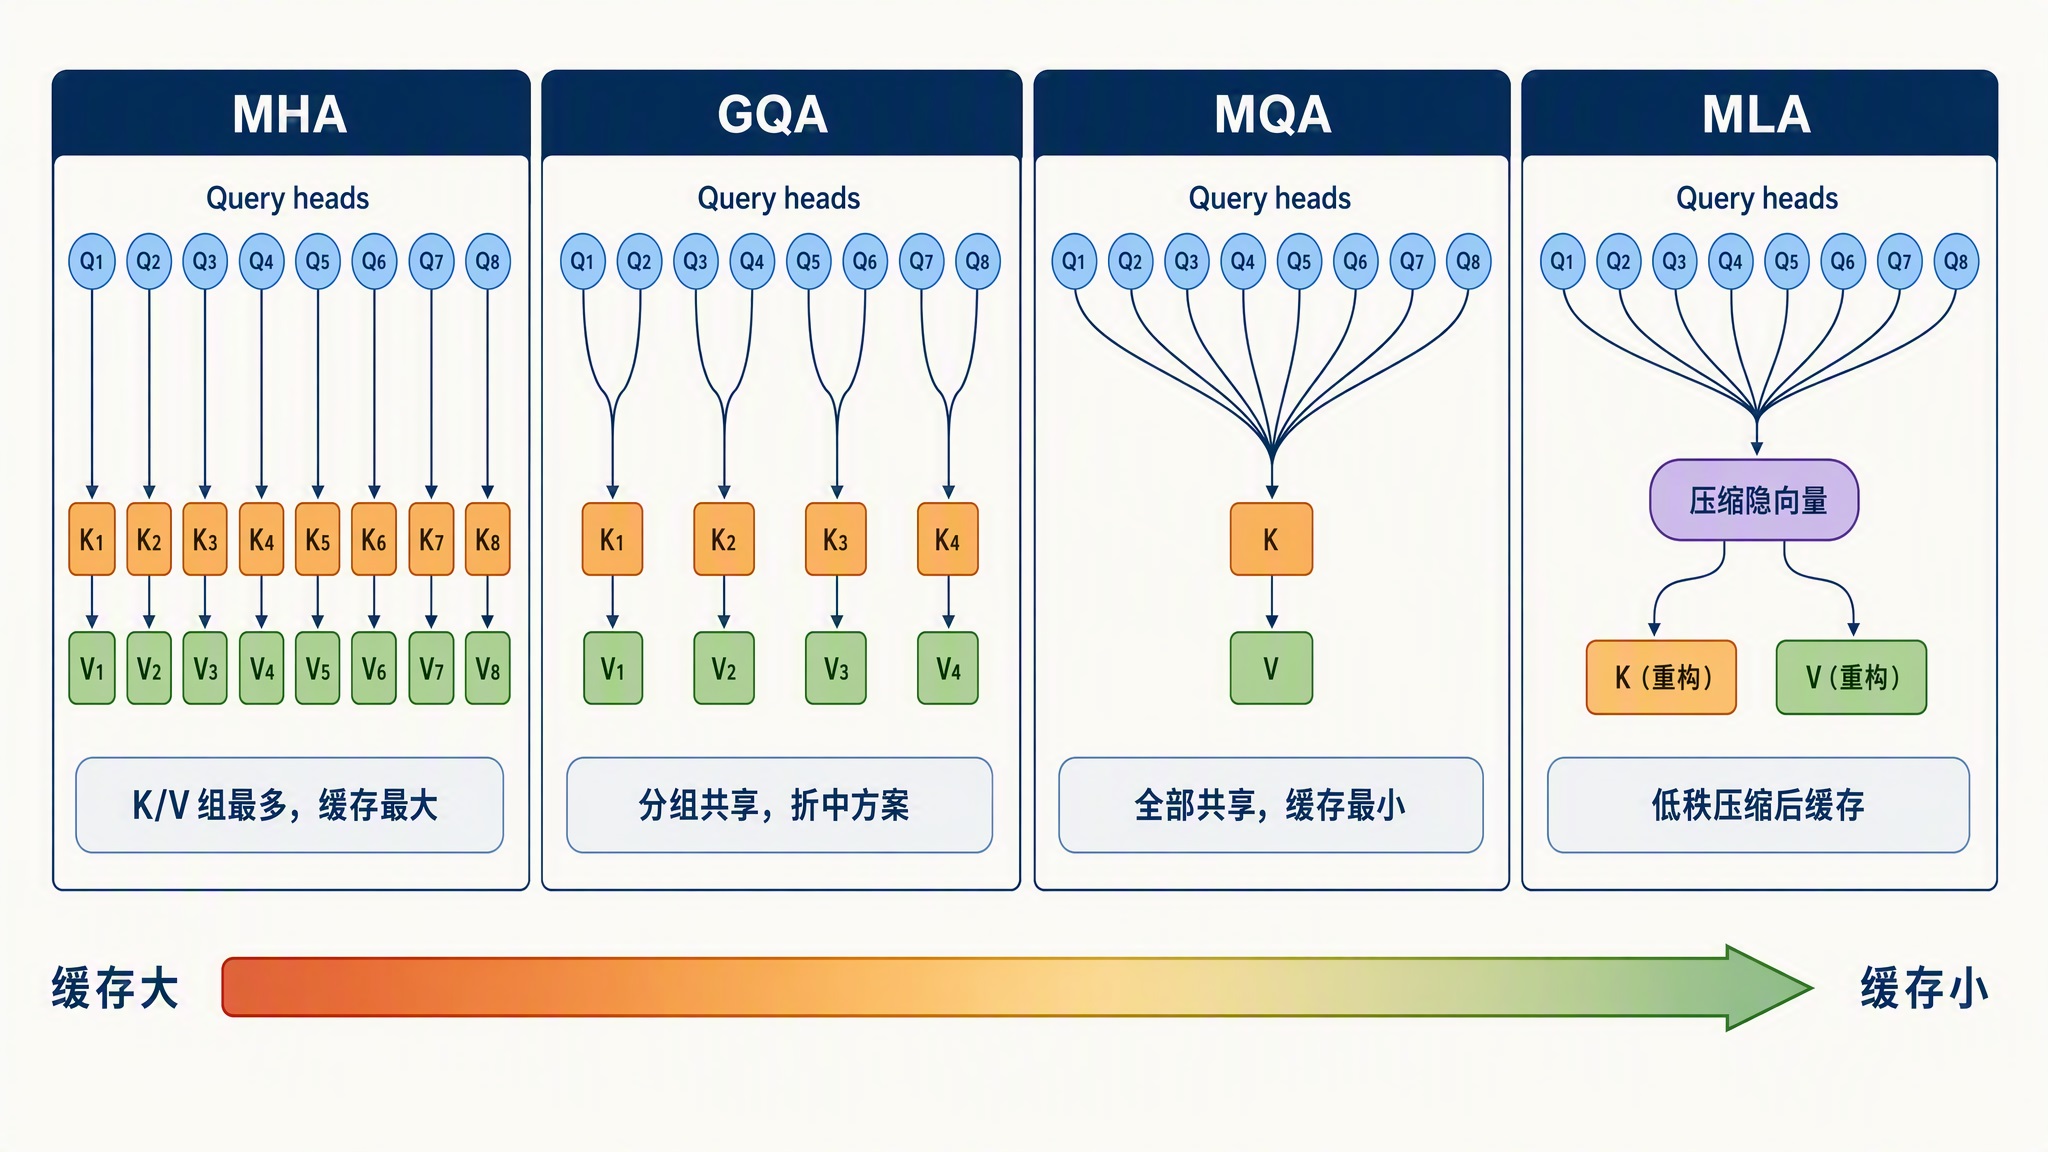
attention-variants.jpg

四种方案的取舍可以汇总成一张表:

方案K/V 组数KV 缓存大小代表模型
MHA等于查询头数最大GPT-3
GQA查询头数的几分之一中等LLaMA 3、Qwen3
MQA1最小Falcon
MLA压缩成隐向量比 GQA 更省DeepSeek-V2/V3

这里只需要建立一个印象:注意力头的设计,本质上是在质量和 KV 缓存开销之间做权衡。缓存到底怎么存、怎么管,我们留到下一篇展开。

前馈网络

注意力解决 token 之间的信息交换,前馈网络(Feed-Forward Network,FFN) 则是对每个 token 的向量单独做加工。注意力算完一轮,每个位置的向量里都揉进了上下文,接下来怎么把这些信息消化成更有用的表示,就是 FFN 要干的事。它的结构比注意力简单得多,我们一层层拆开看。

两层 MLP:先放大,再压回

FFN 的结构是两层 MLP(Multi-Layer Perceptron,多层感知机),也就是矩阵乘法叠起来的全连接网络:先把维度放大,中间过一遍激活函数,再压回原来的维度。原始 Transformer 里就是 512 维放大到 2048 维再压回 512 维,Qwen3-0.6B 则是 1024 维放大到 3072 维再压回 1024 维,这个形状从 2017 年一直沿用到今天。
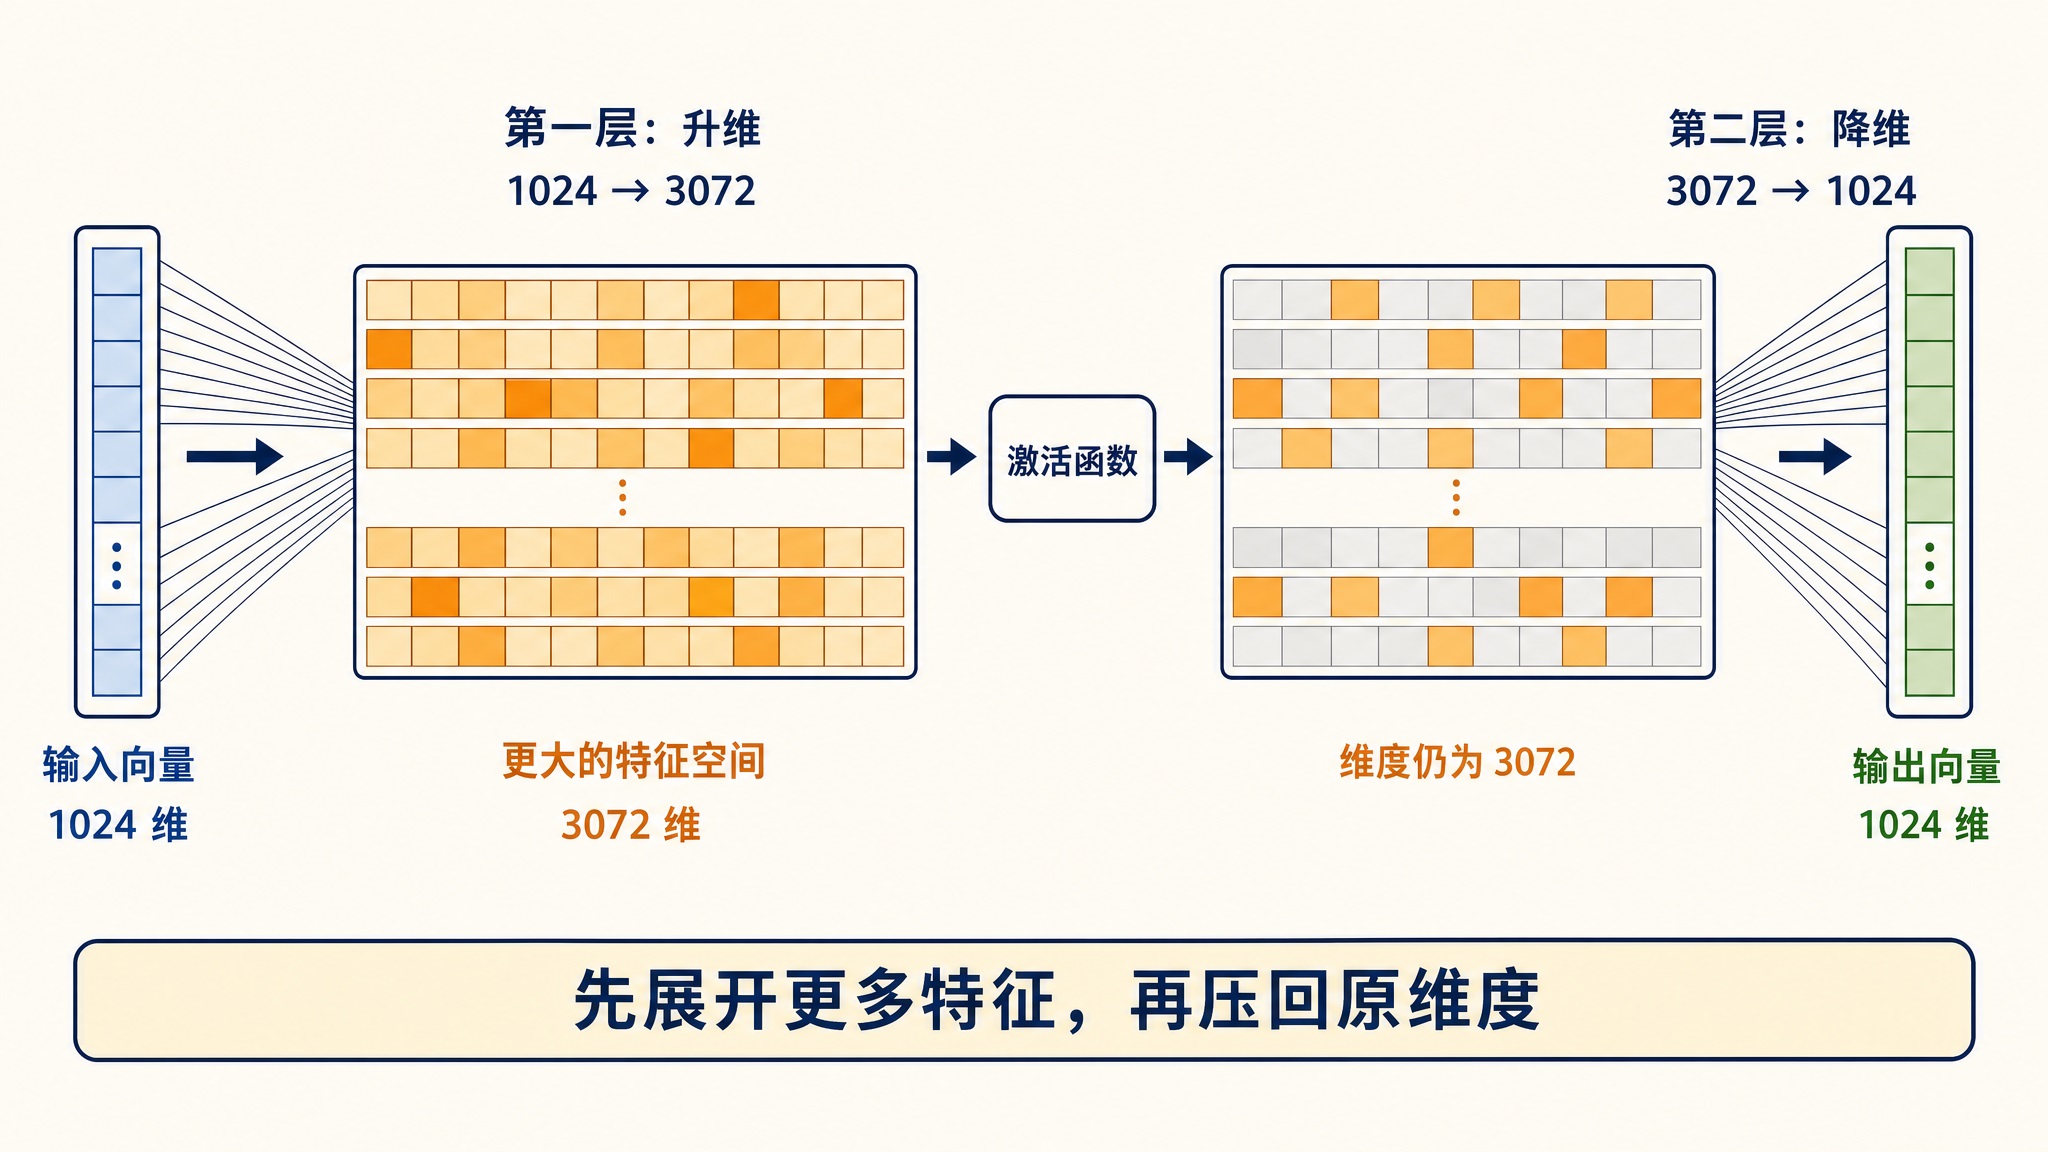
ffn-two-layer-mlp.jpg

为什么要先放大?一个直觉的解释是:1024 维的向量能容纳的特征有限,放大到 3072 维相当于摊到一张更大的工作台上,模型可以同时检测更多的模式,整理完再装回原来的盒子。

激活函数:非线性的来源

正如上一节所说,两层矩阵乘法之间还夹着一步:激活函数。它是逐元素起作用的非线性函数,也是网络能学会复杂模式的关键。如果没有它,两层矩阵乘法叠起来在数学上等价于一层,先放大再压回就失去了意义。

早期的 Transformer 用 ReLU(Rectified Linear Unit,线性整流单元),做法很直接:负数归零,正数原样通过。GPT 和 BERT 换成了 GELU(Gaussian Error Linear Unit,高斯误差线性单元),形状和 ReLU 类似但处处平滑,负数不再一刀切归零。现在主流模型用的是 SiLU(Sigmoid Linear Unit,Sigmoid 线性单元),它还有一个更广为人知的名字,Swish,也是同样的思路,公式是 x 乘以 sigmoid(x),sigmoid 是把任意实数压到 0 和 1 之间的 S 形函数。

用同一组输入对比一下这三个函数:

import torch
import torch.nn.functional as F

x = torch.tensor([-2.0, -0.5, 0.5, 2.0])

print(F.relu(x))
print(F.gelu(x))
print(F.silu(x))

输出结果:

tensor([0.0000, 0.0000, 0.5000, 2.0000])
tensor([-0.0455, -0.1543, 0.3457, 1.9545])
tensor([-0.2384, -0.1888, 0.3112, 1.7616])

可以看到,ReLU 把负数直接砍成 0,GELU 和 SiLU 则给小负数留了一点非零输出,整条曲线是平滑的。平滑的好处和训练有关:负半区的梯度不至于完全消失,参数更新更稳定。

activation-functions.png

SwiGLU:给 MLP 加一条门控分支

SwiGLU 出自 Shazeer 2020 年的论文 GLU Variants Improve Transformer,在 SiLU 的基础上又进了一步。它把 MLP 的放大从一路改成两路:gate_projup_proj 都负责把维度放大,gate 一路先过 SiLU 激活,再和 up 一路逐元素相乘,最后由 down_proj 压回原维度。

逐元素相乘这一步叫门控,思路来自更早的 GLU 家族:让一路输出充当另一路的开关,控制每个维度放行多少信息。gate 这路过完 SiLU 后,值小的维度会把 up 那路压下去,值大的维度则放行,模型由此学会哪些特征该留下、哪些该抑制。

swiglu-ffn.png

下面用代码模拟一遍这个过程,维度沿用 Qwen3-0.6B 的 1024 和 3072:

import torch
import torch.nn.functional as F

torch.manual_seed(0)
x = torch.randn(1024)          # 一个 token 的输入向量

gate_proj = torch.randn(3072, 1024)
up_proj = torch.randn(3072, 1024)
down_proj = torch.randn(1024, 3072)

gate = x @ gate_proj.T         # 1024 -> 3072
up = x @ up_proj.T             # 1024 -> 3072
hidden = F.silu(gate) * up     # 门控:两路逐元素相乘
out = hidden @ down_proj.T     # 3072 -> 1024

print(gate.shape, hidden.shape, out.shape)

输出结果:

torch.Size([3072]) torch.Size([3072]) torch.Size([1024])

可以看到,整个 FFN 的全部计算就是三次矩阵乘法加一次逐元素相乘。多了一路矩阵,参数量自然会涨,所以 SwiGLU 的中间维度通常取得比 ReLU 版本小一些,整体参数量和原来保持相当。记住 gate、up、down 这三个名字,等下看真实模型结构时会再遇到。

FFN 里存的是什么

2020 年特拉维夫大学的一篇论文 Transformer Feed-Forward Layers Are Key-Value Memories 认为,FFN 可以看成一个小型的键值记忆库。第一层矩阵的每一行是一个模式探测器,比如识别输入里是否出现了地名加「的首都」这类模式;第二层矩阵的每一列对应一段要往输出里写入的内容,比如把「巴黎」这个方向的表示加进去。一层负责认模式,一层负责写结论,几十层叠起来,模型在预训练时读到的知识就这样存进了 FFN 的权重。
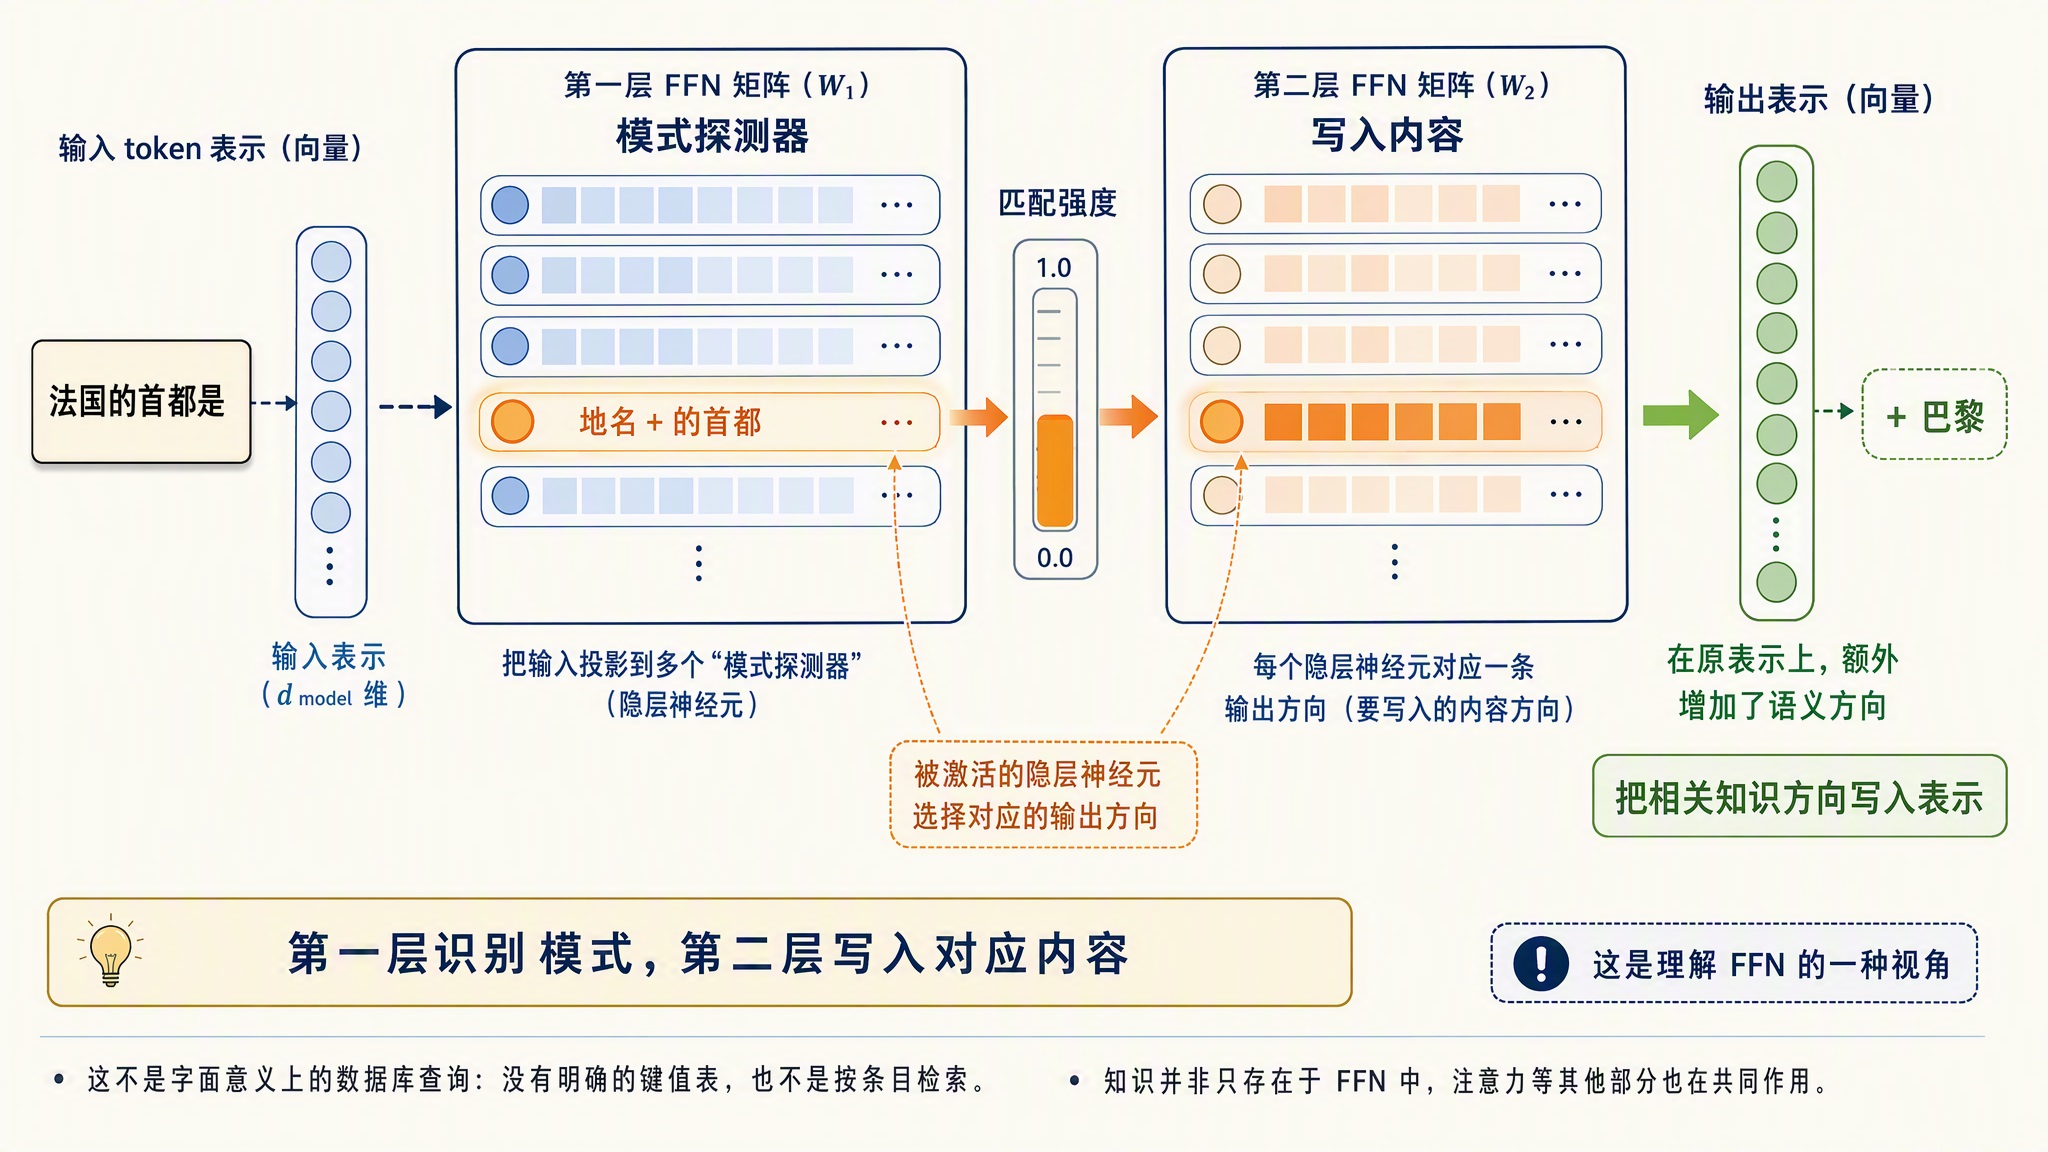
ffn-key-value-memory.jpg

这个视角也解释了为什么 FFN 的参数量比注意力多的多。注意力决定信息往哪流,FFN 才是真正装知识的地方。

混合专家:把一个 FFN 换成一排专家

FFN 还有一个重要变体:混合专家(Mixture of Experts,MoE)。它把一个大的 FFN 换成一排小的专家 FFN,每个 token 进来后由路由器给所有专家打分,只激活分数最高的几个,其余不参与计算。
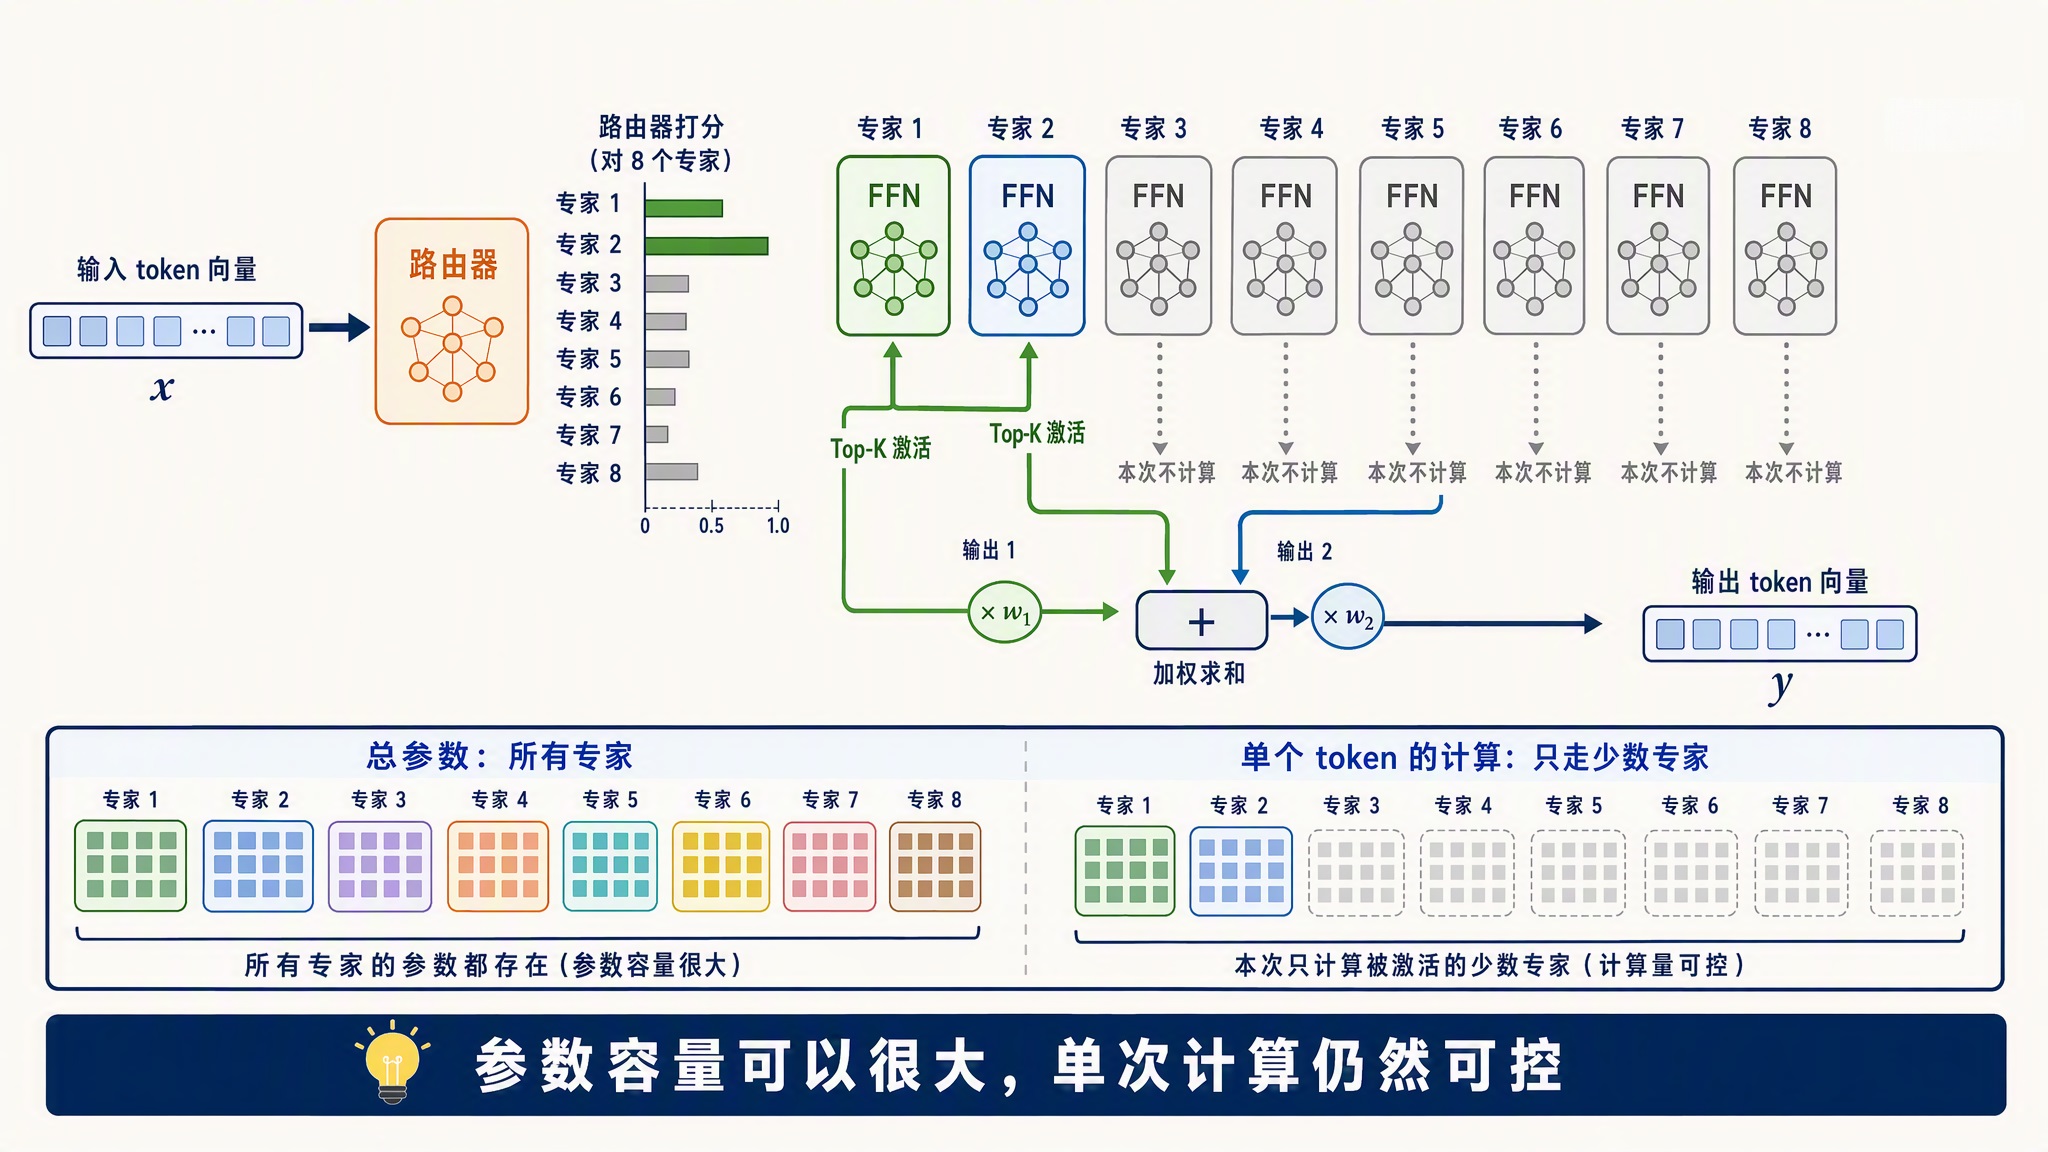
mixture-of-experts.jpg

这样做的好处是把参数量和计算量解耦了:总参数做得越大,能装的知识越多,但每个 token 实际消耗的计算只和激活的那几个专家有关。比如 DeepSeek-V3 总参数 6710 亿,每个 token 只激活 370 亿;Qwen3 系列的旗舰 Qwen3-235B-A22B 总参数 2350 亿,只激活 220 亿。

MoE 的细节今天不展开,知道它替换的是 Block 里 FFN 那一块就够了。

从最后一层到 logits

向量穿过全部 N 层 Block 后,还差两步才能变成下一个 token:

  1. 先过最后一次 RMSNorm,把数值分布再稳一遍
  2. 再过 lm_head,把向量从隐藏维度映射到词表维度,Qwen3 的词表大小是 151936

lm_head 是 language model head 的缩写,直译是语言模型的输出头。它本身只是一个线性层,也就是一个 151936×1024 的矩阵,不带别的计算。输入的 1024 维向量和这个矩阵相乘,相当于拿它分别和矩阵的每一行做点积;矩阵有 151936 行,每行对应词表里的一个 token,算出来的 151936 个点积就是这一轮的输出。

lm_head 的每一行可以理解为对应 token 的代表向量,点积越大,说明隐藏向量和这个 token 越像。模型挑下一个 token 的过程,本质上又是一次匹配打分,和注意力分数的思路一脉相承。

既然 lm_head 的每一行是 token 的代表向量,嵌入矩阵的每一行也是,这两份参数能不能干脆共用?Qwen3-0.6B 就是这么做的:它的 lm_head 和嵌入层共享同一个矩阵,这个设计叫权重绑定(weight tying),嵌入矩阵转置一下直接当输出层用,省掉一份 151936×1024 的参数。对小模型来说绑定是常见的做法。

lm_head 的输出叫 logits(未归一化分数):词表里每个候选 token 各得一个分数。分数本身还不是概率,要再过一次 softmax 才变成概率分布。实际生成时,推理框架会按温度、top-p 这些采样策略从分布里挑一个 token,拼到输入末尾,然后开始下一轮前向传播。

hidden-to-logits.png

再看 Qwen3-0.6B 的完整结构

Qwen3-0.6B 参数量小、结构标准,很适合拿来对照。我们继续以它为例,看看上面讲的各个组件在真实模型中是什么样的。

from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-0.6B")
print(model)

输出如下,每个 Block 的内容相同,这里只展开第一个:

Qwen3ForCausalLM(
  (model): Qwen3Model(
    (embed_tokens): Embedding(151936, 1024)
    (layers): ModuleList(
      (0-27): 28 x Qwen3DecoderLayer(
        (self_attn): Qwen3Attention(
          (q_proj): Linear(in_features=1024, out_features=2048, bias=False)
          (k_proj): Linear(in_features=1024, out_features=1024, bias=False)
          (v_proj): Linear(in_features=1024, out_features=1024, bias=False)
          (o_proj): Linear(in_features=2048, out_features=1024, bias=False)
          (q_norm): Qwen3RMSNorm((128,), eps=1e-06)
          (k_norm): Qwen3RMSNorm((128,), eps=1e-06)
        )
        (mlp): Qwen3MLP(
          (gate_proj): Linear(in_features=1024, out_features=3072, bias=False)
          (up_proj): Linear(in_features=1024, out_features=3072, bias=False)
          (down_proj): Linear(in_features=3072, out_features=1024, bias=False)
          (act_fn): SiLU()
        )
        (input_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
        (post_attention_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
      )
    )
    (norm): Qwen3RMSNorm((1024,), eps=1e-06)
    (rotary_emb): Qwen3RotaryEmbedding()
  )
  (lm_head): Linear(in_features=1024, out_features=151936, bias=False)
)

对照今天讲的内容,逐行认一下:

  • embed_tokens:嵌入层,把词表里 151936 个 token 各映射成 1024 维向量,上一篇的主角
  • layers:28 个 Transformer Block 叠在一起,(0-27): 28 x 表示同一结构重复 28 次
  • q_proj / k_proj / v_proj:Query、Key、Value 的三个投影矩阵
  • q_proj 输出 2048 而 k_projv_proj 输出 1024:2048 = 16 头 × 128 维,1024 = 8 头 × 128 维。这组数字就是 GQA 的直接证据,16 个查询头配 8 组 K/V
  • o_proj:多头结果拼接后的输出投影,把 2048 维压回 1024 维
  • q_norm / k_norm:Qwen3 在 Q 和 K 上额外加的小 RMSNorm,用来稳定训练
  • gate_proj / up_proj / down_projSiLU:SwiGLU 结构的三件套,中间维度 3072
  • input_layernorm / post_attention_layernorm:Pre-Norm 结构里的两个 RMSNorm,分别在注意力和 FFN 之前
  • rotary_emb:RoPE 位置编码的实现,上一篇讲过
  • norm:所有 Block 走完之后最后一次归一化
  • lm_head:1024 维到 151936 维的线性映射,输出 logits

再顺手跑一次前向传播,看看 logits 长什么样:

import torch
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")
inputs = tokenizer("我爱吃苹果", return_tensors="pt")

with torch.no_grad():
    outputs = model(**inputs)

print(outputs.logits.shape)

结果如下:

torch.Size([1, 3, 151936])

输出形状的最后一维 151936 就是词表大小,中间一维 3 是这次分词得到的 token 数。每个位置都有一份完整的词表分数,但自回归生成只取最后一个位置的 logits 来决定下一个 token,前面位置的结果是顺带算出来的。

这里埋个彩蛋:这些被扔掉的分数并不是废品。后面讲到推理加速的时候,会有一项技术专门把它们捡起来当验收标准用,一次前向就能验好几个 token,到时候记得回来看这一行。

小结

今天我们把一个向量序列从嵌入层到 logits 的完整旅程走完了:

  1. Transformer Block 结构:现代 Block 从原始 Transformer 的解码器演化而来,拿掉了交叉注意力,剩下注意力和前馈网络两段。骨架上有三个关键设计:残差连接给信息和梯度留了一条直通旁路,深层网络才训得动;RMSNorm 按均方根做等比缩放,把数值拉回稳定范围;Pre-Norm 把归一化放在子层之前,让残差旁路畅通。主流模型的 Block 都是这套组合,整个模型就是几十个 Block 叠起来
  2. 注意力机制:每个 token 通过三个投影矩阵得到 Query、Key、Value,Q 和 K 的点积给出 token 之间的注意力分数,再按分数对所有 token 的 Value 加权求和,token 之间的信息交换就完成了
  3. 因果掩码:分数矩阵上三角置为负无穷,保证每个位置只能看到自己和左边的 token,训练和生成行为一致
  4. 注意力头的演进:MHA 到 MQA 到 GQA 再到 DeepSeek 的 MLA,一路都在压缩 KV 缓存,用更小的显存换尽量不掉的质量
  5. FFN 与 SwiGLU:对每个 token 单独加工的两层 MLP,先放大再压回,中间靠激活函数引入非线性;现在主流用带门控的 SwiGLU。FFN 占了模型约三分之二的参数,可以解读成模型的键值记忆库;MoE 版本把参数和计算解耦,每次只激活部分专家,DeepSeek、Qwen 的大模型都在用
  6. logits:最后一层出来后再过 RMSNorm 和 lm_head。lm_head 本质是一个词表大小的矩阵,每行是一个 token 的代表向量,输出就是隐藏向量和每个 token 的匹配分数,下一个 token 从这些分数里采出来

不过这里藏着一个小问题。今天我们一直在描述一遍前向传播,但生成是逐 token 进行的:每生成一个新 token,都要把变长了一位的整段序列重新送进模型。如果每一步都把历史 token 的 K、V 从头重算一遍,序列越长算得越慢,而且绝大部分计算是完全重复的。这个浪费怎么消除,就是下一篇的主角 KV Cache。我们明天继续。

参考

学习大模型推理的嵌入与位置编码

在上一篇中,我们看了分词器如何用 BPE 算法把一句话切成子词,再映射成一串整数,也就是 token id 序列。这串整数是分词阶段的终点,却不是模型计算的起点。

token id 说到底只是编号,和字典里每个词条的序号没有区别,编号本身不带任何语义信息。模型真正处理的是向量。今天这篇就来讲 token id 之后发生的事:它怎么先被嵌入层变成稠密向量,又怎么被位置编码注入顺序信息,最后才进入 Transformer 层参与计算。

嵌入层查表

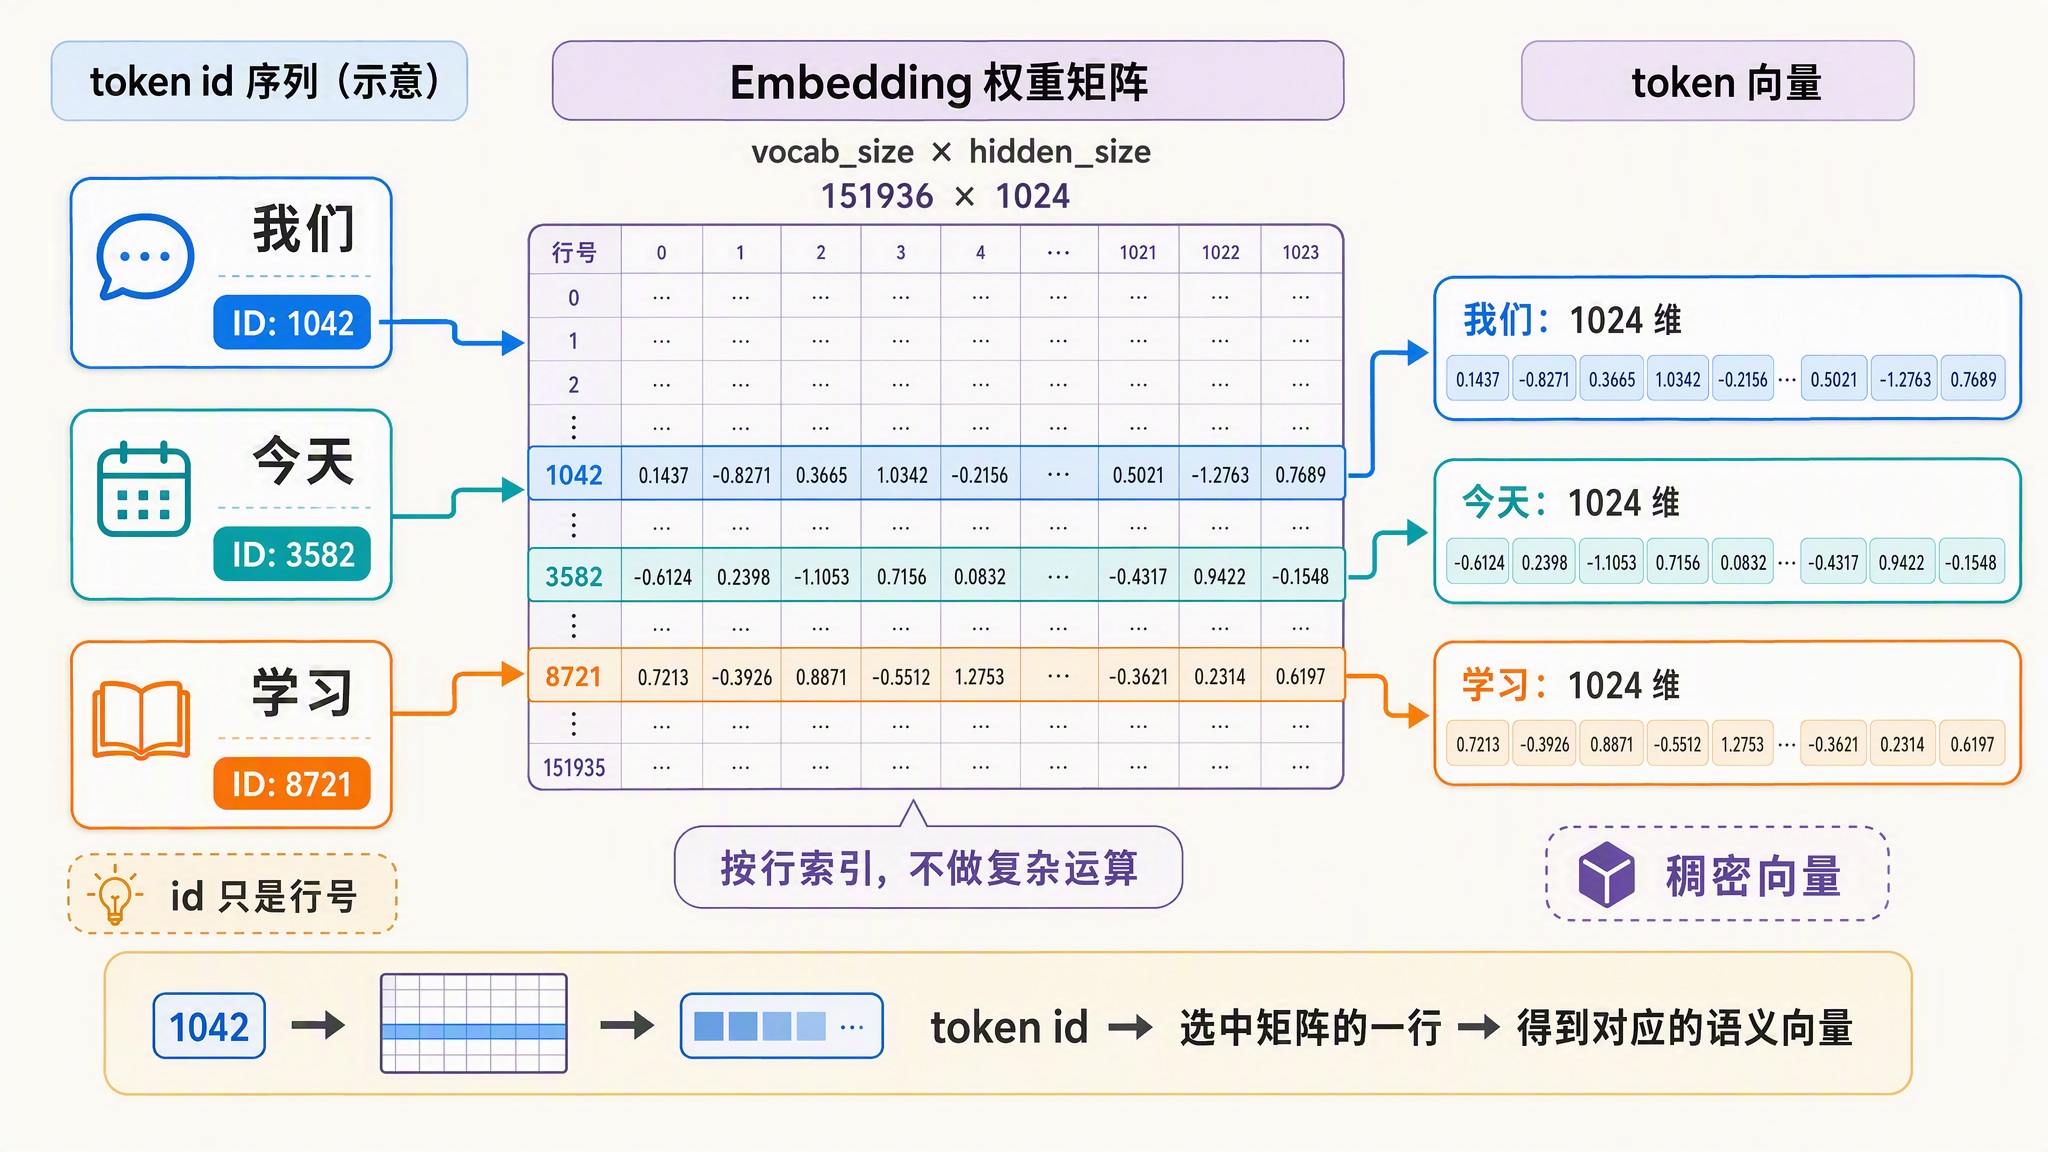
嵌入(Embedding) 是把离散的 token id 映射为连续向量的过程。它的实现非常直接:就是一张形状为 vocab_size × hidden_size 的二维矩阵,每一行对应词表里一个 token 的向量。token id 进来,按行号取出对应那一行,查表完成,没有任何复杂运算。

以 Qwen3-0.6B 为例,它 config 里的 vocab_size 是 151936,隐藏层维度是 1024,所以嵌入矩阵就是一个 151936 行、1024 列的浮点数表格。上一篇讲过,这个 vocab_size 比词表实际条目略多,多出来的是对齐预留位,不影响查表。每个 token 被表示成一个 1024 维的稠密向量(Dense Vector),即每个维度都是一个实数、没有大量零元素的向量。

embedding-lookup.jpg

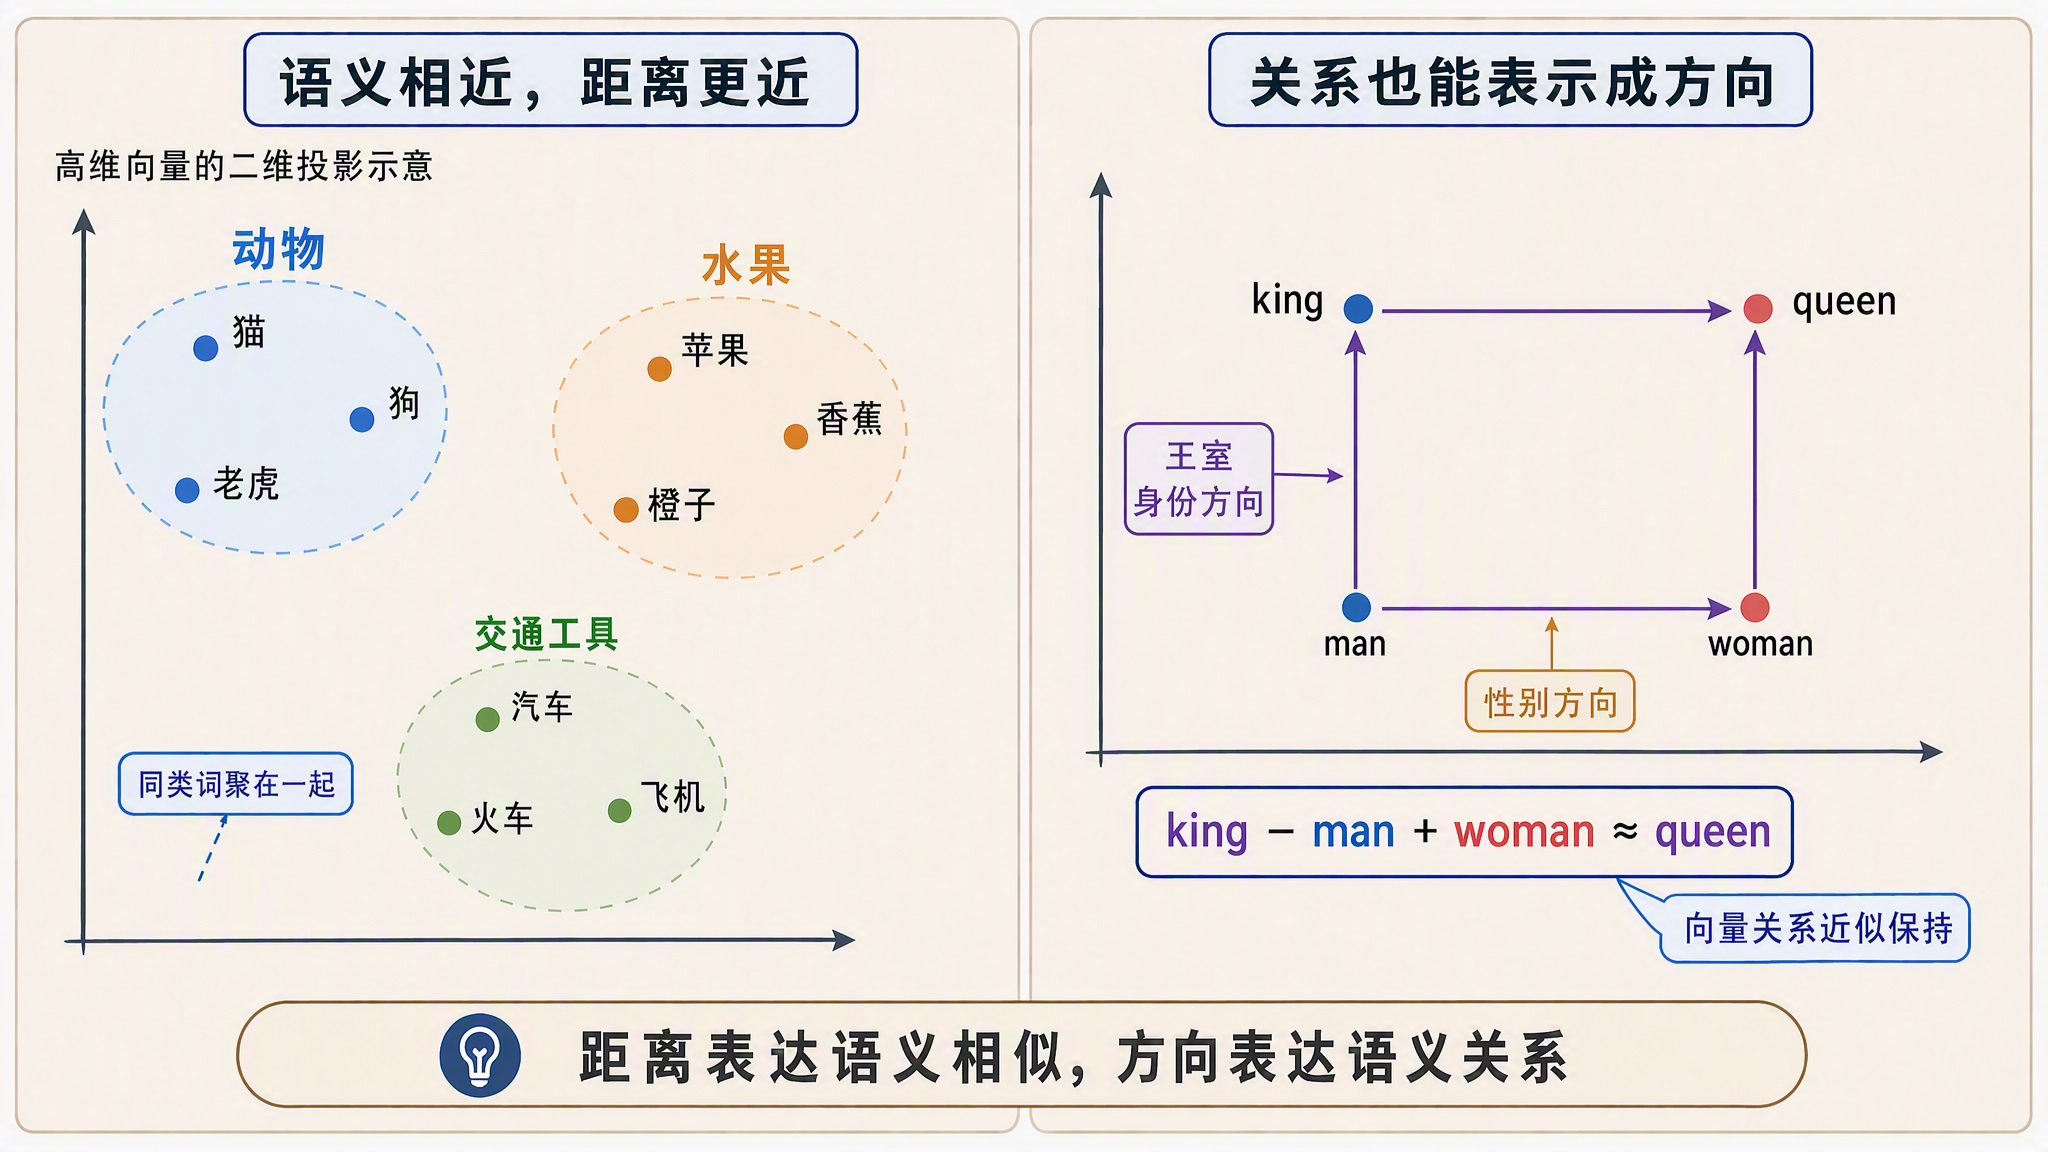
这张表是在训练过程中和模型其他参数一起学出来的。学出来的结果有一个著名性质:语义相近的词,向量在空间中也相近。这就是词向量(Word Embedding) 的语义性。2013 年 Mikolov 等人提出 word2vec,论文里给出了一个流传至今的例子:

king - man + woman ≈ queen

对 king 的向量减去 man 的向量、加上 woman 的向量,结果最接近的词是 queen。这说明向量里编码了性别、王室身份这类语义维度,词与词的关系变成了可以计算的向量运算。他们在随后的另一篇论文里用词类比任务对这类线性关系做了系统研究,比如国家与首都、形容词比较级、动词时态都能用向量加减算出来。

词向量在语义空间里的分布大致如下图所示:

word-vector-space.jpg

要注意的是,大模型词表里的单位是子词(subword)而不是完整的词,像 unbelief 会被拆成 un、belief 两个 token,各有各的向量。所以现代模型的嵌入表更像是子词向量表,词一级的语义靠模型后续层组合出来。

动手看看嵌入矩阵

下面我们通过一个简单的示例来体验下。用 Hugging Face transformers 加载 Qwen/Qwen3-0.6B,直接看它的嵌入层:

import torch
from transformers import AutoModelForCausalLM

model_name = "Qwen/Qwen3-0.6B"
model = AutoModelForCausalLM.from_pretrained(model_name, dtype=torch.float32)

# 输入嵌入层,本质就是一个 nn.Embedding
emb = model.get_input_embeddings()
print(emb.weight.shape)

输出:

torch.Size([151936, 1024])

可以看到,形状正是 vocab_size × hidden_size。词表里 15 万多个 token,每个都有自己专属的一行向量。

再验证一下语义性。取两组词算余弦相似度(Cosine Similarity),它衡量两个向量方向的接近程度,取值在 -1 到 1 之间,越接近 1 表示越相似:

import torch.nn.functional as F
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained(model_name)

def vec(word):
    # 这几个词都是单个 token,直接取出对应行的向量
    token_id = tokenizer.encode(word, add_special_tokens=False)[0]
    return emb.weight[token_id]

pairs = [("猫", "狗"), ("猫", "汽车")]
for a, b in pairs:
    sim = F.cosine_similarity(vec(a), vec(b), dim=0)
    print(f"{a} vs {b}: {sim.item():.4f}")

输出:

猫 vs 狗: 0.4233
猫 vs 汽车: 0.1562

「猫」和「狗」同为动物,向量方向明显比「猫」和「汽车」更接近。词向量的语义是统计意义上的相近,绝对数值谈不上大,但相对关系是清楚的。

注意力不知道顺序

嵌入向量解决了语义问题,但还有一个问题没解决:顺序。

大模型的核心是注意力机制,细节我们留到下一篇展开。这里只需要知道一点:注意力计算是把一批向量放在一起两两做点积,它关心的是向量的集合,不关心谁先谁后。把输入顺序打乱,只要还是那几个向量,算出来的结果就不变。这个性质有个专门的名字,叫置换等变(Permutation Equivariance):输入怎么排列,输出就怎么跟着排,计算本身对先后顺序零感知。

口说无凭,我们用 NumPy 手写一个最简注意力验证一下,Q、K、V 投影用随机矩阵代替:

这里的注意力实现做了大量简化,你不需要看懂每一行,注意力机制的细节下一篇会专门展开。现在只需关注实验的设计:同一批向量,打乱顺序送进去,看结果变不变。

import numpy as np

rng = np.random.default_rng(0)
d = 8
Wq, Wk, Wv = (rng.normal(size=(d, d)) for _ in range(3))  # 三个 8×8 投影矩阵

def attention(x):
    # 最简自注意力:softmax(QKᵀ/√d)V
    # @ 是矩阵乘法运算符:(4,8) @ (8,8) -> (4,8),一次算出所有 token 的投影
    # Wq, Wk, Wv 是可学习的参数(真实模型里从训练中学出来,这里用随机矩阵代替)
    q, k, v = x @ Wq, x @ Wk, x @ Wv
    # k.T 是转置,(4,8) @ (8,4) -> (4,4),得到 4 个 query 对 4 个 key 的两两打分表
    scores = q @ k.T / np.sqrt(d)
    # softmax:对每行分数先取 exp 再归一化,转成和为 1 的权重
    # 分数越高的 key 权重越大;减去最大值是为了防止 exp 数值溢出,不改变结果
    scores = np.exp(scores - scores.max(axis=-1, keepdims=True))
    weights = scores / scores.sum(axis=-1, keepdims=True)
    return weights @ v

x = rng.normal(size=(4, d))  # 4 个 token,每个 8 维
out1 = attention(x)

perm = [2, 0, 3, 1]          # 打乱后的 token 顺序
# 花式索引:用数组当下标,按给定顺序取行
# x[perm] 等价于 [x[2], x[0], x[3], x[1]],即打乱语序后的输入
out2 = attention(x[perm])

# argsort 求逆排列:inv[i] 表示原位置 i 的 token 被打乱到了哪里
# out2[inv] 把打乱的输出按原顺序排回去,这样才能和 out1 逐位置对比
inv = np.argsort(perm)
print(f"打乱前后的最大差异: {np.abs(out1 - out2[inv]).max():.2e}")

输出:

打乱前后的最大差异: 1.78e-15

打乱后每个位置的输出,和它原来位置的输出完全一致,差异是 10⁻¹⁵ 级别的浮点误差。注意力确实对顺序没有任何感知。

这会带来一个直观的问题。「狗咬人」和「人咬狗」用的是同样的三个字,分词后 token 集合一样,查出来的向量集合也一样。如果没有位置信息,在注意力看来这两句话完全等价,但它们的含义显然相反。中文是这样,英文里也一样。

所以必须在向量进入 Transformer 之前,把顺序信息注入进去,这就是位置编码(Positional Encoding) 要干的事。早期的循环(RNN)和卷积(CNN)结构天然按顺序读文本,而纯注意力结构本身没有顺序概念,位置信息只能显式注入。位置编码方案的好坏,直接影响模型对语序、指代、因果这类依赖顺序的语言现象的理解能力。

从文本到 Transformer 层的完整链路如下:

position-encoding-pipeline.png

位置编码的做法经历了几次演进,我们按时间线依次看。

正弦绝对位置编码

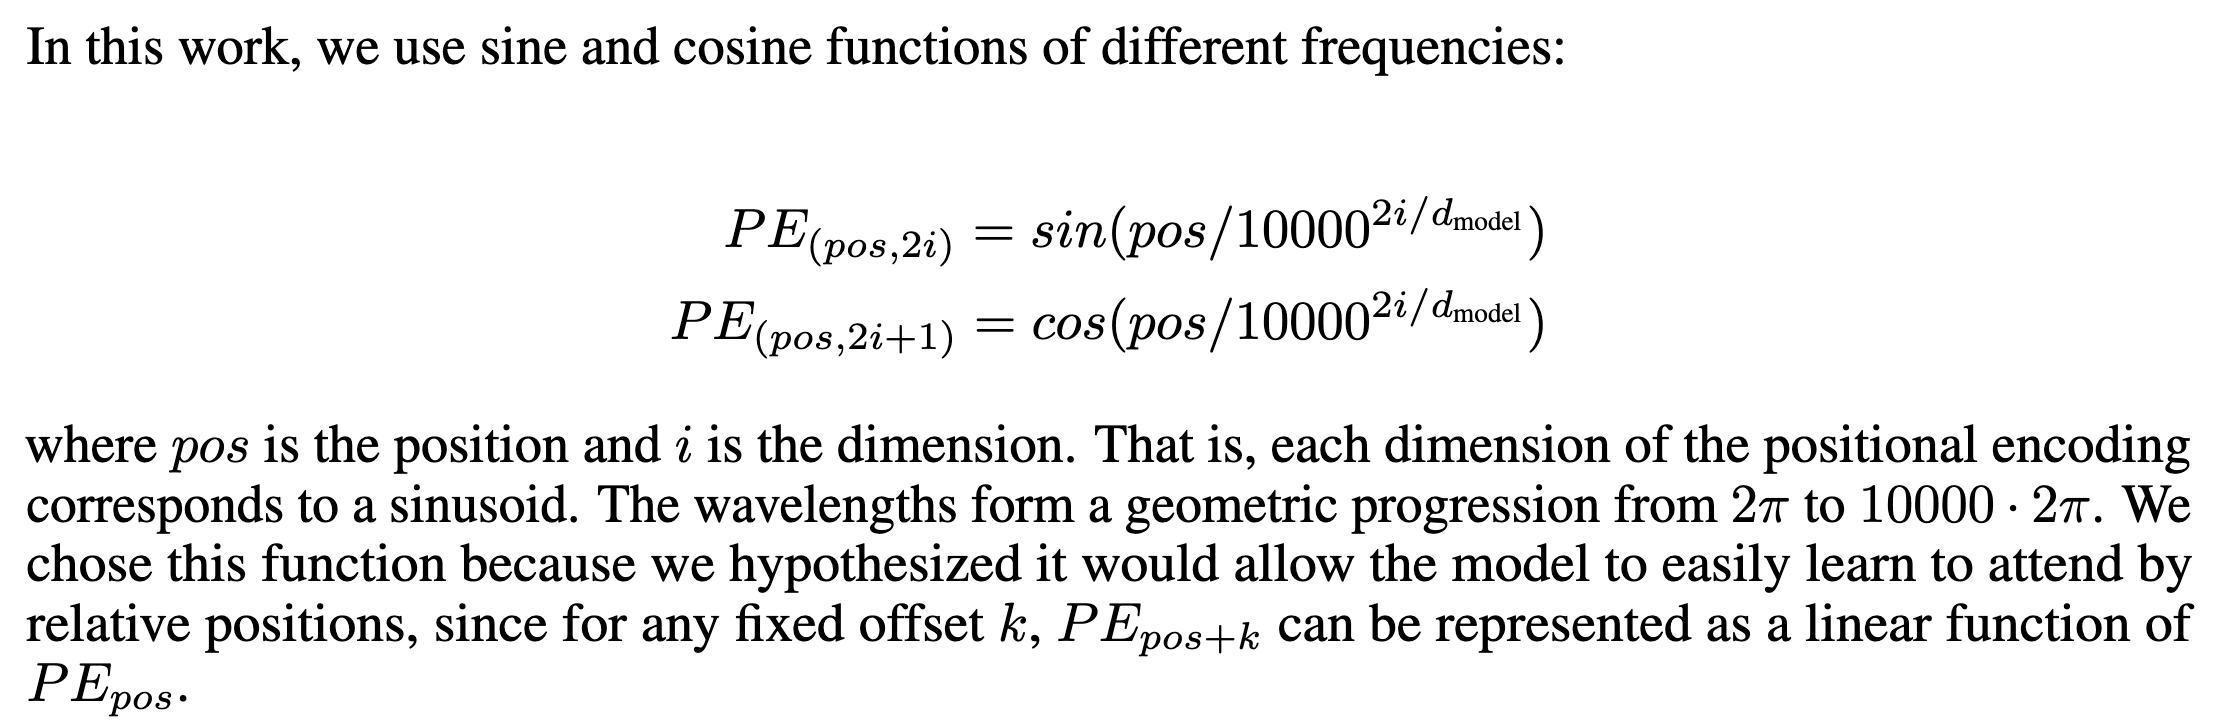
2017 年的 Transformer 原论文 Attention Is All You Need 用的是正弦位置编码(Sinusoidal Positional Encoding)。做法是给每个位置生成一个固定的向量,偶数维度填正弦值,奇数维度填余弦值,不同维度用不同频率。位置编码的维度和嵌入向量相同(都是论文里的 d_model),所以两者能直接相加,加出来的和就是带进模型的向量。

为什么偏偏是正弦和余弦?我们可以从最直接的想法倒推。给向量注入位置信息,最容易想到三个办法,但每个都有毛病:

  1. 直接用位置编号:把 0、1、2、3 这样的整数塞进向量。数值无界,位置到几千的时候,编号比嵌入值大好几个数量级,训练不稳定
  2. 编号归一化:除以序列长度压到 0 到 1 之间。数值有界了,但同一个值在不同长度的序列里含义不同,0.5 在 10 个词的句子里是第 5 个词,在 1000 个词的句子里是第 500 个词
  3. 二进制编码:把位置写成二进制数,每一位占一个维度。有界、唯一、和序列长度无关,前面几个问题都解决了,但每一位都在 0 和 1 之间硬跳变,不平滑

正弦编码可以看成二进制编码的连续版。二进制从低位到高位,翻转周期按 2、4、8、16 翻倍;正弦编码从低维到高维,波长同样按几何级数拉长,区别只是把硬跳换成了平滑的正弦波。

论文里的公式长这样:

pe.png

公式里 pos 是位置编号,i 是维度编号。关键在分母 10000^(2i/d),把公式换个写法 sin(pos × ω),其中 ω = 1/10000^(2i/d),这个 ω 就是每个维度的频率:ω 越大,pos 每增加 1,正弦波走得越快;ω 越小,波走得越慢。维度编号 i 越大,指数越大,ω 就越小。以 8 维为例,四个维度对的频率和波长如下:

维度对 i频率 ω波长(约多少个位置)
016.3
10.163
20.01628
30.0016283

频率按 ω = 1/10000^(2i/d) 代入 i 和 d=8 算出;波长是波形走完一个周期需要的位置数,即 2π/ω。10000 恰好是 10⁴,d=8 时分母正好是 10 的整数次幂,所以数字格外整齐。

这就像钟表:秒针转得快,用来分辨相邻的秒;时针转得慢,用来定位大致在几点。只看一根针会有歧义,所有维度合起来,每个位置才有独一无二的指纹。

sinusoidal-position-encoding.png

论文中的两行公式看着唬人,代码实现其实很简单。我们用一个 8 维的迷你版本,把前几个位置的编码算出来看看:

import math

def sinusoidal_pe(pos, d_model=8):
    # 偶数维度填 sin,奇数维度填 cos,频率随维度指数下降
    return [
        math.sin(pos / 10000 ** (i / d_model)) if i % 2 == 0
        else math.cos(pos / 10000 ** ((i - 1) / d_model))
        for i in range(d_model)
    ]

for pos in range(4):
    print(f"位置 {pos}:", [round(x, 2) for x in sinusoidal_pe(pos)])

# 对比一下相邻位置和相隔很远的位置,编码差多少
def dist(a, b):
    return math.sqrt(sum((x - y) ** 2 for x, y in zip(a, b)))

for pos in list(range(1, 11)) + [100, 1000]:
    print(f"位置 0 和 {pos} 的距离:", round(dist(sinusoidal_pe(0), sinusoidal_pe(pos)), 2))

# 同样的间隔,换个起点再算一遍
for gap in [1, 5, 100]:
    a = dist(sinusoidal_pe(0), sinusoidal_pe(gap))
    b = dist(sinusoidal_pe(100), sinusoidal_pe(100 + gap))
    print(f"间隔 {gap}: 起点 0 算得 {a:.4f}, 起点 100 算得 {b:.4f}")

输出:

位置 0: [0.0, 1.0, 0.0, 1.0, 0.0, 1.0, 0.0, 1.0]
位置 1: [0.84, 0.54, 0.1, 1.0, 0.01, 1.0, 0.0, 1.0]
位置 2: [0.91, -0.42, 0.2, 0.98, 0.02, 1.0, 0.0, 1.0]
位置 3: [0.14, -0.99, 0.3, 0.96, 0.03, 1.0, 0.0, 1.0]
位置 0 和 1 的距离: 0.96
位置 0 和 2 的距离: 1.69
位置 0 和 3 的距离: 2.02
位置 0 和 4 的距离: 1.86
位置 0 和 5 的距离: 1.3
位置 0 和 6 的距离: 0.66
位置 0 和 7 的距离: 0.98
位置 0 和 8 的距离: 1.7
位置 0 和 9 的距离: 2.14
位置 0 和 10 的距离: 2.15
位置 0 和 100 的距离: 2.21
位置 0 和 1000 的距离: 2.4
间隔 1: 起点 0 算得 0.9641, 起点 100 算得 0.9641
间隔 5: 起点 0 算得 1.2962, 起点 100 算得 1.2962
间隔 100: 起点 0 算得 2.2097, 起点 100 算得 2.2097

从运行结果我们可以看到三个规律。一是不同维度的变化速度不同:前两个维度变得最快,位置每加 1 数值就明显不同;越靠后的维度变得越慢,最后一对几乎不动,和上面的频率表完全对得上。二是编码距离只和间隔有关,和起点无关:间隔同为 1,位置 0 到 1 和位置 100 到 101 算出的距离都是 0.9641,间隔 100 时两个起点都算得 2.2097。这不是巧合,用差角公式可以严格证明:每个维度对对距离平方的贡献是 2(1 − cos(ωk)),只含间隔 k,不含起点。也就是说,正弦编码的距离结构天生就是相对的。三是距离随间隔先升后饱和,不是越远越大:间隔从 1 到 3 距离升到 2.02,间隔 5 又回落到 1.30,间隔 1000 也只有 2.4,之后就在这个量级振荡,不再持续增大。原因还是周期性:每个维度对的贡献最大只有 4,波形转完一圈还会回来,合起来的距离自然有界。不过有界不等于撞车:两个不同位置的编码只是距离有上限,并不会变得相同,慢速维度上总差着一截。多频率组合保证的是每个位置的编码独一无二,而不是距离随间隔无限拉大。

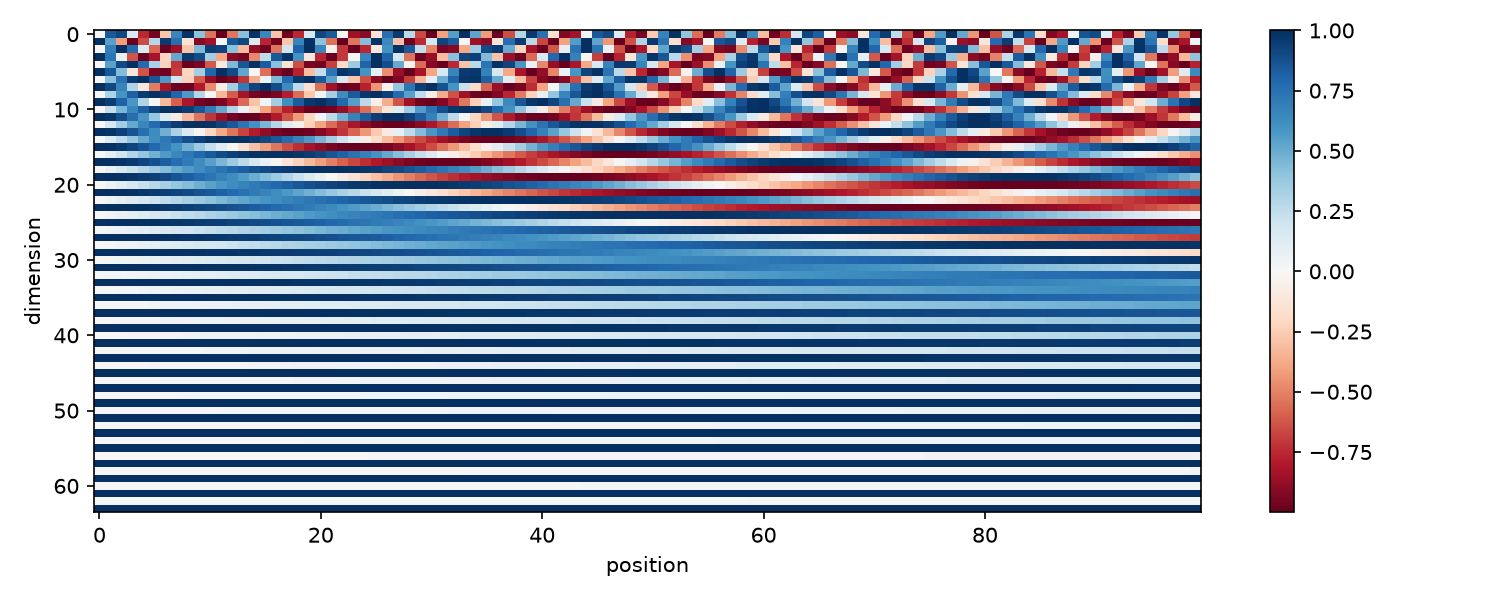
不过这样看还不够直观,我们可以把更多位置和维度画成一张热力图:

import numpy as np
import matplotlib.pyplot as plt

d_model, max_pos = 64, 100
positions = np.arange(max_pos)[:, None]
omega = 1 / 10000 ** (2 * np.arange(d_model // 2) / d_model)
angles = positions * omega                    # (100, 32) 个角度

pe = np.zeros((max_pos, d_model))
pe[:, 0::2] = np.sin(angles)                  # 偶数维度填 sin
pe[:, 1::2] = np.cos(angles)                  # 奇数维度填 cos

plt.figure(figsize=(10, 4))
plt.imshow(pe.T, aspect="auto", cmap="RdBu")
plt.xlabel("position")
plt.ylabel("dimension")
plt.colorbar()
plt.show()

生成的图如下所示:

sinusoidal-heatmap.png

横轴是位置,纵轴是维度。低维区域条纹细密,波形高频振荡;高维区域几乎一整片不变,波长极长。每一列就是一个位置 64 个维度取值的组合,任意两列都不相同,这就是每个位置的指纹。

正弦位置编码有两个特点。一是不需要学习参数,公式直接算出来;二是位置之间存在数学上的线性关系:位置 pos + k 的编码等于位置 pos 的编码乘上一个只和 k 有关的矩阵,效果是把每个维度对旋转 k×ωᵢ 角度,模型有机会学出相对位置的概念。

这个线性关系用三角恒等式展开就能看到,对频率为 ω 的维度对:

sin-cos-pair.png

k 固定时,cos(ωk)sin(ωk) 都是常数,所以 pos + k 的编码恰好是 pos 的编码在每个维度对上旋转 ωk 角度:

sin-cos-pair-2.png

不过它是绝对位置编码(Absolute Positional Encoding),每个位置的编码只跟自己的序号有关,加在语义向量上之后,语义和位置混在同一个向量空间里。

RoPE 旋转位置编码

现在主流的开源模型,包括 Qwen、Llama、DeepSeek、Gemma 等,用的都是 RoPE(Rotary Positional Embedding,旋转位置编码)。它由苏剑林在 2021 年的 RoFormer 论文中提出,论文标题是 Enhanced Transformer with Rotary Position Embedding

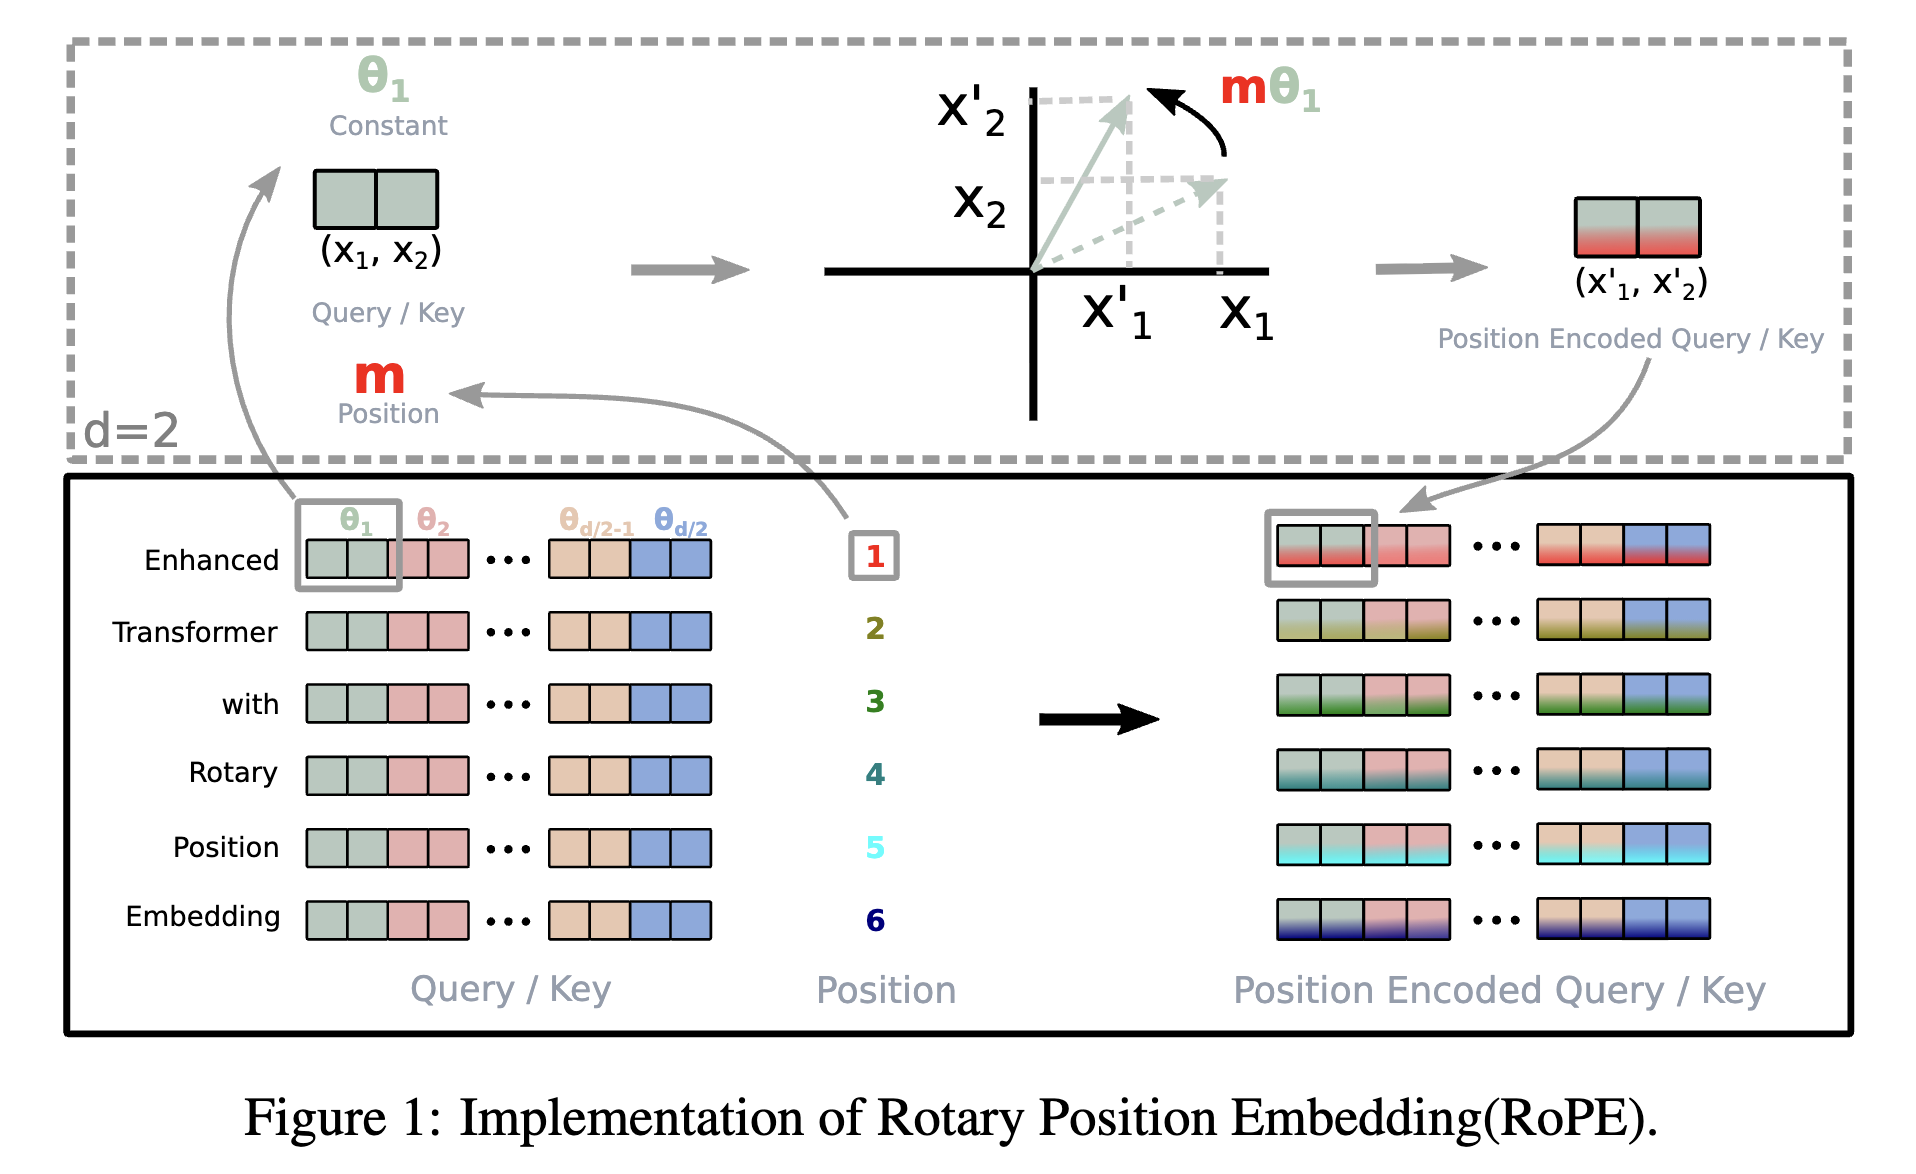
上一节我们看到,正弦编码里位置平移 k 等价于把每个维度对旋转一个固定角度。RoPE 把这个关系反过来用:不给嵌入向量加位置信息,而是直接按位置旋转向量。注意力机制里,每个 token 的向量会被变换成 query 和 key 两种角色,靠它们的内积来两两打分。RoPE 的做法是把 query 和 key 向量按维度两两分组,每一组看成一个二维平面上的小箭头。位置为 m 的 token,把它的每组箭头都旋转一个与 m 成正比的角度,位置越靠后,转得越多。不同维度组的旋转速度不一样,类似钟表上时针、分针、秒针各转各的,所有维度组的旋转速度由同一个基底频率推出来。要注意旋转只发生在每层注意力的 query 和 key 上,嵌入层出来的向量本身不动。

旋转的效果如下图所示:

rope-rotation.png

旋转操作用矩阵写出来,就是线性代数里标准的二维旋转矩阵,每个维度对各乘一个:

R(θ) = [ cos θ  −sin θ ]
       [ sin θ   cos θ ]

角度 θ = m × ωᵢ,由 token 的位置 m 和这个维度对的频率 ωᵢ 共同决定,位置越靠后,角度越大。是不是很眼熟?和上一节正弦编码用的是一样的思想,区别只在:正弦编码把 sin、cos 的值直接到嵌入向量上,RoPE 把它们组成旋转矩阵在 query 和 key 上。

为什么这样做有效?关键在于注意力算的是 query 和 key 的内积,而两个向量各自旋转之后,它们的内积只取决于转过的角度差。位置 m 的 query 和位置 n 的 key,内积里自动带上了 m - n 这个相对位置。模型不用关心每个 token 的绝对序号,就能知道两个 token 之间隔了多远。相对位置信息就这样自然地进了注意力分数。

我们可以用代码验证一下「内积只取决于角度差」:

def rotate(x, y, pos, omega=1.0):
    # 把二维箭头 (x, y) 按位置旋转 pos * omega 角度
    angle = pos * omega
    return (x * math.cos(angle) - y * math.sin(angle),
            x * math.sin(angle) + y * math.cos(angle))

def dot(a, b):
    # 二维向量的点积(内积):对应分量相乘再求和
    # 几何意义是 |a| × |b| × cos(夹角),方向越一致点积越大
    return a[0] * b[0] + a[1] * b[1]

q = (1.0, 0.0)
k = (0.8, 0.6)

# 两组不同的绝对位置,相对距离都是 2
print(round(dot(rotate(*q, 5), rotate(*k, 3)), 4))
print(round(dot(rotate(*q, 50), rotate(*k, 48)), 4))

# 相对距离变成 5,分数跟着变
print(round(dot(rotate(*q, 5), rotate(*k, 0)), 4))

输出:

0.2127
0.2127
-0.3484

前两个数一模一样:query 在位置 5、key 在位置 3,和 query 在位置 50、key 在位置 48,只要相对距离都是 2,注意力打出的分完全相同,绝对位置被旋转消掉了。第三个数说明相对距离一变,分数立刻跟着变。这里只看了一对维度,真实的 RoPE 是多对维度各自按不同速度旋转,总内积是所有维度对的结果之和,每一对都只和 m - n 有关。

实现时有一个细节:维度配对有两种方式,GPT-J 式的相邻配对(第 0、1 维一组,第 2、3 维一组)和 GPT-NeoX、Llama 式的前后半配对(第 0 维和第 d/2 维一组)。两者只是维度排列顺序不同,数学上完全等价,内积结果不受影响。

将 RoPE 和正弦绝对位置编码放在一起做个对比:

对比项正弦绝对位置编码RoPE
作用对象加在嵌入向量上旋转 query 和 key 向量
位置类型绝对位置内积中自然体现相对位置
可学习参数
语义与位置混在同一向量空间各走各的通道
典型使用者2017 年原始 TransformerQwen、Llama、DeepSeek 等

和正弦编码相比,RoPE 不是把位置向量加到嵌入上,而是直接作用在注意力的 query、key 上,语义向量和位置信息互不污染。加上实现简单、没有额外参数,它很快成了新模型的默认选择。苏剑林本人的博客科学空间上有一系列推导文章,想深入数学细节的同学可以去读。英文资料推荐 EleutherAI 的 Rotary Embeddings: A Relative Revolution,它从「内积只依赖相对位置」这个设计目标出发反推出旋转形式,他们的实验还发现 RoPE 的训练收敛更快。

RoPE 还有一个性质很符合直觉:两个 token 的相对距离越远,旋转带来的内积差异越杂乱,注意力分数整体呈衰减趋势。也就是说,模型天然更关注离自己近的 token。这种预先写进模型结构里的倾向叫归纳偏置(Inductive Bias),它和自然语言的局部性是一致的。

这个衰减趋势也可以用代码验证。取一个最干净的情形:q 和 k 在每个维度对上都是同向的单位向量,旋转后的内积就等于各维度对 cos((m − n) × ωᵢ) 之和,直接看它随距离的变化:

import numpy as np

d = 128
omega = 1 / 10000 ** (2 * np.arange(d // 2) / d)  # 64 个维度对的频率

for dist in [0, 1, 5, 10, 20, 50, 100, 200, 400]:
    score = np.cos(dist * omega).sum() / (d // 2)  # 归一化,满值为 1
    print(f"距离 {dist}: {score:.3f}")

输出:

距离 0: 1.000
距离 1: 0.970
距离 5: 0.737
距离 10: 0.669
距离 20: 0.608
距离 50: 0.546
距离 100: 0.477
距离 200: 0.306
距离 400: 0.278

距离 0 时内积满值 1,距离拉到 400 时降到 0.28,一路往下。真实的 q、k 方向各异,曲线会有波动,但衰减的整体趋势一致。

其他位置编码

除了正弦编码和 RoPE 这两条线,历史上还有两条路线也简单了解下。BERT 和早期的 GPT 用的是学习式绝对位置编码(Learned Absolute Positional Embedding),给每个位置编号也配一张可训练的查表,和词嵌入一样从数据里学。其实 Transformer 原论文就对比过这条路线,实验发现学习式和正弦版的效果几乎一样,最后选正弦版是出于一个前瞻考虑:公式编码有可能外推到比训练时更长的序列。学习式有个绕不过去的限制:表的长度在训练时就定死了,想支持更长的文本就得重新学,灵活性不如公式编码,后来主流模型基本都放弃了这条路线。

另一条是 ALiBi(Attention with Linear Biases,线性偏置注意力),论文标题叫 Train Short, Test Long。它不改任何向量,直接在注意力分数上减去一个和距离成正比的惩罚项,距离越远扣分越多,把「优先关注近处」写死在公式里。BLOOM、MPT 等模型采用过它,长度外推表现不错,但长程依赖场景下不如 RoPE 灵活,近年的新模型里已经很少见了。

几种代表性方案讲完,回过头总结下,一个好的位置编码应该满足下面这些条件:

  • 唯一性:每个位置要有独一无二的编码,不同位置不能撞车
  • 有界性:编码数值要有界,不能随位置编号无限膨胀,否则会淹没语义信息
  • 相对性:模型关心的往往是两个词隔多远,编码最好能表达相对距离
  • 可外推:训练时没见过的更长序列,推理时编码依然合理
  • 确定性:同样的位置永远算出同样的编码

用这几条标准对照一遍:学习式编码输在可外推,表长训练时就定死了;ALiBi 把相对性简化成线性距离惩罚,换来了外推,牺牲了长程依赖的灵活性;正弦编码五条都满足,但相对位置藏在加法里,要靠模型自己学出来;RoPE 也是五条都满足,相对位置还直接进了内积,这就是它成为主流的原因。

位置编码与上下文长度

位置编码还决定了一件工程上很实际的事:模型能处理多长的上下文。

训练时模型只见过有限范围内的位置。比如训练最大长度是 4096,那么 RoPE 里超出 4096 的旋转角度模型从没见过。推理时硬塞更长的文本,注意力分数会乱掉,生成质量明显下降。这就是位置编码的外推(Extrapolation) 问题,即模型在训练长度之外的表现。

我们看 Qwen3-0.6B 的配置里和位置相关的两个字段:

print(model.config.max_position_embeddings)
print(model.config.rope_parameters["rope_theta"])  # transformers 4.x 里是 config.rope_theta

输出:

40960
1000000

其中 max_position_embeddings 是模型位置编号的上限,Qwen3-0.6B 这里是 40960,比官方标称的 32K 原生上下文略留了余量。rope_theta 就是上一节说的那个基底频率,各维度组的旋转速度都由它推出来,Qwen3 把它从早期模型常用的 10000 调大到了 1000000,让高频维度的旋转放缓,为长上下文留余地。

围绕外推问题有一系列改进方法。位置插值(Position Interpolation,PI) 把长文本的位置等比压缩回训练窗口内;NTK-aware 缩放 调整 RoPE 的基底频率,让不同转速的维度组得到不同程度的拉伸。NTK 这个名字来自神经正切核(Neural Tangent Kernel) 的理论启发,最早是 Reddit 上的一篇社区帖子提出的。YaRN 名字是 Yet another RoPE extensioN 的缩写。它在 NTK 思路上对高频和低频分量区别处理,再加一个注意力温度系数,用少量微调就能把上下文窗口扩到训练长度的好几倍。YaRN 论文里把 LLaMA 系列扩到了 128K。Qwen3 官方也说明了通过 YaRN 可以把上下文从 32K 扩到 128K。这些方法涉及不少公式和细节,我们这里就点到为止了,感兴趣的同学可以进一步查阅相关资料。

小结

今天我们学习了 token id 之后的第一步:

  1. 嵌入层是一张 vocab_size × hidden_size 的查表,把 token id 变成稠密向量;训练让语义相近的词向量相近,经典的 king - man + woman ≈ queen 就是这种语义性的体现
  2. 动手用 Qwen3-0.6B 验证了嵌入矩阵的形状,并用余弦相似度对比了语义相近词与无关词的差异
  3. 注意力是置换等变的,本身不包含顺序信息,我们用 NumPy 最简注意力做了实验:打乱输入,输出只是跟着重排,逐位置的值完全不变
  4. 好的位置编码有五条标尺:唯一、有界、能表达相对距离、可外推、确定。正弦编码可以看成二进制编码的连续版,用一组几何级数的频率给每个位置生成独一无二的指纹
  5. RoPE 把「旋转」从正弦编码的副产品变成了主角:按位置旋转 query 和 key,让相对位置自然体现在内积里,我们还用代码验证了它的距离衰减性质
  6. 位置编码限制了上下文长度,位置插值、NTK、YaRN 等方法通过调整位置或旋转频率做长度外推

向量准备好了,位置信息也注入进去了,接下来就是真正的计算核心:这些向量进入 Transformer 层之后,注意力机制到底是怎么两两打分的,前向传播的完整数据流又长什么样。我们明天继续。

参考


学习大模型推理的分词:从文本到 Token

在上一篇中,我们把一次请求的完整旅程走了一遍,画出了整个系列的地图:你敲下的一句话先经过分词变成 token 序列,然后模型在 Prefill 阶段一口气读完问题,接着进入 Decode 循环一个 token 一个 token 地生成回答,每一步还要经过采样挑出下一个词,最后反分词把 token 还原成文字流式返回给你。

今天我们从地图的第一站开始,把分词这个环节单独拿出来学习。

为什么需要分词

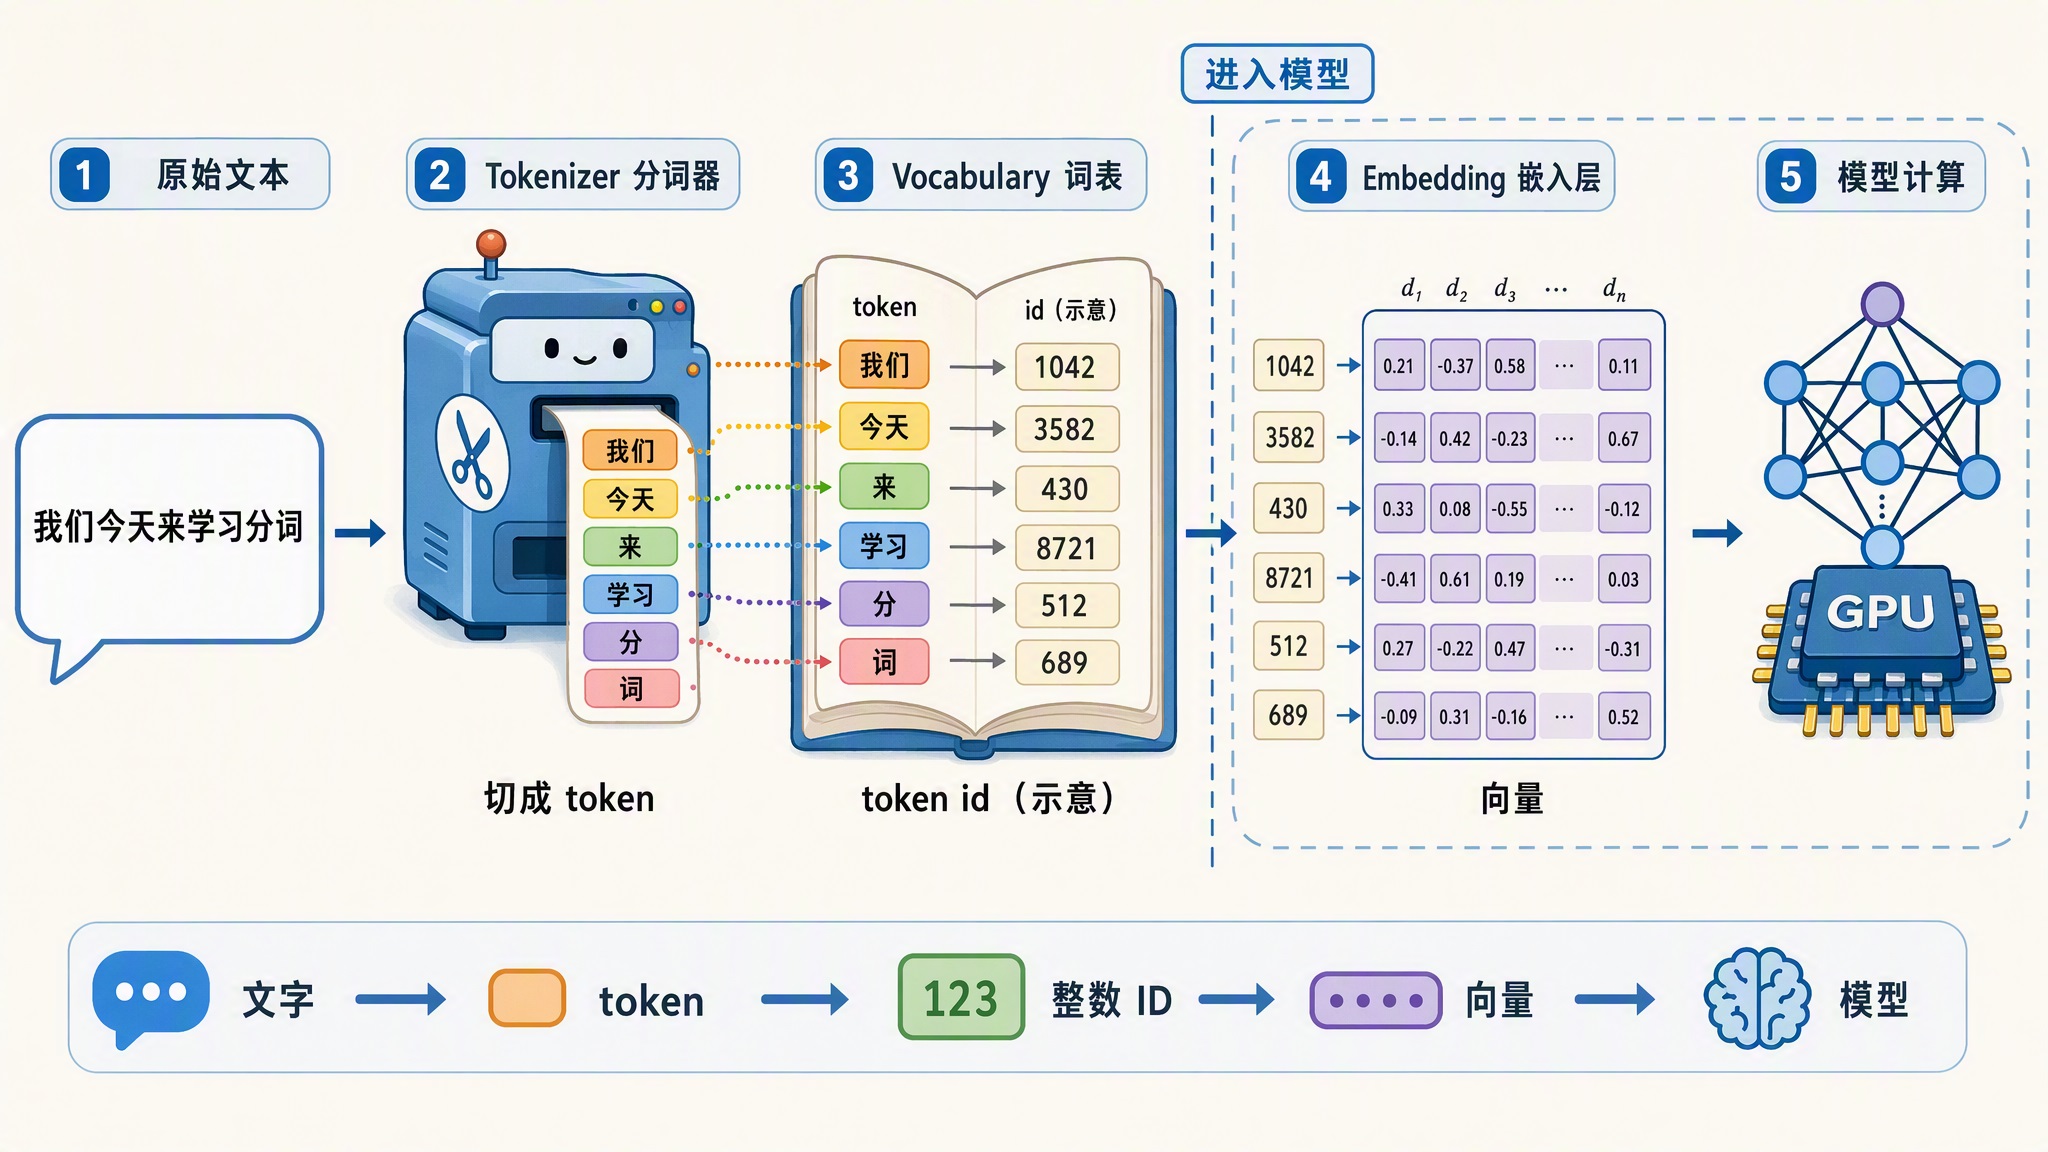
神经网络的计算基本都是矩阵乘法,输入必须是一串数字。但用户给的是自然语言文本,中间需要一座桥把文字翻译成数字,这座桥就是分词(Tokenization)。分词做两件事:先把文本切成一个个片段,每个片段叫一个 token;再查一张对照表,把每个 token 换成一个整数编号,也就是 token id。

这张对照表叫词表(Vocabulary),它在模型训练之前就定好了,训练完成后固定不变。词表里的每个 id 对应模型嵌入层里的一行向量,模型实际读进去的就是这些向量。嵌入层的内容我们留到下一篇讲,今天只需要知道 id 是文本和模型之间的中间货币。

光说对照表可能有点抽象,直接打开它看看。用 Hugging Face transformers 库的 AutoTokenizer 加载分词器,模型选 Qwen3 系列最小的 Qwen3-0.6B,只下载分词器配置,10 MB 出头,不用下载模型权重:

from transformers import AutoTokenizer

# 加载 Qwen3-0.6B 的分词器
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")

# 词表就是一个「token 文本 → id」的大字典
vocab = tokenizer.get_vocab()
print(len(vocab))

# 按 id 排序,看看队头和队尾
vocab_by_id = sorted(vocab.items(), key=lambda kv: kv[1])
print(dict(vocab_by_id[:10]))
print(dict(vocab_by_id[-3:]))

运行结果:

151669
{'!': 0, '"': 1, '#': 2, '$': 3, '%': 4, '&': 5, "'": 6, '(': 7, ')': 8, '*': 9}
{'</tool_response>': 151666, '<think>': 151667, '</think>': 151668}

可以看到,词表就是一个 15 万多个条目的大字典。排在最前面的是标点符号这些 ASCII 字符,id 从 0 开始;排在最后面的是 <think> 这种不对应自然语言的条目,它们属于特殊 token,后面会专门讲。

细心的读者可以顺手试试 vocab["你好"],会发现查不到,报 KeyError 错误。这是因为词表的 key 并不是中文词汇,而是把 UTF-8 字节逐字节映射成可打印字符后的形式(GPT-2 传下来的做法,这样词表文件里不会出现不可见字符),比如「你好」的 6 个字节 b'\xe4\xbd\xa0\xe5\xa5\xbd' 映射后的 key 是 'ä½łå¥½',可以用 tokenizer.tokenize("你好") 来查。

还有一个细节:词表条目是 151669,而上一篇 config 里的 vocab_size 是 151936。前者是分词器词表的条目数,后者是嵌入表的行数,多出来的 267 行没有对应的 token,是把嵌入表凑成 128 的倍数做对齐的预留位,实际用不到。

整个过程可以用一张图概括:

why-tokenization.jpg

分词这一步发生在模型之外,由一个叫分词器(Tokenizer)的独立组件完成。每个模型发布时都会带上自己专属的分词器,不同模型的词表不一样,切分结果也不一样,所以分词器和模型必须配套使用,不能混着用。

Token 不一定是字或词

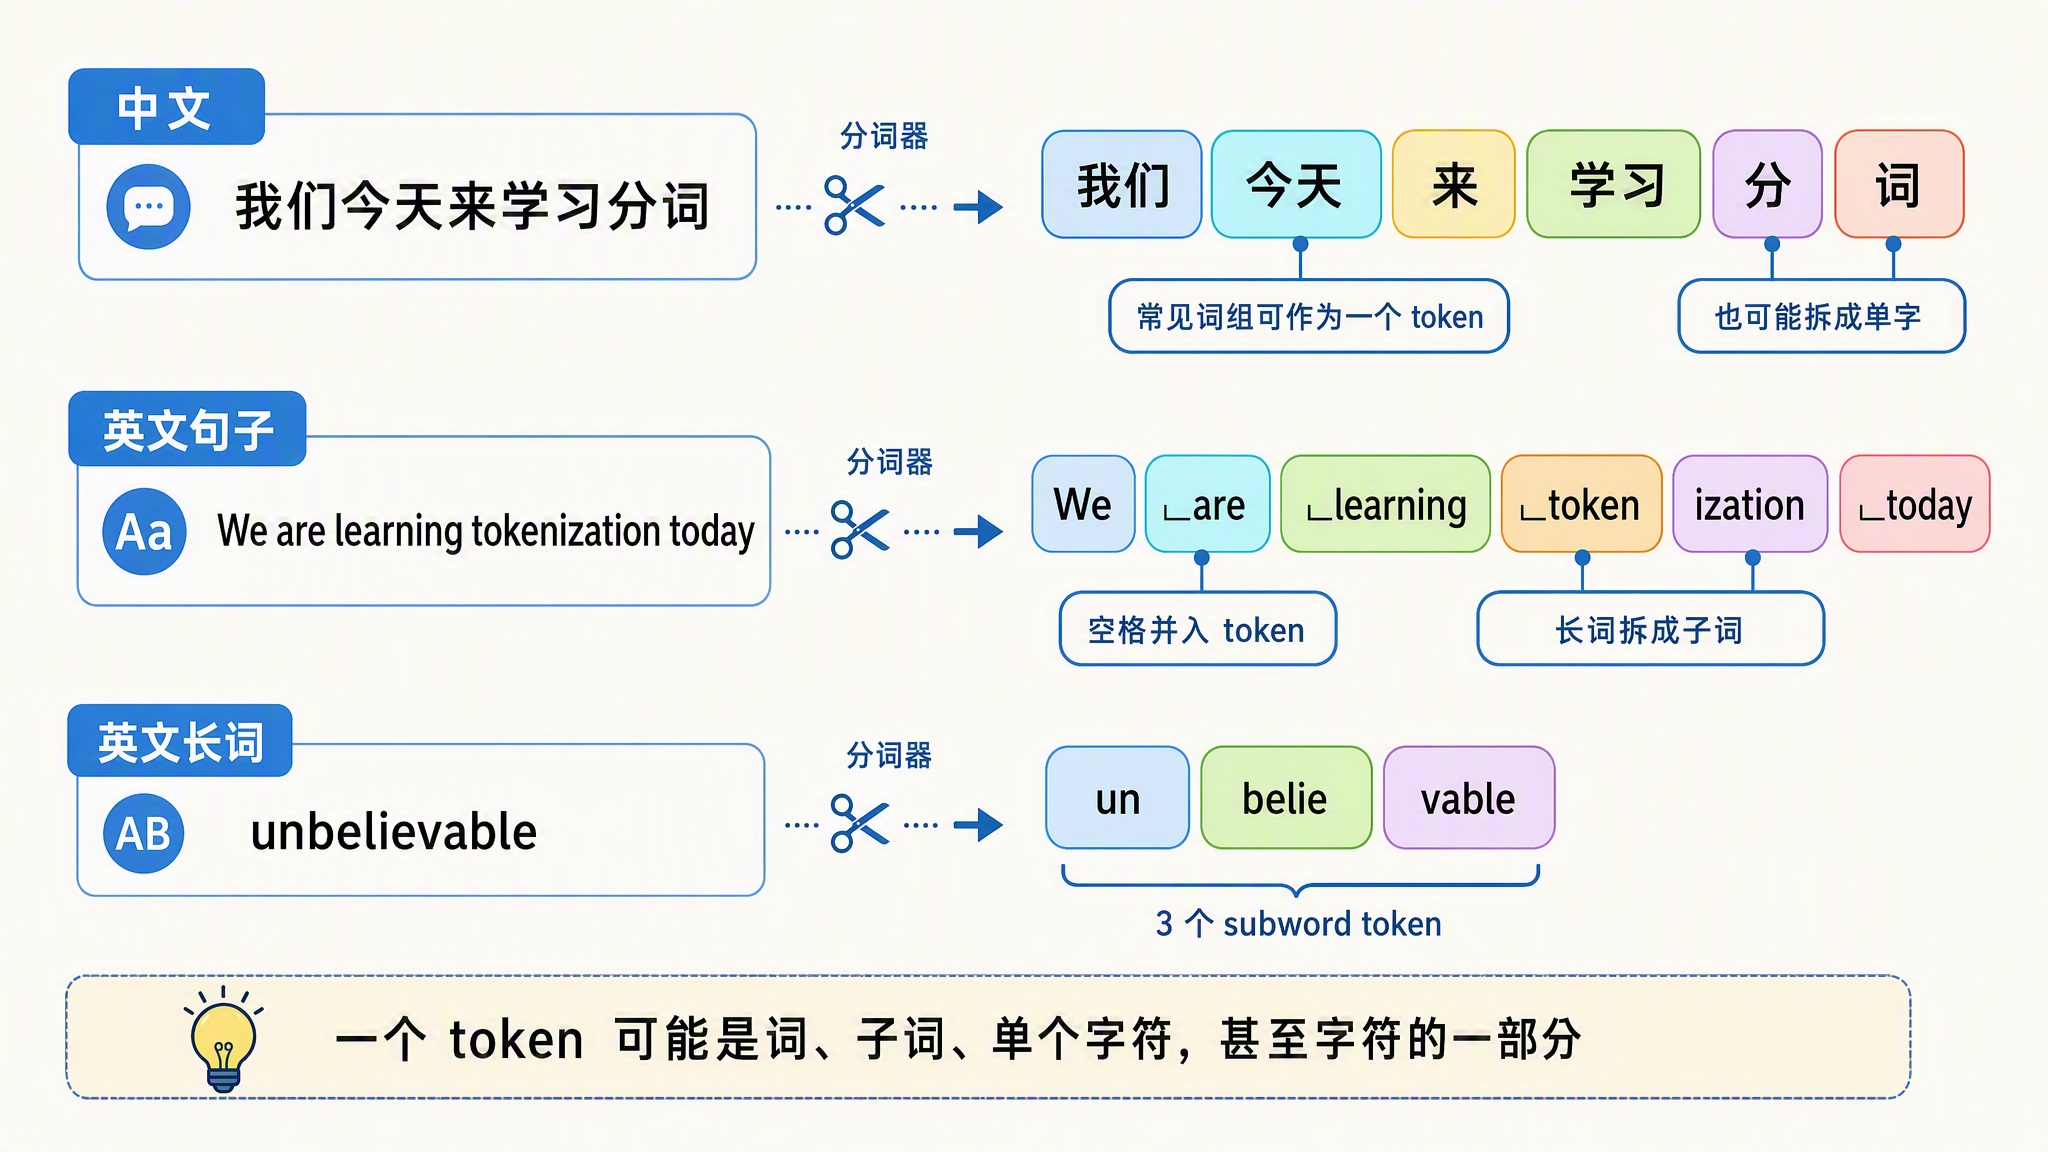
刚接触这个概念时,很多人会默认一个 token 就是一个字或者一个单词,其实都不是。Token(词元) 是分词器切出来的最小单位,它可能是整个词、词的一部分、单个字符,甚至字符的一部分。

我们用刚才加载的 Qwen3 分词器跑几个真实例子:

texts = ["我们今天来学习分词", "We are learning tokenization today", "unbelievable"]
for text in texts:
    ids = tokenizer.encode(text)
    # 逐个 decode 出 token 片段,把空格换成 ␣ 方便看
    tokens = [tokenizer.decode([i]).replace(" ", "␣") for i in ids]
    print(f'"{text}" → {len(ids)} 个 token:{" / ".join(tokens)}')

运行结果:

"我们今天来学习分词" → 6 个 token:我们 / 今天 / 来 / 学习 / 分 / 词
"We are learning tokenization today" → 6 个 token:We / ␣are / ␣learning / ␣token / ization / ␣today
"unbelievable" → 3 个 token:un / belie / vable

可以看到几个规律:

  • 常见中文词组是一个整体:「我们」「今天」「学习」各自占一个 token,但不太常见的组合会被拆开,「分词」就拆成了「分」和「词」
  • 常见英文单词是一个 token,长词会被拆成子词(Subword):tokenization 拆成 token 和 ization,unbelievable 拆成三段
  • 空格是有意义的:英文里单词前的空格通常会并进 token,上面用 ␣ 标出了空格,比如「␣today」整体是一个 token

text-to-tokens-concept.jpg

中英文的差异尤其值得关注。早期针对英文优化的分词器处理中文很浪费,一个汉字可能占 2 到 3 个 token;现在主流的多语言分词器(比如 Qwen 用的)对中文友好了很多,常见汉字和词组大约 1 个 token,生僻字仍然会拆得更碎。

这不是一个纯学术问题。API 计费按 token 算,上下文长度按 token 算,速率限制也按 token 算。同样一段话用中文写还是用英文写,token 数量可能差出一截,账单也跟着差一截。估算成本时拿字数当 token 数,是会算错的。

BPE:从数据压缩借来的算法

那分词器是怎么决定在哪里下刀的?目前主流大模型用的都是 BPE(Byte Pair Encoding,字节对编码) 或者它的变体。

BPE 的历史有点意思。它本来是 Philip Gage 在 1994 年提出的一个数据压缩算法,和自然语言处理没有关系。2016 年,Sennrich 等人在一篇机器翻译论文里把它改造成了子词切分方法,用来解决翻译模型遇到生僻词就抓瞎的问题,这篇论文后来拿了 ACL 2026 的 Test of Time 奖。2019 年 GPT-2 又把它改造成字节级 BPE(Byte-level BPE):不再以字符为起点,而是以 256 个字节为初始词表。这么一改,任何语言、任何符号、任何 emoji 都能被表示,彻底不会出现分词器不认识某个字的情况。

BPE 论文全名是 Neural Machine Translation of Rare Words with Subword Units,arXiv 编号 1508.07909。想了解从零实现一个 BPE 分词器长什么样,可以看 Sebastian Raschka 的 BPE from scratch 一文。

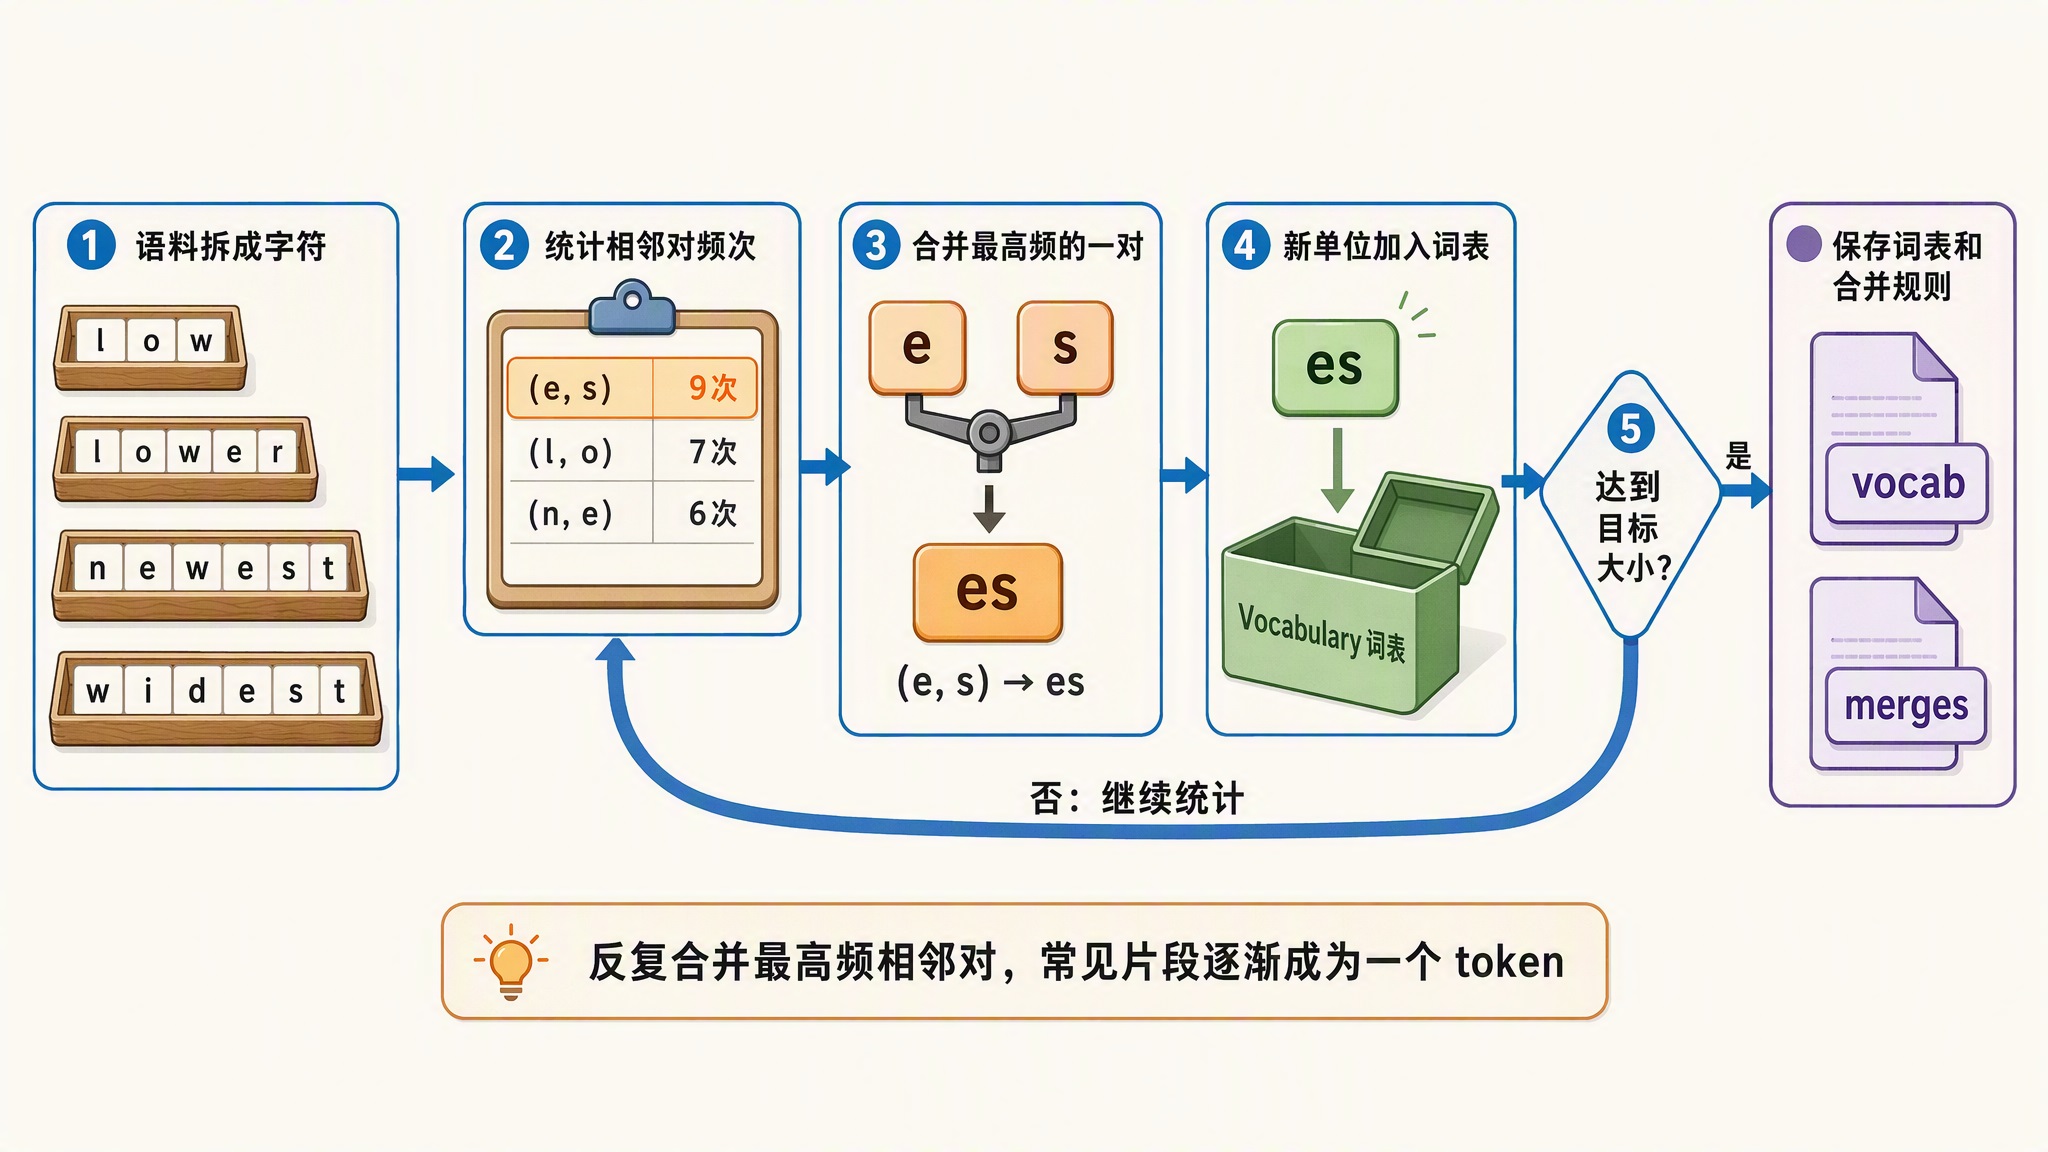
BPE 的核心思路就一句话:反复把语料里出现最频繁的相邻两个单位合并成一个新单位,直到词表达标。训练分词器的过程就是学出一张合并规则表,分词时按同样的规则顺序套用到新文本上。

用一个具体例子演示。假设我们的全部训练语料只有四个词:low 出现 5 次,lower 出现 2 次,newest 出现 6 次,widest 出现 3 次。初始状态每个词拆成单个字符,词尾加一个特殊标记表示单词结束:

low    → l o w </w>     (5 次)
lower  → l o w e r </w> (2 次)
newest → n e w e s t </w>(6 次)
widest → w i d e s t </w>(3 次)

然后开始循环:统计所有相邻对的出现次数,把最高频的一对合并,加入词表。前几轮的过程如下:

轮次最高频相邻对合并结果出现次数
1(e, s)es9
2(es, t)est9
3(l, o)lo7
4(lo, w)low7
5(n, e)ne6
6(ne, w)new6
7(new, est)newest6

表里省略了和词尾标记 </w> 的合并,比如 (est, </w>) 出现 9 次,实际顺序里它就排在第 3 轮,为了演示直观,我就去掉了。

几轮之后,est、low、newest 这些高频片段各自成了词表里的整体 token。训练好的分词器遇到新文本时,按学好的合并顺序逐条套用。最有价值的情况是遇到没见过的词,比如 slowest:s 开头的部分没有对应规则,退回单个字符,但后半段 low 和 est 都在词表里,最终切成 s + low + est。这就是子词切分的精髓:常见词走整体,生僻词拆成熟悉的零件,永远不会无法表示。

真实模型的词表规模远大于这个玩具例子。GPT-2 的词表是 50257 个 token,Qwen3 是 15 万多个。词表大,常见词和词组都能整体表示,同样文本切出来的 token 数就少,推理更省;但词表越大嵌入层参数越多,词表里冷门 token 的训练也越不充分,所以规模是权衡出来的。

整个训练循环可以画成这样:

bpe-training-loop.jpg

保存下来的这两个文件就在模型仓库里,随分词器一起下发:

$ ls  ~/.cache/huggingface/hub/models--Qwen--Qwen3-0.6B/snapshots/* 
config.json             merges.txt              tokenizer_config.json   vocab.json
generation_config.json  model.safetensors       tokenizer.json

这 7 个文件分两组,4 个属于分词器,3 个属于模型:

文件是什么
vocab.json词表,token(字节映射形式)到 id 的对照表
merges.txt合并规则表
tokenizer.json前两个文件的打包加强版,还包含预分词规则和特殊 token 定义,fast tokenizer 实际加载的是它
tokenizer_config.json分词器配置,包括特殊 token 的名字和聊天模板,后面聊天模板一节还会见到它
config.json模型结构配置,上一篇已经见过
generation_config.json生成的默认参数,temperature、top_p 这些的出厂值
model.safetensors模型权重本体,1.5 GB,推理的主角

只跑分词实验的话,AutoTokenizer 只需要前 4 个文件,总共 10 MB 出头;后 3 个是上一篇跑模型推理时下载的,和分词无关。

词表我们前面已经看过了,那么真实的合并规则长什么样呢?不妨打开 merges.txt 文件瞧瞧,它的开头是这样的:

#version: 0.2
Ġ Ġ
ĠĠ ĠĠ
i n
Ġ t
...
e r
...
def ine
def ault

每行一条规则,两个符号写在一行,表示分词时看到这两个相邻的单位就合并成一个,比如 i n 表示 i 后面跟着 n 时合并成 in。Ġ 是空格的字节映射形式,Ġ t 就是「空格加 t 合并成 ␣t」。可以看到后面还有 def ine、def ault 这种明显从代码语料里学出来的规则。顺序就是优先级:训练时越早学出的合并排得越靠前,分词新文本时从字节开始,反复挑当前序列里排名最靠前的对子来合并,保证切分结果和训练时的学习顺序一致。上面玩具例子里那张 7 轮的表,就是一个迷你版的 merges.txt

用 transformers 观察分词

下面我们再来看一个示例,看看这个分词器面对一句中英文混合、还带标点 emoji 的话会怎么切:

from transformers import AutoTokenizer

# 加载 Qwen3-0.6B 的分词器
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")

text = "你好,world!今天的 weather 真不错 😊"

# encode:文本 → token id 序列
ids = tokenizer.encode(text)
print(ids)

# 逐个看每个 token 对应的文本片段
for i in ids:
    print(i, repr(tokenizer.decode([i])))

# decode:token id 序列 → 还原成文本
print(tokenizer.decode(ids))

运行结果如下:

ids: [108386, 3837, 14615, 6313, 106560, 9104, 10236, 250, 253, 100832, 26525, 232]
108386 '你好'
3837 ','
14615 'world'
6313 '!'
106560 '今天的'
9104 ' weather'
10236 ' �'
250 '�'
253 '�'
100832 '不错'
26525 ' �'
232 '�'
decode: 你好,world!今天的 weather 真不错 😊

这 12 个 token 里有几个点值得注意:

  • 中文:「你好」「今天的」「不错」都是整体 token,但「真」连同前面空格这个组合没有对应的合并规则,被拆成了 3 个字节级 token。这不是分词器坏了,而是字节级 BPE 的兜底机制在起作用,词表里没有覆盖的组合会退回到字节表示
  • 英文:world 是整体 token,「 weather」带着前导空格一起算一个 token,和前面说的规律一致
  • 标点:中文逗号和感叹号各自独立成 token
  • emoji:笑脸连同前面的空格也被拆成了字节级 token,和「真」一样,都是词表没覆盖到组合时退回字节表示的结果

最后一行的 decode 输出和输入一字不差,说明 encode 之后再 decode 可以无损还原。旅程地图里的反分词环节,干的就是 decode 这件事。

特殊 token

词表里除了正常文本切出来的 token,还有一类特殊 token(Special Token),刚才词表队尾的 <think> 就属于这类。它们不对应任何自然语言文字,作用是充当结构标记,告诉模型一段文本从哪里开始、到哪里结束、哪里是补齐的空白。最常见的三个:

特殊 token全称作用
BOSBeginning of Sequence标记序列开头
EOSEnd of Sequence标记序列结束,模型生成出它就停止
PADPadding批处理时把短序列补齐到同样长度

其中 EOS 很重要,上一篇讲过 Decode 循环是一个 token 一个 token 地生成,那模型怎么知道该停了?答案就是训练时教会它在回答结束时生成 EOS,推理引擎检测到这个 id 就终止循环。

各家模型用哪些特殊 token、取什么名字并不统一。可以打印出来看看 Qwen3 的情况:

print(tokenizer.bos_token)  # None
print(tokenizer.eos_token)  # <|im_end|>
print(tokenizer.pad_token)  # <|endoftext|>

可以看到 Qwen3 没有 BOS,EOS 用的是 <|im_end|>,PAD 用的是 <|endoftext|>

聊天模板

平时我们在对话框里打字,很容易以为那句话原封不动就进了模型。其实没有。你发出去的每一条消息,都会先被包进一个固定格式里,这个格式就是聊天模板(Chat Template)

聊天模型是在多轮对话数据上训练出来的,训练数据里每轮对话都有明确的角色标记,谁是系统提示、谁是用户、谁是助手,边界清清楚楚。推理时必须用同样的格式包装输入,模型才知道现在轮到谁说话了。用 apply_chat_template 看一下 Qwen3 实际拼出来的字符串:

messages = [
    {"role": "system", "content": "你是一个有帮助的助手。"},
    {"role": "user", "content": "什么是分词?"},
]
text = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
print(text)

输出如下:

<|im_start|>system
你是一个有帮助的助手。<|im_end|>
<|im_start|>user
什么是分词?<|im_end|>
<|im_start|>assistant

可以看到,每条消息被 <|im_start|> 加角色名开头、<|im_end|> 结尾包住,最后还追加了一个 <|im_start|>assistant 的开头,这就是 add_generation_prompt=True 的作用,相当于把话头递给模型:接下来该你说了。模型生成回答后输出 <|im_end|>,EOS 检测到,Decode 循环结束。

chat-template-wrapping.jpg

这个格式其实不是 Qwen 自创的,它是 OpenAI 在 2023 年发布 ChatGPT API 时提出的 ChatML(Chat Markup Language),im 是 instant message 的缩写。Qwen 系列沿用了这套格式。

不同模型的聊天模板差别很大,比如和 Llama 3 对比一下:

Qwen(ChatML 风格)Llama 3
一轮开始`<\im_start\>` 加角色名`<\start_header_id\> 角色名 <\end_header_id\>`
一轮结束`<\im_end\>``<\eot_id\>`
序列开头`<\begin_of_text\>`

功能上等价,写法完全不同。所以不能把 Qwen 的模板套给 Llama 用,格式错了模型表现会明显变差。同样也不能拿这套模板机制去套 base 模型:base 模型训练时没见过 <|im_start|> 这些标记,你把对话格式喂给它,它只会顺着往下续写文本,而不是回答你的问题。

base 模型是预训练完就直接发布的模型,训练目标只有一个:根据上文预测下一个 token。它学的是文本本身的分布,所以只会续写。对话模型(Chat 或 Instruct 模型)是在 base 模型的基础上,再用带角色标记的对话数据做微调和对齐,才学会按格式回答。从模型名字能看出来,比如 Qwen3-0.6B 是对话模型,对应的 Qwen3-0.6B-Base 就是 base 模型。

上下文窗口与 token 计数

最后把 token 和两个工程上天天打交道的概念连起来。

第一个是上下文窗口(Context Window),它指模型一次能处理的 token 总数上限,输入加输出一起算。Qwen3-0.6B 原生支持 32K token 的上下文,通过 YaRN(一种基于 RoPE 缩放的上下文长度扩展方法)扩展可以到 128K。

第二个是计费。API 厂商按 token 报价,输入输出分开计价。写应用时预估成本、控制超长文本,第一步都是先数 token。数 token 的方法很简单,用模型对应的分词器 encode 一下看长度就行。如果你用的是 OpenAI 的模型,它家开源了一个快速的 BPE 分词库 tiktoken,两行就能数出来:

import tiktoken
enc = tiktoken.encoding_for_model("gpt-4o")
print(len(enc.encode("你好,world!")))

OpenAI 还提供了一个在线的 Tokenizer 页面,把文本粘进去就能直观看到切分结果和数量,适合不想写代码的时候随手验证:

openai-tokenizer.png

要注意的是 tiktoken 只适用于 OpenAI 自家模型,数 Qwen、Llama 的 token 还是得用各家自己的分词器。词表不同,数出来的结果也不一样。

小结

今天我们把推理旅程的第一站走完了,要点如下:

  1. 为什么分词:模型只认识数字,分词器负责把文本切成 token 再查词表换成 id,它是文本和模型之间的中间货币
  2. Token 不是字也不是词:是切分出来的最小单位,常见词整体一个,长词拆子词,生僻内容退回字节;中英文 token 效率不同,直接影响计费和上下文容量
  3. BPE 算法:源自数据压缩,经 Sennrich 等人引入 NLP、GPT-2 发展到字节级,核心就是反复合并最高频相邻对
  4. 特殊 token:BOS、EOS、PAD 是结构标记,EOS 同时承担着终止 Decode 循环的职责
  5. 聊天模板:用户消息进模型前会被包成带角色的对话格式,Qwen 用 <|im_start|><|im_end|>,Llama 用另一套,这也是 base 模型和 chat 模型表现差异的来源之一

现在我们已经能把一句话变成一串 token id 了。但 id 只是编号,模型真正吃的是每个 id 对应的向量,而且这些向量里还得想办法带上位置信息,不然模型分不清「你打我」和「我打你」。嵌入和位置编码就是下一篇的主题,我们明天继续。

参考


大模型推理介绍:从一次提问说起

平时用豆包聊天、用 Claude Code 或 Codex 写代码,几乎成了每天的日常。但每次敲下回车之后,从第一个字蹦出来到整段回答写完,中间到底走过了哪些环节,我之前其实一直说不太清楚。最近在系统补大模型推理和训练相关的知识,于是想写一个系列,顺便记录下学习过程中的笔记,争取把整条链路梳理清楚。

越看越觉得,推理这件事被低估了。训练一个大模型是一次性投入;但是模型上线之后,每一次用户提问产生的推理开销却是日复一日、持续累积的。行业分析估计,企业 AI 的 GPU 预算里 55% 到 80% 花在了推理上。对一个有真实流量的产品来说,上线几周内,推理的累计算力就会超过训练。训练决定了模型能做到什么,推理决定了用户每天实际用到什么。所以 vLLMSGLangllama.cpp 这些名字才会一次次出现在技术圈的讨论里。大家争的,其实都是怎么把推理跑得更快、更省、更能扛并发。

这个系列我们就来系统地学习大模型推理相关的知识。今天是第一篇,先不急着抠细节,而是回答一个最基本的问题:你在对话框里敲下一句话、按下回车,到第一个字跳出来、再到回答逐字生成完毕,这中间到底发生了什么?我们会把一次请求的完整旅程走一遍,画出一张全系列的地图;后面每篇文章,就对应地图上的一个环节。

什么是推理

推理(Inference) 指的是训练好的模型根据输入生成输出的过程。和它相对的概念是 训练(Training),两者的区别可以用一张表说清楚:

对比项训练推理
目的调整模型权重,让模型学会规律用固定的权重生成结果
计算方式前向计算 + 反向传播 + 权重更新只做前向计算
权重状态每步都在变全程不变
发生频率一次性或周期性每次用户请求都在发生
典型用户模型研发工程师所有使用模型的人

简单来说,训练是造模型,推理是用模型。训练时模型要算梯度、更新参数,一次训练动辄占用几千张 GPU 跑上几周甚至几个月;推理时权重已经固定,每次只是把输入送进网络做一遍前向计算,拿到下一个词的预测。

表格里提到的三个词稍微展开一下。前向计算(Forward Pass) 是把输入从网络第一层逐层算到最后一层,得到预测结果的过程,训练和推理都要做这一步。反向传播(Backpropagation) 是拿预测结果和正确答案算出差多少,再沿着网络倒着把这个误差分摊到每个权重上,算出每个权重各自该负多少责任,也就是梯度。权重更新(Weight Update) 则是优化器根据梯度把权重往误差更小的方向挪一小步,模型就是这样一点点「学会」的。这三步组成训练的一次迭代,反复进行成千上万次;而推理只保留第一步,后面两步都不需要,这正是两者计算量差距悬殊的原因。

对绝大多数人来说,推理就是接触大模型的唯一方式。你打开豆包聊天、用 Claude Code 写代码、调用 API 做文本分类,背后发生的都是推理。这个系列研究的对象,就是这个每天被调用亿万次的过程。

从成本结构上看,训练和推理还有一个不对称的地方。训练再贵也是一次性投入,花完就花完了;推理的单价很低,一次请求可能只有几厘钱,但它随着用户量线性增长,永不停歇。一个模型越成功、用户越多,推理的累计开销就越大,最终远远超过当初的训练成本。

training-vs-inference.png

一次请求的完整旅程

现在我们跟着一个请求走一遍。假设你在对话框里输入「合肥今天天气怎么样」,按下回车之后,请求会依次经过下面这些环节:

inference-request-journey.jpg

我们逐一看看每个环节在做什么。

分词:文本变成 token

模型不认识自然语言,它只认识数字。所以第一步是 分词(Tokenization),把输入文本切成一串 token(词元),每个 token 对应词表里的一个编号。token 可以是一个字、一个词、一个标点,甚至半个词。比如「合肥今天天气怎么样」用 Qwen3 的分词器会切成 4 个 token,而同样意思的英文 How is the weather in Hefei today 要切出 9 个。

感兴趣的话可以运行下面几行代码,就能看到切分结果:

from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")

for text in ["合肥今天天气怎么样", "How is the weather in Hefei today"]:
    ids = tokenizer.encode(text)
    # 对每个 token id 做 decode,把字节级表示还原成可读的文本片段
    tokens = [tokenizer.decode([i]) for i in ids]
    print(len(tokens), tokens)

# 4 ['合肥', '今天', '天气', '怎么样']
# 9 ['How', ' is', ' the', ' weather', ' in', ' H', 'ef', 'ei', ' today']

可以看到中文按词切得很整,「合肥」整体是一个 token;而英文的 Hefei 因为不在常见词表里,被拆成了 H、ef、ei 三个碎片,token 数一下子多出不少。这也是为什么同样的语义,不同语言的推理成本会不一样。

分词是文本世界和模型世界之间的翻译官,它直接影响模型能处理的上下文长度、推理的成本核算(API 都按 token 计费),甚至影响模型在某些语言上的表现。这个话题比想象中深,我们下一篇专门来讲这块。

Prefill:一口气读完问题

分词之后进入 Prefill(预填充) 阶段。模型一次性并行处理输入的全部 token,算出每个位置的表示,并生成第一个新 token。这个阶段的特点是输入一次性给齐,可以充分并行计算,所以它是 计算密集型(compute-bound) 的,GPU 的算力利用率很高。你按下回车之后等待第一个字出现的那段时间,主要就是 Prefill 花掉的。

那 Prefill 具体在算什么?要先知道,Transformer 模型不是一个单独的网络,而是几十层结构相同的 层(Layer) 叠起来的,比如 Qwen3-0.6B 就有 28 层,输入从第一层进去,逐层加工,从最后一层出来。每一层做的核心工作是 自注意力(Self-Attention),粗略理解就是:让每个 token 都和序列里的其他 token「对一遍话」,吸收上下文信息之后更新自己的表示。

口说无凭,我们把模型加载进来,亲眼看看这些层:

from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-0.6B")

# 模型一共有多少层
print(model.config.num_hidden_layers)

# 打印第 0 层,看看一层里面都有什么
print(model.model.layers[0])

运行结果如下:

28
Qwen3DecoderLayer(
  (self_attn): Qwen3Attention(
    (q_proj): Linear(in_features=1024, out_features=2048, bias=False)
    (k_proj): Linear(in_features=1024, out_features=1024, bias=False)
    (v_proj): Linear(in_features=1024, out_features=1024, bias=False)
    (o_proj): Linear(in_features=2048, out_features=1024, bias=False)
    (q_norm): Qwen3RMSNorm((128,), eps=1e-06)
    (k_norm): Qwen3RMSNorm((128,), eps=1e-06)
  )
  (mlp): Qwen3MLP(...)  # 省略 MLP 部分
  (input_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
  (post_attention_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
)

可以看到,这里的 model.model.layers 是一个 28 个元素的列表,每个元素都是结构完全相同的 Qwen3DecoderLayer。往一层里面看,self_attn 就是自注意力模块,它下面的 q_projk_projv_proj 正是下文要讲的 W_Q、W_K、W_V 三个权重矩阵。

「自注意力」的 自(Self) 是相对于早期注意力机制说的:以前的注意力是让一个序列去关注另一个序列(比如翻译时让译文关注原文),而自注意力是让每个 token 去关注 同一个序列里 的其他 token。拿「合肥今天天气怎么样」来说,「天气」的表示会吸收「合肥」和「今天」的信息,从而知道这里问的是某地某时的天气而不是别的。每一层都做一遍这样的信息交换,层数越深,token 的表示就吸收越多的上下文。

那么,每个 token 具体是怎么和其他 token「对一遍话」的呢?分两步。第一步是 查嵌入表(Embedding):模型里存着一张大表,词表里每个 token 编号对应一行向量,Qwen3-0.6B 的词表有 151936 个 token,每行是一个 1024 维的向量,查表就把 token 编号变成了它的初始表示。第二步是 乘权重矩阵:每一层都有自己训练好的三个矩阵 W_Q、W_K、W_V,把每个 token 的向量分别乘上去,得到查询(Q)、键(K)、值(V)三个向量。然后每个 token 拿自己的 Q 去和序列里所有 token 的 K 做匹配,按匹配程度对所有的 V 加权求和,就得到了「读过上下文之后」的新表示。

Q、K、V 这三个向量可以用查资料来类比:查询(Query) 是当前 token 提出的问题「我想找和我相关的信息」;键(Key) 是每个 token 挂在门口的标签「我这里有关于什么的信息」;值(Value) 则是 token 实际携带的内容。拿「天气」的 Q 去和所有 token 的 K 逐个比对,「合肥」「今天」的标签对得上,匹配分数就高,于是它们的 V 就以更大的权重被加进来。

实际模型里,Q、K、V 通常会被拆成多份并行计算。以 Qwen3-0.6B 为例,Q 被拆成 16 份各 128 维(也就是 16 个注意力头),K 和 V 各拆成 8 份 128 维,每个头独立做一遍匹配,最后再把结果拼回去。多头的好处是不同的头可以各看各的角度,有的关注语法,有的关注指代。

上面提到的这些数字,同样可以从模型的 config 里直接读到:

config = model.config
print(config.vocab_size)           # 151936,词表大小
print(config.hidden_size)          # 1024,嵌入向量的维度
print(config.num_attention_heads)  # 16,Q 的注意力头数
print(config.num_key_value_heads)  # 8,K、V 的注意力头数
print(config.head_dim)             # 128,每个头的维度

对照上面打印的层结构验算一下:q_proj 的输出维度 2048 = 16 × 128,k_proj、v_proj 的输出维度 1024 = 8 × 128,正好分别是 Q 和 K、V 所有头拼起来的大小。

Prefill 结束时有两个产物:一个是最后一个位置预测出的第一个新 token;另一个是所有 token 在所有层上算好的 K、V 向量,它们被存进显存,就是后面反复提到的 KV Cache(键值缓存)。有了这个缓存,Decode 阶段每生成一个新 token,只需要算它自己的 Q、K、V,再回头查缓存里历史 token 的 K、V 就行,不用把整个输入重算一遍。可以说 Prefill 的一项重要职责就是为 Decode 备好这份缓存。

为什么缓存只存 K 和 V,不存 Q 呢?这是因为生成新 token 时,只有它在提问,用自己的 Q 去匹配所有历史 token 的 K,再对 V 加权求和。历史 token 在这一步里只是被查询的对象,用到的是它们的 K 和 V。而历史 token 自己的 Q,只在它刚生成的那一步用过一次,之后再也用不上,自然不用存。

回过头看,为什么说 Prefill 是计算密集型的?因为输入 token 一次性到齐,上面这些 Q、K、V 的计算和注意力匹配全都是大矩阵乘法,恰好是 GPU 的 Tensor Core(张量核心,GPU 里专门做矩阵乘法的硬件单元)最擅长的活儿,算力能被充分利用。但凡事有代价:注意力要求每个 token 和每个 token 打交道,这部分的计算量随输入长度近似 平方增长。prompt 从几千 token 涨到几万 token,注意力的计算量不是涨十倍而是涨上百倍。这也是为什么喂给模型一本小说和问它一句话,首 token 的等待时间完全是两个量级。

于是围绕 Prefill 出现了一批专门的优化技术。比如 Chunked Prefill(分块预填充) 把超长输入切成小块,穿插在 Decode 步骤之间分批算,避免一个长 prompt 把其他用户的生成卡住;Prefix Caching(前缀缓存) 则把多个请求共享的 prompt 前缀(比如同一份系统提示词)的 KV Cache 直接复用,跳过重复的 Prefill 计算。这些技术后面在学 KV Cache 和推理引擎调度时再细说,这里先了解一下。

Decode 循环:逐 token 生成

接下来是最关键也最容易被误解的部分。大语言模型本质上只做一件事:给定前面的 token 序列,预测下一个 token。所以生成回答不是一次性算出来的,而是一个循环:

  1. 模型根据已有序列预测下一个 token
  2. 把这个 token 拼到序列末尾
  3. 用新序列再预测下一个
  4. 重复以上步骤,直到生成结束标记或达到长度上限

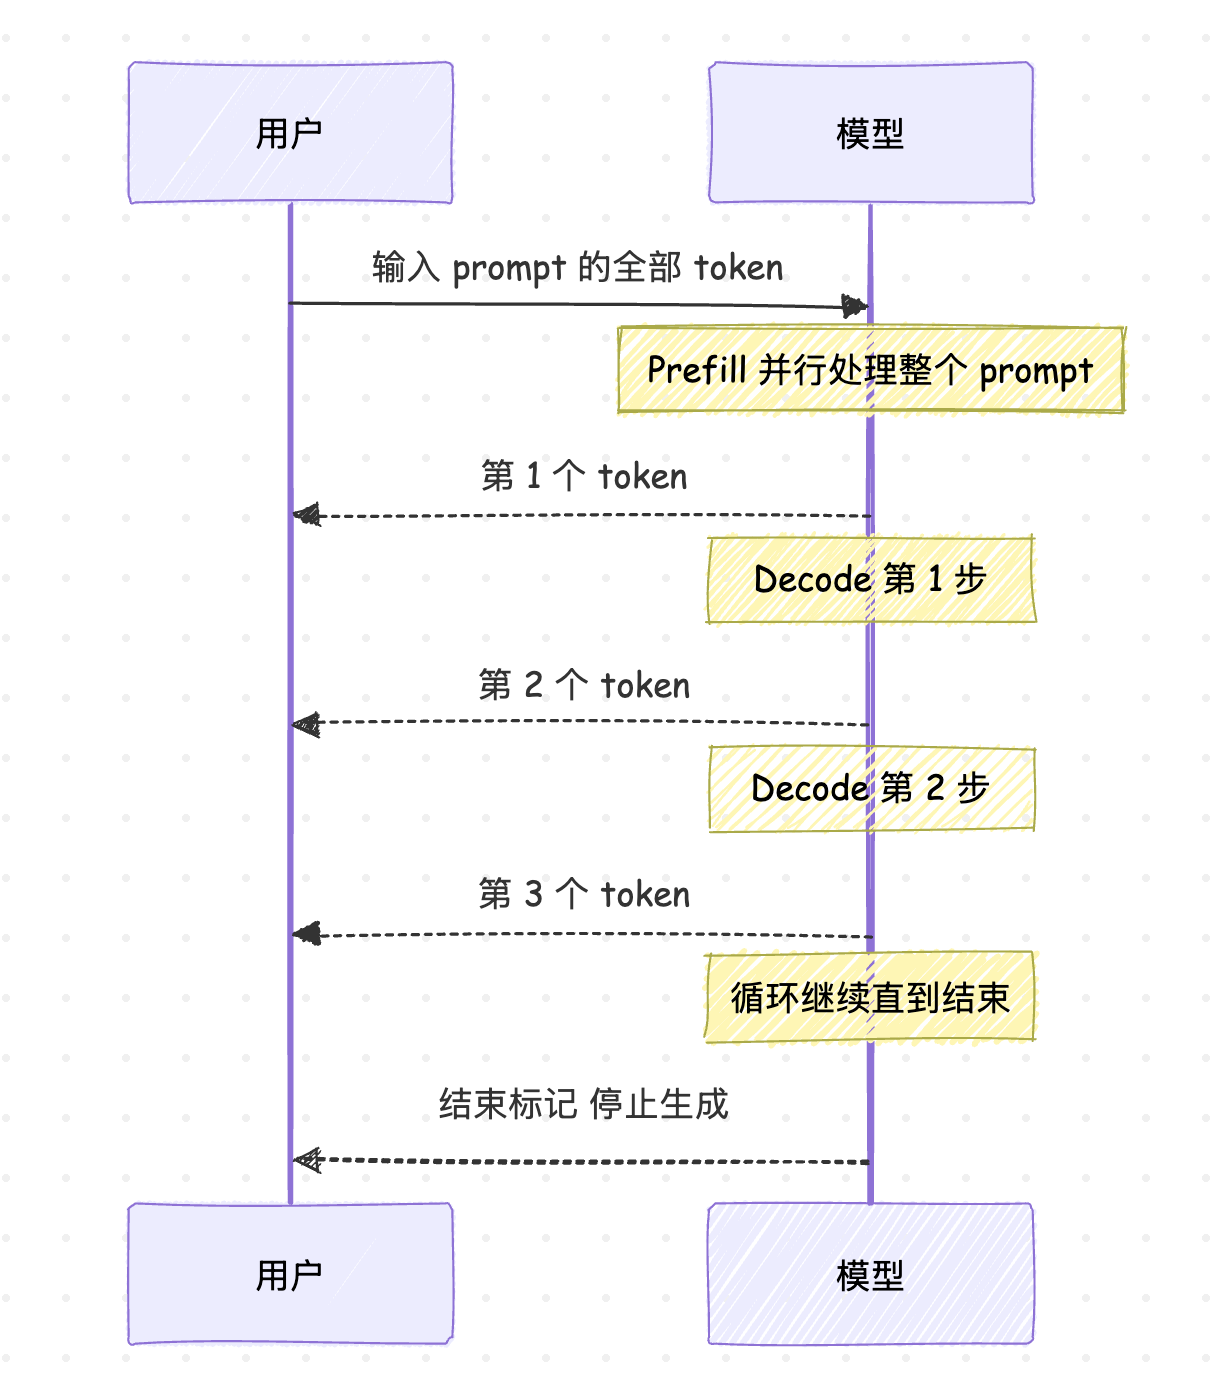
这个逐 token 生成的过程叫 Decode(解码),这种一个接着一个的生成方式叫 自回归生成(Autoregressive Generation)。下面这张时序图可以看出 Prefill 和 Decode 的关系:

prefill-decode.png

和 Prefill 不同,Decode 每一步只算一个 token。Prefill 时输入一次性到齐,权重从显存读出来一次能被所有输入 token 复用;而 Decode 每步只有一个新 token,大矩阵乘法退化成矩阵乘向量,计算量很小,但每一步仍然要把全部模型权重和攒下来的 KV Cache 完整读一遍。时间花在「读」上而不是「算」上,GPU 的算力大量闲置,所以它是 访存密集型(memory-bound) 的。这就是为什么你在聊天界面里看到的回答是一个字一个字往外蹦的,不是模型在模仿人打字,而是它真的就是这样工作的。

值得注意的是,解码过程中 KV Cache 还在不断变大,每个新 token 都要在每一层留下自己的 K、V。占多少显存,用前面打印的 config 就能算出来:

kv_per_token = 2 * config.num_hidden_layers * config.num_key_value_heads * config.head_dim * 2
print(kv_per_token / 1024, "KB")  # 112.0 KB

式子里第一个 2 是 K 和 V 两份,最后的 2 是 bf16 每个元素占的字节数。也就是说每生成一个 token,KV Cache 就涨 112 KB;一轮对话生成 2000 个 token,光缓存就要 200 多 MB,接近模型权重(约 1.2 GB)的五分之一了。上下文越长、生成越长,显存吃得越多,显存容量也因此成了推理服务能扛多少并发的关键约束。

既然瓶颈在读权重,优化思路也很直接:让读一遍权重服务尽可能多的 token。把多个用户的请求凑成一批一起跑,同一份权重读出一次,就能同时算出几十个请求的下一个 token。vLLM 的 Continuous Batching(连续批处理) 走的就是这条路。

Prefill 和 Decode 一个吃算力、一个吃带宽,两者的优化思路完全不同。NVIDIA Dynamo 这类新框架甚至把它们拆到不同的 GPU 上分别部署,这就是所谓 PD 分离(Prefill-Decode Disaggregation)。

采样:从概率分布里挑一个词

模型每一步输出的其实不是一个确定的词,而是词表里每个 token 的一个分数,这个分数叫 logits。logits 是模型最后一层直接算出来的原始数值,可以是任意实数,有正有负,本身没有概率含义,只有相对大小:分数越高,说明模型越倾向于选这个 token。要把分数变成概率,需要过一遍 softmax:先对每个分数取指数,让负数也变成正数,同时放大分数之间的差距;再除以所有指数值的总和做归一化,让结果加起来正好等于 1。这样,十几万个候选 token 就各自带上了一个概率值。从这个分布里决定到底用哪个 token 的过程就是 采样(Sampling)

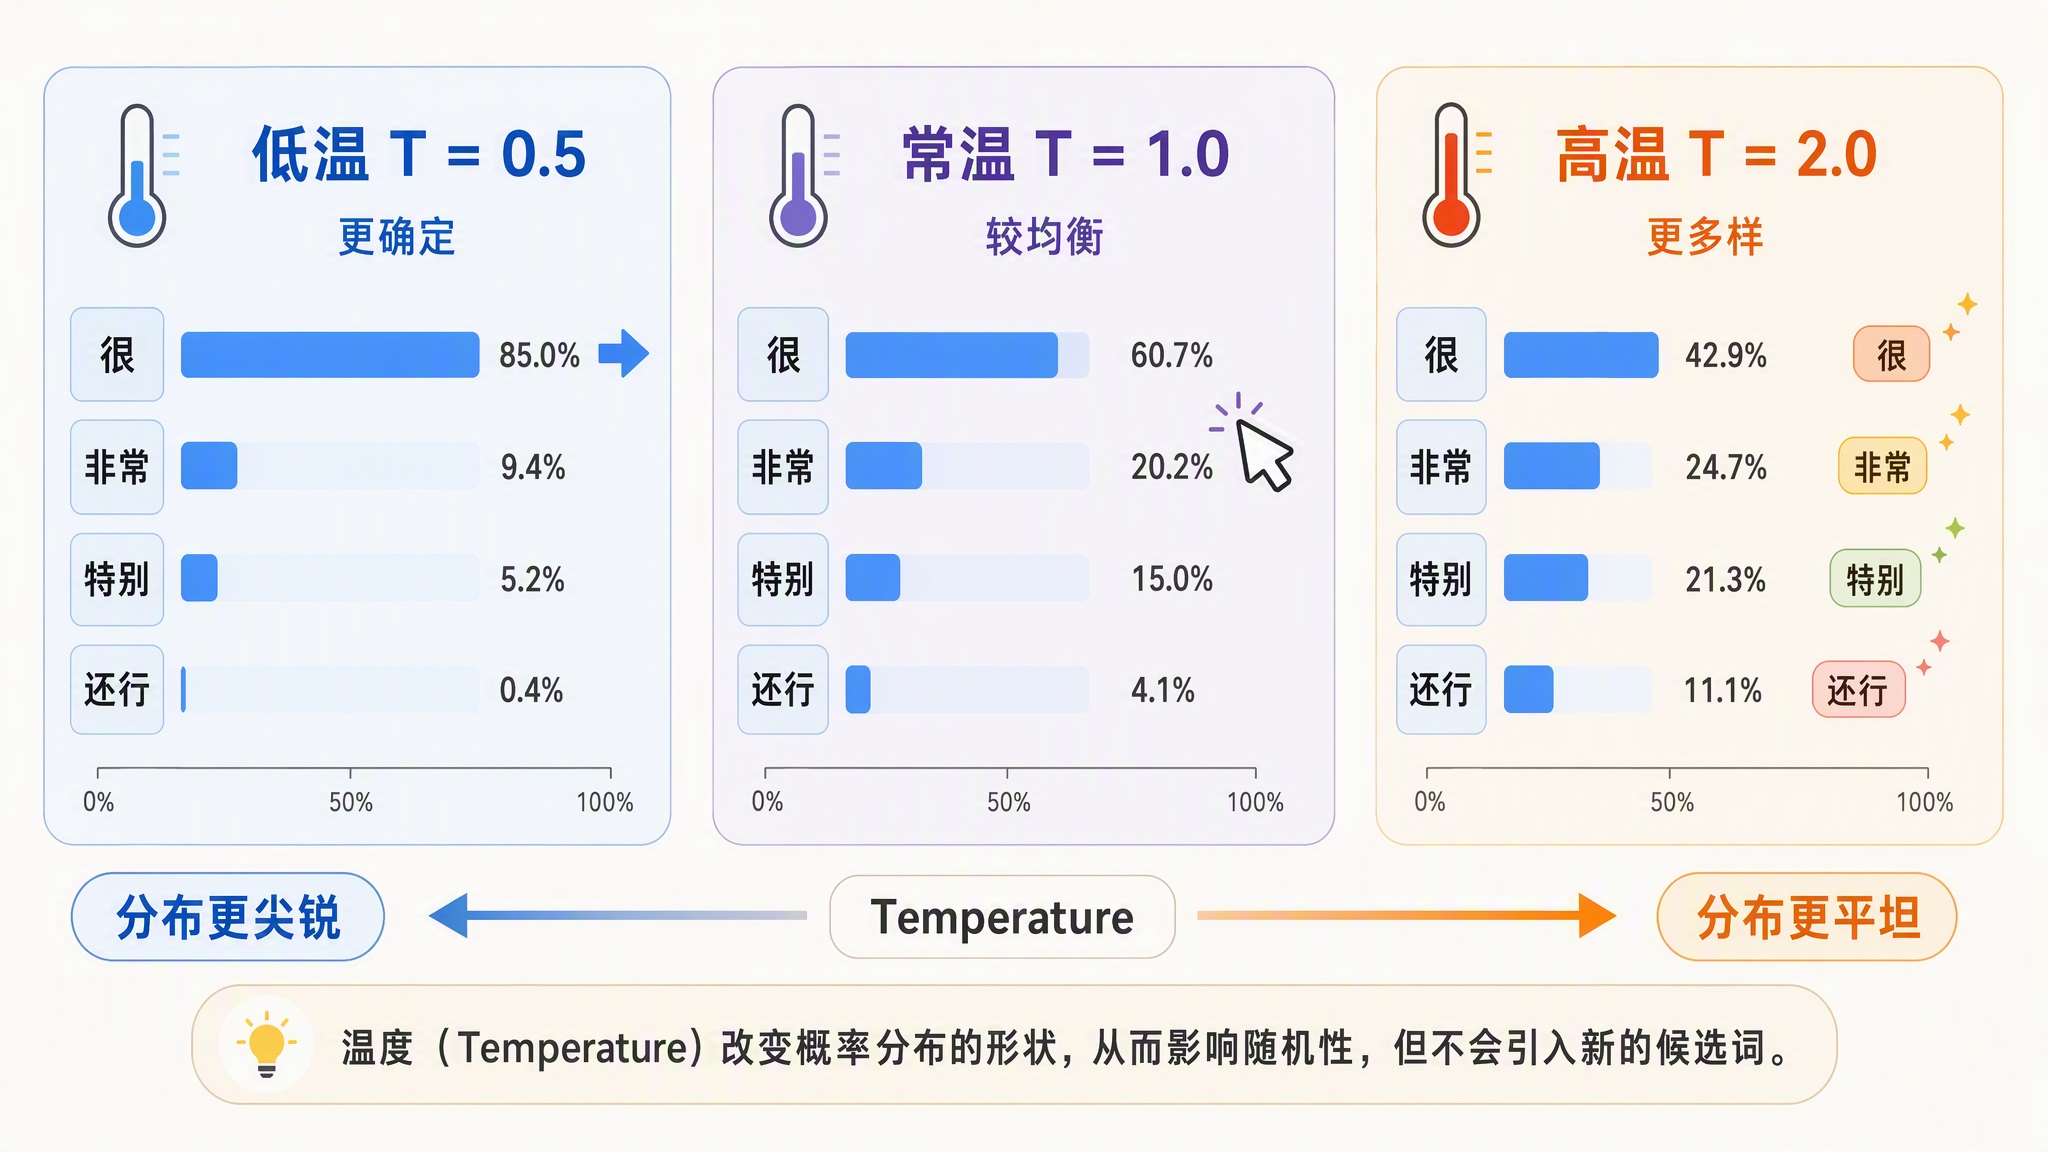
最简单的策略是每次直接选概率最高的那个,也就是 贪心(Greedy) 策略。不过更多时候我们会引入随机性:按概率抽一个,概率大的被抽中的机会大,但长尾里的 token 也有机会出场。分布的形状可以用 temperature 调节,它的作用是在 softmax 之前把 logits 除以一个系数。用几行 Python 感受一下,这里不用真跑模型,随手编几个分数:

import math

# 假设模型给下一个 token 算出的分数是这样的
logits = {"很": 3.2, "非常": 2.1, "特别": 1.8, "还行": 0.5}

def softmax(scores, temperature=1.0):
    exp = [math.exp(s / temperature) for s in scores]
    return [e / sum(exp) for e in exp]

for t in [0.5, 1.0, 2.0]:
    probs = softmax(logits.values(), t)
    print(f"temperature={t}", {k: round(p, 3) for k, p in zip(logits, probs)})

这段代码的关键是 softmax 函数,里面两行对应三步操作:

  1. s / temperature:每个分数先除以温度,温度小于 1 相当于把分数差距放大,大于 1 相当于把差距压小
  2. math.exp(...):对缩放后的分数取指数,这是 softmax 的第一半。e 的任何实数次方都大于 0(e⁰ = 1,负数次方是 0 到 1 之间的小数),所以负分也被映射成了正数,同时分数之间的差距被进一步拉大
  3. e / sum(exp):每个指数值除以总和,归一化成概率,这是 softmax 的第二半,保证所有候选加起来等于 1

下面的循环用三个温度各算一遍,对比分布形状的变化。输出结果如下:

temperature=0.5 {'很': 0.85, '非常': 0.094, '特别': 0.052, '还行': 0.004}
temperature=1.0 {'很': 0.607, '非常': 0.202, '特别': 0.15, '还行': 0.041}
temperature=2.0 {'很': 0.429, '非常': 0.247, '特别': 0.213, '还行': 0.111}

用一张图表示,看起来更直观:

temperature-comparison.jpg

可以看到,temperature 小于 1 时分布变尖,头部 token 几乎垄断,输出更稳定;大于 1 时分布变平,长尾 token 的机会变多,输出更发散。贪心可以理解成 temperature 趋近于 0 的极限情况。除了它,常用的还有 top_k(只在分数最高的 k 个里抽)和 top_p(按概率从高到低累加,累计到 p 就截断,也叫核采样),实际使用时经常几个参数组合在一起。同样的模型、同样的问题,回答有时稳定有时发散,差别往往就在这些采样参数上。

这里的 temperature 在数学上可以是任意正数,但是各个平台都有自己允许的取值范围:OpenAI 和 Gemini 是 0 到 2,Anthropic 限制在 0 到 1,阿里百炼是 [0, 2),本地用 transformers 跑则没有限制,平时在使用时注意一下。

反分词与流式输出

采样得到的还是 token 编号,需要 反分词(Detokenization) 把它还原成人类可读的文字。这一步在流式场景下有个必须处理的坑。Qwen、Llama 这些模型用的都是字节级 BPE(Byte Pair Encoding,字节对编码)分词器,一个 token 不一定正好是一个完整字符,可能只是某个汉字 UTF-8 编码三个字节里的一两个。如果每收到一个 token 就 decode 一次,拼出来的就是乱码。拿 Qwen3 的分词器试一下:

ids = tokenizer.encode("龘")
print(ids)                                  # [82912, 246],一个汉字被切成两个 token
print([tokenizer.decode([i]) for i in ids]) # ['�', '�'],单独 decode 都是乱码
print(tokenizer.decode(ids))                # '龘',拼在一起才能正确还原

所以推理引擎做的是 增量反分词:收到新 token 后先把字节攒着,凑够一个完整字符再往外发。

由于 Decode 是逐 token 进行的,推理服务可以边生成边把结果推给前端,这就是 流式输出(Streaming)。工程上一般通过 SSE(Server-Sent Events,一种服务端持续推送数据的 HTTP 机制)实现:服务端每产出一个 token 就推送一条消息,客户端收到一条就渲染一点。它不改变生成的总耗时,但极大改善了等待体验:第一个字出来你就能开始读,而不是盯着空白屏幕等整段回答算完。你在各类聊天产品里看到的打字机效果,源头就在这里。

推理初体验

这一节我们用 Hugging Face transformers 加载一个小模型 Qwen/Qwen3-0.6B,动手体验一次推理,代码只要十几行:

from transformers import AutoModelForCausalLM, AutoTokenizer

# 1. 加载分词器和模型
model_name = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

# 2. 分词:文本变成 token 编号
messages = [{"role": "user", "content": "用一句话解释什么是大模型推理"}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
inputs = tokenizer(text, return_tensors="pt")

# 3. 生成:Prefill + Decode 循环都在这一步里
outputs = model.generate(**inputs, max_new_tokens=1024)

# 4. 反分词:token 编号还原成文本
response = tokenizer.decode(outputs[0][inputs.input_ids.shape[1]:], skip_special_tokens=True)
print(response)

这段代码和我们上面讲的旅程是一一对应的:

  1. 加载:分词器负责文本和 token 的互转,模型则是训练好的权重
  2. 分词tokenizer 把输入文本编码成 token 编号张量
  3. 生成model.generate 内部先 Prefill 处理输入,再进入自回归的 Decode 循环,每步生成一个 token 并采样
  4. 反分词tokenizer.decode 把新生成的 token 还原成文字

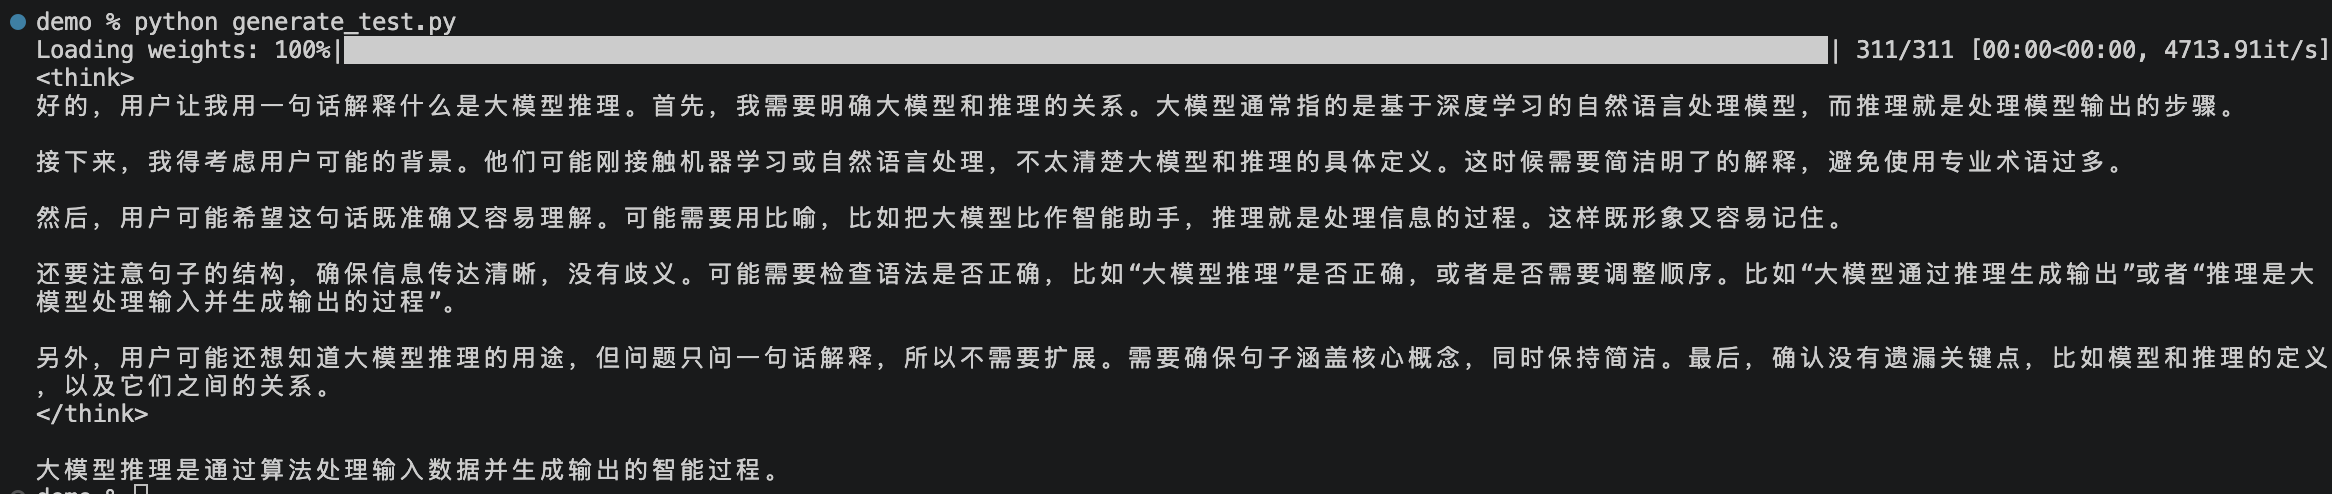
运行之后终端里会打印出模型的回答:

transformers-generate-output.png

也可以加个流式输出,亲眼看着 token 一个一个生成出来。把第 3、4 步换成下面这样:

from transformers import TextStreamer

# 流式生成:每产出一个 token 就立刻解码打印
streamer = TextStreamer(tokenizer, skip_special_tokens=True)
outputs = model.generate(**inputs, max_new_tokens=1024, streamer=streamer)

TextStreamer 会在 Decode 循环的每一步把新生成的 token 立刻反分词并打印到终端,这就是流式输出在最朴素环境下的样子。

生产环境里更常见的做法是把模型部署成一个服务,客户端通过 OpenAI 兼容接口调用,比如用 curl 发一个请求:

$ curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-0.6B",
    "messages": [{"role": "user", "content": "用一句话解释什么是大模型推理"}],
    "stream": true
  }'

加上 stream: true 之后,服务端会用 SSE 把每个 token 逐个推回来。至于本地怎么把模型跑成一个 OpenAI 兼容的服务,vLLM、SGLang、llama.cpp 都能做到,在后面的系列文章中我们会专门学习。

小结

今天这篇文章完成了两件事:

  1. 建立了概念:推理是训练好的模型根据输入生成输出的过程,权重固定、只做前向计算,它是绝大多数用户真正接触模型的方式,也是当前 AI 算力开销的大头
  2. 画出了地图:一次请求的完整旅程是分词、Prefill、Decode 循环、采样、反分词、流式输出,每个环节我们后续都会单开文章细讲

接下来的文章会沿着这张地图逐站展开,下一篇我们就走进地图的第一站,看看分词这件看起来简单、但是实际上又没那么简单的事。我们明天继续。

参考


学习Headroom 的输出 token 优化

在前面几篇里,我们把 Headroom 的输入侧基本都聊过了:compress() 入口和管线生命周期、ContentRouter 怎么分流内容、SmartCrusher / CodeAwareCompressor / Kompress 三个压缩器各自压什么、CCR 可逆压缩怎么把原文缓存在本地、跨 agent 记忆和 headroom learn 又怎么把经验沉淀成长期知识。它们有一个共同点:围着的都是发给模型这一路。工具输出、日志、RAG 片段、文件、对话历史,在进入大模型之前先被压缩。

今天这一篇换个方向,看 Headroom 怎么压模型写回来的东西。这部分能力叫 Output token reduction(输出 token 削减),对应的模块是 Output Shaper(输出整形器)

什么是输出 token 优化

众所周知,输出 token 比输入贵,比如 Opus 级别的模型,输出 token 的单价大约是输入的 5 倍。同样是一万 token,写回来的那一万比发出去的那一万贵得多。所以输入侧压得再狠,如果模型每一轮都长篇大论地写回来,账单还是下不去。

那模型的输出里,哪些部分是可以省的?官方 README 把浪费点归纳成三类:

  • 寒暄与收尾语(preamble / postamble):回答正文前的一句 Great, let me...(好的,我来...),以及正文后的一句总结陈词。这些话对结果没有信息量。
  • 复述已有上下文:模型把你刚发给它的代码、文件内容、diff、工具输出,原样再抄一遍到回复里。你已经有这些内容了,它抄一遍纯属多花钱。
  • 对机械步骤过度思考(thinking):thinking 指模型在正式作答前的一段推理草稿,它同样按输出 token 计费。当这一轮只是读了个文件、跑了个通过的测试,续写本来是很机械的动作,却还调动高档的深度思考,这笔思考 token 就浪费了。

headroom-input-output-cost.jpg

Headroom 代理本身不生成任何输出 token,它只是个透明反向代理。所以它能动的只有请求:通过改写发出去的请求,去影响模型愿意写回来多少。Output Shaper 的两根杠杆都是这个思路。

打开输出整形器

Output Shaper 默认是关闭的,通过环境变量开启:

export HEADROOM_OUTPUT_SHAPER=1

它的配置全部走环境变量,OutputShaperSettings 这个数据类负责从环境里把设置读出来,逻辑在 output_shaper.py

@dataclass(frozen=True)
class OutputShaperSettings:
    enabled: bool = False           # HEADROOM_OUTPUT_SHAPER
    verbosity_level: int = 2        # HEADROOM_VERBOSITY_LEVEL,0~4
    effort_router_enabled: bool = True   # HEADROOM_EFFORT_ROUTER
    mechanical_effort: str = "low"       # 机械续写时降到哪一档

    @classmethod
    def from_env(cls) -> OutputShaperSettings:
        enabled = runtime_env.getenv("HEADROOM_OUTPUT_SHAPER", "").lower() in (
            "1", "true", "yes",
        )
        # ... 读取 level、router、mech,并把 level 夹在 0~4 之间
        return cls(enabled=enabled, ...)

四个字段各对应一个环境变量:

  • HEADROOM_OUTPUT_SHAPER:总开关,设成 1 / true / yes 才算开,其它值都是关。整个 Output Shaper 就靠它启用。
  • HEADROOM_VERBOSITY_LEVEL:详略级别,0 到 4 的整数,默认 2。它控制第一根杠杆「详略引导」的力度,往系统提示词里追加多强的简洁指令,0 是不干预、4 是电报体,各级指令的原文下一节会看到。
  • HEADROOM_EFFORT_ROUTER:第二根杠杆「努力档位路由」的开关,默认是开的,只有显式设成 0 / false / no 才关。它管的是另一件事:给机械续写的轮次降低思考档位。
  • HEADROOM_MECHANICAL_EFFORT:机械续写时把思考档位降到哪一档,默认 low,填了不认识的档位名也会回退到 low

关于后三个环境变量的含义和用法,后面详讲。这个类只负责把开关读出来,真正的整形入口是 shape_request,它的主干很直白:

def shape_request(body, settings=None, level_override=None) -> ShapeResult:
    if settings is None:
        settings = OutputShaperSettings.from_env()   # 读环境变量里的配置
    result = ShapeResult()
    if not settings.enabled:
        return result              # 开关关着:原样返回,什么都不做

    # 杠杆 1:详略引导
    if level > 0 and apply_verbosity_steering(body, level):
        result.changed = True
    # 杠杆 2:努力档位路由
    if settings.effort_router_enabled:
        kind = classify_turn(body.get("messages", []))
        labels = route_effort(body, kind, settings)
    return result

开关关着时它直接返回一个空结果,请求原样放行,所以默认行为和不装 Output Shaper 完全一样。打开之后,它的核心是两根杠杆:详略引导(verbosity steering)努力档位路由(effort routing)。下面分别看。

第一根杠杆:详略引导

详略引导的做法很朴素:在系统提示词的末尾追加一段指令,告诉模型简洁一点、别复述。指令文本按强度分成 5 个等级,0 级是不干预,1 到 4 级逐级变狠,都是写死在代码里的固定字符串。四个级别的原文分别是:

第 1 级,只管寒暄:

Skip preamble and postamble. Do not announce what you are about to do or recap what you just did; start with the substance.

跳过开场白和收尾:不要预告你打算做什么,也不要复述你刚做了什么,直接进正题。

第 2 级(默认级别),开始管复述:

Skip preamble and postamble; start with the substance. Never restate code, file contents, diffs, or tool output that already appear in this conversation — reference them by path and line instead. After a tool call succeeds, continue without narrating the result.

在第 1 级基础上加两条:对话里已经出现过的代码、文件内容、diff、工具输出,一律不许复述,改用路径和行号来引用;工具调用成功后直接往下写,不复述结果。

第 3 级,连理由和改写幅度都管:

Skip preamble and postamble. Never restate code, file contents, diffs, or tool output already in this conversation — reference by path and line. Give conclusions only; omit rationale unless the user asks why. Prefer the smallest edit over rewriting whole files. Keep prose to the minimum needed to be unambiguous.

在第 2 级基础上再加码:只给结论,用户不问就不讲理由;改代码优先最小编辑,不要动不动重写整个文件;文字压缩到「不产生歧义」的下限。

第 4 级,进入电报体:

Minimum tokens. Fragments fine. No preamble, no postamble, no restating context, no rationale. Answer, smallest-possible edits, nothing else.

token 能省则省:允许不完整的句子,开场、收尾、复述、理由一概不要,只要答案和最小改动,别的什么都别写。

四个级别对比着看,约束是层层加码的:1 级管寒暄,2 级管复述,3 级管理由和改写幅度,4 级进入电报体。默认用第 2 级,是一个大多数人都能接受的力度。

顺带一提,这段指令是追加在系统提示词最末尾(所有 cache_control 断点之后)的,这样不会弄坏缓存前缀,原理前面几篇讲过,这里就不展开了。

第二根杠杆:努力档位路由

第二根杠杆针对的是前面说的第三类浪费:对机械步骤过度思考。

先解释一下背景。像 Claude Code 这样的编程 agent,在一个任务里会反复循环:调用工具、拿到结果、继续、再调用工具。这些循环里的绝大多数轮次,其实只是机械的续写,比如刚读完一个文件、刚跑过一个通过的测试,模型接下来做的事情是可预期的。但 Claude Code 这类客户端往往把每一轮的努力档位output_config.effort)都钉在 xhigh 这样的高档上,于是模型对这种机械续写也调动高强度的思考,而思考是按输出 token 计费的。

output-config-effort.png

努力档位路由要做的,就是识别出这种机械续写的轮次,把它的思考档位调低;而对新问题、对报错,保持全力。判断哪种轮次靠的是 classify_turn,它的分类完全基于消息的结构,不看任何关键词、不用正则:

def classify_turn(messages: list[dict]) -> TurnKind:
    last = messages[-1]
    if last.get("role") != "user":
        return TurnKind.UNKNOWN
    content = last.get("content")
    # ...
    saw_tool_result = False
    saw_error = False
    for block in content:
        btype = block.get("type")
        if btype == "tool_result":
            saw_tool_result = True
            if block.get("is_error") is True:
                saw_error = True
        elif btype == "text":
            return TurnKind.NEW_USER_ASK   # 用户又插了一句新的话
        elif btype in ("image", "document"):
            return TurnKind.NEW_USER_ASK
    if saw_error:
        return TurnKind.ERROR_CONTINUATION   # 工具报错,要认真推理
    if saw_tool_result:
        return TurnKind.MECHANICAL_CONTINUATION  # 干净的工具结果,机械续写
    return TurnKind.UNKNOWN

逻辑很直白:看最后一条用户消息里都是些什么块。如果里面夹了用户新打的文字、图片或文档,说明用户又提了新要求,判为 NEW_USER_ASK;如果全是工具结果、且没有一个带 is_error 标记,判为机械续写 MECHANICAL_CONTINUATION;只要有一个工具结果带了错误标记,就判为报错续写 ERROR_CONTINUATION,因为模型这时候得认真琢磨这个失败。

只有被判为机械续写的轮次,route_effort 才会动手降档:

def route_effort(body, kind, settings) -> list[str]:
    if kind is not TurnKind.MECHANICAL_CONTINUATION:
        return []                       # 其它情况一律不碰
    labels = []
    output_config = body.get("output_config")
    if isinstance(output_config, dict):
        effort = output_config.get("effort")
        if isinstance(effort, str) and effort in _EFFORT_RANK \
                and _EFFORT_RANK[effort] > _EFFORT_RANK[settings.mechanical_effort]:
            output_config["effort"] = settings.mechanical_effort   # 只往低调
            labels.append(f"output_shaper:effort:{effort}->{settings.mechanical_effort}")
    # ... 老模型走 thinking.budget_tokens,夹到 API 下限
    return labels

这段代码里有两条安全规则:

  • 只降不加:只有当客户端本来就发了 output_config.effort 这个字段,整形器才会把它往低调。绝不主动注入这个字段,因为不支持努力档位的模型碰到这个参数会直接返回 400 报错。
  • 绝不动 thinking.type:对还在用老式 thinking.budget_tokens(思考预算 token 数)的模型,整形器只把预算夹到 API 允许的下限 1024,而从不去关掉思考开关。因为历史消息里如果带着思考块,中途关掉思考也会让某些模型报 400,而且这个开关一动就会破坏消息层的缓存。

学习你偏好的啰嗦度

上面的详略级别可以手动用 HEADROOM_VERBOSITY_LEVEL 指定,但更省心的方式是让 Headroom 自己学。命令是:

headroom learn --verbosity          # 只分析、给建议
headroom learn --verbosity --apply  # 分析并写入配置

这背后的逻辑在 headroom/learn/verbosity.py 文件中。它的出发点是一个观察:用户几乎从不明说自己想要多简洁的回答,但用户会用行为表现出来。这些行为信号能从 Claude Code 的会话记录里提取出来,Headroom 一共提取了四个信号:打断率、快速跳过率、长输出频率和复读率,其中决定详略级别的主要看前两个:

  • 打断率(interrupt rate):模型话说到一半,用户按下打断的比例。
  • 快速跳过率(fast-skip rate):模型给了个长回答,用户回得飞快,快到根本不可能读完。

后两个不参与定级,但也各有用途:

  • 长输出频率(long-output rate):长回答占全部回答的比例,「长」是相对的,以你自己的回答长度中位数为参照,且至少 200 词才参评。
  • 复读率(echo ratio):回答和它拿到的上下文之间 n-gram 重叠的比例,看回答有多少是复述。它不定级,但它正是后文「度量输出节省」那节里直接浪费那一层的指标。

快速跳过率的判定不是拿一个固定秒数当界限,而是先按平均阅读速度(每分钟 250 词)算出这段回答读完需要多久,如果用户在读完时间的一半都不到就回复了,就算一次快速跳过:

_READING_WPM = 250.0          # 技术类文字的平均阅读速度(词/分钟)
_SKIP_READ_FRACTION = 0.5     # 回复快于读完时间的一半,判为没读
_MIN_WORDS_FOR_SKIP = 150     # 太短的回答不参与判断,没什么可跳的

然后把打断率和快速跳过率加起来当作「输出太多」的压力值,压力越大、建议的级别越高。它还设了个上限:即便压力非常大,也只封顶到第 3 级,而不会自动应用最激进的第 4 级电报体。数据不足(人类消息加上打断次数合计少于 10)时回退到默认的第 2 级。

上面整个推荐是一个启发式先验,还可以加一个 --llm-judge 参数,配个大模型做裁判,它把提取好的四个信号(不是原始会话)发给 LLM,让它按四级标准给个级别。

除此之外,还有一个自动调节控制器做运行时的实时微调(由 HEADROOM_VERBOSITY_AUTOTUNE 开启),学到的级别只是起点,它在会话进行中继续盯实时信号,动态调整级别。思路借自拥塞控制的 AIMD(加法增、乘法减):连续多次「用户没在读」(打断、快速跳过)才把级别上调一级,往上探要慢;一旦用户嫌回答太少,立刻回退一级并冷却一段时间,压住不再轻易上调,因为惹恼用户是代价大的事件。

这一步学到的级别会写进工作区的 verbosity.json 文件。运行时 resolve_verbosity_level 会按优先级取值:环境变量显式指定的手动值最高,其次是自动调节控制器,再次是学到的 verbosity.json,最后才是默认值。

怎么度量输出省了多少

到这里有一个绕不开的问题:输出侧到底省了多少 token,怎么算?

输入侧好办。压缩是一个纯函数,压之前多少 token、压之后多少 token 都摆在那里,两个数一减就是省下的。但输出侧不一样。当整形器让请求变得更简洁,模型吐出了 N 个输出 token,可我们永远看不到它在没被整形的情况下本来会吐多少。这是一个反事实(counterfactual)问题:每个请求只会发生一种情况,另一种平行世界里的结果观察不到。

反事实是因果推断里的概念,指的是「如果当初没这么做,结果会怎样」的那个没有真实发生的情形。它天然不可直接观测。

所以,既然那个平行世界观测不到,节省就只能靠估计。headroom/proxy/output_savings.py 这个模块的工作,就是把估计做得诚实。它把结果分成三个层次:

  • estimated(合成对照估计):对照数据其实是由上节的 headroom learn --verbosity 命令输出,这条命令对历史会话时进行扫描,学习详略级别,另外,它还会顺带按请求特征把未整形时的输出 token 数累进一份逐层基线(baseline),--apply 时写进 output_savings.json。这份基线扫的是整形器上线之前的会话,相当于用历史数据拼出一个「假如没做整形会怎样」的假想对照组,这叫合成对照(synthetic control)。拿整形后实际观测到的输出,去和同类请求的基线均值相减,累加起来就是估计的节省。这个结果会带上置信区间,并且始终标注为「估计」,而不说是「测量」。
  • measured(A/B 留出测量):故意扣下一小撮对话不做整形,这叫留出集(holdout);这些对话进对照臂(control arm,也叫对照组),其余进处理臂(treatment arm,也叫试验组)正常整形。两边同类请求的均值之差,是一个无偏的因果估计。这是唯一能被称为「测量」的数字。
  • direct waste(直接浪费,无反事实):复读率(echo ratio),就是上一节提取的四个行为信号之一,表示响应和上下文之间的 n-gram(连续 n 个词的片段)重叠比例。它是单个响应自身的属性,不需要反事实就能测。

这里最关键、也最能体现设计诚实度的,是 measured 这一层。它是怎么留出对照组的呢?答案在 assign_arm 函数中,按对话做确定性分组:

def assign_arm(conversation_key: str, holdout_fraction: float) -> str:
    if holdout_fraction <= 0.0:
        return "treatment"
    if holdout_fraction >= 1.0:
        return "control"
    digest = hashlib.sha256(("arm:" + conversation_key).encode()).hexdigest()
    frac = int(digest[:8], 16) / 0xFFFFFFFF   # 映射到 [0, 1)
    return "control" if frac < holdout_fraction else "treatment"

上面的 holdout_fraction 对应环境变量 HEADROOM_OUTPUT_HOLDOUT,默认取值为 0.1。就是把大约 10% 的对话留作对照组、不做整形;设成 0 或干脆不设,全部进处理组,那就没有 measured 数字可报。

函数本身的逻辑很短。先处理两个边界:比例 ≤ 0 全部当处理组,≥ 1 全部当对照组。正常落在中间时,把对话 key 前面拼上固定前缀 "arm:",做一次 SHA-256,再取哈希的前 8 个十六进制字符,除以 0xFFFFFFFF,映射成 [0, 1) 上的一个伪随机小数 fracfrac 落在 holdout_fraction 左边就进对照组,否则进处理组。因为哈希对同一个 key 永远出同一个数,所以分组是确定性的:同一条对话每次进来都会落进同一组,不会在中途变化。

分组解决的是「做不做整形」,但光有组别还不够。不同请求天然就该吐出不同长度的输出:Opus 比 Haiku 啰嗦、带工具的机械续写比纯聊天短、输入 10 万 token 的上下文和输入 1 千 token 的也不一样。如果把所有请求的均值直接相减,混在一起的异质性会把因果效应淹没。所以还要分层(stratum):把「同类」请求放进同一格,只在同一格里比处理组和对照组。

分层用的特征必须在请求发出时就能观测到,绝不能看响应本身,否则就是用结果去分桶,因果估计就偏了。stratum_key 拼的是四样东西:

def stratum_key(*, turn_kind, input_tokens, model, has_tools) -> str:
    return "|".join((
        model_family(model),          # opus / sonnet / haiku ...
        turn_kind,                    # 轮次类型
        input_bucket(input_tokens),   # xs / s / m / l / xl
        "tools" if has_tools else "notools",
    ))

输入 token 数被故意划成很粗的几档(2k / 8k / 32k / 128k 为界),模型 id 也收成家族名。层划得太细,每一格样本会稀到基线噪声很大;粗一点,格子里才有足够的数可平均。合成对照的基线、A/B 的均值差,都是按这个 key 逐层算的:estimate = Σ (该层基线均值 − 该层观测输出),或 A/B 里 Σ (该层对照组均值 − 该层处理组均值)。只有两边都有数据的层才参与 measured 的汇总。

分组(进哪只臂)和分层(落进哪一格)的信息,全都通过已有的 transforms_applied 标签通道往下传,不用改动响应处理的任何路径。响应回来时,SavingsRecorder.record_from_labels 从标签里解出(组别,分层),把这一次的输出 token 记进对应格子的账本。估计的输出是带 95% 置信区间的,_finalize 用正态近似算出上下界:

@staticmethod
def _finalize(total_saved, total_baseline, var, n_requests, kind):
    pct = (total_saved / total_baseline * 100.0) if total_baseline > 0 else 0.0
    se = math.sqrt(var)
    lo = total_saved - 1.96 * se   # 95% 区间下界
    hi = total_saved + 1.96 * se
    # ... 换算成百分比返回

可以通过 headroom output-savings 命令查看详细的结果,它优先展示 measured 的数字,没有对照组数据时退回 estimated 的数字。

小结

这一篇我们学习了 Headroom 的输出 token 优化:

  1. 为什么输出也值得压:输出 token 的单价约为输入的 5 倍,浪费集中在三处:寒暄与收尾语、复述已有上下文、对机械步骤过度思考。代理本身不生成输出 token,只能通过改写请求去引导模型少写。
  2. 两根杠杆:详略引导往系统提示词末尾追加简洁指令,五个等级层层加码(1 级管寒暄、2 级管复述、3 级管理由和改写幅度、4 级电报体),默认 2 级;努力档位路由按消息结构识别机械续写、把它的思考档位调低,同时守住两条安全规则:只降不加、绝不动思考开关。
  3. 学习偏好headroom learn --verbosity 从打断率、快速跳过率等行为信号反推你想要的级别,启发式之外还能加 LLM 裁判,运行时还有 AIMD 控制器根据实时信号继续微调。
  4. 诚实的度量:输出节省是反事实问题,Headroom 把它分成三层:合成对照给出的估计(带置信区间、只标注为估计)、留出对照组的 A/B 测量(HEADROOM_OUTPUT_HOLDOUT),以及不需要反事实的直接浪费(复读率)。

至此,Headroom 的两个方向就凑齐了。把输入侧压缩和输出侧削减放在一起对比,正好作为整个系列的总结:

维度输入侧压缩输出侧削减
作用对象发给模型的内容模型写回来的内容
手法直接缩小文本体积改写请求去影响模型行为
节省是否可直接观测是,压前压后两个数一减否,是反事实,需估计或 A/B 测量
单价权重输入 token,单价较低输出 token,Opus 级约为输入的 5 倍
相关模块transforms/proxy/output_shaper.pyoutput_savings.py

输入侧是把已经确定的文本压小,是个纯函数,干净利落。输出侧动不了模型本身,只能通过改写请求去引导它少写,效果天生带不确定性,所以配了一整套诚实的度量。

写到这里,这个系列也差不多要告一段落了。回头看这条路线:第一篇介绍 Headroom 是什么、它要解决什么问题;第二篇把 headroom wrapheadroom proxy 跑起来;第三篇俯瞰架构,把 ContentRouter、三大压缩器、CacheAligner、CCR 和管线生命周期串成一张图;第四篇钻进 compress() 入口和管线编排的源码;第五篇细看 SmartCrusher、CodeAwareCompressor 和在本地推理的 Kompress;第六篇看 CCR 可逆压缩;第七篇看跨 agent 记忆和 headroom learn;到这最后一篇,把方向从输入侧翻到了输出侧。

从压缩内容到压缩生成,从纯函数式的确定节省到反事实的诚实估计,Headroom 这套东西的价值不只在省钱的数字,更在它对待「省了多少」这件事的态度。希望这个系列能帮你把 Headroom 从一个命令行工具,理解成一套可以借鉴的工程思路。

参考


学习 Headroom 的压缩管线

在上一篇里,我们从架构的角度把 Headroom 的压缩层俯瞰了一遍:内容进来之后先经过 ContentRouter 分流,再交给三大压缩器处理,中间还夹着 CacheAligner 和一整套贯穿全流程的生命周期事件。那一篇讲的是各个模块的分工和位置,属于总览。

今天我们换个视角,钻进源码里,顺着一次 compress() 调用往下追,目标是把「入口函数收到一批消息之后,到底发生了什么」这条主线看清楚。我们从最外层的入口函数看起。

compress() 入口

Headroom 对外暴露的最简单用法就是一个函数:compress(),它定义在 headroom/compress.py 里。不需要起代理、不需要写配置,把消息传进去,拿回压缩后的消息就行。函数签名如下:

def compress(
    messages: list[dict[str, Any]],
    model: str = "claude-sonnet-4-5-20250929",
    model_limit: int = 200000,
    optimize: bool = True,
    hooks: Any = None,
    config: CompressConfig | None = None,
    **kwargs: Any,
) -> CompressResult:
    ...

几个参数值得留意:

  • messages:一批消息,兼容 Anthropic 和 OpenAI 两种格式。
  • modelmodel_limit:用于 token 计数和上下文窗口大小的判断,默认按 Claude Sonnet 的 20 万 token 上限算。
  • optimize:是否真的压缩。传 False 会原样返回,方便做 A/B 对照(同一批消息,一边压一边不压,比较效果)。
  • config**kwargs:压缩选项,后者是前者的字段简写。先用传进来的 config(没有就取默认值),再拿 **kwargs 里对得上字段名的键去覆盖它。也就是说 compress(messages, protect_recent=0) 这种写法,等价于构造一个 CompressConfig(protect_recent=0)

CompressConfig:压缩到什么程度

CompressConfig 是面向用户的压缩选项,控制「压什么、压多狠、用哪个模型」。它是一个 dataclass,几个默认值透露了 Headroom 的取向:

@dataclass
class CompressConfig:
    compress_user_messages: bool = False       # 默认不压用户消息
    compress_system_messages: bool = True      # 默认压系统消息
    protect_recent: int = 4                    # 最近 4 条消息不动
    protect_analysis_context: bool = True      # 检测到分析/评审意图时保护代码
    target_ratio: float | None = None          # 保留比例,None = 模型自己决定
    min_tokens_to_compress: int = 250          # 短于 250 token 的消息跳过
    kompress_model: str | None = None          # 文本压缩模型 ID
    savings_profile: str | None = None         # 命名的高压缩档位

dataclass 是 Python 标准库提供的一种类写法,专门用来定义「主要用来装数据」的类。只要在类上加一个 @dataclass 装饰器,它就会按你声明的字段自动生成 __init____repr__ 等方法,字段还能直接写默认值,省去手写字段赋值的样板代码。CompressConfig 这种纯配置类用它正合适。

这些字段大致分三组。第一组决定压什么compress_user_messagescompress_system_messages 分别控制用户消息、系统消息要不要参与压缩;protect_recent 把最后 N 条消息保护起来不动,因为它们是当前对话的活跃部分;protect_analysis_context 更进一步,一旦识别出「分析」「评审」这类意图,就会把相关代码保护起来不压。

第二组决定压多狠target_ratio 是 Kompress 的保留比例,设 None 就由模型自己定(默认激进,大约只留 15%);min_tokens_to_compress 是参与压缩的最小 token 数,消息短于这个值就直接跳过,压缩本身有开销,太短不值得压。

第三组决定用哪个模型、用哪套档位kompress_model 是文本压缩用的模型 ID,默认是作者训练的 chopratejas/kompress-v2-base,可以换成 HuggingFace 上其它针对特定领域的模型,设为 'disabled' 则彻底关掉 ML 压缩;savings_profile 则是一套预设好的高压缩档位,它定义在 headroom/agent_savings.py,一共四个:

档位保留比例压用户/系统消息protect_recent特点
agent-9010%都压2最激进,强制走 Kompress,目标省 90%,面向 Codex/Claude/Cursor 这类 agent
balanced30%都不压4折中档,保护好用户和系统消息,目标省 70%
coding模型自定都不压2代码负载档,不钉死比例,靠无损压缩和相关性出节省
general模型自定都不压0通用档,代码少,没什么位置性内容要保护

这四个档位分两路:agent-90balanced 显式钉死了 target_ratio,直接规定保留多少;codinggeneral 不设这个比例,交给 Kompress 自己定,省多少主要看无损压缩和相关性过滤实际压掉多少。

从这些默认值能看出,Headroom 出厂时是按「包裹编程 agent」这个场景调的:用户自己的消息(compress_user_messages=False)和最近的 4 条对话(protect_recent=4)都保护起来不压,因为它们是当前正在处理的活跃上下文;真正拿来开刀的是那些塞了大段工具输出、日志、检索结果的历史消息。

CompressResult:结果长什么样

压缩结果是另一个 dataclass,CompressResult

@dataclass
class CompressResult:
    messages: list[dict[str, Any]]          # 压缩后的消息,格式和输入一致
    tokens_before: int = 0                  # 压缩前 token 数
    tokens_after: int = 0                   # 压缩后 token 数
    tokens_saved: int = 0                   # 省下的 token 数
    compression_ratio: float = 0.0          # 省下的比例,0.35 表示省了 35%
    transforms_applied: list[str] = field(default_factory=list)  # 用过哪些变换

关键的一点是 messages 的格式和输入完全一样,你可以直接把它塞回原来的 LLM 客户端调用里,无需改任何别的代码。transforms_applied 记录了这次实际跑过哪些变换(transform),后面排查「为什么没压」的时候很有用。

拿到管线并执行

配置就绪后,compress() 做的核心动作只有几行:

pipeline = _get_pipeline()
pipeline_extensions = PipelineExtensionManager(hooks=hooks, discover=False)

# ... 发出 INPUT_RECEIVED 事件、抽取用户查询 ...

result = pipeline.apply(
    messages=messages,
    model=model,
    model_limit=model_limit,
    context=context,
    biases=biases,
    compress_user_messages=cfg.compress_user_messages,
    compress_system_messages=cfg.compress_system_messages,
    target_ratio=cfg.target_ratio,
    protect_recent=cfg.protect_recent,
    # ... 把 CompressConfig 的字段透传给各个变换 ...
)

CompressConfig 里的字段在这里被摊平成一个个关键字参数,透传给管线,再由管线传给每个变换。这样每个变换都能看到「用户要不要压系统消息」「保护最近几条」这类全局意图。

执行完之后还有一道 膨胀防护栏(inflation guard) 值得注意:

if tokens_after > tokens_before:
    logger.warning("Optimization inflated tokens (%d -> %d); reverting to original messages", ...)
    return CompressResult(
        messages=messages,
        # ...
        transforms_applied=["inflation_guard:reverted"],
    )

如果「压缩」之后 token 数反而变多了(比如插入的标记比省下的还多),就直接回退到原始消息,并在 transforms_applied 里打上 inflation_guard:reverted 标记。压缩层的底线是绝不能帮倒忙。整个 apply() 外面还包了一层 try/except,任何异常都会记一次失败指标,然后原样返回输入消息。

_get_pipeline:懒加载的单例

_get_pipeline() 负责把管线装出来,它用的是单例(singleton,全进程只建一个实例)加线程锁的经典写法:

def _get_pipeline() -> Any:
    global _pipeline
    if _pipeline is not None:
        return _pipeline
    with _pipeline_lock:
        if _pipeline is not None:
            return _pipeline
        from headroom.transforms import TransformPipeline
        # Default pipeline: CacheAligner → ContentRouter
        _pipeline = TransformPipeline()
        return _pipeline

管线只在第一次调用时创建,之后复用同一个实例。这样管线里的压缩器只需加载一次,比如初始化 Rust 核心和 ML 模型,后面的每次 compress() 调用都直接复用,不用重复付出加载开销。

TransformPipeline 的编排顺序

管线的真身是 headroom/transforms/pipeline.py 里的 TransformPipeline。它的职责总结成一句话就是:按正确的顺序,把一串变换依次作用到消息上。默认装配哪些变换、什么顺序,由 _build_default_transforms() 决定:

def _build_default_transforms(self) -> list[Transform]:
    transforms: list[Transform] = []

    # 0. 工具结果拦截器(默认关闭,需 opt-in)
    if getattr(self.config, "intercept_tool_results", False) or \
            os.environ.get("HEADROOM_INTERCEPT_ENABLED"):
        transforms.append(ToolResultInterceptorTransform())

    # 1. Cache Aligner(前缀稳定,用于缓存命中)
    if self.config.cache_aligner.enabled:
        transforms.append(CacheAligner(self.config.cache_aligner))

    # 2. 内容感知压缩:ContentRouter 处理所有内容类型
    transforms.append(ContentRouter())
    return transforms

默认顺序就是注释里写的两步:先 CacheAligner,再 ContentRouter。顺序不能乱,CacheAligner 必须在前,因为它要在内容被改动之前先检查前缀的稳定性。

从代码里可以看到,管道最前面还有一个工具结果拦截器,默认关着,要靠环境变量或配置显式打开,它是专门针对「工具结果」的一类可插拔重写器。它和后面那些通用压缩器思路不同:通用压缩器拿到什么内容就压什么,拦截器则是按「这是哪个工具的返回」来匹配,命中了才对这个工具的结果做定制化的改写。目前仓库里只有一个具体实现:ast-grep 拦截器(astgrep.py),它匹配 Claude Code 的 Read 工具,当读出的是个代码文件且足够大时,调用 ast-grep 把整份文件内容替换成一份函数级大纲,只留每个顶层函数和类的签名、将函数体省略掉。

apply:逐个变换跑一遍

TransformPipeline.apply() 是真正干活的地方。剥掉计时、追踪、日志之后,主循环很简洁:

for transform in self.transforms:
    if not transform.should_apply(current_messages, tokenizer, **kwargs):
        continue
    try:
        result = transform.apply(current_messages, tokenizer, **kwargs)
    except Exception:
        self._breaker_record_failure()
        raise
    current_messages = result.messages
    all_transforms.extend(result.transforms_applied)
    # ... 累积标记、警告、计时 ...

每个变换调用前先被问一句 should_apply(),如果条件不满足就跳过,满足了才 apply(),输出的消息再喂给下一个变换。所有变换用过的记录都累积到 all_transforms 里,最后进 CompressResult.transforms_applied

这里还藏着一个熔断器(circuit breaker)

self._breaker_threshold = _breaker_env("HEADROOM_PIPELINE_BREAKER_THRESHOLD", 3, int)
self._breaker_cooldown_s = _breaker_env("HEADROOM_PIPELINE_BREAKER_COOLDOWN_S", 60.0, float)

如果管线连续失败达到阈值(默认 3 次),熔断器就打开,在冷却窗口(默认 60 秒)内所有请求都原样透传、不再尝试压缩,避免每个请求都去重跑一遍注定失败的变换。窗口过后再自动恢复。有一次成功就把连续失败计数清零。

ContentRouter:路由决策

ContentRouter 是整套压缩的核心分流器,代码在 content_router.py。它的任务是:分析一段内容,判断它是什么类型,然后交给最合适的压缩器。类型判断的第一步是内容检测:

mixed = is_mixed_content(content)
detection = _detect_content(content)
strategy = self._determine_strategy(content)

_detect_content() 优先走 Rust 核心里的原生检测链(基于 Magika,Google 开源的一个用机器学习识别文件类型的小模型),在 Windows 上因为原生检测可能卡死,默认降级到纯 Python 的正则检测。检测的结果是一个内容类型,比如 JSON 数组、源代码、搜索结果、构建日志等等。

拿到类型之后,_strategy_from_detection() 用一张映射表把类型翻译成压缩策略:

mapping = {
    ContentType.SOURCE_CODE: CompressionStrategy.CODE_AWARE,
    ContentType.JSON_ARRAY: CompressionStrategy.SMART_CRUSHER,
    ContentType.SEARCH_RESULTS: CompressionStrategy.SEARCH,
    ContentType.BUILD_OUTPUT: CompressionStrategy.LOG,
    ContentType.GIT_DIFF: CompressionStrategy.DIFF,
    ContentType.HTML: CompressionStrategy.HTML,
    ContentType.TABULAR: CompressionStrategy.TABULAR,
    ContentType.PLAIN_TEXT: CompressionStrategy.TEXT,
}
strategy = mapping.get(detection.content_type, self.config.fallback_strategy)

if (strategy == CompressionStrategy.CODE_AWARE
        and not self.config.prefer_code_aware_for_code):
    strategy = CompressionStrategy.KOMPRESS

映射表一目了然:JSON 数组走 SmartCrusher,搜索结果走 SearchCompressor,日志走 LogCompressor,git diff 走 DiffCompressor,纯文本走文本压缩。表里没匹配上的走 fallback_strategy,默认是 Kompress(作者训练的文本压缩模型)。

最后那个 if 值得注意:源代码本来映射到 CODE_AWARE,但因为默认配置里 prefer_code_aware_for_code=False,代码实际上被改道去了 Kompress。也就是说,默认情况下 Headroom 宁可让代码走通用文本压缩,也不轻易对代码做 AST(抽象语法树) 级别的改写,避免误伤。这一层的取舍我们留到下一篇讲三大压缩器时再展开。

上面说的是一段内容只属于一种类型的情况。如果一段内容里既有代码块、又有 JSON、还夹着散文,is_mixed_content() 会判定它是混合内容,走 _compress_mixed() 这条路:先用 split_into_sections() 把内容按代码围栏、JSON 块、搜索结果行拆成一段段带类型的片段,每段各自选策略压缩,最后再拼回去。这样一段图文并茂的工具输出里,代码归代码压、JSON 归 JSON 压,互不干扰。

# headroom/transforms/content_router.py(精简)
def _compress_mixed(self, content, context, ...):
    sections = split_into_sections(content)   # 拆成带类型的片段
    for section in sections:
        strategy = self._strategy_from_detection_type(section.content_type)  # 每段各选策略
        compressed_content, ... = self._apply_strategy_to_content(
            section.content, strategy, context, ...)
        if section.is_code_fence and section.language:
            # 保留代码围栏标记,如 ```python
            compressed_content = f"```{section.language}\n{compressed_content}\n```"
        compressed_sections.append(compressed_content)
    return RouterCompressionResult(
        compressed="\n\n".join(compressed_sections),  # 拼回去
        strategy_used=CompressionStrategy.MIXED,
        ...)

整个路由决策的流程可以画成这样:

compressors.png

CacheAligner:守住缓存前缀

ContentRouter 之前那一步是 CacheAligner,代码在 cache_aligner.py。要理解它,得先说清楚它守的是什么。

Anthropic、OpenAI 这些服务商都支持 prompt 前缀缓存(prefix cache):如果两次请求的开头一大段内容一模一样,服务商可以复用上一次算好的 KV cache(注意力机制里键值对的缓存,命中后这段内容几乎不重复计费),省钱又省时间。但缓存命中有个苛刻的前提:前缀必须逐字节稳定。只要系统提示词开头掺了一个会变的值,比如一个时间戳、一个会话 ID,缓存就会整段失效。

CacheAligner 的职责就是盯住这个隐患。在 Headroom 的早期版本中,它会去改写系统提示词,把动态内容抽出来重新插到别处。这个思路听上去挺顺:发模型之前先把易变内容摘掉,服务商缓存的就是干净前缀,下次再摘一次,不就命中了?但问题恰恰出在「摘」这个动作上。缓存命中的唯一标准是两次转发出去的前缀逐字节一致,而易变内容的位置、边界、和前后文字的关系并不固定,这次摘成这样、下次可能摘成那样,只要有一字之差缓存照样失效;把内容重新插到别处,插入的位置和格式又成了新的不稳定点。也就是说,越想靠中途改写在热区里制造稳定,越是在热区里不断制造新的字节变化,反而把缓存弄坏。源码里把这叫做违反了「缓存热区(系统提示词)绝不能被改动」的不变式,于是那条改写路径被彻底移除了。现在它是一个纯检测器:只发现问题、发警告,从不改消息。

正确的解法不是代理在中途帮你摘,而是从源头就别把易变内容放进系统提示词,把它挪到用户消息之类的地方。这样系统提示词天生就是逐字节稳定的,根本不需要谁来摘。所以 CacheAligner 检测到动态值时,给的是「把这些值挪出系统提示词」的建议,动手的决定权留给使用者。

检测的产物是 VolatileFinding(易变内容发现记录):

@dataclass(frozen=True)
class VolatileFinding:
    label: str      # 类型标签:uuid / iso8601 / jwt / hex_hash
    sample: str     # 截断后的样本,绝不记录完整内容

detect_volatile_content() 会把系统提示词切成 token 逐个分类,识别出四类易变内容:UUID、ISO 8601 时间戳、JWT 令牌、十六进制哈希。检测全程不用正则,而是靠结构化的解析器,比如用标准库的 uuid.UUID 去试解析、用 datetime.fromisoformat 去试时间戳,形状对得上才算数。一旦发现易变内容,就打印出一条警告信息:

if all_findings:
    counts = {}  # 统计每类各多少个
    # ...
    msg_text = (
        f"CacheAligner: detected volatile content in system prompt "
        f"({counts_str}); cache prefix unstable. "
        "Move dynamic values out of the system prompt to recover cache hits."
    )
    warnings.append(msg_text)
    logger.warning(msg_text)

小结

这一篇我们跟着一次 compress() 调用,把 Headroom 压缩管线的主干走了一遍:

  1. 入口 compress():解析 CompressConfig(默认按编程 agent 场景调,保护用户消息和最近 4 条),跑完管线拿到 CompressResult,中间有膨胀防护栏和异常兜底,绝不帮倒忙。
  2. _get_pipeline()TransformPipeline:懒加载的单例管线,默认顺序是 CacheAligner → ContentRouter。管线里还带连续失败熔断。
  3. ContentRouter 路由决策:先检测内容类型(原生 Magika 链,Windows 降级到正则),再查映射表选压缩器;代码默认改道走 Kompress;混合内容拆片段分别压。
  4. CacheAligner:一个纯检测器,用结构化解析(非正则)找出系统提示词里的 UUID、时间戳、JWT、哈希这类易变内容,发警告提示缓存前缀不稳,但从不改写提示词。

整体链路还是比较清晰的,至此,我们已经了解了「一段内容被送到哪个压缩器」这条路由主线,但每个压缩器内部到底怎么把 token 压下来,还没拆开。下一篇我们就深入三大压缩器:处理 JSON 的 SmartCrusher、AST 感知的 CodeAwareCompressor,以及跑在 Rust 核心里的 Kompress 文本压缩模型。

参考


学习 Headroom 的跨 agent 记忆与失败学习

在上一篇里,我们看了 Headroom 的 CCR(Compress-Cache-Retrieve,可逆压缩):压缩时把原文按哈希缓存在本地,模型觉得信息不够,就拿着哈希把原文取回来。它管的是「一次会话内」的信息不丢。这一篇我们看另外两块和「记住事情」有关的能力:一个是跨会话、跨 agent 的共享记忆,你在 Claude Code 里定过的偏好、积累的经验,能不能让 Codex、Gemini 下次也用上;另一个是 headroom learn,它会翻你过去的编程会话记录,自动找出反复踩的坑,把纠正写进各 agent 的上下文文件里。这两块的源码分别在 headroom/memory/headroom/learn/ 目录下。

headroom memory:跨 agent 的共享记忆

在第二篇的学习里,我们其实已经见过记忆的命令了,运行 headroom wrap claude --memory,代理会在流量里自动注入和提取记忆,什么都不用改。想在自己的代码里用,库提供了一个包装函数 with_memory()

from openai import OpenAI
from headroom import with_memory

# 一行套上,之后照常使用
client = with_memory(OpenAI(), user_id="alice")

# 第一个会话:随口告诉它你的偏好
client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "I prefer Python for backend work"}]
)

# 之后换一个全新会话:
client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "What language should I use?"}]
)
# 回答会引用上个会话记下的 Python 偏好

效果就是:第一个会话里你只随口说了句偏好,新会话里模型就能据此回答。这背后 with_memory() 在每次调用里做了三件事:

第一件是注入相关记忆:按当前的用户消息做语义检索,把查到的相关记忆拼进消息发给模型。拼的位置有讲究,不是塞进系统提示词,而是拼到第一条用户消息里。系统提示词是缓存热区,动了会让 prompt cache 整段失效,这和之前的 CacheAligner 是同一个考量。

第二件是指导模型如何记忆:Headroom 会在系统提示词里加一段固定指令,大意是,如果这轮对话里有值得长期记住的事实(用户偏好、身份、当前目标这类可复用的信息),就在回答之后输出一个 <memory> 块;寒暄、一次性问题、已经知道的信息不要记。格式是 XML 标签包一段 JSON:<memory>{"memories": [{"content": "..."}]}</memory>,没什么可记的,模型就输出空的 {"memories": []}

第三件是解析并保存记忆:Headroom 拿到响应后把这个块解析出来,逐条调 add() 存进记忆库里(下一节介绍);然后把块从响应里剥掉再返回,你看到的回答是干净的。这整个提取内联在同一次调用里完成,没有额外的 API 调用。

with-memory-three-things.jpg

攒下的记忆可以用 headroom memory 系列命令直接管理:

headroom memory list                 # 看存了哪些记忆
headroom memory list --scope USER    # 只看 user 级(跨会话持久)的
headroom memory list --since 7d      # 最近 7 天的
headroom memory stats                # 统计
headroom memory export --output backup.json  # 导出备份
headroom memory prune --older-than 30d       # 清理 30 天前的

记忆的使用比较简单,下面看它内部是怎么组织的。

分层记忆

上面说到,Headroom 从响应里解析出 <memory> 块之后,会逐条调 add() 把事实存进记忆库。这个 add() 就是记忆系统的核心入口,它所在的类是 core.py 里的 HierarchicalMemory。它把持久化存储、向量索引、全文索引、Embedding、缓存这些组件拼成一套统一的记忆 API,外界只用跟它打交道。看它的实现,一条记忆是怎么进来的:

async def add(self, content, user_id, session_id=None, agent_id=None,
              turn_id=None, importance=0.5, ..., auto_bubble=None):
    memory = Memory(content=content, user_id=user_id, session_id=session_id,
                    agent_id=agent_id, turn_id=turn_id, importance=importance, ...)
    if auto_embed:
        memory.embedding = await self._embedder.embed(content)   # 生成向量
    await self._store.save(memory)                               # 落库
    if memory.embedding is not None:
        await self._vector_index.index(memory)                  # 建向量索引
    await self._index_for_text_search(memory)                   # 建全文索引
    should_bubble = auto_bubble if auto_bubble is not None else self._config.auto_bubble
    if should_bubble:
        await self._maybe_bubble(memory)                        # 重要记忆上浮
    return memory

可以看到,一条记忆加进来,流程分四步:先给内容生成向量,然后把记忆本体落库,最后同时建两个索引,向量索引管语义检索,全文索引管关键词精确检索。

memory-add-four-step-pipeline.jpg

这四步各自对应 headroom/memory/adapters/ 下的适配器,而且每一步都留了可替换的后端:

步骤适配器后端选择
生成向量embedders.pysentence-transformers(默认,需要 torch 较重)、ONNX(推荐的轻量项,无需 torch、约 86MB)、OpenAI、Ollama
落库存储sqlite.py内置只有 SQLite,第三方存储可走 entry point 插件接入
向量索引sqlite_vector.py / hnsw.py默认自动选:有 sqlite-vec 就用它,否则回退 hnswlib
全文索引fts5.pySQLite FTS5(BM25 排序 + Porter 词干),也可走外部插件

向量索引管语义,全文索引管字面,两个配合起来就是常说的混合检索。

生成向量sentence-transformers 是 HuggingFace 生态里的老牌向量库,把一段文本编码成向量,效果好但要带 torch,体积较大;ONNX 是跨框架的模型推理格式,同一个模型改用它跑就不用装 torch,体积小很多,所以被标为推荐。OpenAI 和 Ollama 则是把向量生成外包给 API 或本地 Ollama 服务。

落库存储:SQLite 是嵌在进程里的本地数据库,不用单独起服务,记忆这种单机数据用它正合适。Entry points 是 Python 的插件发现机制,第三方包注册后能被自动找到,存储、索引这些后端都靠它对外开放。

向量索引sqlite-vec 是 SQLite 的向量检索扩展,向量存在数据库文件里,查询走页缓存,记忆条数再多内存占用也不涨。hnswlib 是 HNSW 算法的实现,HNSW(Hierarchical Navigable Small World)是一种近似最近邻算法,能在大量向量里快速找到语义最接近的几条,检索快,但整个图索引都在内存里,随条数涨。

全文索引FTS5(Full-Text Search 5) 是 SQLite 自带的全文检索扩展,直接在数据库里建全文索引,不用额外部署搜索引擎。BM25 是信息检索里经典的相关性打分算法,关键词命中越多、越稀有,分越高;Porter 词干提取则把 running、runs、ran 这类英文变形归到同一个词干 run,搜索按词干匹配,命中更全。

细心的读者会发现,add() 这个函数的签名里有 user_idsession_idagent_idturn_id 这一串参数,这是 Headroom 记忆系统的另一个特点 —— 分层作用域(scope)。一条记忆可以挂在四层里的任何一层:user → session → agent → turn,从宽到窄。注意这里的 agent 不是指「某个 agent 应用」,而是当前会话里的一个 agent 实例,一个会话里可以有多个 agent(比如主 agent 和它派生的 subagent),每个实例的存活期都在会话内部,所以 agent 比 session 窄。四层按存活期理解:user 跨所有会话,session 只管当前这一个会话,agent 管会话里某一个实例,turn 是单次 LLM 调用。

hierarchical-memory-scopes-and-bubbling.jpg

函数末尾的 _maybe_bubble 是配合分层的另一个重要机制:记忆上浮。它解决的问题是:一条记忆是在某个具体会话里产生的(session 级),会话一结束它就跟着没用了,可有些记忆明明值得长期留下。上浮的判断很直接,当重要性 importance 达到阈值(bubble_threshold,默认 0.7)的,就复制一份提到 user 级:副本的 session_id、agent_id、turn_id 全部清空,从此对这个用户的所有会话可见,同时记下 promoted_from(从哪条记忆升上来的)和 promotion_chain(提升链条),方便溯源;原记忆还留在原处不动。这样普通记忆随会话消亡,真正重要的少数会自己升上去,越攒越多。

记忆的双向同步

上面这套语义记忆是 Headroom 自己的存储,但各家编程 agent 其实都有自己的 markdown 记忆文件:Claude Code 的 MEMORY.md、Codex 的 AGENTS.md、Gemini 的 GEMINI.md。Headroom 支持在这两个世界之间做双向同步。一方面是导入侧,本质上也是一次 add() 调用,Headroom 把 markdown 解析成段落,按标题层级算出重要性,打上来源标签后写进来;另一方面是导出侧,就是反过来,把 Headroom 里新增加的记忆回写到 markdown 文件里,这个我们下一节再看。

对于 Claude Code,你可能更熟悉它的项目上下文文件 CLAUDE.md,而 Headroom 记忆同步的是它的自动记忆文件 MEMORY.md,放在 ~/.claude/projects/<项目>/memory/ 下,每次启动时前 200 行会常驻进上下文。

双向同步的核心逻辑位于 bridge.pyMemoryBridge 如下:

async def sync(self, paths=None, user_id=None) -> SyncStats:
    # 阶段 1:把 markdown 里新增 / 改动的段落导入 Headroom 语义记忆
    stats.import_stats = await self.import_from_markdown(paths=paths, user_id=user_id)
    # 阶段 2:把 Headroom 里新增的记忆导出回 markdown
    new_memories = await self._get_new_organic_memories(user_id, since)
    if new_memories and paths:
        count = await self._append_to_markdown(Path(paths[0]).expanduser(), new_memories)
    self._sync_state["last_sync"] = datetime.now(timezone.utc).isoformat()
    self._save_sync_state()

导入侧靠基于哈希的变更检测,每个文件、每个段落都存了内容哈希,没变的直接跳过,避免重复导入;导出侧只挑「原生记忆」,也就是 Headroom 自己生成的,而不是从 markdown 导进来的那些。具体靠元数据里的 source 标签把导入来的过滤掉,防止同一条内容在两边来回导。

async def _get_new_organic_memories(self, user_id, since=None):
    # ...
    # 过滤掉 metadata.source == source_tag 的记忆(那些是当初从 md 导入的)
    if metadata.get("source") == self._config.source_tag:
        continue

各 agent 的写入器

导出回 markdown 时,不同 agent 的文件格式不一样,这部分由 writers/ 下的一组写入器分别处理。它们共享一个基类 AgentWriter,通用的处理都放在基类里:按「重要度 × 新近度 × 访问次数」排序、按内容哈希去重、按 token 预算截断、用注释标记包裹自己管理的段落。

# writers/base.py
MARKER_START = "<!-- headroom:memory:start -->"
MARKER_END = "<!-- headroom:memory:end -->"

def export(self, memories, output_path=None, dry_run=True):
    ranked = sorted(memories, key=lambda m: m.score, reverse=True)   # 排序
    # 按 content_hash 去重
    # 按 token 预算截断
    formatted = self.format_memories(budgeted)                       # 子类实现格式
    section = f"{MARKER_START}\n{formatted}\n{MARKER_END}"           # 包进标记
    full_content = _merge_section(target, section)                   # 只替换标记内部

标记(marker)在这里划定了回写边界:写入器只碰 <!-- headroom:memory:start --><!-- headroom:memory:end --> 之间的内容,你自己在文件里手写的部分不会动。子类只需实现 format_memories(怎么排版)和 default_path(写到哪)。以 claude_writer.py 为例,这两个方法长这样:

# writers/claude_writer.py(精简)
def format_memories(self, memories: list[MemoryEntry]) -> str:
    """Format as Claude Code MEMORY.md section."""
    lines = ["## Headroom Learned Context",
             "*Auto-maintained by Headroom — do not edit manually*", ""]
    # 按 category 分组,每组一个 ### 小标题,记忆逐条列成列表项
    grouped: dict[str, list[MemoryEntry]] = defaultdict(list)
    for m in memories:
        grouped[(m.category or "General").replace("_", " ").title()].append(m)
    for heading, entries in grouped.items():
        lines.append(f"### {heading}")
        for entry in entries:
            lines.append(f"- {entry.content}")
        lines.append("")
    return "\n".join(lines)

def default_path(self) -> Path:
    """Default: Claude Code project memory directory."""
    if self._memory_dir:
        return self._memory_dir / "MEMORY.md"
    # ~/.claude/projects/-<sanitized-path>/memory/MEMORY.md
    sanitized = encode_claude_project_path(self._project_path)
    return Path.home() / ".claude" / "projects" / sanitized / "memory" / "MEMORY.md"

可以看到子类要做的就这两件事:format_memories 负责排版,把记忆按类别分组、每组一个小标题、逐条列成列表项;default_path 负责路径,返回的正是上面说的那个 ~/.claude/projects/<项目>/memory/MEMORY.md。剩下的排序、去重、截断、合并进标记块,都由基类包办了。几个写入器的差异也集中在这两点上:

  • claude_writer.py:写 Claude Code 的 MEMORY.md。它的 token 预算默认 2000,因为 Claude Code 只把 MEMORY.md 的前 200 行常驻上下文;超出的高重要度记忆会被 export_topics 按主题分别写进独立文件,按需加载,不挤占那 200 行的预算。
  • codex_writer.py:写 Codex 的 AGENTS.md,纯 markdown 无 frontmatter,默认预算 3000。
  • cursor_writer.py:写 Cursor 的 .cursor/rules/*.mdc,带 YAML frontmatter(文件头部的元数据块)。
  • generic_writer.py:兜底写入器,输出纯 markdown,任何读 markdown 上下文文件的 agent 都能用。它的 default_path 默认写到项目根目录的 HEADROOM_MEMORY.md,文件名可以传参指定。Gemini 没有专门的写入器,就可以用它,把文件名传成 GEMINI.md 即可。

整个记忆同步的数据流如下图所示:

cross-agent-memory-sync-flow.jpg

headroom learn:从失败会话里学经验

记忆是「你告诉它什么,它记什么」。headroom learn 更主动一点:它去翻你过去的编程会话记录,自动找出反复踩的坑,把纠正写进各 agent 的上下文文件里,下次这个坑就不会再踩。

headroom learn 默认是空跑(dry-run,只演示不落盘),加 --apply 才真正写文件:

headroom learn                        # 空跑,只看会给出什么建议
headroom learn --apply                # 落盘写入
headroom learn --project ~/my-project --apply   # 分析指定项目
headroom learn --agent codex --all    # 分析所有 Codex 会话
headroom learn --target CLAUDE.md     # 改写进团队共享文件

不过我第一次在一个项目上直接跑 headroom learn 就失败了,报 403 forbidden:这是因为 learn 对 claude 模型会绕过 ANTHROPIC_BASE_URL、直接请求官方 api.anthropic.com(本意是防止它指向本地代理),而我的 ANTHROPIC_API_KEY 是配给 MiniMax 这类第三方端点的,拿着它调用官方 API 自然被拒。改成 --model claude-cli 走本机 CLI(它会继承第三方端点配置)才跑通:

headroom learn --model claude-cli

跑通后,真实输出是这样:扫了 207 个会话、8614 次工具调用,其中 486 次失败(5.6%),给出 10 条建议:

headroom-learn.png

它给出的不是「Read 失败了 5 次」这种泛泛的统计,而是具体的纠正。官方文档里把这项机制叫做成功关联(Success Correlation):它不只是记录失败,还会找出模型后来是怎么修好的。比如这次运行里学到的一条经验:

  • 失败:在 manager/backend 子目录里执行 git add manager/...,报错 pathspec did not match(路径被拼成了 manager/backend/manager/...);
  • 后来成功:先 cd 到仓库根目录再 add;
  • 学到的经验:git 命令一律在仓库根目录执行

注意每条建议后面都跟着一个节省估算,这个数不是 LLM 拍脑袋估的,而是后面要讲到的循环检测实测出来的浪费下界。学到的模式大致分几类:防循环(上面这种)、环境事实(该用哪条命令)、路径纠正、搜索范围、命令模式、已知大文件。下次会话 agent 启动时读到这些,同类错误就不会再犯。写入位置默认是 CLAUDE.local.md(个人的、gitignored),想写进团队共享的 CLAUDE.md 就加 --target 参数。

Scanner → Digest → LLM → Recommendations

上面这些建议看着简单,背后的问题却不小:207 个会话、8614 次调用,怎么从里面找出值得学的模式?headroom learn 的答案是一条四步流水线,analyzer.py 开头的文档字符串写明了它的立场:

# Pipeline: Scanner (events) → Digest Builder → LLM → Recommendations
# No regex patterns, no static lookback windows, no hardcoded heuristics.
# A single LLM call understands the full conversation context and produces
# structured recommendations for CLAUDE.md / MEMORY.md.

这段说的是:不用正则、不用固定回看窗口、不用硬编码启发式规则,一次 LLM 调用理解完整对话上下文,产出结构化建议。这条流水线按字面就是四步,每步的职责是:

  1. Scanner(扫描):从磁盘上把 agent 的会话记录读出来。以 Claude Code 为例,读的是 ~/.claude/projects/<项目>/ 下的 JSONL 会话日志,把每一次工具调用(名字、入参、成功还是失败、token 数)和用户消息解析成结构化事件。每种 agent 一个插件(plugins/ 下的 claude、codex、gemini),运行输出里那行 Detected agents 就是这一步探测到的。
  2. Digest Builder(摘要):几百个会话、几千次调用不可能全塞给模型,这一步把它们压成一份 token 预算内(约 8 万 token)的文字摘要:项目概况和总数(多少会话、多少调用、失败率)、检测到的循环放在最前面(最贵的浪费模式,附实测浪费)、之前已学到的模式、以及每个会话精简后的事件流(报错截断、保留成功标记和用户消息)。它就是喂给 LLM 的那份「证据包」。
  3. LLM(分析):只发一次调用。系统提示词把它设定成「分析 coding agent 会话、提取能防止 token 浪费的模式」的专家,并给了明确的优先级,循环最高,往下是环境规则、文件结构事实、用户偏好、失败模式、工作流规则;用户消息就是那份摘要。返回结构化 JSON。
  4. Recommendations(建议):JSON 被解析成一条条 Recommendation,每条带着写到哪个文件(CLAUDE.local.md 还是 MEMORY.md)、具体内容和估计节省的 token。之后 apply_loop_weighting 用循环的实测浪费校准估算值,按节省降序排好,交给 writer.py 落盘。

learn-scanner-digest-llm-recommendations.jpg

所以判断「哪些是该学的经验」这件事本身,是交给一个 LLM 去做的,而不是用一堆正则去套。扫描和摘要都是确定性的机械工作,只有「从证据里提炼模式」这一步交给模型。SessionAnalyzer.analyze 就是把这四步串起来:

def analyze(self, project, sessions) -> AnalysisResult:
    all_calls = [tc for s in sessions for tc in s.tool_calls]
    failed_calls = [tc for tc in all_calls if tc.is_error]
    loops = detect_loops(sessions)                       # 先检测循环
    if not failed_calls and not loops and not any(s.events for s in sessions):
        return result                                    # 没失败、没循环、没事件,直接返回
    digest = _build_digest(project, sessions, loops=loops)   # 拼成紧凑摘要
    model = self.model or _detect_default_model()            # 自动选模型
    raw = _call_llm(digest, model)
    result.recommendations = _parse_llm_response(raw)        # 解析成建议
    apply_loop_weighting(result.recommendations, loops)      # 按实测浪费加权
    result.recommendations.sort(key=lambda r: r.estimated_tokens_saved, reverse=True)
    return result

值得注意的是,这里的模型调用走的是 LiteLLM 这个统一接口,不管你使用的是什么模型,一次 completion() 调用即可。如果不用它,就得为每家各写一套 SDK 的直调、各处理一套鉴权和响应格式。

具体用哪个模型,由下面这个顺序决定:

  1. 显式指定 --model 优先级最高,它的取值有两类:任意 litellm 模型名(100 多家 provider 任选),或三个本机 CLI 标识(转给本机对应的 CLI 做分析,支持 claude-cli / gemini-cli / codex-cli);
  2. 环境变量里有 API key,按一张写死的映射表来取:ANTHROPIC_API_KEYclaude-sonnet-4-6OPENAI_API_KEYgpt-4oGEMINI_API_KEYgemini/gemini-flash-latest
  3. 一个 key 都没有:看 HEADROOM_LEARN_CLI 环境变量指定的 CLI;
  4. 如果还没有:自动探测本机装了的 CLI 工具(claude > gemini > codex),让订阅用户不用另配 API key 也能用。

检测错误循环

headroom learn循环列为重点,因为一次性错误只浪费一次,而循环的浪费随重复次数累加。循环在流水线里被处理了两次:模型调用之前detect_loops 把它检测出来、连着实测浪费一起写进摘要,让模型看得到;模型调用之后apply_loop_weighting 再拿这份实测浪费去校准建议里的估算。

先看 detect_loops,它主要检查两种循环:

  • 错误循环:同一个调用失败、重试、又失败。比如反复去读一个根本不存在的路径。
  • RTK 重取循环:RTK(Rust Token Killer,第二篇介绍过的 shell 输出压缩工具)把 grep foo 改写成 grep foo | head -50,结果截断掉了 agent 真正要的内容,agent 只好换个变体再跑一遍(head -100、换偏移量)。每次调用都成功,所以纯看失败的分析根本发现不了它。

关键技巧是把这些变体折叠成同一个规范签名(signature),再数重复次数、算实测浪费的 token:

def _canonical_signature(tc: ToolCall) -> str:
    raw = tc.input_summary.strip()
    if tc.name.lower() in ("bash", "shell"):
        raw = _PAGINATION_RE.sub(" ", raw)   # 去掉 | head -50 / limit 100 这类分页片段
        raw = _INT_RE.sub("N", raw)          # 裸数字统一替换成 N
    raw = _WS_RE.sub(" ", raw).strip().lower()
    return f"{tc.name.lower()}::{raw}"

这样 grep foo | head -50grep foo | head -100 就归成了同一个签名。默认要重复满 3 次才算循环,这是能把「循环」和「一次性重试」区分开的最小次数。浪费的 token 是实测下界,不是让 LLM 猜的:错误循环里每次都算浪费,重取循环里第一次是正当工作、只算后面 N-1 次的重取。

检测发生在模型调用前,校准发生在模型调用后。模型返回建议之后,apply_loop_weighting 会把与某个循环签名重叠的建议的 estimated_tokens_saved 抬到至少等于该循环实测浪费的 token。因为循环的实测浪费是多次累加的,这一步能可靠地把「防循环」的建议排到「防一次性错误」的建议前面,而不必指望 LLM 自己把权重估对。

把纠正写进文件

模型给出建议、再经循环的实测浪费校准估算之后,流水线就剩最后一步:把建议写进文件,让下次会话的 agent 能读到。这一步由 writer.py 负责。它同样用标记块(<!-- headroom:learn:start --> / <!-- headroom:learn:end -->)圈出自己的地盘,只动块内的内容。至于写到哪个文件ClaudeCodeWriter 的默认目标不是 CLAUDE.md,而是 CLAUDE.local.md

def _resolve_context_path(self, project):
    if self._context_target is not None:
        # --target 显式指定的话,它说了算(比如想写进团队共享的 CLAUDE.md)
        ...
    if project.project_path == Path.home():
        return claude_config_dir() / "CLAUDE.md"   # 主目录下的是个人全局记忆
    return project.project_path / "CLAUDE.local.md"  # 项目级默认写个人文件

Claude Code 约定 CLAUDE.md 是团队共享,会提交进 git 仓库,而 CLAUDE.local.md 是个人的,默认被 gitignore 忽略,学到的模式一般都是「个人」的,所以默认写进 CLAUDE.local.md 文件。

如果你用的是别的 agent,目标文件也会跟着换:Codex 是 AGENTS.md,Gemini 是 GEMINI.md,这套映射由 headroom/learn/plugins/ 下各自的插件提供,这里不再赘述。

小结

这一篇我们学习了 Headroom 的两块「记忆」能力:

  1. 跨 agent 记忆:按 user -> session -> agent -> turn 四层作用域组织,普通记忆随会话消亡,重要的会自动上浮到用户级、跨会话越攒越多;检索同时走向量索引(HNSW)和全文索引(FTS5)两条路;它还能和各 agent 的 markdown 记忆文件双向同步:导入按哈希检测变更、只挑改动的段落,导出只回写自己新增的记忆,并用标记块圈定边界、绝不碰手写的内容。
  2. headroom learn:走 Scanner → Digest → LLM → Recommendations 的流水线,判断该学什么这件事交给模型而不是正则;loops.py 把错误循环和 RTK 重取循环折叠成规范签名、按实测浪费加权;writer.py 默认把纠正写进 gitignore 的 CLAUDE.local.md,也支持 AGENTS.mdGEMINI.md

到这里,关于 Headroom 模型输入这一侧的内容就基本讲完了。不过省 token 还有另一半没讲:模型输出的那部分。同样一个问题,模型可以啰嗦地复述一大段,也可以简洁作答,输出 token 一样要计费。Headroom 的 Output Shaper 就是冲着这半边来的。我们下一篇看它怎么削减输出 token,也给这个系列收个尾。

参考


学习 Headroom 的 CCR 可逆压缩

在上一篇里,我们学习了 Headroom 的三大压缩器:处理 JSON 数组的 SmartCrusher、基于 tree-sitter 做 AST(抽象语法树) 感知的 CodeAwareCompressor,以及作者自训、在本地推理的文本压缩模型 Kompress。它们能把工具输出、日志、代码片段压掉一大半,token 随之骤减。

不过压缩到这一步,有个绕不开的问题:压缩是会丢信息的。SmartCrusher 把 100 条搜索结果压成 10 条,剩下的 90 条并没有进模型的上下文。万一模型看完这 10 条,发现真正想要的答案在第 47 条上,怎么办?如果没有补救手段,那压缩省下的 token 就是以「模型可能答错」为代价换来的。

Headroom 给这个问题的答案叫 CCR(Compress-Cache-Retrieve,可逆压缩):压缩时把原文在本地缓存起来,同时告诉模型「你要是觉得不够,可以来取」。

CCR 原理解析

要实现压缩的「可逆」,必须得靠两样东西:一是原文不丢,按一个哈希键存进本地缓存(Python 侧默认是 ~/.headroom/ccr_store.db 这个 SQLite 库,Rust 侧还提供内存和 Redis 后端);二是压缩产物里带上这个哈希键的标记,模型凭它知道「不够可以来取」。

标记的形态不止一种。标准格式是方括号这样的:

[100 items compressed to 10. Retrieve more: hash=a1b2c3d4e5f6a1b2c3d4e5f6]

上一篇 SmartCrusher 压 JSON 数组时用的是另一种行内标记,作为一个哨兵元素嵌在数组末尾:

[
  {"ts": "10:00:01", "level": "INFO", "msg": "worker started"},
  {"ts": "10:04:59", "level": "ERROR", "msg": "connection refused"},
  {"_ccr_dropped": "<<ccr:a1b2c3d4e5f6 2_rows_offloaded>>"}
]

两种形态作用都一样:告诉模型原文在哪、怎么取。

模型如果只看压缩后的内容就够了,那什么都不用做,省下的 token 落袋为安;只有当它判断信息不够时,才拿着这个 hash 回来取原文。

CCR 模块的职责定义在 headroom/ccr/__init__.py 文件里,分成四块:

# 1. Tool Injection: 压缩发生时,代理往请求里注入 headroom_retrieve 工具
# 2. Response Handler: 拦截响应,自动处理模型发起的 CCR 工具调用
# 3. Context Tracker: 跨轮追踪被压缩的内容,按需主动展开
# 4. Batch Processing: 处理批量 API 结果里的 CCR 调用

ccr-four-components.jpg

我们挨个看这四块,它们合起来覆盖了实时和异步两种场景下的完整取回链路。

注入 retrieve 工具

模型要能主动取原文,前提是它手里得有这么一个工具可用。这件事由 tool_injection.py 负责。它的核心是一个工具定义 create_ccr_tool_definition

CCR_TOOL_NAME = "headroom_retrieve"

# Anthropic 格式(OpenAI / Google 各有一份,字段结构略有不同)
{
    "name": CCR_TOOL_NAME,
    "description": (
        "Retrieve original uncompressed content that was compressed to save tokens. "
        "Use this when you need more data than what's shown in compressed tool results. "
        # 取回被压缩掉的原始内容。当压缩结果里的数据不够用时调用它。
    ),
    "input_schema": {
        "type": "object",
        "properties": {
            "hash": {"type": "string", "description": "Hash key from the compression marker"},
        },
        "required": ["hash"],
    },
}

工具只有一个参数 hash,也就是压缩标记里那串哈希。注入的时机由 CCRToolInjector 控制,它的 scan_for_markers 会扫一遍请求里的所有消息,用一组正则去匹配各个压缩器留下的标记:

_marker_patterns = [
    # 标准格式: [N items compressed to M. Retrieve more: hash=xxx](24 位十六进制哈希)
    re.compile(r"\[(\d+) \w+ compressed to (\d+)\. Retrieve more: hash=([a-f0-9]{24})\]"),
    # SmartCrusher 的行内标记: <<ccr:HASH ...>>(12~24 位)
    re.compile(r"<<ccr:([a-f0-9]{12,24})\b"),
    # ... 省略若干兼容旧格式的正则
]

扫到标记就说明这一轮里有压缩内容,inject_tool_definition 会把 headroom_retrieve 追加进请求的工具列表。这里有个容易忽略的细节:一旦某个会话用过一次 CCR,后续每一轮都会粘性地保留这个工具,哪怕当前轮没有新的压缩标记:

def inject_tool_definition(self, tools, *, session_has_done_ccr=False):
    # session_has_done_ccr=True 时,即使本轮没有新标记也照样注入
    if not (session_has_done_ccr or self.has_compressed_content):
        return tools or [], False
    # 已经存在(比如来自 MCP server)就不重复注入
    for tool in tools or []:
        if (tool.get("name") or tool.get("function", {}).get("name")) == CCR_TOOL_NAME:
            return tools, False
    # ...

为什么要粘性保留?因为工具列表的字节一旦在会话中途变来变去,就会打破 Anthropic、OpenAI 的 KV cache,工具列表是缓存前缀的一部分,忽有忽无会让缓存整段失效。这一点和之前讲 CacheAligner 时是同一个考量:稳定前缀,让缓存真正命中。

拦截响应、自动取回

工具注入进去了,模型也调用了,可这个调用是发给谁的?模型以为它在调一个正常的工具,实际上这个工具由 Headroom 的代理自己兜住。这部分逻辑在 response_handler.pyCCRResponseHandler 里。

它的入口是 handle_response,拿到模型的响应后先判断里面有没有 CCR 调用,有就进入一个取回循环:

async def handle_response(self, response, messages, tools, api_call_fn, provider="anthropic"):
    current_response = response
    current_messages = list(messages)
    rounds = 0
    while rounds < self.config.max_retrieval_rounds:   # 默认最多 3 轮
        ccr_calls, other_calls = self._parse_ccr_tool_calls(current_response, provider)
        if not ccr_calls:
            break                                       # 没有 CCR 调用,收工
        if other_calls:
            break                                       # 混了别的工具调用,交回客户端处理
        rounds += 1
        results = [self._execute_retrieval(call) for call in ccr_calls]  # 本地取原文
        current_messages.append(self._extract_assistant_message(current_response, provider))
        current_messages.append(self._create_tool_result_message(results, provider))
        current_response = await api_call_fn(current_messages, tools)     # 带着原文续问一轮
    return current_response

这个循环的意思是:模型说「我要 hash=abc 的原文」,handler 就去本地缓存把原文捞出来(_execute_retrieval),拼成一条工具结果消息,替模型把对话续上,再发一轮 API 请求。模型这轮拿到了完整原文,通常就能给出真正的答案。整个过程对最终客户端是透明的,客户端只会收到最后那条不带 CCR 调用的响应。

_execute_retrieval 有两个细节。一是取回按哈希整块取回,返回的是完整原文,不做二次筛选:

entry = store.retrieve(ccr_call.hash_key)
if entry:
    content = json.dumps({
        "hash": ccr_call.hash_key,
        "original_content": entry.original_content,
        "original_item_count": entry.original_item_count,
    }, indent=2)
    return CCRToolResult(tool_call_id=..., content=content, success=True, ...)

二是缓存有 TTL 存活时长,过期就取不到了。这时 handler 会把失败状态原样返回给模型,让它知道这块内容已经不可用:

if entry_status is not None and entry_status["status"] != "available":
    content = json.dumps({
        "error": format_retrieval_miss_detail(entry_status),
        "hash": ccr_call.hash_key,
        "status": entry_status["status"],       # 比如 expired
        "ttl_seconds": ...,
    }, indent=2)
    return CCRToolResult(..., success=False)

整条 CCR 取回流程串起来如下图所示:

ccr-workflow.png

还有一种边界情况处理得很谨慎:如果模型在同一轮里既调了 headroom_retrieve、又调了别的正常工具,handler 会直接跳出循环、交回客户端。因为一条 assistant 消息里的每个工具调用都要有配对的工具结果,而 handler 只有 CCR 那部分的结果,硬拼一个续问请求会得到非法的消息序列。

那交回客户端之后,headroom_retrieve 这个调用谁来兑现呢?其实客户端自己就能兑现。取回工具有两条分发渠道:一条是上面讲的代理注入、由 handler 在代理侧自动兑现;另一条是 MCP server,也就是第二篇里 wrap 注册的那个 headroom MCP 服务,它把 headroom_retrieve 作为真正的工具挂在客户端上。

流式响应(streaming)也有对应的 StreamingCCRBuffer,思路是先缓冲、扫到 CCR 调用就切换成非流式处理,取回后再把续写流式吐出去。这里不展开。

跨轮主动展开

前两块解决的是「模型主动来取」。但还有一种情况:早几轮压掉的内容,模型其实已经忘了它存在。比如第 1 轮搜索返回 100 个文件、压成了 10 个,到第 5 轮用户问「那认证中间件呢」,模型压根不知道 auth_middleware.py 曾经出现在那被压掉的 90 个里。context_tracker.py 就是来补这一环的。

ContextTracker 会把每次压缩事件记下来,包括哈希、发生在第几轮、压缩前后的条数、当时的查询上下文,还有一段样本内容用于后面做相关性匹配。等新一轮用户消息进来,analyze_query 会拿这条查询去和历史压缩内容算相关性,够高就主动把对应原文展开:

def _calculate_relevance(self, query, context) -> float:
    query_words = set(self._extract_keywords(query.lower()))
    score = 0.0
    # 和样本内容的关键词重叠
    sample_words = set(self._extract_keywords(context.sample_content.lower()))
    if sample_words:
        score += len(query_words & sample_words) / len(query_words) * 0.5
        for word in query_words:                       # 长词命中额外加分
            if len(word) >= 4 and word in context.sample_content.lower():
                score += 0.2
    # 和当时查询上下文的关键词重叠
    # ... 省略
    return min(score, 1.0)

相关性算法本身是朴素的关键词重叠,加了几条加权:长词的精确子串命中额外给分、越旧的压缩内容按时间打折(age_factor)、超过 5 分钟的直接不考虑。超过阈值 0.3 的才会进推荐列表,每轮最多主动展开 2 条。

批量 API 里的取回

前面三块讲的都是实时请求:模型一响应,handler 当场拦截、当场续问。但还有一种调用方式不走这条路 —— 批量 API,比如 Anthropic 的 Message Batches API、OpenAI 的 Batch API、Gemini 的 Batch API 等。

batch-processing.png

批量 API 的玩法是:客户端把 N 个请求打包成一个数组一次性提交,拿到一个 batch ID(类似一个任务号),之后拿它轮询,直到全部跑完,再一次性拉回 N 份结果。批量请求里的内容同样会被 Headroom 压缩,因此模型同样可能会发起 headroom_retrieve 调用。但这条链路和实时调用完全不同,根本不存在「模型响应回来、代理当场拦截」的那一刻,Response Handler 是专为实时调用写的,自然用不上。

batch_processor.pyBatchResultProcessor 就是补这个场景的,分两步配合。提交批量时,先把每个请求的上下文(消息、工具列表)按 batch ID 存进 BatchContextStore;等客户端拿 batch ID 把 N 份结果全部拉回来时,处理器先按 batch ID 取出存好的上下文,再逐份扫描,发现哪份里有 CCR 调用就对哪份动手:从本地缓存取回原文、拼上工具结果、发起续问调用(最多 3 轮),最后把这份只有工具调用、没有答案的半成品结果,替换成带完整答案的结果。

注意这个续问调用不是再发起一次批量,而是普通的实时调用:Anthropic 走 /v1/messages,OpenAI 走 /v1/chat/completions,Gemini 走 generateContent。道理很简单:N 份结果里带 CCR 调用的往往就那么几份,为这几份再排一次异步队列、再等一轮,远不如直接同步调用快。三个服务商的批量结果格式各不相同,但这套"检测 → 取回 → 续问 → 替换"的逻辑是完全一样的。

到这里,ccr/__init__.py 里说的四块就齐了:实时请求靠 Tool Injection 和 Response Handler,跨轮遗忘靠 Context Tracker,异步批量靠 Batch Processing。

小结

这一篇我们把 Headroom 的 CCR 可逆压缩读完了,四块组件都看完了:

  1. CCR 的原理:压缩时原文不丢、按哈希缓存在本地,压缩产物带上标记,模型信息不够时凭哈希取回。传输有损,端到端无损。
  2. 三个组件串成实时取回流程tool_injection.py 往请求里注入 headroom_retrieve 工具(并粘性保留以护住 KV cache),response_handler.py 拦截并自动兑现模型的取回调用、带着原文续问一轮,context_tracker.py 跨轮追踪压缩内容、按查询相关性主动展开。取回工具有代理注入和 MCP server 两条分发渠道,混合调用时客户端走 MCP 自己兑现。
  3. 批量 API 里的取回:异步批量请求赶不上实时续问,由 batch_processor.py 在结果回来时补做"检测 → 取回 → 续问 → 替换"。

下一篇我们看输入侧的另外两块拼图:跨 agent 的共享记忆,以及从失败会话里学经验的 headroom learn

参考


学习 Headroom 的三大压缩器

在上一篇中,我们跟着 compress() 走完了整条压缩管线。当时看到 ContentRouter 会先识别一段内容到底是 JSON、代码还是普通文本,再把它交给对应的压缩器处理。这三类文本对应的压缩器分别是 SmartCrusherCodeAwareCompressorKompress,今天我们就来逐个学习下这三大压缩器。

compressors.jpg

SmartCrusher:统计式压缩 JSON 数组

工具调用返回的内容里,最常见的一种形态是一个很长的 JSON 数组,每个元素结构都差不多。比如调用一个 API 接口拉回来的一批记录,或者 Docker 的 JSON 日志一行一个对象,每条都是同一套字段。模型真正需要的往往是头部几条和尾部几条,中间几十条高度雷同的记录既占 token,又没带来新信息。SmartCrusher 做的就是统计这个数组的结构规律,保留最有代表性的若干条,把其余的丢进 CCR(Compress-Cache-Retrieve,可逆压缩)缓存。

这个压缩器的 Python 实现已经在最新版本中整个搬到了 Rust。打开 smart_crusher.py,文件顶部有一行注释:所有数组压缩现在都走 headroom._core.SmartCrusher,也就是从 crates/headroom-py 编译出来的 Rust 扩展。Python 侧只留下了配置类和一层薄薄的转发。所以要讲清它的工作原理,得直接看 Rust 那边的实现。

按数组分类选压缩策略

SmartCrusher 不是一上来就压,它先让一个分析器把这个数组摸清楚。具体的做法是把数组里所有项的字段名合并起来,逐个字段统计一遍,给每个字段算一份 FieldStats。这份统计大致长这样:

// crates/headroom-core/src/transforms/smart_crusher/types.rs(精简)
pub struct FieldStats {
    pub field_type: String,        // numeric / string / boolean / object / array
    pub count: usize,              // 这个字段出现了多少次
    pub unique_count: usize,       // 有多少个不同的值
    pub unique_ratio: f64,         // 不同值占比 = unique_count / count
    pub is_constant: bool,         // 是不是所有项都一样
    // 数值字段专有:min_val / max_val / mean_val / variance / change_points
    // 字符串字段专有:avg_length / top_values(按频率排的高频值)
}

可以看出统计的维度挺有讲究:unique_ratio 看一个字段的取值有多「重样」,比如日志的 level 字段翻来覆去就 INFO、ERROR 几个值,这个比例就很低;而 message 字段每条都不太一样,比例就高。数值字段额外记方差和变化点(数值突然跳变的位置),字符串字段额外记平均长度和最高频的几个值。

统计完每个字段,下一步把这些 FieldStats 翻译成这个数组「是什么类型」:

  • 有时间戳字段、数值字段又有方差的,是 time_series
  • 同时存在一个高基数的文本字段(像 message)和一个低基数的级别字段(像 level)的,是 logs
  • 有字段被判定为「像分数」的,是 search_results
  • 都不沾边的,归为 generic

认完类型,select_strategy 再据此选对应的压缩策略:

// crates/headroom-core/src/transforms/smart_crusher/analyzer.rs(精简)
pub fn select_strategy(&self, field_stats, pattern, item_count, ...) -> CompressionStrategy {
    if item_count < self.config.min_items_to_analyze {
        return CompressionStrategy::None;        // 数组太短,不压
    }
    if pattern == "time_series" && has_change_points {
        return CompressionStrategy::TimeSeries;  // 时间序列,盯变化点
    }
    if pattern == "logs" && message_field.unique_ratio < 0.5 {
        return CompressionStrategy::ClusterSample; // message 字段大量重复 → 聚类
    }
    if pattern == "search_results" {
        return CompressionStrategy::TopN;        // 搜索结果 → 取 top N
    }
    CompressionStrategy::SmartSample             // 通用数组 → 智能抽样
}

这个函数就是「类型 → 策略」的一张映射表,但有两个细节值得留意。一是它带前置门槛:数组元素太少(少于 min_items_to_analyze)直接返回 None 不压,不值得为一个短数组费这个劲。二是日志那档多加了一道确认:光认出 logs 类型还不够,还要 message 字段的 unique_ratio < 0.5(一半以上的值是重复的)才真的走聚类,因为聚类压的就是重复模板,如果 message 每条都不同,聚类就没意义了。认完类型、过完这些门槛,才知道该用哪种思路去挑要保留的项。

按策略挑出要保留的下标

归好类,就生成一个压缩计划 CompressionPlan。它的核心是一份 keep_indices,也就是要保留的原数组下标清单,但完整定义里还带了一些执行时要用的信息:

// crates/headroom-core/src/transforms/smart_crusher/types.rs
pub struct CompressionPlan {
    pub strategy: CompressionStrategy,           // 用哪种策略
    pub keep_indices: Vec<usize>,                // 要保留的原数组下标
    pub constant_fields: BTreeMap<String, Value>,// 所有项都相同的字段,可抽出来只留一份
    pub summary_ranges: Vec<(usize, usize, Value)>, // 被归纳成摘要的区间
    pub cluster_field: Option<String>,           // 日志聚类时按哪个字段分簇
    pub sort_field: Option<String>,              // 排序/取 top N 时按哪个字段
    pub keep_count: usize,                       // 保留多少条
}

keep_indices 是这份计划的主体,挑选它的信号有好几路:

  • 搜索结果TopN):数组里那个「像分数」的字段(比如每条命中自带的相关度分),按它从高到低排序、取前 N 条。注意这个分数是数据自带的,跟你当下查什么没关系,所以它只适合本身就有排序依据的搜索结果。
  • 日志ClusterSample):把内容模板相同的行聚成簇,日志往往同一句报错刷几十遍,只有时间戳在变,每个簇只留一条代表,其余的去掉,重复的刷屏就压掉了。
  • 通用保底:带报错词的行、取值异常稀有的行,强制保留。报错词是一份写死的清单(errorexceptioncrashtimeout 等十几个),只要一条里出现其中任何一个就保留。取值稀有针对的是另一类情况:有些异常不带 error 字样,比如一个状态码字段 95 次是 ok、只有 5 次是各种错误码,这些低频值本身就说明不正常,含它们的行也要保留。两道兜底都是为了防止主策略(按相关性取 top N、聚类留代表)把最关键的报错和异常给淘汰掉。
  • 查询相关性:这一路会看查询上下文(也就是用户当前的问题),先拿它做确定性的关键词精确匹配,再用一个相关性打分器给每条和这句话的相关程度打个分,超过阈值就保留。这个打分器是「BM25 关键词匹配 + 向量语义相似度」的混合:BM25 看共享多少关键词,向量看语义上有多接近,两者按权重融合,遇到 UUID、ID 这类需要精确匹配的查询还会自动调高关键词的权重。它是叠加在前面所有策略上的,让最终的保留清单向你当前关心的问题倾斜。
  • 位置锚点:保留头部、尾部各一小部分,保证开头结尾总有代表。

这几路信号挑出来的下标合并去重,就是最终保留的那批。所以 SmartCrusher 不是简单地「掐头去尾、中间全删」,真正的核心是先认类型,再按类型用相关性打分、聚类、异常检测这些手段选出最有代表性的若干条,头尾那部分只是其中一路保底。

生成 CCR 标记

挑出要丢的行之后,还不能一删了之。crush_array 末尾会把完整的原数组序列化一次、算出哈希、存进 CCR 缓存,然后生成一个指向这个哈希的标记:

// crates/headroom-core/src/transforms/smart_crusher/crusher.rs(精简)
let dropped_count = items.len() - result.len();
if dropped_count > 0 && self.config.enable_ccr_marker {
    let canonical = canonical_array_json(items);   // 完整原数组
    let h = hash_canonical(&canonical);
    let marker = format!("<<ccr:{h} {dropped_count}_rows_offloaded>>");
    if let Some(store) = &self.ccr_store {
        store.put(&h, &canonical);                 // 原文按哈希存进缓存
    }
    // marker 会被放进输出,模型凭它把原文取回来
}

这个 <<ccr:HASH N_rows_offloaded>> 标记就是可逆的关键:原文按哈希存在本地,模型之后发现信息不够,拿这个哈希就能把丢掉的那 N 行原样取回来。

压前 vs 压后

举个直观的例子。假设一次日志查询返回了这样一个数组(这里精简到 4 条示意,实际可能是几十上百条):

[
  {"ts": "10:00:01", "level": "INFO", "msg": "worker started"},
  {"ts": "10:00:02", "level": "INFO", "msg": "worker started"},
  {"ts": "10:00:03", "level": "INFO", "msg": "worker started"},
  {"ts": "10:04:59", "level": "ERROR", "msg": "connection refused"}
]

SmartCrusher 去重、抽样之后,可能得到:

[
  {"ts": "10:00:01", "level": "INFO", "msg": "worker started"},
  {"ts": "10:04:59", "level": "ERROR", "msg": "connection refused"},
  {"_ccr_dropped": "<<ccr:a1b2c3d4e5f6 2_rows_offloaded>>"}
]

可以看到,输出仍然是原数组里的元素,schema 完全没变。中间两条重复的 INFO 被丢掉了,末尾多出来一个 _ccr_dropped 哨兵对象,它不是真正的记录,只是给模型看的一个提示:这里省了 2 行,需要的话可以用 CCR 取回。文件里还专门提供了 strip_ccr_sentinels 函数,方便下游遍历数组时把这个哨兵过滤掉,免得当成正常记录处理。

官方给出的一组真实压缩基准里,代码搜索场景(100 条结果)从 17,765 token 压到 1,408,省了 92%;SRE 事故排查场景从 65,694 压到 5,118,同样是 92%。这类高度结构化、大量重复的数组,正是 SmartCrusher 最擅长的场景。

CodeAwareCompressor:AST 感知的代码压缩

第二位处理的是源代码。代码和 JSON 数组不一样,它有严格的语法,随便截断几行就可能变成一段无法解析的乱码。CodeAwareCompressor 的核心承诺是:压缩后的代码一定仍然是语法有效的。它的做法是先把代码解析成 AST(抽象语法树)。然后保留 import 语句、函数签名和类型注解这些结构性骨架,只压缩函数体内部的实现细节,最后再拼回一段合法代码。

这套思路参考了一篇叫 LongCodeZip 的论文(ASE 2025),它专门解决代码的长上下文压缩。通用的文本剪枝方法(比如 LLMLingua)不理解代码的结构和依赖,效果有限,LongCodeZip 则按代码的结构来压。做法是分两阶段:先做粗粒度,把代码按函数切成块,用「相对你的指令的条件困惑度」给每个函数打分、只留和任务最相关的函数;再做细粒度,把留下的函数体内部再切成更小的块,按 token 预算挑出最相关的子集。论文报告在不掉任务表现的前提下最高能压到 5.6 倍。

CodeAwareCompressor 保留签名、按重要性分配函数体预算,和它是同一路数,只不过落地时换成了 tree-sitter 静态解析,不用真的去跑困惑度。tree-sitter 是一个增量式的代码解析库,能把多种语言的源代码解析成统一的语法树结构,很多编辑器用它来做语法高亮和代码折叠。

tree-sitter.png

code_compressor.py 的整体流程可以画成一张图:

code-compressor.png

用数据表描述每种语言

CodeAwareCompressor 支持不少的编程语言:第一梯队是 Python、JavaScript、TypeScript,第二梯队还有 Go、Rust、Java、C、C++ 和 Perl。要为这么多语言各写一套抽取逻辑,代码会非常臃肿。Headroom 的做法是把每种语言的差异抽成一张数据表 LangConfig,让同一套通用逻辑去查表:

@dataclass(frozen=True)
class LangConfig:
    import_nodes: frozenset[str]      # 哪些 AST 节点算 import
    function_nodes: frozenset[str]    # 哪些算函数定义
    class_nodes: frozenset[str]       # 哪些算类定义
    type_nodes: frozenset[str]        # 哪些算类型定义
    body_node_types: frozenset[str]   # 哪些算函数体
    comment_prefix: str               # 注释前缀,Python 是 #,C 系是 //
    uses_colon_after_signature: bool  # Python 签名后跟冒号,C 系跟花括号
    # ...

以 Python 为例,它的配置就是把 import_statementfunction_definitionclass_definition 这些 tree-sitter 节点类型分门别类填进去。结构抽取时只有一个通用的 visit 访问器遍历语法树,遇到某个节点就查 LangConfig 判断它属于哪一类,完全不需要为每种语言重复写方法。

压缩函数体

压缩的关键在 _compress_function_ast。它拿到一个函数节点后,先从 AST 里精确定位函数体,再按分配到的行数预算保留若干条完整语句:

# 按 AST 里的语句逐条保留,绝不从表达式中间切断
for start_row, end_row in body_stmts:
    stmt_lines = code_lines[start_row : end_row + 1]
    stmt_line_count = len(stmt_lines)
    # 加上这条就超预算,且已经留了至少一条,就停在这里
    if kept_line_count + stmt_line_count > body_limit and stmts_kept > 0:
        break
    kept_lines.extend(stmt_lines)
    kept_line_count += stmt_line_count
    stmts_kept += 1

这里的关键设计是按语句而不是按行截断。它遍历的是 AST 里的语句节点,每一个都是完整、合法的语句,保留到预算用完为止。这样无论砍到哪里,剩下的代码都能正常解析,不会出现半句 if 或者没闭合的括号。

每个函数保留多少行,不是平均分配的,而是由 _analyze_symbol_importance 打分决定。这个方法综合了几个信号:一个符号被引用了多少次、它调用了多少别的函数(扇出)、它是不是公开符号、名字是否命中了当前查询的上下文。被引用得多、和查询相关的函数,会分到更多的行数预算,实现细节保留得更完整;边角料函数则可能只剩个签名。

docstring(文档字符串)默认走 FIRST_LINE 模式,多行 docstring 只保留第一行摘要并正确闭合引号,剩下的说明文字全部压掉。

三道安全阀

compress() 方法里有三处保护,任何一处不满足都会原样退回,绝不输出坏代码:

  • 语法校验:拼回代码后再用 tree-sitter 解析一遍,只要出现 ERROR 或 MISSING 节点就退回原文。
  • 过度压缩保护:如果压缩比低于 0.05(也就是只剩 5% 不到),判定为压得太狠、可能丢了数据,退回原文。
  • 异常兜底:AST 压缩过程中抛任何异常,都退回原文或转交 Kompress。

压前 vs 压后

用一个 Python 函数来感受一下(仿照源码顶部的示例,docstring 扩充成了多行):

import os
from typing import List

def process_data(items: List[str]) -> List[str]:
    """Process a list of items.

    Each item is validated and, when non-empty, normalized by
    stripping whitespace and lowercasing. Invalid (falsy) items
    are skipped. The normalized items are collected in order
    and returned as a new list.
    """
    results = []
    for item in items:
        # Validate item
        if not item:
            continue
        # Process valid item
        processed = item.strip().lower()
        results.append(processed)
    return results

压缩后变成:

import os
from typing import List

def process_data(items: List[str]) -> List[str]:
    """Process a list of items."""
    # ... (body compressed: 10 lines → 2 lines)
    pass

import 一行不动,函数签名连同类型注解 List[str] 完整保留,多行 docstring 只留了第一行摘要、后面那段详细说明被压掉了,函数体那一大段实现也只剩一行占位注释。对于一次代码检索返回的多个文件,模型光看签名和类型往往就够判断该看哪个函数了;真要深入某个函数的实现,再通过 CCR 把原文取回来即可。压缩显著时,CodeAwareCompressor 还会在末尾追加一条注释,写明省了多少 token、CCR 的 hash 是多少、多久过期。

Kompress:跑在本地的 ModernBERT 压缩模型

前两个压缩器面对的都是结构清晰的内容:JSON 有 schema,代码有语法。可现实里还有大量没有明显结构的文本,比如报错栈、RAG 检索回来的文档片段、大段的对话记录。这类内容 SmartCrusherCodeAwareCompressor 都使不上劲,这时就该 Kompress 上场了。

Kompress 是作者专门训练的一个文本压缩模型,托管在 HuggingFace 上,模型 ID 是 chopratejas/kompress-v2-base。和前两个基于规则的压缩器不同,它是一个真正的神经网络模型,逐个 token 判断该保留还是丢弃。

双头 ModernBERT

Kompress 是在一个叫 ModernBERT 的开源模型之上实现的,先简单认识一下这个模型。

ModernBERT 是 Answer.AI 团队(联合 LightOn 等)在 2024 年底发布的 BERT 现代化版本,论文叫《Smarter, Better, Faster, Longer》。相比 2018 年的原版 BERT,它把后来主流大模型的不少新技术搬了过来:用 RoPE 旋转位置编码替换了老式绝对位置编码,原生支持 8192 token 的上下文(是 BERT 512 的 16 倍),长文本处理速度是同级编码器的两三倍,还首次把代码数据纳入预训练,所以在代码相关任务上格外强。这些特点对 Kompress 很关键:日志、文档动辄几千 token,上下文不够长就放不下;压缩又跑在代理热路径上,速度慢了会拖垮请求。Kompress 用的 base 版有 1.49 亿参数,每个 token 的向量维度是 768。

它是一种编码器模型,作用是读完一段文字后,给里面每个 token 都算出一个向量,这个向量捕捉的是这个 token 在上下文里的含义。比如 apple 在「吃了一个 apple」和在「apple 发布了新手机」里,算出来的向量是不一样的,因为模型看了它前后文。这一步解决的是「理解」:模型由此知道每个 token 在当前语境里是什么意思。

但理解归理解,这些向量本身只是一堆数字,还没回答「这个 token 要不要留」。要回答这个问题,需要在编码器的输出之上再接一个判断层,也就是所谓的头(head)。头本身不大,就是把 768 维的 token 向量映射成你想要的答案,具体用什么层随任务而定。以 Kompress 的 token 头为例,它是一个 768 → 2 的线性层:把某个 token 的向量乘上一个学好的权重矩阵,输出「该丢」「该留」两个得分,比一下大小就有了去留。训练时,骨干(ModernBERT)和头一起被优化:给模型看成堆标注好「哪些 token 该留」的文本,不断调整权重,直到头的判断越来越准。之所以叫「头」,是相对于「骨干」而言的,骨干负责通用的语言理解、可以原样复用,换任务时往往只需换掉或新训顶上这个小小的头,不必重训整个大模型,这是迁移学习里常见的做法。

Kompress 正是拿 ModernBERT 当骨干负责理解,再在顶上接两个这样的头,所以叫「双头」。

Kompress 源码解读

打开 kompress_compressor.py,模型结构定义在 HeadroomCompressorModel 里:

class HeadroomCompressorModel(nn.Module):
    """Dual-head ModernBERT: token classification + span importance CNN."""

    def __init__(self, model_name="answerdotai/ModernBERT-base"):
        super().__init__()
        self.encoder = AutoModel.from_pretrained(model_name, ...)  # 加载 ModernBERT
        hidden_size = self.encoder.config.hidden_size  # 向量维度 768,两个头都以它为输入

        # 头 1:768 → 2 的线性层,逐 token 输出「该丢」「该留」两个得分
        self.token_head = nn.Linear(hidden_size, 2)

        # 头 2:一维卷积,评估一小段连续区域的重要性
        self.span_conv = nn.Sequential(
            # 每次看 5 个相邻 token,提取 256 个局部特征;padding 保证输出与输入等长
            nn.Conv1d(hidden_size, 256, kernel_size=5, padding=2),
            nn.GELU(),  # 非线性激活,否则两层卷积等价于一层
            # 窗口收窄到 3,把 256 个特征聚成每个位置 1 个重要性分
            nn.Conv1d(256, 1, kernel_size=3, padding=1),
            nn.Sigmoid(),  # 压进 0~1,变成可直接跟阈值比较的分数
        )

这两个头分工不同。token 头看的是单个 token:把某个 token 的 768 维向量映射成两个数,分别代表「该丢」和「该留」的得分,比较一下大小就知道这个 token 去留。span 头看的是一小段连续区域:用两层一维卷积把相邻 token 的向量扫一遍,输出一个 0 到 1 之间的分数,表示「这一整片内容重不重要」。为什么用两层而不是一层?这是因为一层卷积只是对窗口内几个 token 做线性加权,学不会需要组合特征才能识别的复杂模式;先展开成 256 个特征通道、配上非线性再聚合,才有能力先提取局部特征、再据此打分。

一维卷积(Conv1d)可以理解成一个在序列上滑动的「小窗口」。它拿一个固定宽度的窗口,从文本开头往结尾一格一格地滑,每滑到一个位置,就把窗口里那几个相邻 token 的向量合在一起算出一个值。和线性层只看单个 token 不同,卷积这个窗口一次看好几个相邻的 token,所以它捕捉的是「这一小片」的局部特征,而不是孤立的某个词。窗口宽度由 kernel_size 决定,Kompress 的 span 头第一层窗口是 5、第二层是 3,两层叠起来,输出每个位置实际覆盖前后共 7 个 token。

那为什么要两个头呢?一个不够吗?关键在「拿不准」的情况。模型对很多 token 的去留其实很纠结,单独看它,留也行丢也行。这时候光看单个 token 容易误删,span 头提供的就是一个「看大局」的补救:如果某个 token 处在边界地带(保留概率在 0.3 到 0.5 之间、模棱两可),但它所在的这一片被 span 头判为重要(得分超过 0.5),那就宁可把它留下来。实际的判定逻辑就一行:

# kompress_compressor.py(精简)
keep = token_keep | (borderline & span_boost)
# token_keep:token 头明确说留
# borderline:这个 token 模棱两可(保留概率 0.3~0.5)
# span_boost:它所在的片段被判为重要(span 得分 > 0.5)

翻译过来就是:token 头明确说留的留;模棱两可、但所在片段重要的,也留。 其余的就丢掉。这样单个 token 判断的「细」和片段判断的「稳」就互补上了,不容易因为某个 token 单独看不显眼就把它误删,从而把一整句关键信息拆断。

必留 token 的硬性保险

光靠模型打分还不够。有些 token 一旦丢掉,模型没法从剩下的文本里推断出来,比如具体的数字、错误码、文件路径等,这样的值丢了,看上下文是猜不回来的。虽然 CCR 缓存着原文,但模型得先意识到自己缺了关键信息才会去取回,而这类精确值被悄悄丢掉时往往连个缺口都看不出来,所以不能指望 CCR 兜底。kompress_compressor.py 用一条正则定义了这些必留 token

_KOMPRESS_MUST_KEEP_RE = re.compile(
    r"\b0x[0-9A-Fa-f]+\b"                 # 十六进制地址:0x7fff2038
    r"|(?<![\w.])\d+(?:\.\d+)?(?![\w.])"  # 独立数字:42、3.14
    r"|[A-Z_]{2,}"                        # 全大写:SIGILL、EOF、ERROR
    r"|[a-z_][a-z0-9_]*\.[a-z0-9_]+"      # 带点路径:libsystem_kernel.dylib
    r"|/[a-z0-9/._-]{2,}"                 # unix 路径:/usr/lib/python3.so
    r"|--?[a-z][\w-]*"                    # 命令行 flag:--verbose、-n
    # ...
)

不管模型给这些 token 打多低的分,_add_kompress_must_keep_words 都会强行把它们保留下来。这是一道防止模型误伤关键信息的硬性保险。

压前 vs 压后

Kompress 的压缩是词级别的丢弃。比如这样一句啰嗦的报错描述:

The application process crashed with signal SIGILL at address 0x7fff2038 in libsystem_kernel.dylib
# 应用进程因信号 SIGILL 在地址 0x7fff2038 处崩溃,位置在 libsystem_kernel.dylib

模型判断后可能压成:

crashed signal SIGILL address 0x7fff2038 libsystem_kernel.dylib
# 崩溃 信号 SIGILL 地址 0x7fff2038 libsystem_kernel.dylib

Thewithatin 这些没有信息量的虚词被丢掉了,而 SIGILL(全大写命中必留规则)、0x7fff2038(十六进制地址)、libsystem_kernel.dylib(带点路径)这些排查问题真正要用的 token 一个都没少。虽然读起来不再是通顺的句子,但模型需要的语义信息完整保留。压缩显著时,Kompress 同样会追加一条 CCR 提示,注明原文可以取回。

其余几个压缩器

SmartCrusherCodeAwareCompressorKompress 是分工最重的三个压缩器,但 ContentRouter 的映射表里还挂着另外几个针对特定内容形态的压缩器,同样在 headroom/transforms/ 下。它们都是各自领域的一套专门规则,简单认识一下:

  • LogCompressorlog_compressor.py):对付运行日志和构建输出。日志的特点是大量重复模板和刷屏的 INFO,它按行解析、识别日志级别和格式,把重复的堆栈、刷屏的常规行压掉,留下报错和关键状态。
  • DiffCompressordiff_compressor.py):对付 git diff 的输出。diff 里真正要紧的是改了哪些文件、增删了哪些关键行,它把无关的大段上下文折叠,保留变更的骨架。
  • SearchCompressorsearch_compressor.py):对付 grepripgrep 这类命令行搜索的纯文本结果,把命中按文件聚合、去掉冗余,而不是按 JSON 数组处理。
  • TextCrushertext_crusher.py):大段纯文本的快速确定性压缩。它是 Kompress 之外的另一条路,不走神经网络,而是用 BM25 相关性给句子打分、再去掉近似重复的片段,抽取式地保留原句(不改写),毫秒级就能跑完,适合请求路径上不能等 Kompress 那种大模型推理的场合。
  • TabularIngesttabular_ingest.py):CSV、TSV、markdown 表格这类文本本身没有对应的压缩器,直接走 Kompress 会破坏它的行列结构,所以它先把表格文本解析成 JSON 记录数组,再交给现成的 SmartCrusher 处理。
  • HTMLExtractorhtml_extractor.py):处理网页抓取回来的 HTML。严格说它做的是「抽取」而非「压缩」,把正文从导航、页脚、脚本这些结构性噪音里剥离出来,丢掉的是不相关的整块,而不是逐个 token。

小结

今天我们详细地学习了 Headroom 的三大压缩器:

  1. SmartCrusher:面向 JSON 数组的统计式压缩器,去重加头尾抽样,输出严格保持原 schema,计算已整个搬进 Rust,对高度重复的结构化数据能压到 90% 以上。
  2. CodeAwareCompressor:基于 tree-sitter 把代码解析成 AST,用一张数据表适配九种语言,保留 import、函数签名和类型注解,按语句压缩函数体,并用语法校验、过度压缩保护、异常兜底三道安全阀保证绝不输出坏代码。
  3. Kompress:作者训练的双头 ModernBERT 模型,逐 token 判断保留与丢弃,用必留正则守住数字、错误码、路径等关键信息,首次使用时后台下载、本地推理。
  4. 其余压缩器:LogCompressor 压日志、DiffCompressor 压 git diff、SearchCompressor 压命令行搜索结果、TextCrusher 用 BM25 快速压纯文本、TabularIngest 把表格文本桥接给 SmartCrusher、HTMLExtractor 抽取网页正文,各自守着一种特定的内容形态。

所有的压缩器共用同一套路由和 CCR 机制:由 ContentRouter 按内容类型分发到对应的一个,丢掉的原文一样进 CCR 缓存、可以取回,保证压缩不是有去无回。

关于 CCR 的完整机制,也就是原文怎么缓存、模型怎么用 headroom_retrieve 把它取回来,以及 Headroom 怎么在 Claude、Codex、Gemini 这些不同 agent 之间共享一份压缩过的记忆,我们下一篇继续。

参考