Fork me on GitHub

2026年9月

大模型训练介绍:一个模型是怎么炼成的

2024 年 12 月,DeepSeek 开源 DeepSeek-V3 模型,这是一个 671B 参数的混合专家(Mixture-of-Experts,简称 MoE)模型,每次前向只激活 37B 参数。放出的技术报告里有一组数字被反复引用:它在 2048 块 H800 GPU 上用 14.8T token 做预训练,完整训练一共花了 278.8 万 GPU 小时。报告按每 GPU 小时 2 美元的租金折算,总成本约 557.6 万美元。报告同时注明,这个数只算了正式训练那一轮的算力,此前的研究、消融实验和基础设施建设都不在里面。

作为对照,GPT-4 这个级别的模型,外界估算的训练成本在数千万到上亿美元,OpenAI 的 Sam Altman 公开表示过 GPT-4 的训练花费超过 1 亿美元,斯坦福的 AI Index 报告也收录了这类估算。而在另一头,2025 年 11 月微博开源的 1.5B 小模型 VibeThinker 宣称整个后训练只花了约 7800 美元,在 AIME(美国数学邀请赛,数学推理能力的常用评测)榜单上超过了 DeepSeek-R1。当然,7800 美元同样只算了后训练,它的基座模型是阿里预训练好的 Qwen2.5-Math-1.5B。

同样是造一个模型,成本可以差出好几个数量级。这些数字谈的都是同一件事:训练(Training),它和我们在上一个系列《大模型推理》里反复讲的推理(Inference)正好是一体两面:推理时权重冻结不动,请求进来做一次前向计算就出结果;训练则是反过来,用海量数据一遍又一遍地算损失、调权重,直到模型学会我们想要的本事。

这个系列,我们就把训练从头到尾走一遍。今天的目标是建立整体图景:一个模型从原始互联网数据到能和人对话,中间到底要走过哪些环节。
training-forge-concept.jpg

训练和推理的区别

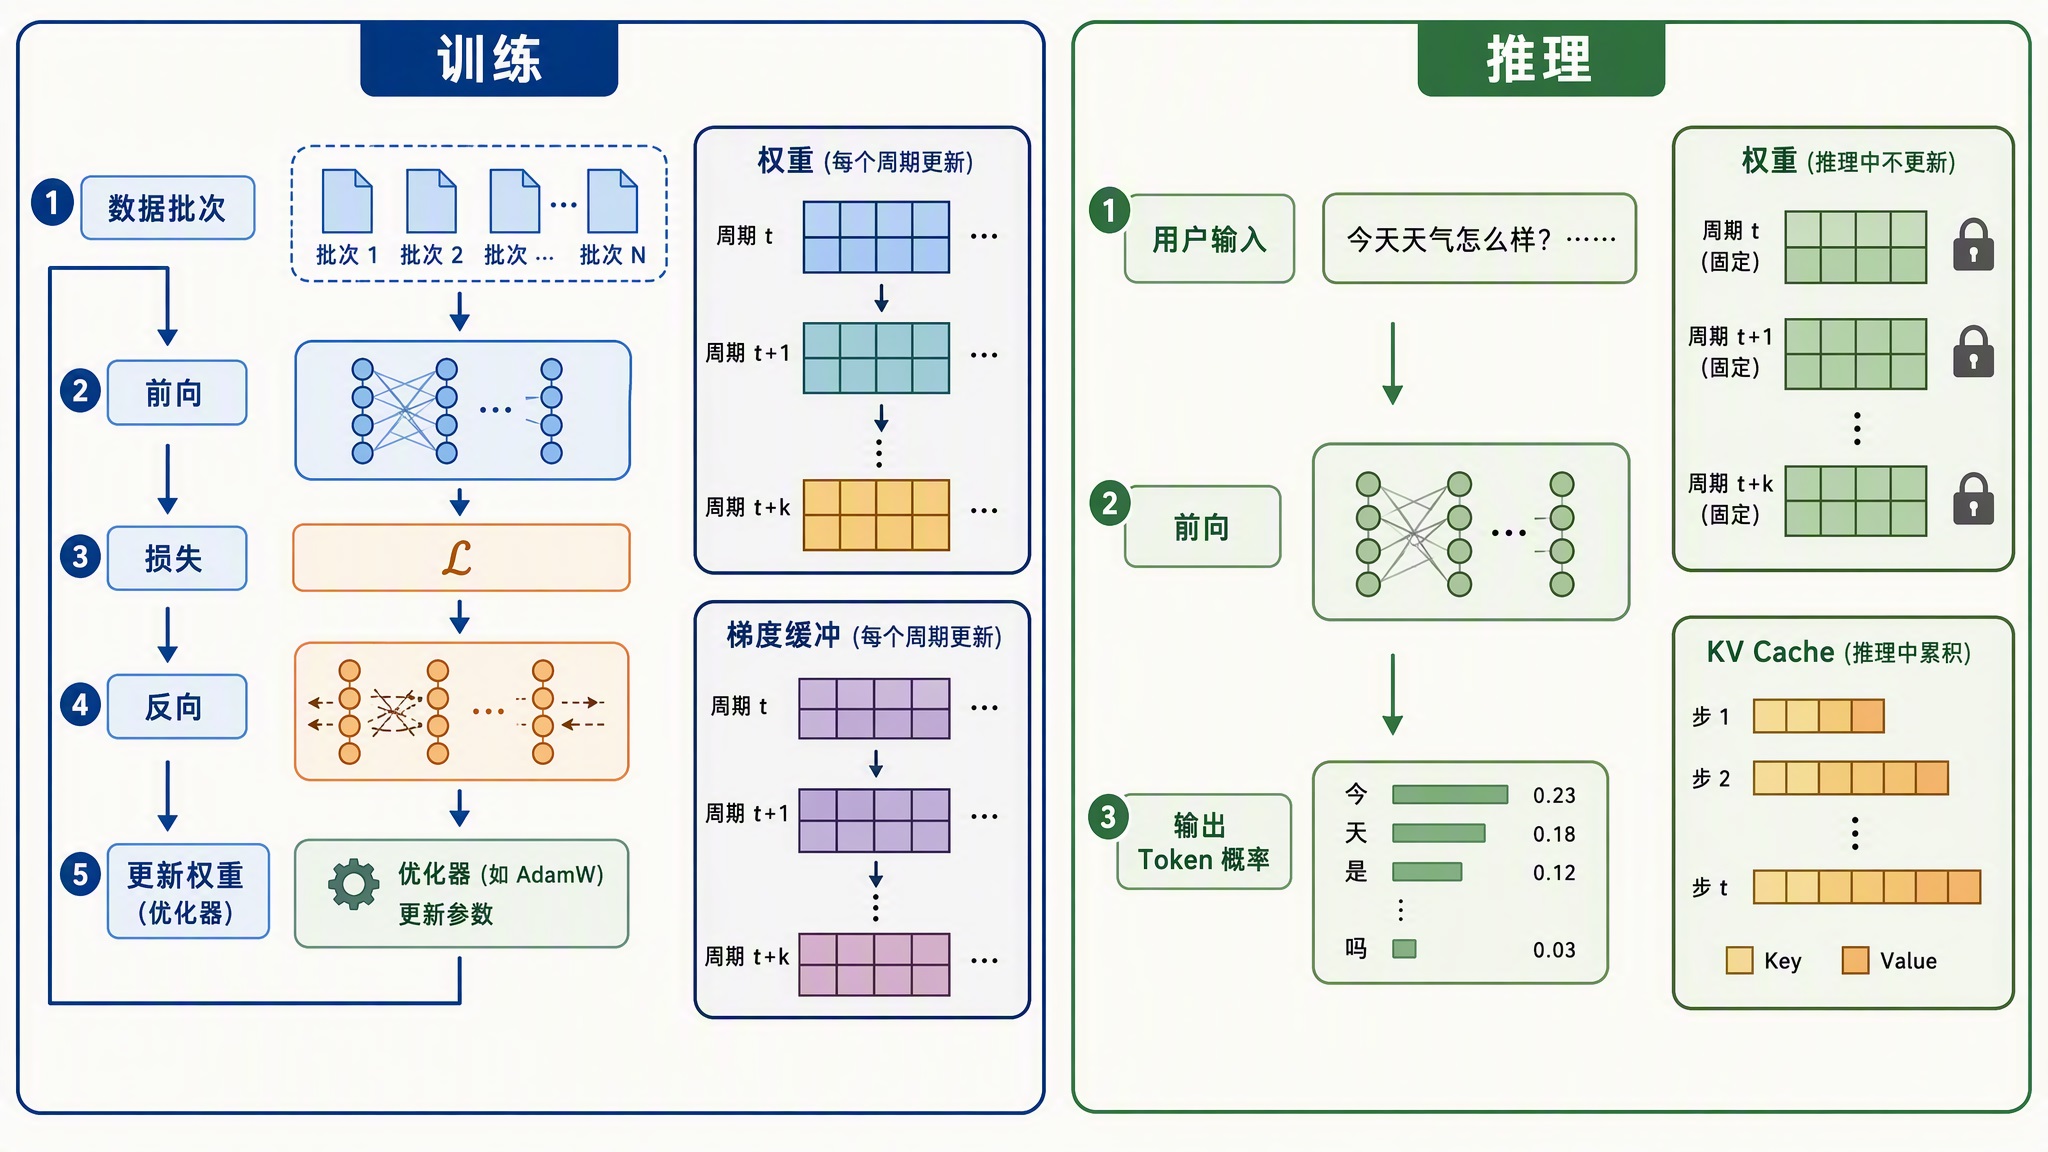
在推理系列的首篇,我们曾提过:训练是造模型,推理是用模型。今天站在训练的角度,把这两个概念再总结一次。

推理是上个系列的主角。模型已经训练好,权重是固定的常量,给它一段输入,它做一次前向传播,吐出下一个 token 的概率分布。无论跑多少次请求,权重一个字节都不会变。推理关心的是怎么算得快、算得省,KV Cache、连续批处理这些优化,都是围绕这个目标。

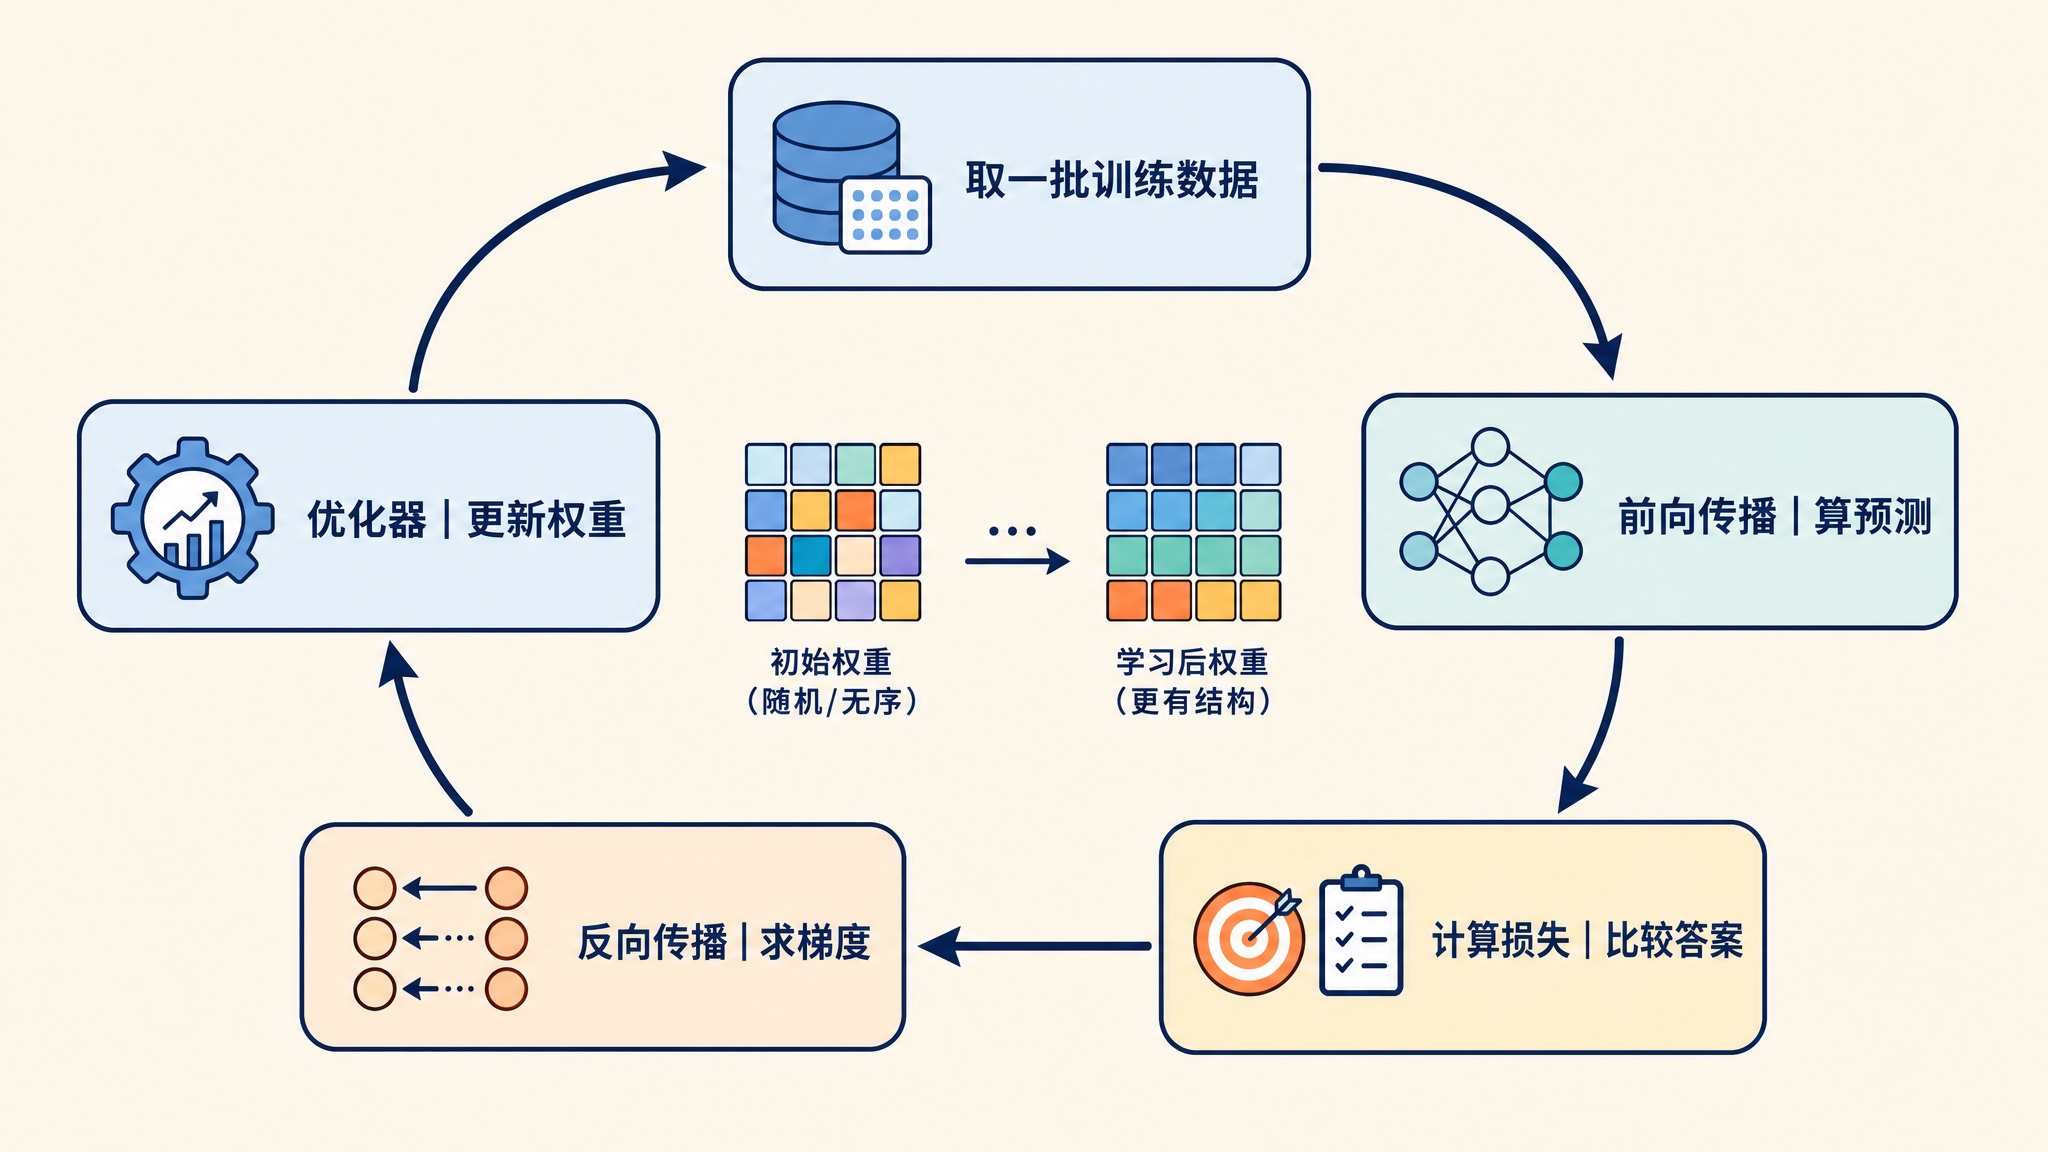
训练则是制造这些权重的过程。一开始权重是随机初始化的,模型基本只会输出乱码。训练的做法是反复执行一个循环:拿一批数据算前向,比较模型的预测和标准答案的差距,根据差距调整权重,让下一次预测更准。跑上几万亿 token 之后,权重里就存下了语言规律和世界知识。
training-vs-inference.jpg

这个循环只有四步,如下图所示:

training-step-loop.jpg

这里有几个术语解释一下:

  • 前向传播(Forward Pass):数据从输入层流到输出层,算出模型当前的预测结果
  • 损失(Loss):一个数值,衡量预测和标准答案差多远,差得越远损失越大
  • 反向传播(Backpropagation):从损失出发,算出每个权重对损失的梯度(Gradient),也就是每个权重该往哪个方向调
  • 优化器(Optimizer):拿着梯度真正更新权重的算法,常见的有 SGD(随机梯度下降)、Adam,以及后面会提到的 Muon

如果用 PyTorch 写出来,这个循环就是这么几行:

# model 是模型,dataloader 提供一批批数据,optimizer 是优化器
for batch in dataloader:
    # 1. 前向传播:用当前权重算预测
    logits = model(batch["input_ids"])

    # 2. 算损失:预测和真实下一个 token 的差距
    loss = loss_fn(logits, batch["labels"])

    # 3. 反向传播:求每个权重对损失的梯度
    loss.backward()

    # 4. 优化器更新权重,并清空梯度准备下一轮
    optimizer.step()
    optimizer.zero_grad()

可以看到,训练在代码层面朴素得很,核心的四步循环和教科书上的写法没什么两样。真正的复杂度不在循环本身,而在规模:DeepSeek-V3 这样的模型,这个循环要在 2048 块 GPU 上连续跑将近两个月,中间任何一环出问题都会浪费大量的算力。怎么把数据备好、怎么把计算摊到几千块卡上、怎么让损失稳稳地降下去,这些才是大模型训练要解决的真实问题,也是这个系列要逐一展开的内容。

将训练和推理在工程上做个对比,如下表所示:

对比项训练推理
权重每步都在更新固定不变
计算前向 + 反向传播只有前向
数据海量训练语料用户的单次输入
并行关注点几千块卡协同跑一个任务单请求低延迟、服务高吞吐
典型问题显存放不下梯度、损失不稳定KV Cache 太大、排队延迟高

一次训练的完整旅程

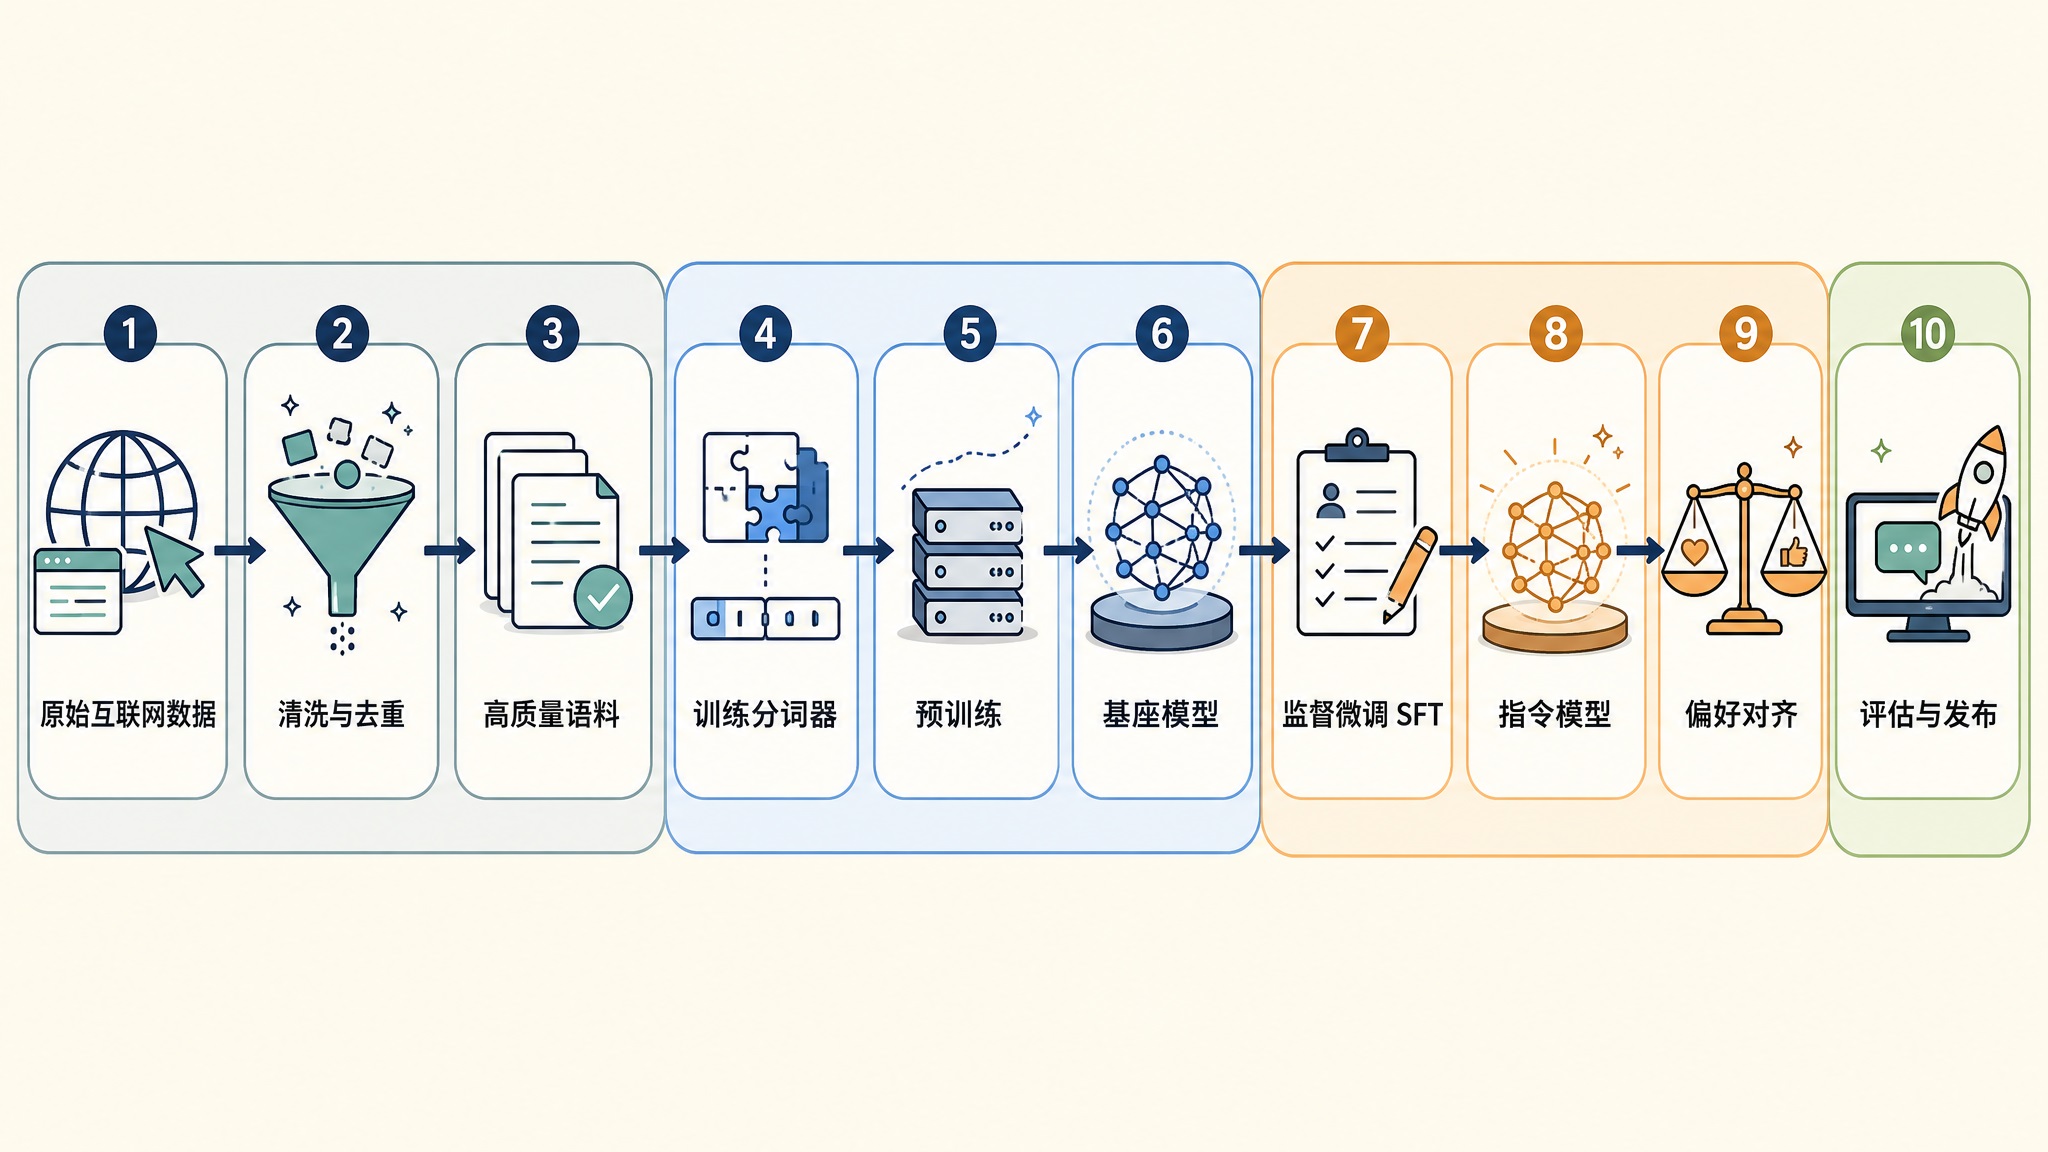
从原始数据到能对话的模型,完整的旅程如下图所示。这张图是整个系列的地图,后续文章基本都会落到这张图的某一个格子里:
full-training-journey.jpg

我们顺着地图看看每个环节在做什么:

  1. 清洗与去重:互联网原始数据里充斥着广告、乱码、模板文本和重复内容,直接用会把模型教坏。这一步要做过滤、去重、隐私脱敏,产出高质量语料。DeepSeek-V3 的 14.8T token 就是从大得多的原始池子里筛出来的
  2. 训练分词器:分词器(Tokenizer)负责把文本切成 token,也就是模型能处理的最小单元,它的切法直接影响模型的效率和效果,通常在正式训练前用语料单独训练一个
  3. 预训练:在海量语料上做无监督学习,产出基座模型(Base Model)。这是整个旅程里算力消耗最大的阶段,前面说的 278.8 万 GPU 小时几乎都花在这里
  4. 监督微调:用人工编写的问答数据继续训练,让基座模型学会听指令,产出指令模型
  5. 偏好对齐:用人类偏好数据进一步调整,让模型的回答更符合人的喜好,推理类模型还会在这一阶段用强化学习专门练推理
  6. 评估与发布:在各种基准测试上验证模型的能力和安全性,达标后发布

接下来,我们顺着地图把中间三个训练阶段分别过一遍。

预训练:学会语言和知识

预训练(Pre-training)的任务很明确:让模型学会语言本身和语言里承载的知识。

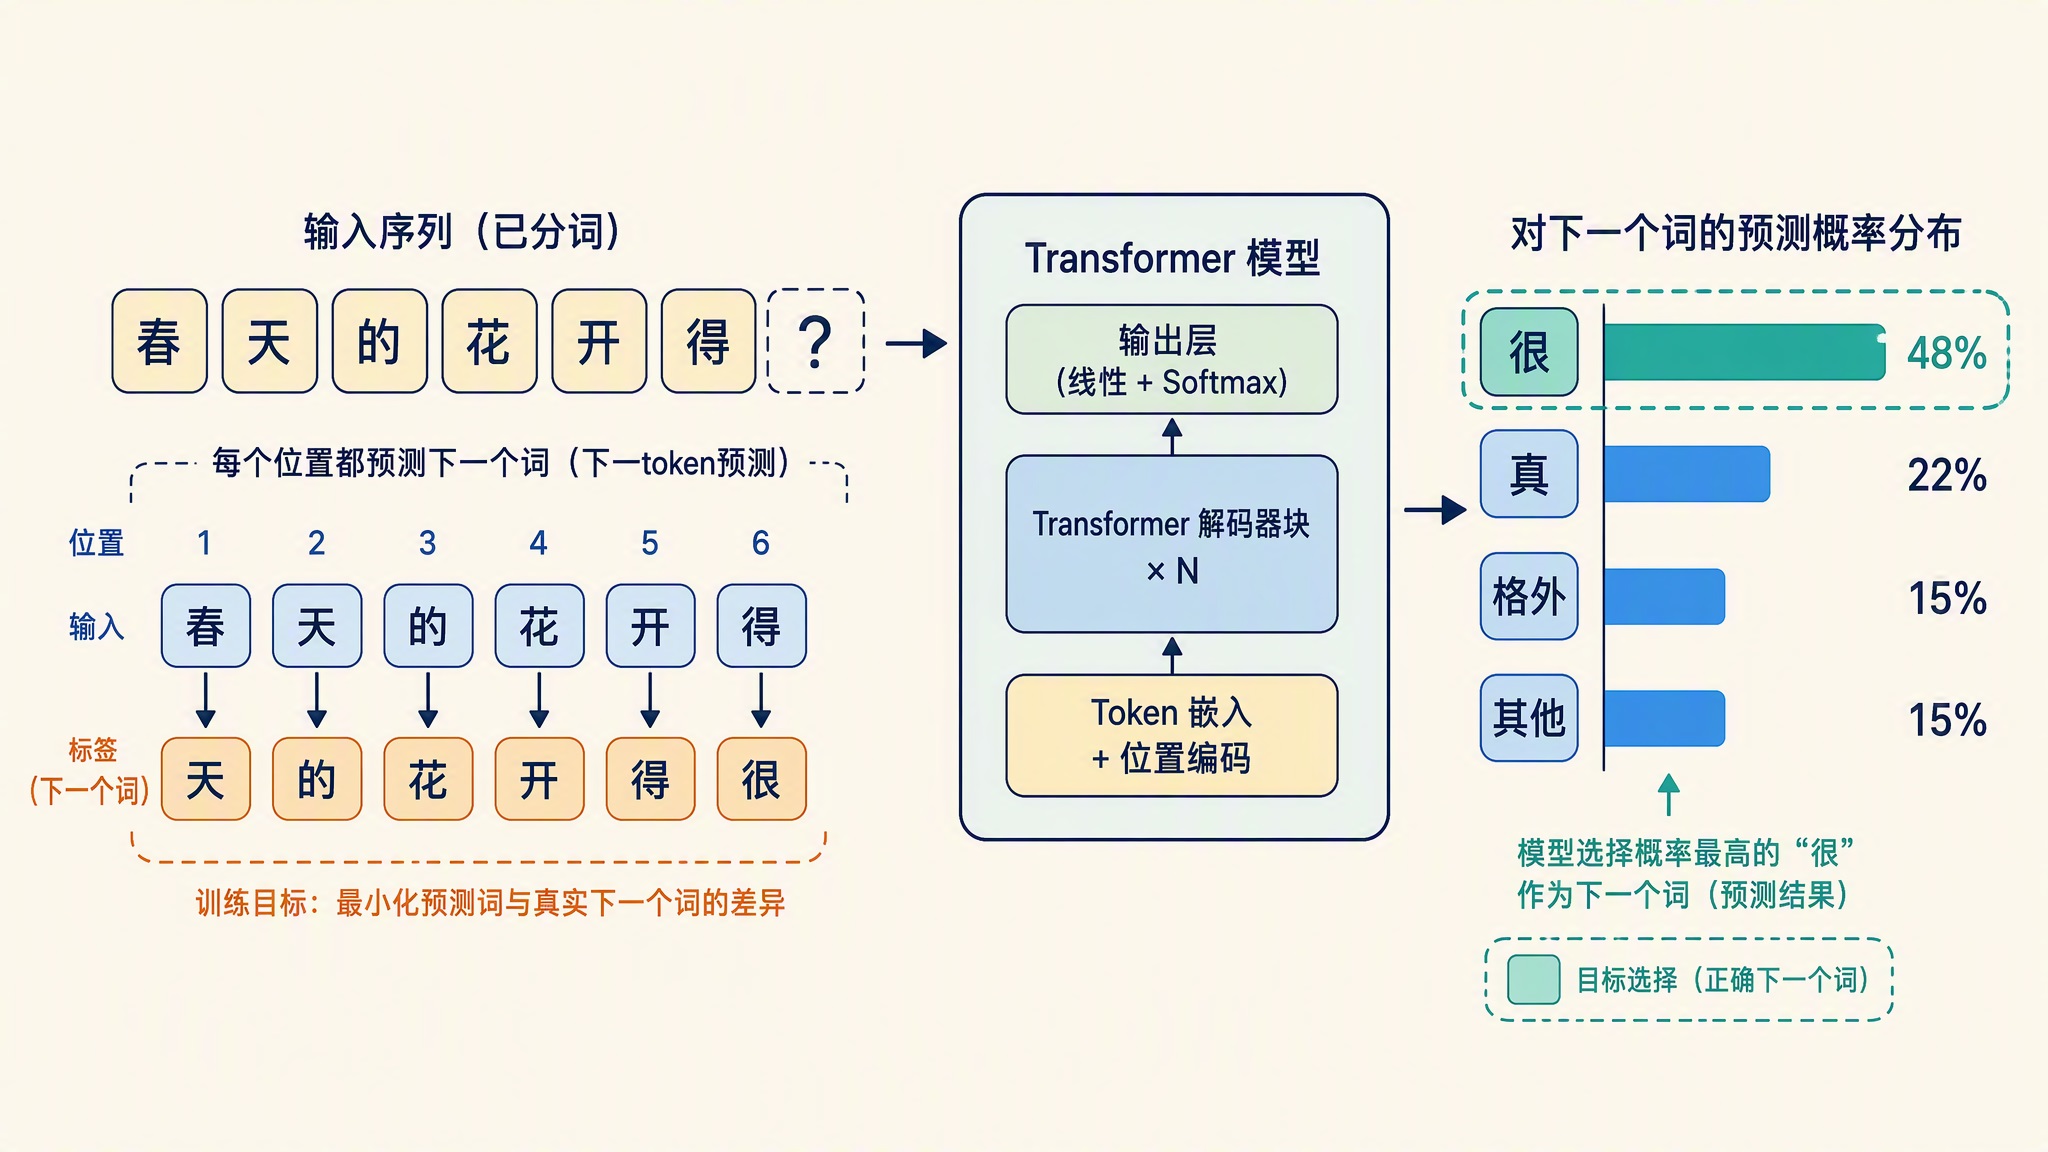
它的训练方式简单得出奇,就是下一个 token 预测(Next Token Prediction):给模型一段文本,让它预测下一个 token 是什么,猜错了就按上面的循环调权重。一段文本里每个位置都是一道预测题,所以 14.8T token 就是 14.8 万亿道练习题。题目做得足够多之后,模型为了猜得准,被迫学会了语法、事实、推理模式,甚至是编写代码。

但预训练出来的基座模型有个明显的特点:它只会续写,不会对话。你问它一个问题,它可能把问题当作文本接着往下编,或者模仿出更多类似的问题,而不是给出回答。这是正常的,因为互联网文本里本来就没有统一的问答格式,续写就是它学到的全部本事。
next-token-prediction.jpg

预训练阶段工程上的挑战主要是规模和稳定性。模型越大、数据越多,训练越容易出岔子:损失突然暴涨(俗称 loss spike)、梯度爆炸、几千块卡的通信协调,每一个都是专门的学问。DeepSeek-V3 的报告里专门提到,那一轮训练全程没有出现不可恢复的损失暴涨,也没有回滚重训。这在万亿 token 级别的训练里很少见。这背后除了工程功底,还有训练方法上的选择,比如他们首次在超大规模上验证了 FP8(8 位浮点数)混合精度训练,用更低的数值精度换来了可观的算力节省,557.6 万美元这个数字才能做到这么低。

优化器的选择同样是稳定性的关键。2025 年 7 月,月之暗面发布的 Kimi K2 是个很好的例子:这是一个 1.04 万亿参数的 MoE 模型,预训练用了 15.5T token,首次在万亿规模上用上了自研的 MuonClip 优化器。Muon 是 2024 年提出的一种新优化器,比传统的 Adam 更省 token。但 Muon 直接放大到万亿规模会出现注意力分数(logits)爆炸的问题,MuonClip 通过对注意力里的 Q、K 两个权重矩阵做裁剪解决了这个问题。最终 K2 的整个预训练没有出过一次 loss spike。优化器这个看似不起眼的组件,在大规模训练里是决定成败的角色。

大规模预训练的分布式工程,开源世界有成熟的参考实现。NVIDIA 的 Megatron-LM 就是专门研究如何高效训练超大 Transformer 的项目,张量并行、流水线并行这些核心技术都是从这类项目里沉淀出来的。

监督微调:学会听指令

监督微调(Supervised Fine-Tuning,简称 SFT)的目标同样很明确:让已经满腹经纶的基座模型学会听指令、按格式回答问题。

做法是在预训练好的权重基础上继续训练,只是数据换了:不再是随手抓的互联网文本,而是人工或机器精心构造的指令数据,每条都是一问一答的形式。模型在这些样本上继续练下一个 token 预测,逐渐就学会了遇到提问要给出回答,遇到让写代码就写代码,遇到让翻译就翻译。它学到的主要不是新知识,而是一种新的行为模式。

SFT 的数据量相比预训练小得多。预训练动辄十几万亿 token,SFT 通常只要几十万到几百万条精心准备的样本,折算成 token 连预训练的零头都不到。很多公开模型的报告都显示,SFT 阶段质量远比数量重要,一小批精心编写的样本往往比一大池粗加工的样本效果好。

SFT 也是普通开发者最容易上手的训练阶段。一台带卡的机器,加上 Hugging Face 生态的 TRL 库,十几行代码就能跑起来:

from trl import SFTConfig, SFTTrainer

trainer = SFTTrainer(
    model="Qwen/Qwen3-0.6B",           # 从预训练好的模型出发
    args=SFTConfig(output_dir="./sft-out", max_length=2048),
    train_dataset=instruction_dataset, # 一问一答格式的指令数据
)
trainer.train()

TRL 是 Hugging Face 维护的专门做模型后训练的库,SFT、奖励模型训练、DPO,以及 DeepSeek-R1 带火的强化学习算法 GRPO(Group Relative Policy Optimization,组相对策略优化),都有现成的 Trainer。后续文章里我们动手做微调和对齐,基本都会用它。

偏好对齐:说人爱听的话

SFT 之后模型已经会听指令了,但还有两个问题没解决。一是同一个问题往往有很多种答法,有的答得准、有的啰嗦、有的甚至有安全风险,SFT 管不了这么细的偏好。二是数学、代码这类需要多步推理的任务,光靠模仿标准答案练不出真正的推理能力。这就是第三阶段偏好对齐(Preference Alignment)要解决的问题。

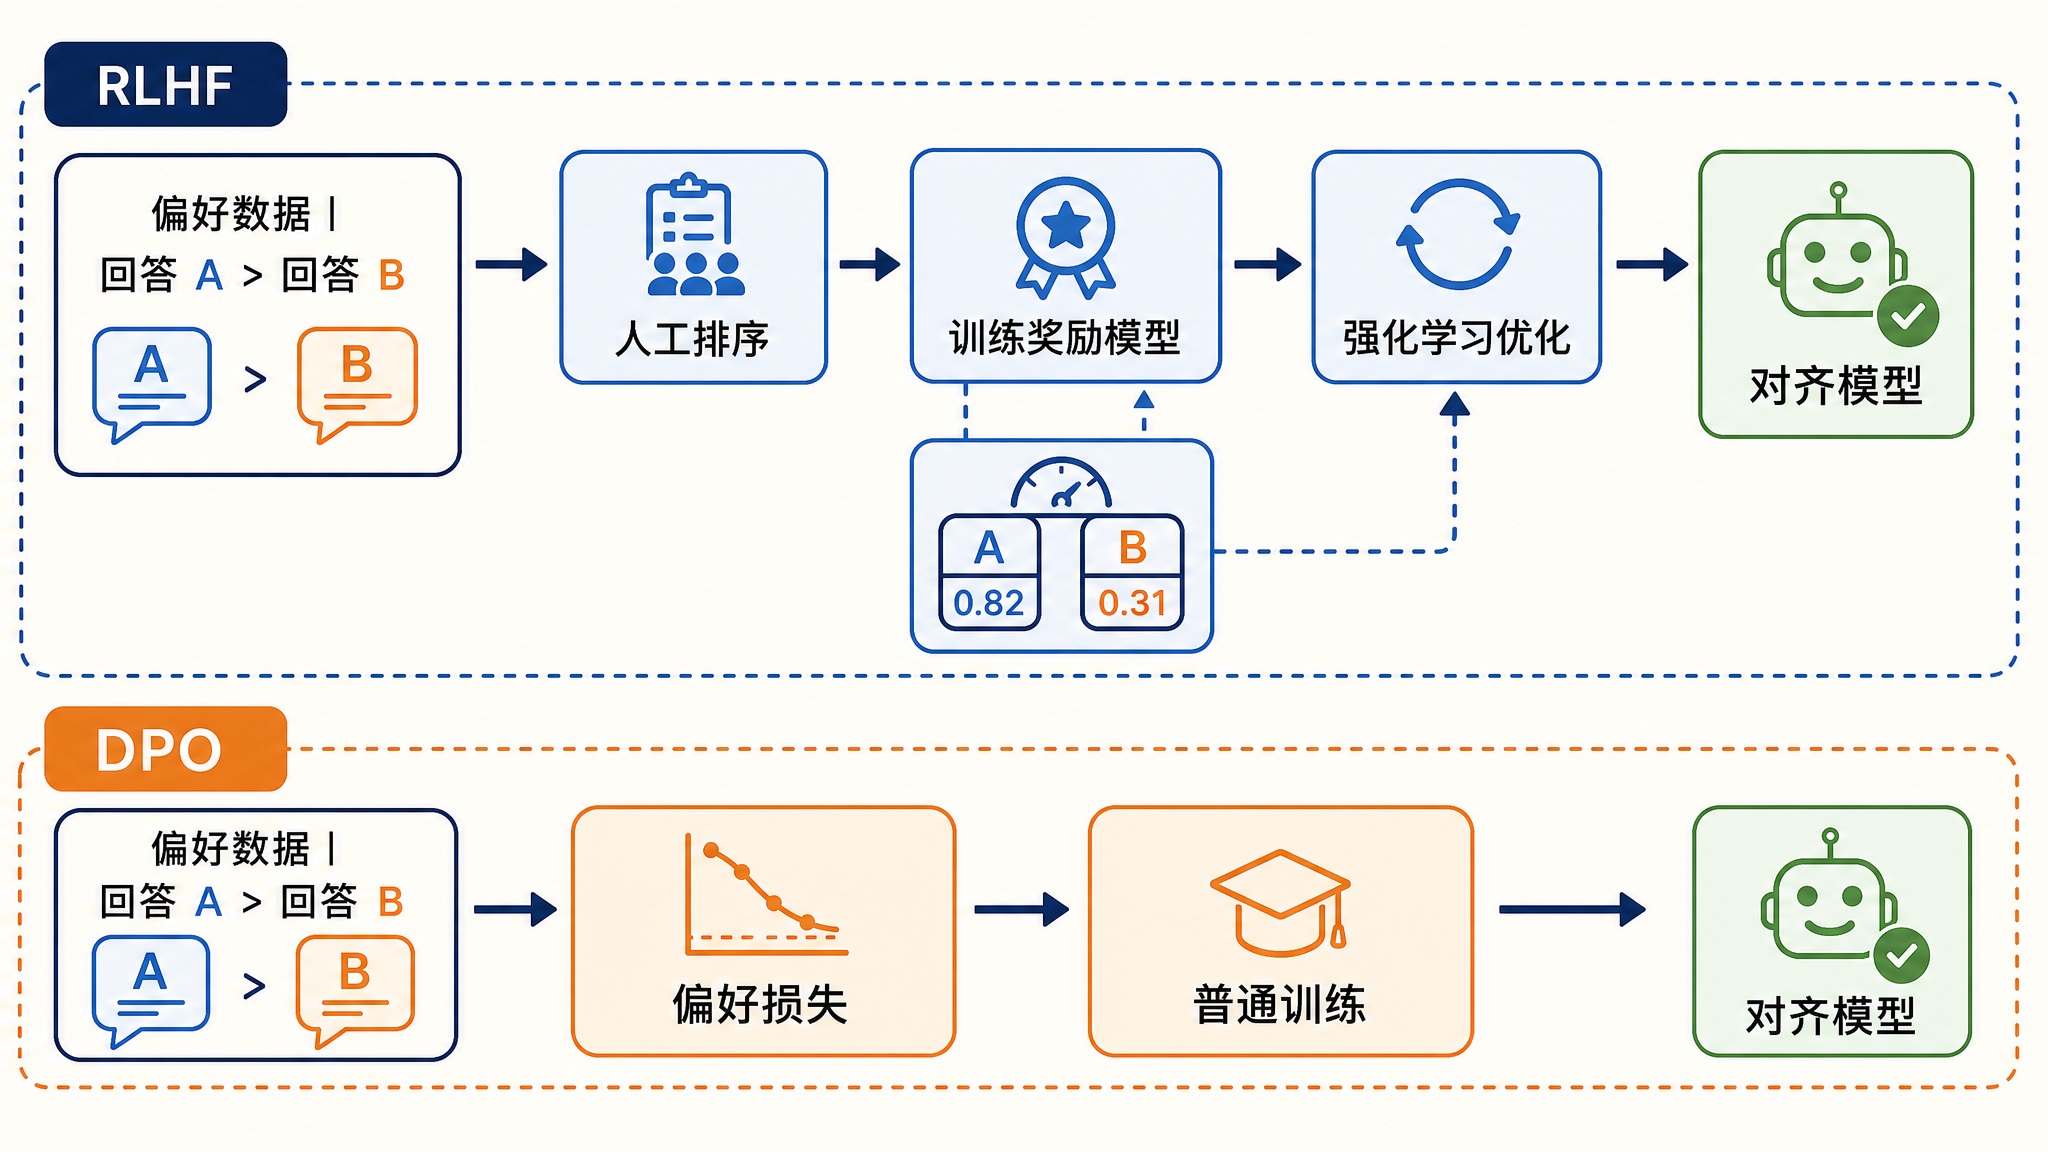
最经典的方案是基于人类反馈的强化学习(Reinforcement Learning from Human Feedback,简称 RLHF),OpenAI 在 2022 年的 InstructGPT 论文里完整提出了这套流程,后来 ChatGPT 用的就是它。RLHF 分两步:先让人类标注员对模型生成的多条回答排序,用这些排序数据训练一个奖励模型(Reward Model),专门给回答打分。再用这个奖励模型当裁判,通过强化学习(Reinforcement Learning,简称 RL)算法调整对话模型,让它生成的回答得分越来越高。

RLHF 效果好,但流程重:要额外训练和维护一个奖励模型,强化学习本身也不好调。2023 年斯坦福提出的直接偏好优化(Direct Preference Optimization,简称 DPO)给出了更轻的办法:不需要奖励模型,也不需要强化学习,直接用排序好的偏好数据构造一个损失函数,一次普通训练就能达到对齐效果。DPO 把 RLHF 的两步并成了一步,实现简单得多,现在已经是开源模型做对齐的常用选择。

两种方案放在一起对比,差别一目了然:
rlhf-vs-dpo.jpg

2025 年以来,对齐阶段还多了一个新的用途:练推理。数学和代码这类任务有个特点,答案对不对可以自动验证,不需要人来打分,验证结果本身就是现成的奖励信号。DeepSeek-R1 就是靠大规模强化学习在这类可验证任务上练出了长链条的推理能力。开头提到的 VibeThinker 也是这条路,它的后训练分两步:SFT 阶段专门追求答案多样性,RL 阶段再用自研的算法放大正确率高的解题路径。最终在 1.5B 的小身板上,它练出了超过 DeepSeek-R1 的数学成绩。这个阶段做得好,投入可以非常小,7800 美元就是这么来的。

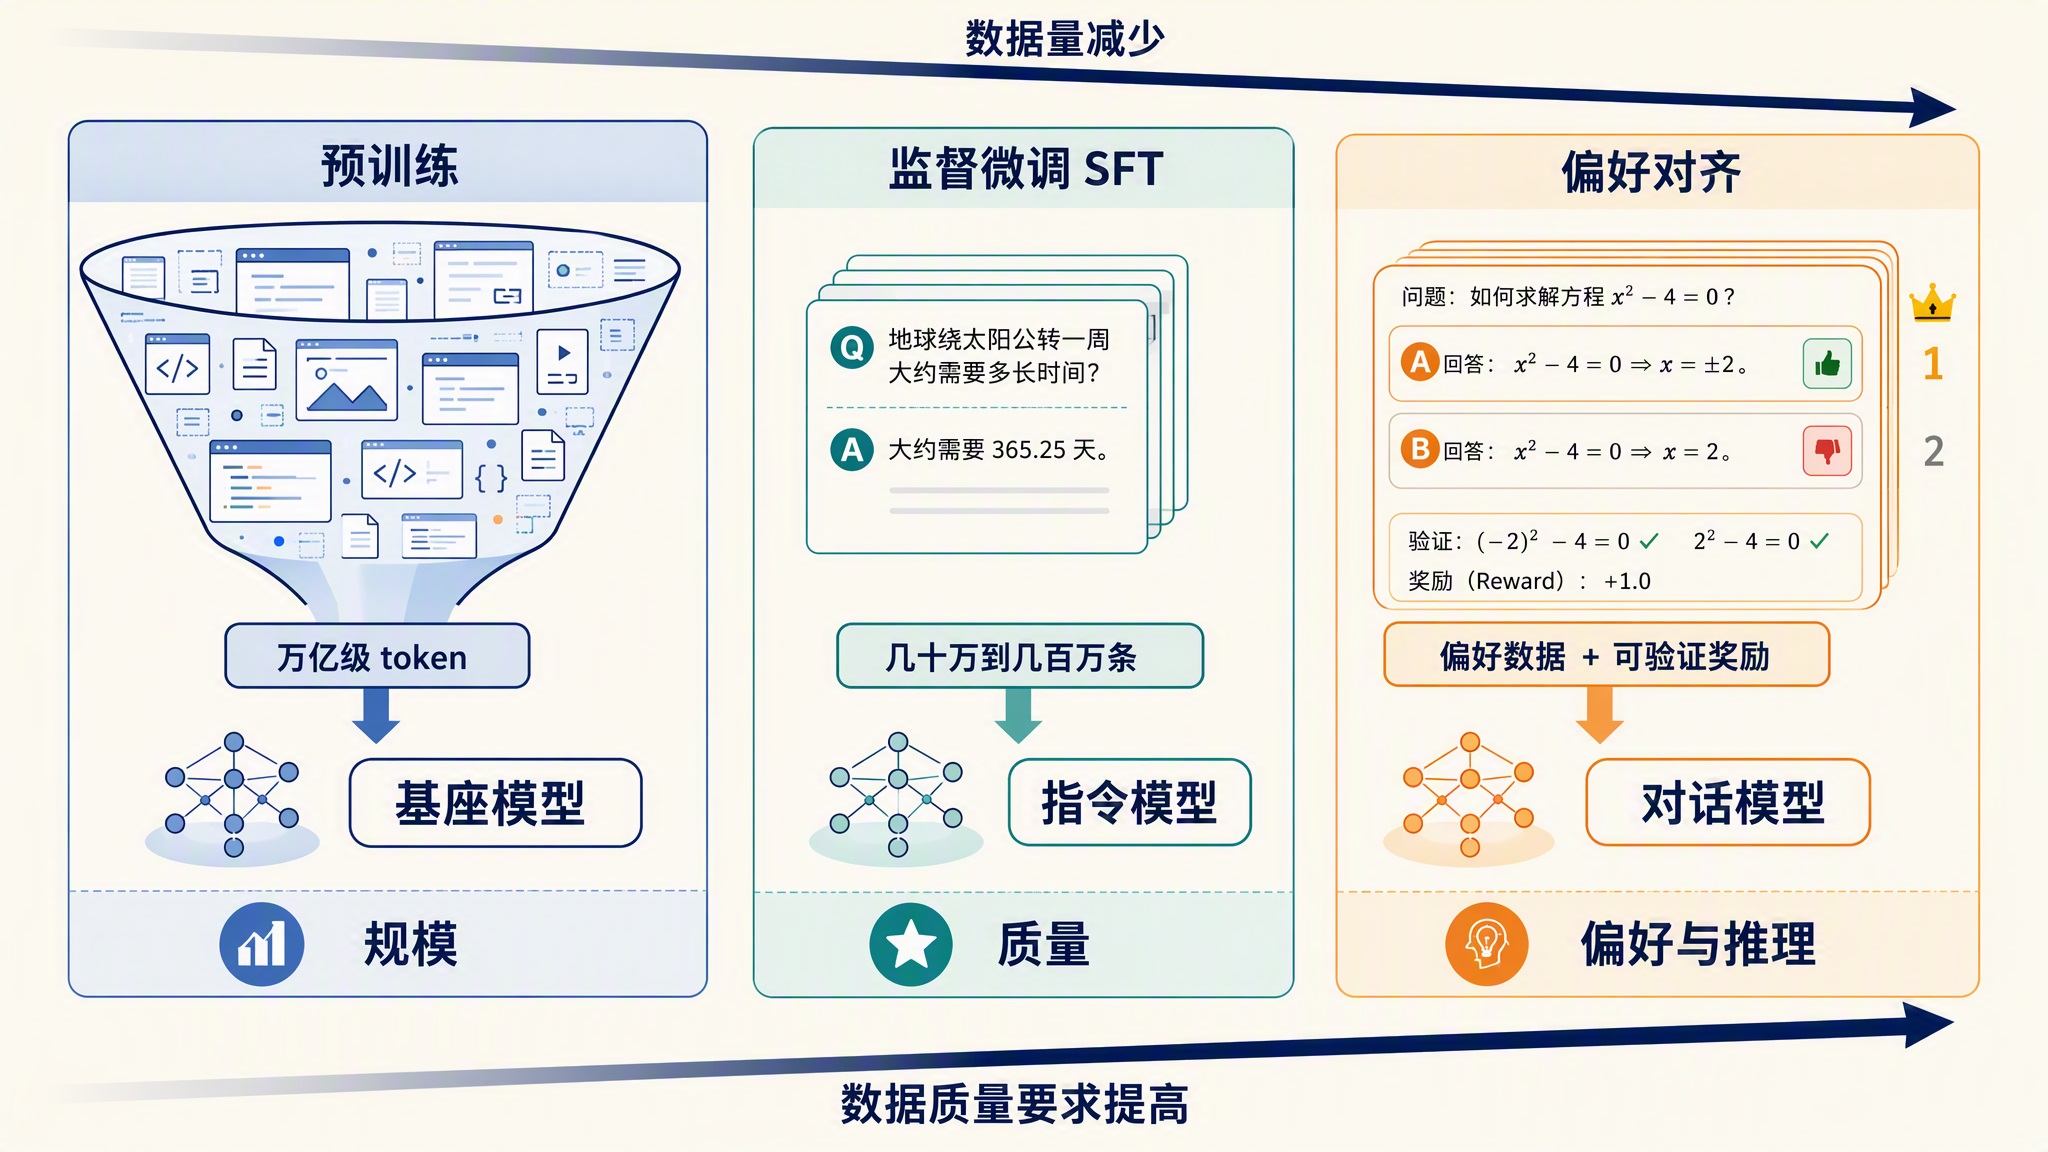
把三个阶段放在一起总结下:

阶段目标数据典型规模产出
预训练学会语言和知识互联网语料万亿到十几万亿 token基座模型
监督微调学会听指令人工编写的问答几十万到几百万条样本指令模型
偏好对齐回答更符合人类喜好、练推理偏好排序、可验证奖励几万到几百万条偏好数据对话模型

training-stage-data-scale.jpg

可以看到一个明显的趋势:越往后,数据量越小,但对数据质量的要求越高,和人的偏好的关系也越直接。预训练拼的是算力和数据规模,后训练拼的是数据质量和算法设计。这也是为什么小团队在后训练阶段有机会做出亮眼的工作,VibeThinker 就是一个例子,而预训练的算力门槛目前仍然很高。

学习路线

到这里,训练的完整图景就齐了。这个系列我们会沿着上面那张地图一站一站往下走,每站单独成篇:

  • 先是数据这一站:原始互联网数据怎么一步步清洗成高质量语料,分词器怎么训练
  • 然后是预训练:模型结构、分布式训练、大规模训练的稳定性问题
  • 再往后是后训练:SFT、RLHF、DPO、推理模型的强化学习
  • 每个阶段都会有配套的评估方法

风格上延续上一个推理系列的做法:从基础概念讲起,不预设读者有训练方面的背景;概念讲透之后尽量动手验证,动手环节主要用 PyTorch、Hugging Face 的 transformers 和 TRL 这些主流工具,优先挑单机一张卡甚至纯 CPU 就能跟着跑的内容。预训练这种个人跑不起来的阶段,也会争取用小模型把同样的机制缩小演示出来。

小结

今天我们建立了大模型训练的整体图景,要点回顾一下:

  1. 训练与推理的区别:推理是权重不变做前向,训练是拿数据反复算损失、调权重。训练循环只有四步,复杂度全在规模上
  2. 完整旅程:原始互联网数据 → 清洗去重 → 训练分词器 → 预训练 → 监督微调 → 偏好对齐 → 评估发布。这也是整个系列的学习路线
  3. 三个阶段的分工:预训练让模型学会语言和知识,产出只会续写的基座模型;SFT 让模型学会听指令;偏好对齐让模型的回答更符合人的喜好,推理能力也在这一阶段通过强化学习练出来

细心的读者会发现,旅程图上前两步都发生在模型训练正式开始之前:数据清洗和分词器训练。别小看这两步,数据质量直接决定模型上限,业内常说的垃圾进垃圾出(Garbage In, Garbage Out)就是这个道理。那么互联网上的原始数据是怎么一步步变成高质量语料的,去重、过滤、配比各有哪些讲究?下一篇就从数据清洗这一步开始。

参考


学习大模型推理的加速技术:量化、投机采样与 PD 分离

在上一篇中,我们学习了推理的显存优化:PagedAttention 把 KV Cache 切成固定大小的块按需分配,前缀缓存让相同前缀的请求复用已算好的 KV 块。再往前看,KV Cache 本身是拿显存换时间,连续批处理是让 GPU 不空转。这些优化有一个共同的特点:它们不改模型、不改输出,只是把现有的资源省着用,把能复用的计算复用起来。

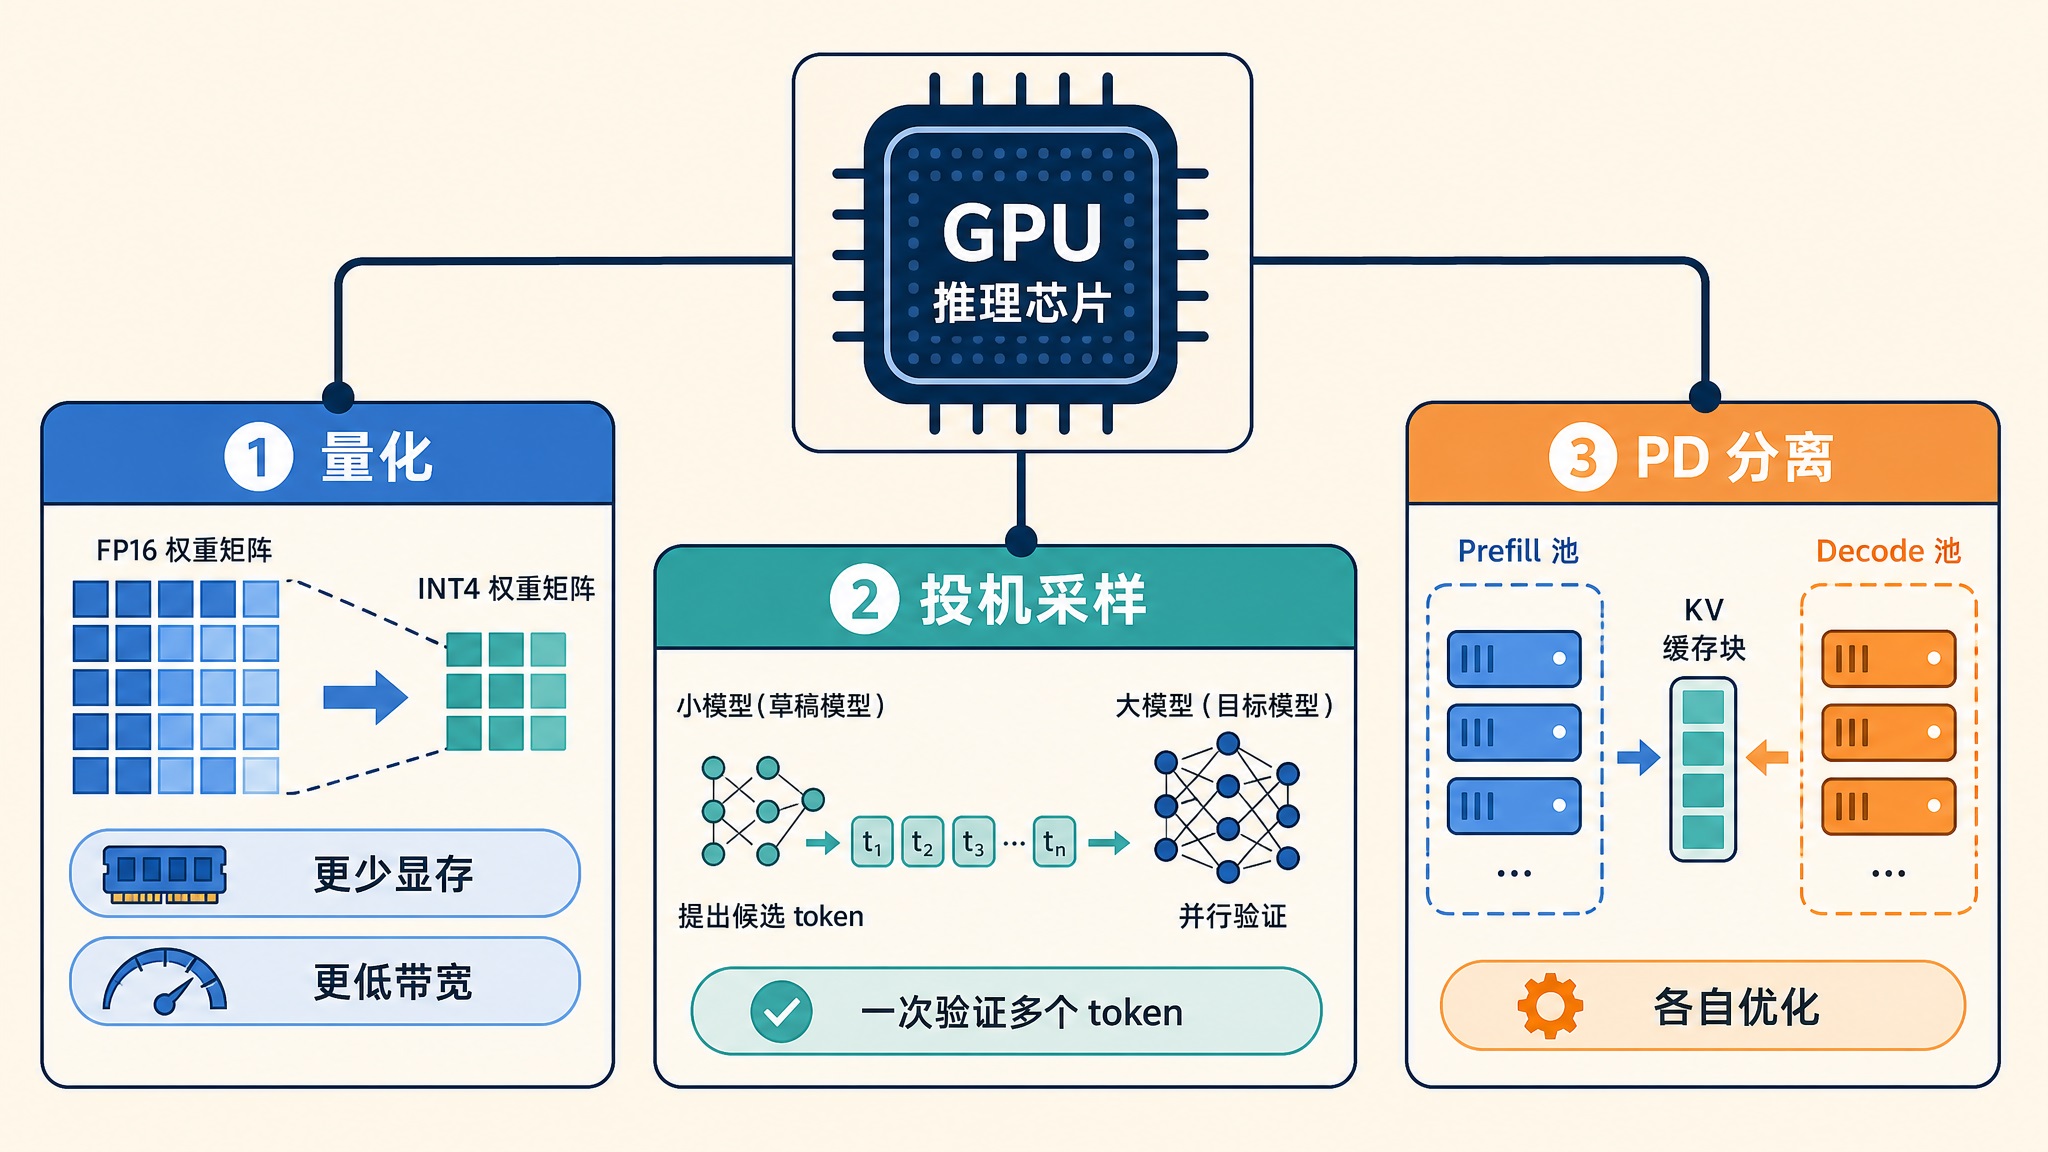
今天我们要讲的三个技术更激进一些。它们会直接改动模型的存储精度、改动生成 token 的方式、改动整个集群的部署形态,目标只有一个:让推理跑得更快。这三类技术分别是量化(Quantization)、投机采样(Speculative Decoding) 和 PD 分离(Prefill/Decode Disaggregation),下面我们逐个来看。

inference-acceleration-overview.jpg

量化:把 FP16 权重压到 4bit

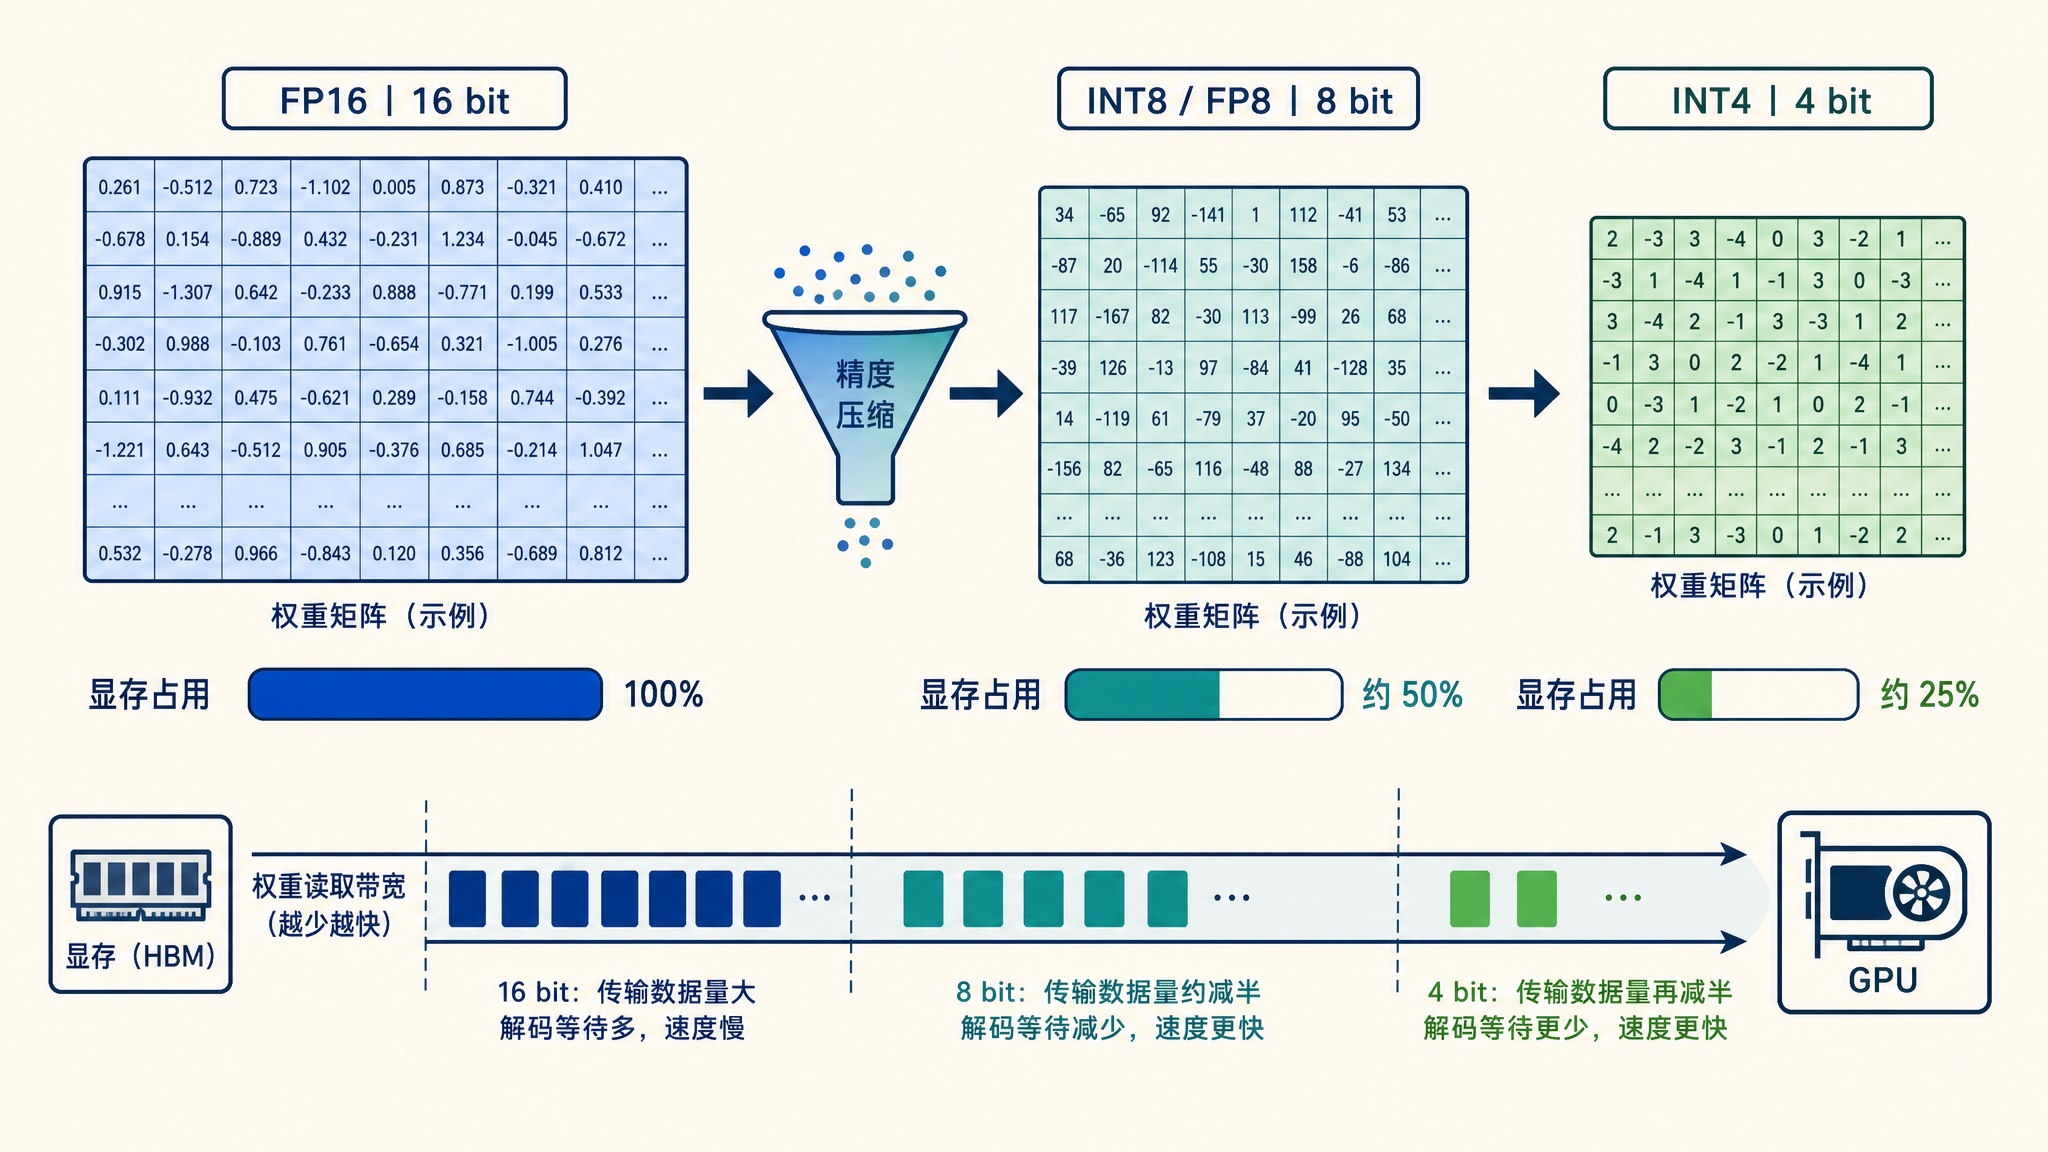
量化(Quantization) 是指把模型参数从高精度数值(如 FP16,每个参数占 2 字节)转换成低精度数值(如 INT8、INT4)存储和计算的技术。一个 7B 模型用 FP16 存要 14 GB 显存,压到 4bit 后只需要 4 GB 左右,原本单卡放不下的模型,现在一张卡就能跑。

量化带来的收益是双重的。一是显存占用直接按位宽比例下降;二是第六篇讲过,decode 阶段是显存带宽瓶颈,每生成一个 token 都要把全部权重从显存读一遍,权重体积小了,读取就快,decode 速度也就跟着上去了。

从 W4A16 说起

量化方案常用 W 和 A 两个数字命名。W 是权重(Weight)的位宽,A 是激活(Activation,即前向计算中每一层的中间结果)的位宽。W4A16 表示权重压成 4bit、激活保持 16bit,是目前最常见的配置。

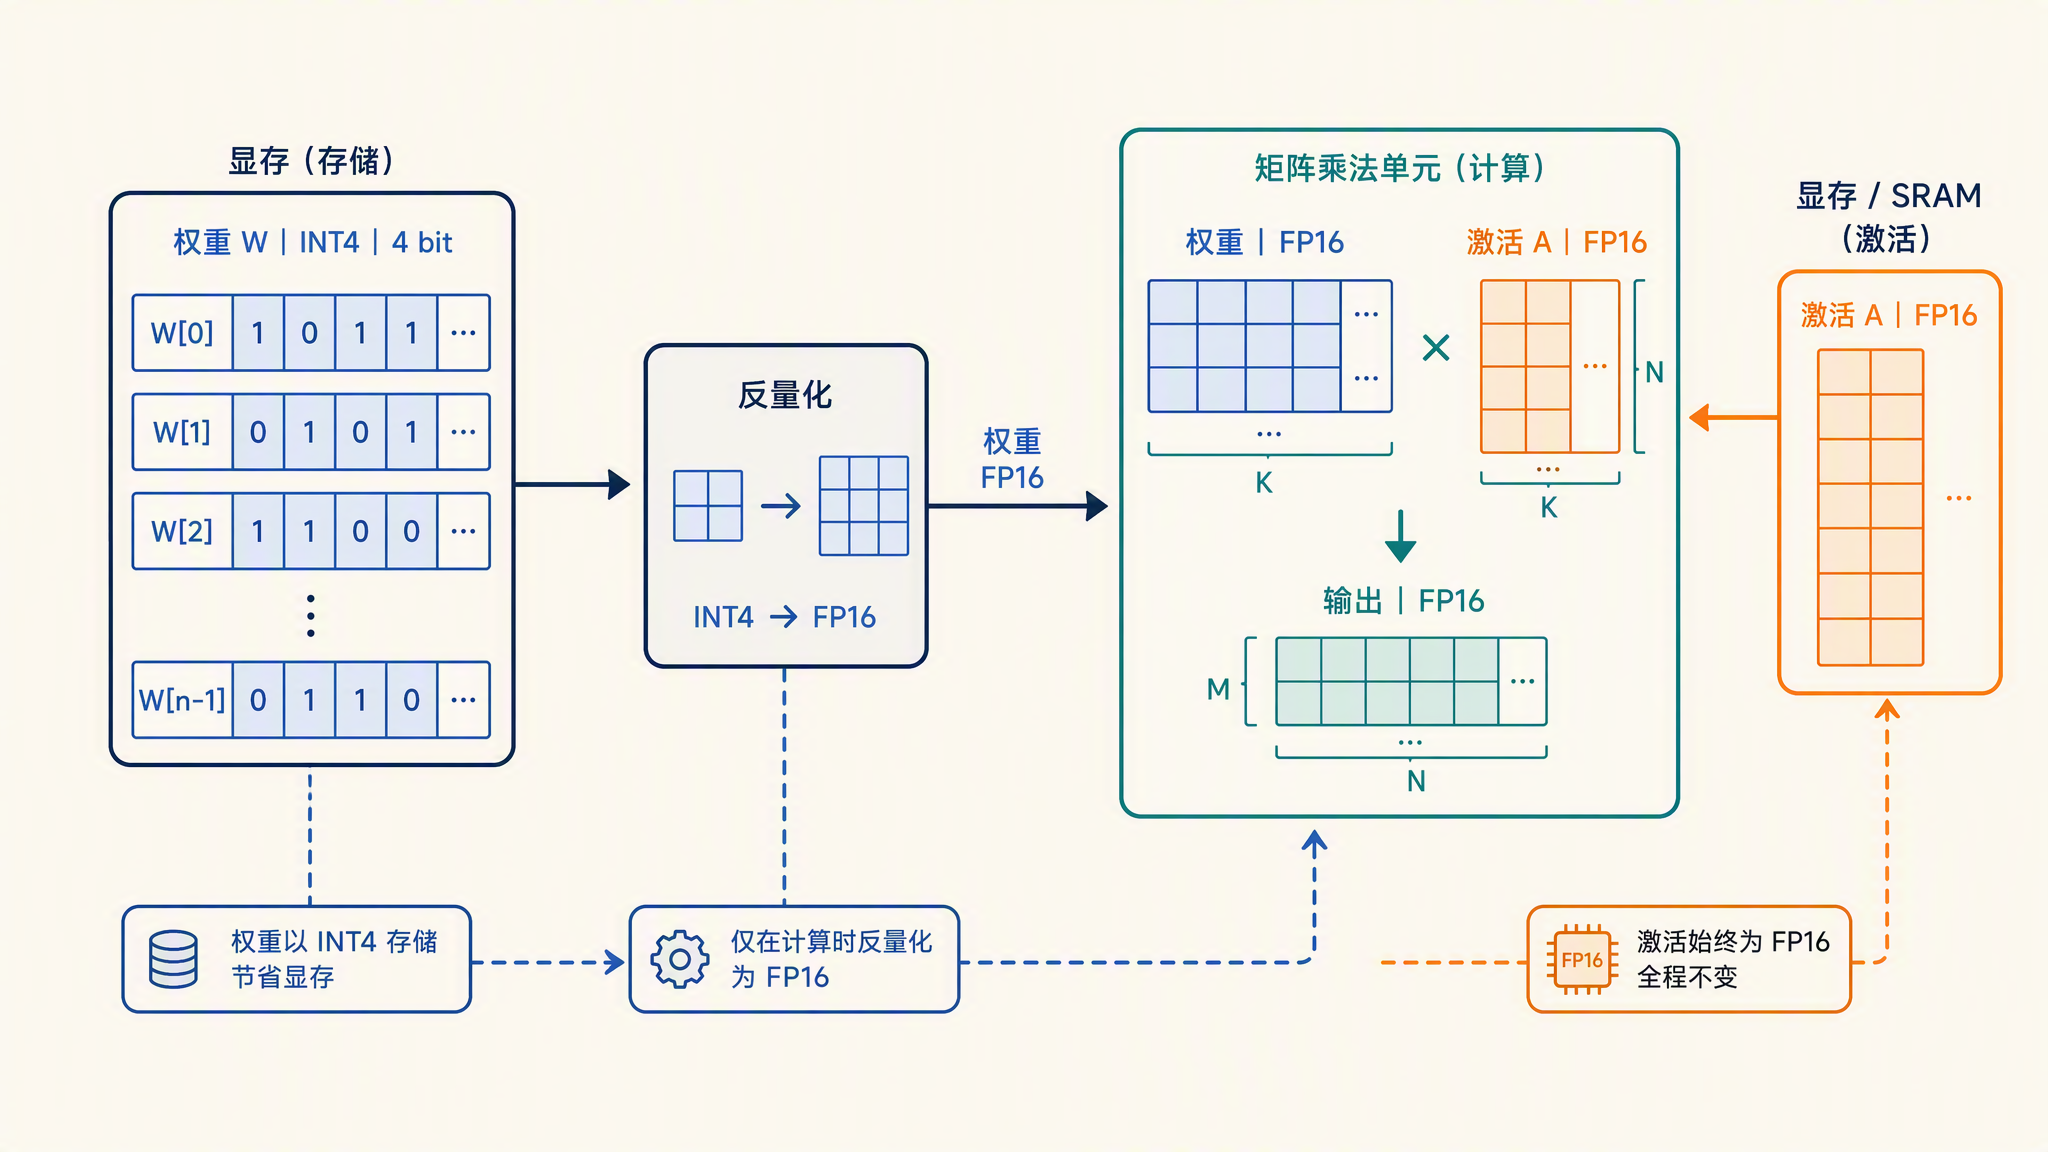
为什么只压权重不压激活?因为激活里存在少量数值特别大的离群通道(outlier channel),硬压到低精度会产生很大的误差;而权重分布比较平滑,压缩余地大。权重在加载时一次性量化好,激活在推理时动态计算,所以 W4A16 的实际做法是:显存里存 4bit 权重,计算时先反量化(dequantize)回 FP16 再做矩阵乘。显存和带宽的收益照拿,计算本身还是 FP16 精度,这是它精度损失小的原因。

所谓通道,就是激活向量的一个维度。模型的隐藏状态是一个几千维的向量,研究者发现,其中少数几个维度上的数值会系统性地比其他维度大出几十倍甚至上百倍,这些维度就是离群通道。量化要按数值范围定刻度,这几个大通道会把刻度撑得很大,其余占绝大多数的普通数值只能挤在刻度底部的一小段里,舍入误差就被放大了。这个现象由 LLM.int8() 论文 系统研究过,模型规模越大越明显。

w4a16-dataflow.png

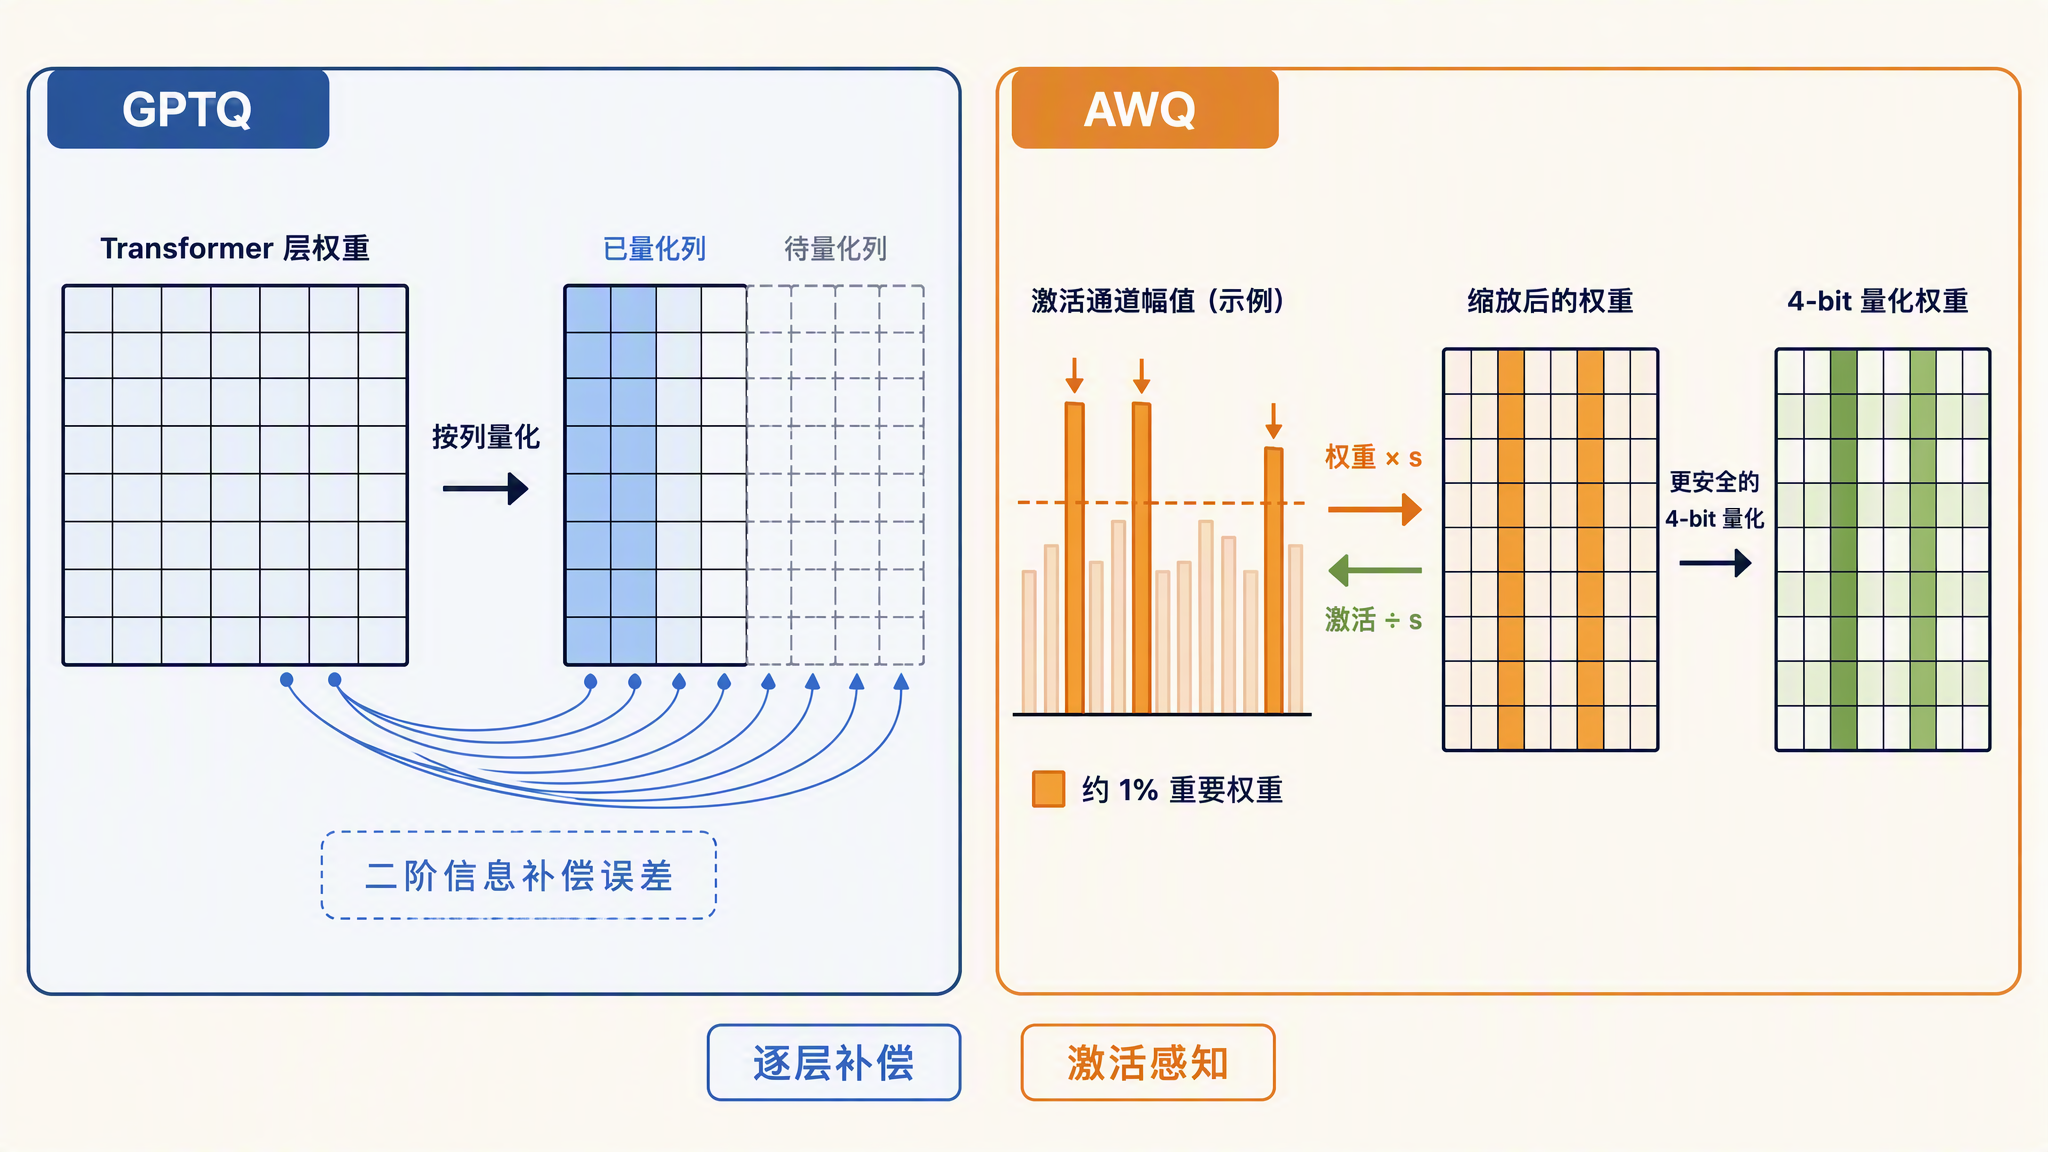
GPTQ:逐层二阶误差补偿

GPTQ 是 Frantar 等人在 2022 年提出的后训练量化(Post-Training Quantization,PTQ) 方法,论文是 GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers。后训练量化的意思是,模型训练完成后,不需要重新训练,只用一小批校准数据就能把权重量化好。

GPTQ 的核心思想是逐层量化,并且每量化一个权重,就用这一层的二阶信息(近似 Hessian 矩阵)调整剩余还没量化的权重,把刚引入的误差补偿掉。这样误差不会在层内累积,模型在 4bit 甚至 3bit 下仍能保持接近原始的精度。论文报告,175B 参数的模型大约 4 个 GPU 小时就能完成量化,在 A100 上端到端推理加速约 3.25 倍。

AWQ:激活感知,保护重要权重

AWQ(Activation-aware Weight Quantization,激活感知权重量化) 是 Lin 等人在 2023 年提出的方法,来自 MIT 韩松团队,论文发表在 MLSys 2024。它的出发点是一个观察:模型里只有约 1% 的权重对输出影响大,而且这些重要权重不能从权重自身的大小看出来,要从激活的分布里看。哪个权重通道对应的激活值大,哪个通道就重要。

找到这 1% 之后,最简单的保护办法是把它们保留成 FP16,但混合精度对硬件不友好。AWQ 的做法更巧:给重要通道的权重乘上一个缩放系数,同时把对应的激活除以同一个系数。数学上输出不变,但缩放后的权重在量化时落入了更安全的区间,等效于获得了更高的有效精度。AWQ 校准快、4bit 下精度表现好,vLLM、SGLang、TensorRT-LLM 都内置了支持,是目前部署 4bit 模型的主流选择。

gptq-awq-comparison.png

FP8:新硬件的原生支持

INT8 和 INT4 量化都需要反量化和专门的 kernel 支持,而 FP8(8 位浮点数) 走的是另一条路:让硬件直接支持低精度浮点运算。NVIDIA 从 Hopper 架构(H100)开始在 Tensor Core 里原生支持 FP8(支持 e4m3 和 e5m2 两种格式),FP8 的算力正好是 FP16 的两倍;到 Blackwell 架构(B200)又进一步支持到 FP4。

硬件原生支持意味着不需要反量化步骤,矩阵乘直接在 FP8 下完成,显存减半的同时算力翻倍。vLLM 里开启动态 FP8 只需要一个参数 --quantization="fp8",不需要准备校准数据,官方文档有详细说明。代价是 FP8 依赖新硬件,A100 及更早的卡用不了。

精度、显存、速度的三方权衡

量化没有免费的午餐,它是三个维度之间的权衡。把常见的几档方案放在一起对比:

方案权重位宽激活位宽权重显存(相对 FP16)精度损失硬件要求典型场景
FP16/BF161616100%无所有 GPU精度敏感、显存充足
FP8 W8A888约 50%极小Hopper / Blackwell 等新卡数据中心高吞吐服务
INT8 W8A888约 50%小广泛支持通用的保守压缩
W4A16(GPTQ/AWQ)416约 25%可感知但可控几乎所有 GPU单卡跑大模型、边缘部署

选择时的经验法则是:有新卡就优先 FP8,它几乎不掉精度;要在消费级显卡上塞进大模型就用 W4A16;对精度极度敏感的场景就保持 FP16,把优化留给别的手段。

quantization-concept.jpg

动手:加载一个量化模型

Hugging Face 上很多热门模型都有官方发布的 AWQ 版本,模型名里带 AWQ 后缀。用 Transformers 加载量化模型和普通模型写法完全一样:

from transformers import AutoModelForCausalLM, AutoTokenizer

# 加载 Qwen3-4B 的 4bit AWQ 量化版本,需要安装 autoawq
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-4B-AWQ",
    device_map="auto",
)
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-4B-AWQ")

messages = [{"role": "user", "content": "用一句话解释什么是模型量化"}]
inputs = tokenizer.apply_chat_template(
    messages,
    return_tensors="pt",
    add_generation_prompt=True,
    enable_thinking=False,
).to(model.device)
output = model.generate(inputs, max_new_tokens=100)
print(tokenizer.decode(output[0], skip_special_tokens=True))

可以看到,API 层面没有任何区别,量化对使用者是透明的。变化的只有显存占用和生成速度。

投机采样:小模型猜,大模型验

投机采样(Speculative Decoding,也叫投机解码) 是 Leviathan 等人在 2023 年发表的加速技术,论文是 Fast Inference from Transformers via Speculative Decoding。同一时期 DeepMind 的 Chen 等人也独立提出了等价的 Speculative Sampling。

为什么验证 k 个和生成 1 个一样快

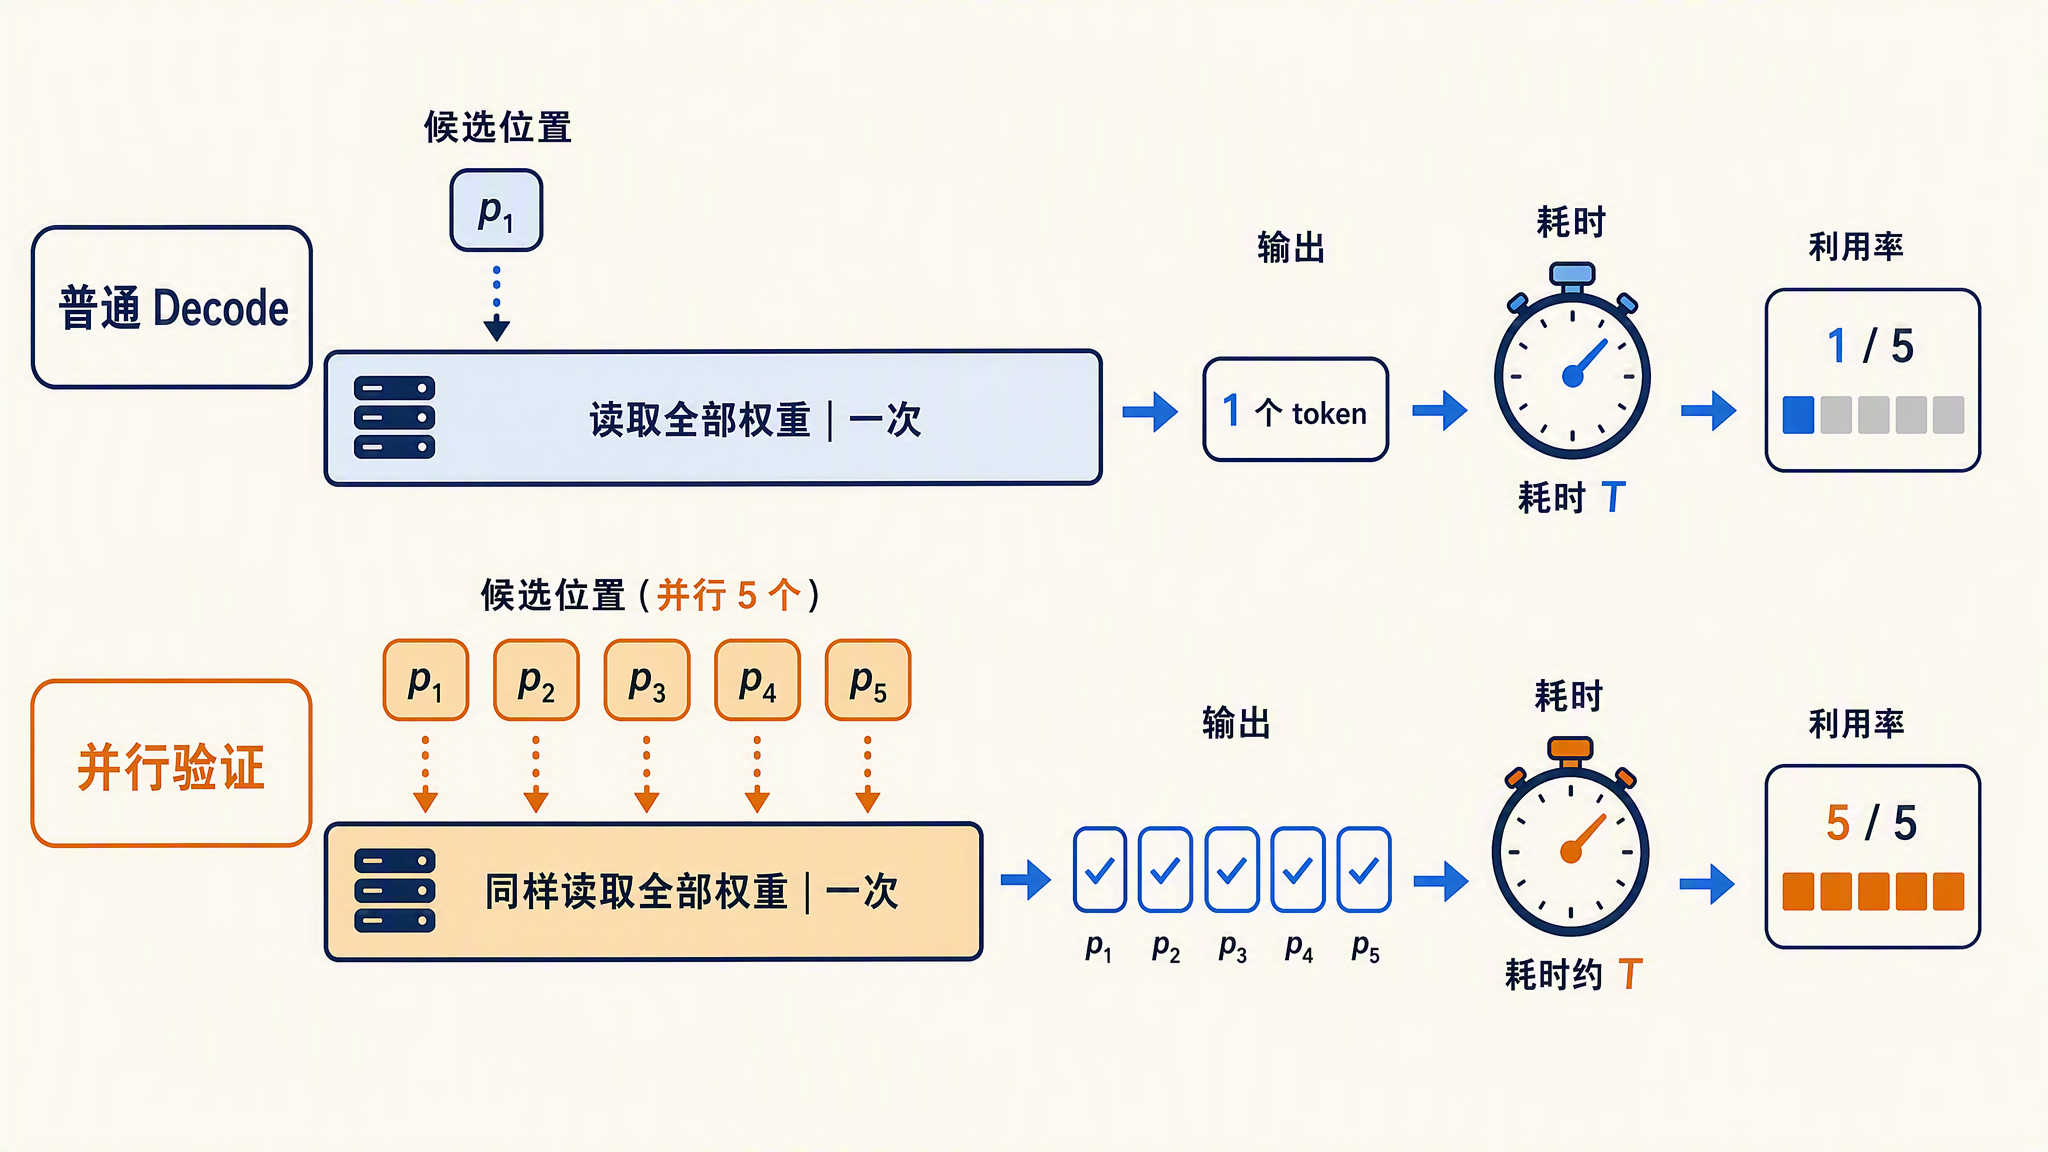
要理解投机采样,先回忆第六篇讲过的结论:decode 阶段每步只处理一个新 token,矩阵乘的规模很小,GPU 算力大量闲置,耗时主要花在把权重从显存搬进计算单元。也就是说,一次前向处理 1 个 token 和处理 5 个 token,读取权重的开销是一样的,总耗时几乎相同。

自回归生成的低效就在这里:每步只产出 1 个 token,却付出了读取全部权重的代价。投机采样的思路是,既然一次前向验证多个 token 几乎不多花时间,那就让一个便宜的小模型先猜,大模型负责验收。

speculative-verification-cost.png

工作流程

具体流程分三步。首先,用一个草稿模型(draft model)(同系列的小尺寸模型,比如参数量小几十倍)自回归地快速猜出 k 个候选 token。然后,把这 k 个 token 拼在现有序列后面,让大模型做一次前向,并行算出这 k 个位置各自的概率分布。最后逐个比对:如果大模型也认可某个 token 就接受,遇到第一个不认可的位置就停下,用修正策略在那里重新采样一个 token,后面的猜测全部作废,它们在 KV Cache 里刚算出的条目也跟着丢弃。

为什么一次前向就能验 k 个位置呢?不知道读者还记不记得第四篇的末尾埋下的那个彩蛋。当时跑前向传播时发现,输入 3 个 token,输出的 logits 形状是 [1, 3, 151936],每个位置都有一份完整的词表分数,只是自回归生成只取最后一个位置的,其余都扔掉了。投机采样就是把这些扔掉的分布捡起来用:把前缀和 k 个候选拼成一整段做一次前向,候选 token 所在位置的那几行分布,就是大模型「自己生成到这一步会选什么」的答案。由于有因果掩码的保证,每个位置只能看到自己和左边的 token,这几行分布和跑 k 步 decode 逐个算出的分布是同一份结果,区别只在于权重读取从 k 次合并成了一次。整个过程中大模型没有生成任何 token,它只是给现成的 token 打了分。

一轮下来,最坏的情况是接受 1 个修正 token(和普通 decode 一样,不亏),最好的情况是一次收下 k+1 个 token。下图是这三步流程的一个示意:

speculative-decoding-workflow.png

这个设计有一个非常重要的性质:由于接受和重采样规则是严格按大模型的概率分布推导的,最终输出的分布和不用投机采样时完全一致。它是无损加速,不像量化那样需要担心精度损失。实际加速倍数取决于接受率(acceptance rate),即小模型猜得有多准。小模型和大模型越同宗同源(比如同一系列的 1B 对 70B),用词习惯越接近,接受率就越高。

接受率还和采样温度有关。贪心解码(temperature 为 0)时,小模型只要猜中大模型概率最高的那个 token 就算命中,接受率最高;温度调高、随机性变大后,猜测变难,加速效果会打折扣。

动手:在 Transformers 里开启投机采样

Transformers 的 generate 原生支持投机采样,只需要多传一个 assistant_model 参数。下面我们加载 Qwen3-4B 作为目标模型,用同系列的 Qwen3-0.6B 当 draft 模型:

from transformers import AutoModelForCausalLM, AutoTokenizer

# 目标大模型和 draft 小模型,同系列才能保证词表一致
target = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-4B", device_map="auto")
draft = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-0.6B", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-4B")

messages = [{"role": "user", "content": "写一首关于秋天的短诗"}]
inputs = tokenizer.apply_chat_template(
    messages,
    return_tensors="pt",
    add_generation_prompt=True,
    enable_thinking=False,
).to(target.device)

# 传入 assistant_model 即开启投机采样,生成结果和不传时分布一致
output = target.generate(inputs, assistant_model=draft, max_new_tokens=200)
print(tokenizer.decode(output[0], skip_special_tokens=True))

可以看到,用法上只多了一行参数。draft 模型必须和目标模型共用同一个词表,否则两边对 token 的编号对不上,验证无从谈起,这也是 draft 模型通常选同系列小模型的原因之一。

改进方向

原版投机采样需要额外部署和维护一个小模型,后续工作沿着去掉独立小模型的方向演进。Medusa 的做法是给大模型本身加几个额外的解码头,一次预测后面多个位置的 token,不再需要单独的 draft 模型。EAGLE 更进一步,在大模型的倒数第二层特征上做外推来生成候选,接受率比 Medusa 更高。这两个都是当前推理框架里常见的可选项,细节这里就不展开了,感兴趣的同学可以查阅相应的资料。

PD 分离:prefill 和 decode 各司其职

第三个技术从系统层面入手,它改的不是模型而是部署形态。

两类负载天生不合

我们已经不止一次讲过 prefill 和 decode 的负载差异:prefill 一次性处理全部输入 token,矩阵规模大,吃算力(compute-bound);decode 每步只处理一个 token,反复读权重和 KV Cache,吃带宽(memory-bound)。传统的部署方式把两个阶段放在同一批 GPU 上混跑,因此一个 prefill 请求进来,会抢走 decode 请求的算力,正在生成的用户会感到 token 输出卡顿;反过来,大量 decode 请求占着 KV Cache 显存,prefill 又排不上队。两个阶段互相拖累,而且它们对并行策略、批大小的最优配置完全不同,混在一起只能取一个两头将就的中间值。

前面讲连续批处理时介绍过的分块预填充,就是在引擎内部缓解这种干扰的办法,把长 prefill 切块混进 decode 迭代里跑。今天这个技术的思路更彻底,直接从部署层面把两个阶段分开。

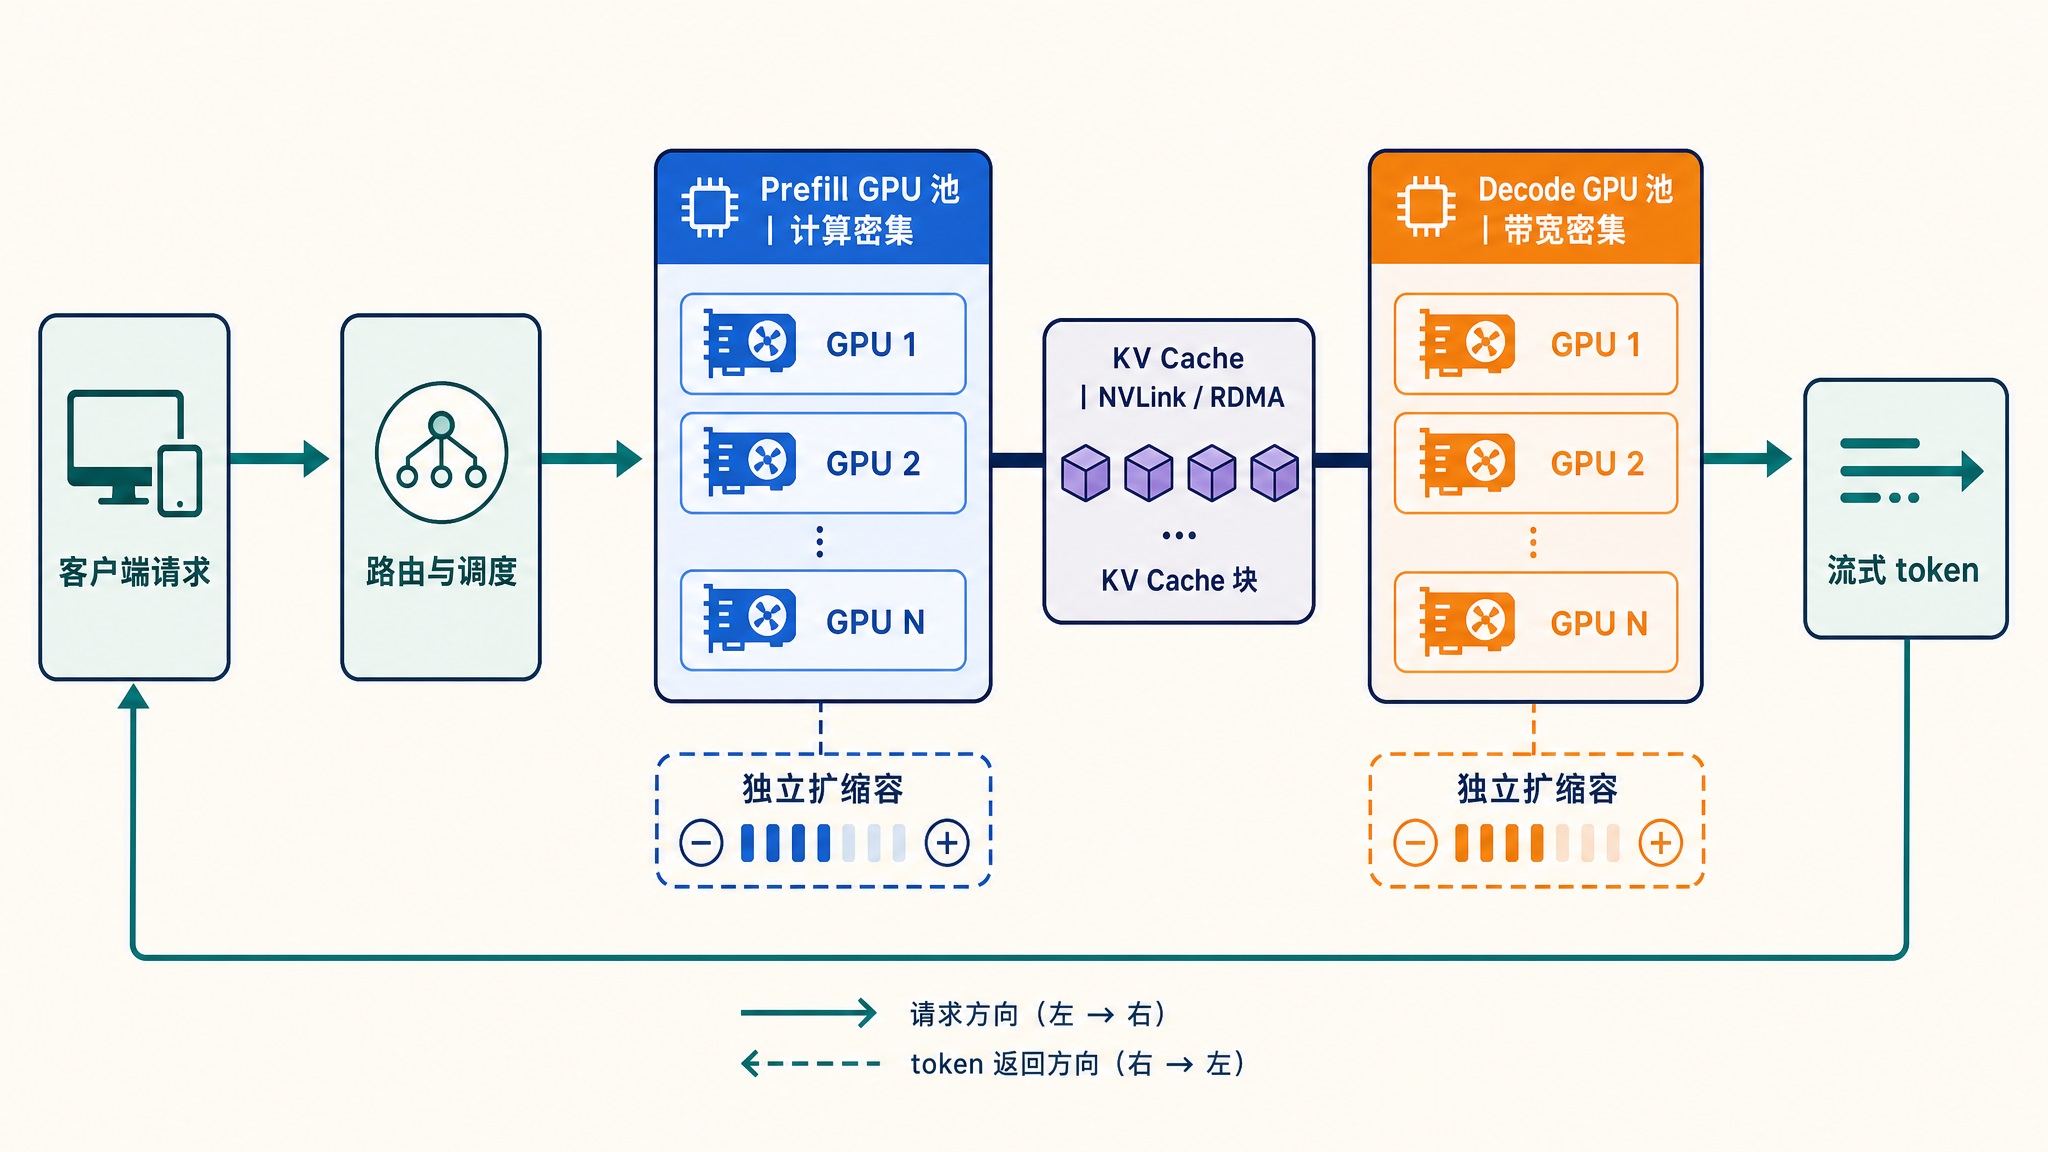
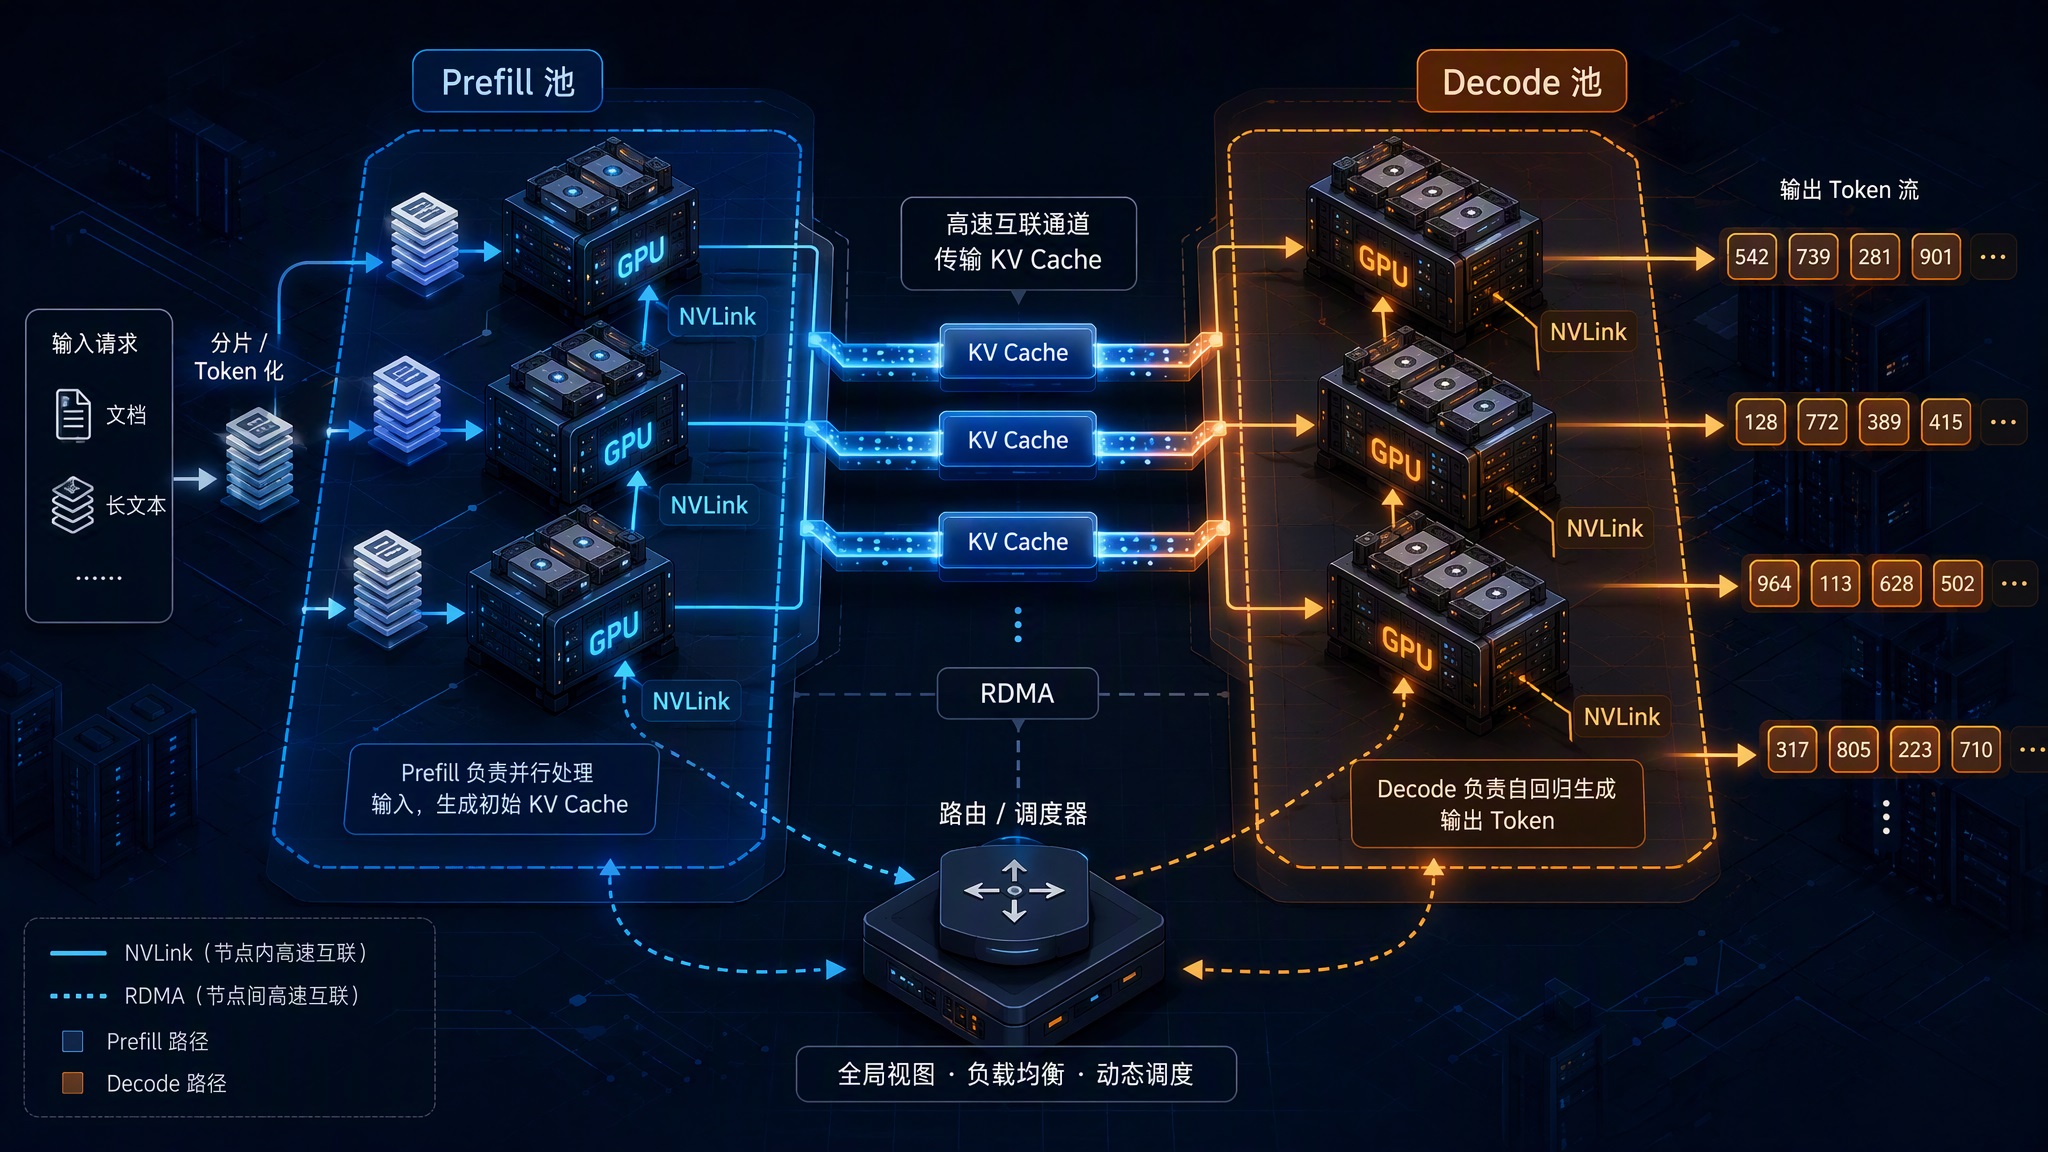
PD 分离(Prefill/Decode Disaggregation,预填充与解码分离) 的做法是把两个阶段拆到两个独立的 GPU 池:prefill 池专门处理输入、算好 KV Cache,然后通过高速网络(NVLink 或 RDMA)把 KV Cache 传给 decode 池,decode 池接力做逐 token 生成。两个池可以按各自的负载特征独立扩缩容、独立选并行策略。整体架构如下:

pd-disaggregation-architecture.jpg

KV Cache 的传输是这套架构的主要开销。一个长上下文的请求,KV Cache 可能有几个 GB,跨机传输必须走高速互联。NVLink 是 NVIDIA GPU 之间的高速互联总线,适合节点内部。RDMA(Remote Direct Memory Access,远程直接内存访问)是一种让一台机器直接读写另一台机器内存的网络技术,绕开两端的 CPU 和操作系统内核,适合跨节点。如果没有这个级别的带宽,省下来的计算时间全搭在搬运上。所以 PD 分离是规模化的技术,请求量大到能填满两个池子时才划算。

pd-disaggregation-cluster.jpg

代表工作

PD 分离这两年从论文走进了生产系统,下面是几个代表性实现:

  • DistServe:2024 年发表于 OSDI 的学术工作,是把 PD 分离系统化的早期代表。它给两个阶段分别优化资源配置和并行策略,并用带宽感知的放置策略尽量让 KV Cache 走节点内的 NVLink。论文报告,在满足延迟目标的前提下,能比当时最先进的系统多服务最多 7.4 倍的请求
  • Mooncake:月之暗面(Moonshot AI)为 Kimi 搭建的生产级推理平台,发表于 USENIX FAST 2025。它在 PD 分离的基础上更进一步,以 KV Cache 为中心设计,把集群里的 CPU 内存、SSD 和 RDMA 网络池化成一个分布式 KV 缓存,长上下文和多轮对话的前缀复用是它的强项
  • NVIDIA Dynamo:NVIDIA 在 GTC 2025 发布的分布式推理框架,Triton Inference Server 的继任者,PD 分离是它的核心特性之一,并配套了专门做跨机 KV Cache 传输的 NIXL 库
  • vLLM:开源推理引擎也在原生支持 P/D disaggregation,提供了 KV 传输的连接器接口和部署示例,可以在自己的集群里搭一套分离式服务

如果想从工程落地的角度进一步了解这套架构,DigitalOcean 有一篇 Prefill/Decode 分离的实践解析,对部署细节的拆解比较细,感兴趣的同学可以看看。

再往上:张量并行与流水并行

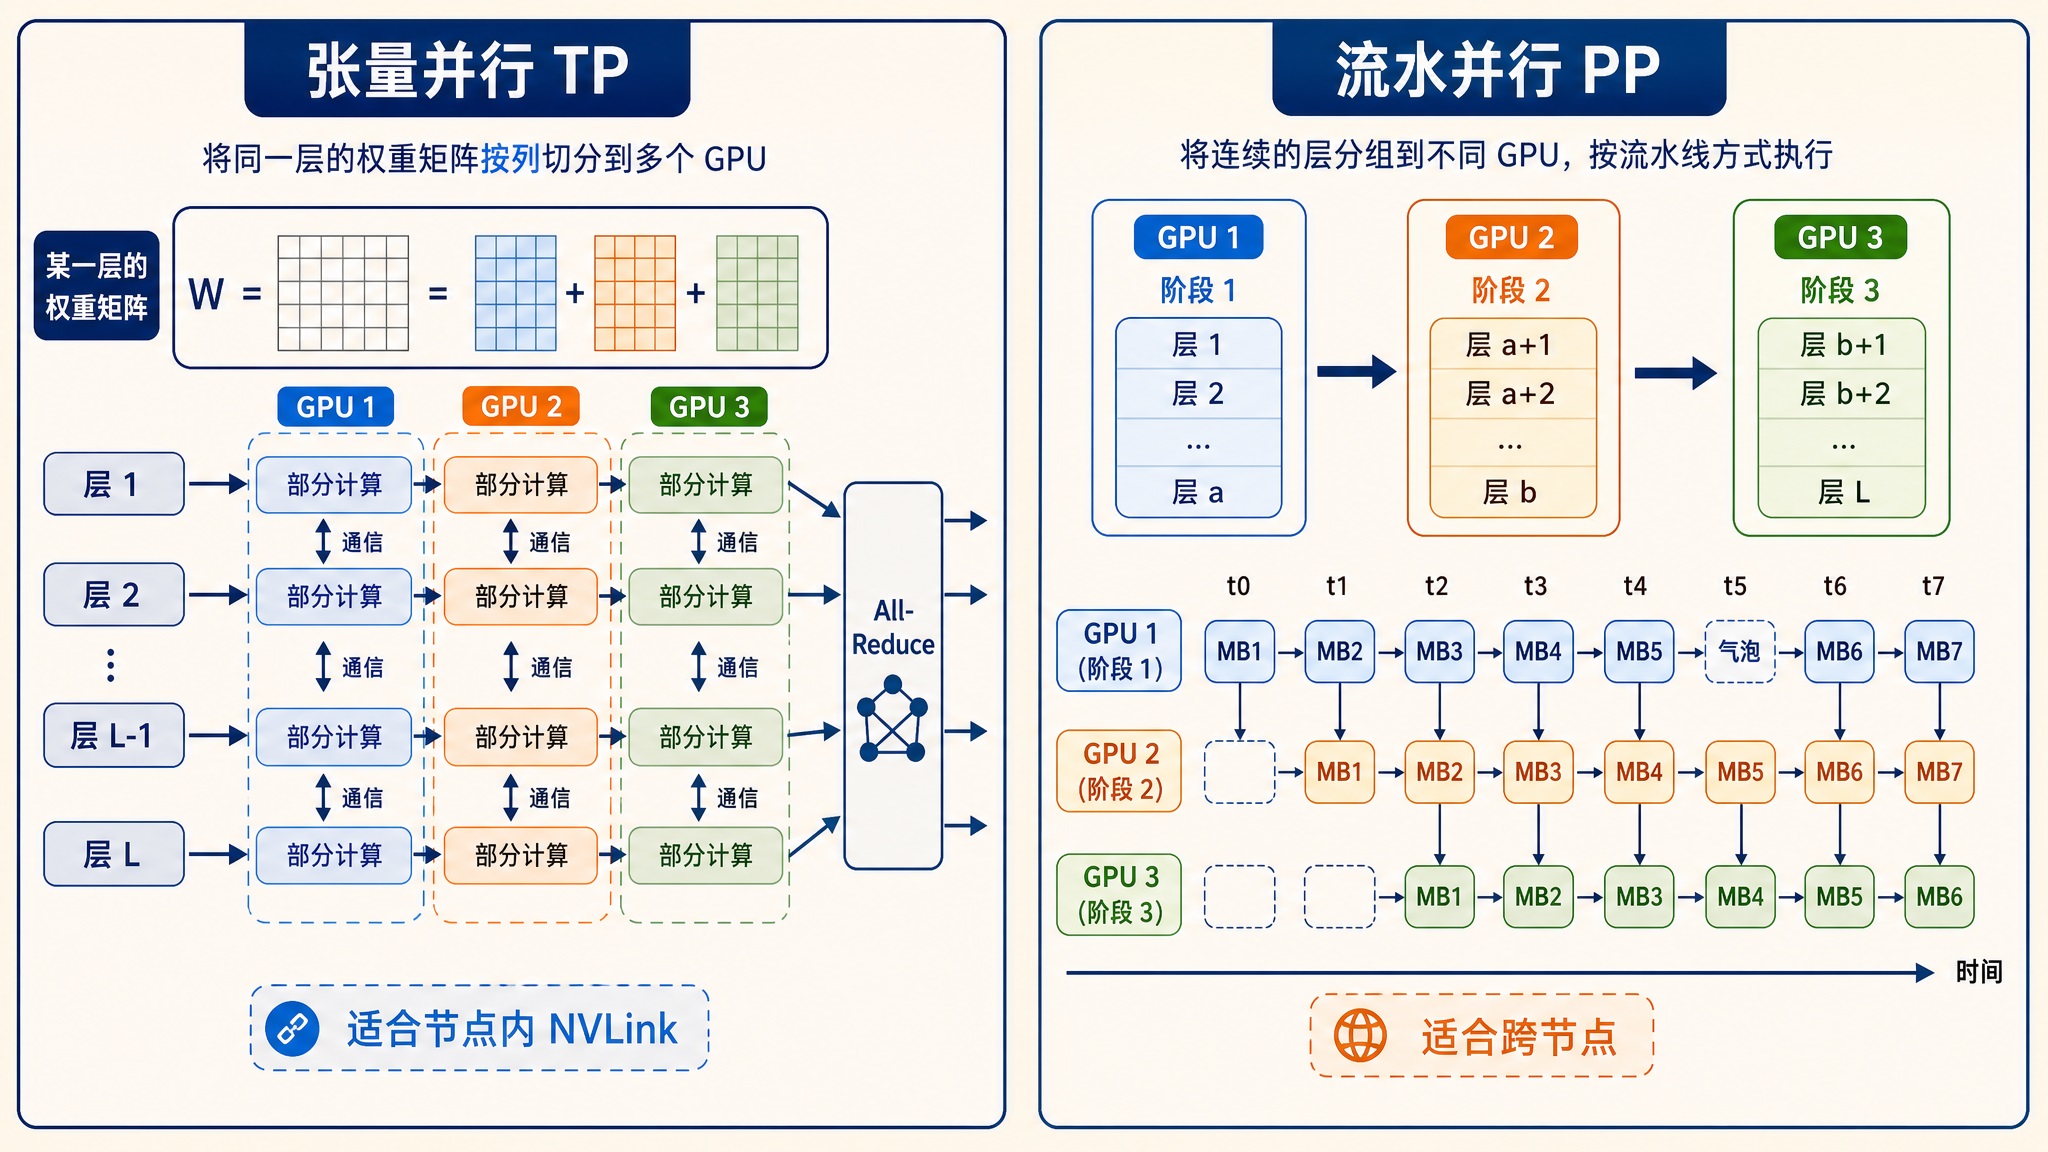
最后简单提一下更大规模的推理。当模型大到单卡放不下时,就得把模型本身拆开。张量并行(Tensor Parallelism,TP) 是把每一层的权重矩阵切开,几张卡各算一部分,每层算完都要做一次卡间通信合并结果,对互联带宽的要求很高,一般限制在节点内的 NVLink 上。流水并行(Pipeline Parallelism,PP) 是把模型的层切成几段,每张卡负责连续的一段,请求像流水线一样在卡之间传递,只在段的边界通信,通信量小,但段与段交接时会留下空闲的气泡,适合跨节点部署。实际的大模型部署往往是 TP、PP 加上今天讲的 PD 分离组合使用,这部分作为延伸阅读,今天点到为止。

tensor-vs-pipeline-parallelism.jpg

小结

今天我们一口气学了三类推理加速技术:

  1. 量化:把 FP16 权重压到 8bit 或 4bit,显存和带宽收益直接。GPTQ 用逐层二阶信息做误差补偿,AWQ 从激活分布里找出约 1% 的重要权重加以保护,FP8 则依靠 Hopper 和 Blackwell 的原生支持做到几乎无损。选型是精度、显存、速度的三方权衡
  2. 投机采样:用小 draft 模型猜 k 个 token,大模型一次前向并行验证,接受多少算多少。它有效是因为 decode 是带宽瓶颈,验证 k 个 token 和生成 1 个耗时几乎一样,而且输出分布与大模型完全一致,是无损加速。Medusa 和 EAGLE 是去掉独立小模型的改进方向
  3. PD 分离:prefill 吃算力、decode 吃带宽,混在一起互相拖累,拆到两个 GPU 池各自优化,KV Cache 走高速网络传输。DistServe、Mooncake、NVIDIA Dynamo 和 vLLM 是代表性实现
  4. 更大规模的分布式推理:张量并行切权重、流水并行切层,作为延伸阅读

至此,我们对大模型推理的探索之旅也告一段落。从第一篇的全景地图出发,我们跟着一条请求走完了它的完整旅程:分词、嵌入和位置编码、前向传播、KV Cache、prefill 与 decode、采样、流式输出,又深入了连续批处理、显存优化和今天的加速技术。每个环节我们都拆开了原理,也都动手跑过真实的代码。希望这个系列能帮你建立起对大模型推理的整体认识,下次再看到屏幕上逐字蹦出的回答时,脑子里浮现的不只是文字,还有文字背后的整条流水线。

参考


学习大模型推理的显存优化:PagedAttention 与前缀缓存

在上一篇中,我们解决了 GPU 空转的问题:用迭代级调度替代静态批处理,请求随到随入、随完随出,GPU 不再为了等齐一批请求而闲置。调度器的目标很明确,就是往运行集里塞尽可能多的并发请求,把算力吃满。

但并发不是想加就能加的。每个在跑的请求都背着一份 KV Cache,在 KV Cache 那一篇里我们总结过一个公式:缓存大小 = 2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数,可见缓存随序列长度线性增长,再乘上并发数。Qwen3-0.6B 这样的小模型,一个 token 的缓存约 112 KB,一条 4k 序列就是 448 MiB。于是矛盾来了:批处理想并发更多请求,显存却先不够了。现实里限制服务吞吐的,往往不是算力而是显存。

今天这篇就来讲推理显存管理里最经典的两项技术:PagedAttention 和前缀缓存(Prefix Caching)。前者把 KV Cache 的分配方式彻底改掉了,后者在前者的基础上让多个请求共享同一段缓存。

显存都去哪了

要优化显存,先看清一块 GPU 的显存都被谁占了。推理时的显存大致分四块:

  • 模型权重:加载后就固定不变。一个 FP16 的 7B 模型约 13 GiB,这部分没什么可省的(权重量化是另一篇的话题)
  • KV Cache:所有在跑请求的缓存总和。它随并发数和序列长度动态增长,负载越重涨得越多,是显存里唯一随流量浮动的大头
  • 激活值与临时缓冲:前向计算中间产物的临时显存,比如注意力得分矩阵。单个请求的激活不大,但也随并发涨
  • 碎片与预留:分配器管理显存时产生的缝隙,以及框架自身预留的部分

四块占用的关系示意如下:

gpu-memory-breakdown.png

权重是死的,激活值占比小,真正能做出文章的只有 KV Cache。所以推理引擎的显存优化,几乎全部围绕 KV Cache 的分配和复用展开。

按最大长度预留

先看不做任何优化时,推理系统怎么给 KV Cache 分配显存。最朴素的做法是:请求一进来,就按最大可能长度给它预留一整段连续显存。比如 max_model_len 设成 4096,那不管这条请求最终只用 200 个 token 还是真用满 4096,引擎一开始就按 4096 把一整段显存占住,请求结束才释放。

这个做法实现简单,但浪费是结构性的,主要有三类:

  • 内部碎片(Internal Fragmentation):按最大长度预留,实际用多少算多少,预留出来没用上的部分一直空着。大部分请求的长度远小于上限,空着的部分是常态
  • 预留浪费:请求刚开始生成第 1 个 token 时,后面几千个 token 的位置就已经被锁定,别的请求用不上
  • 外部碎片(External Fragmentation):不同请求要预留的段长不一,显存被切得七零八落。剩余总量可能够,但凑不出一段连续的来满足新请求

因此,真正存了有效 KV 的部分往往只占一小半。vLLM 团队在他们的论文和官方博客里给出过实测:传统系统里这类浪费能占到 KV Cache 显存的 60% 到 80%,也就是说真正用来存数据的只有两三成。显存利用率上不去,能并发的请求数就上不去,continuous batching 攒出来的调度优势也就发挥不出来。

PagedAttention 原理

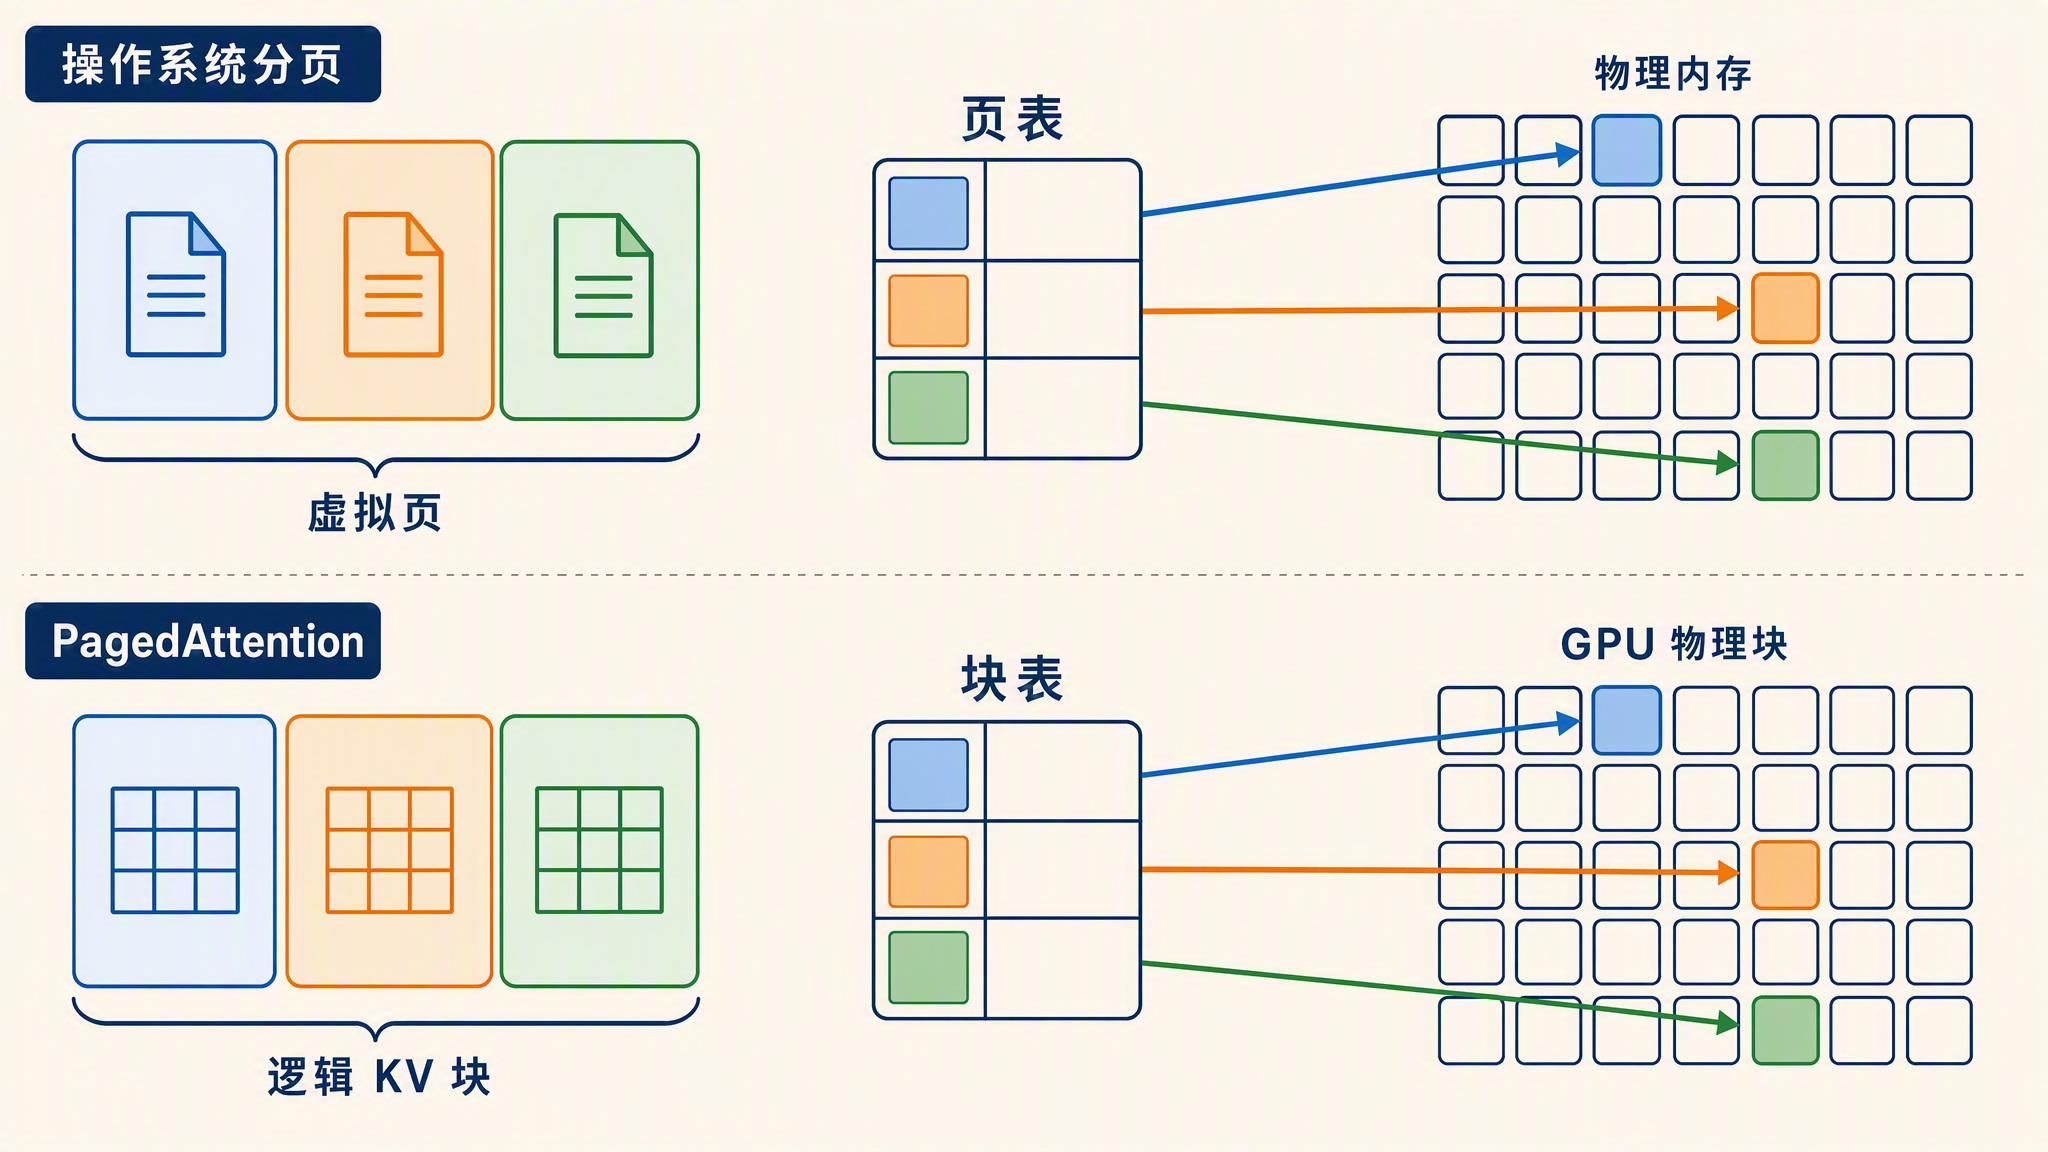
PagedAttention 由 vLLM 团队提出,论文 Efficient Memory Management for Large Language Model Serving with PagedAttention 发表在 SOSP 2023 上,一作是 Woosuk Kwon。它的核心思路来自一个类比:操作系统用虚拟内存分页管理内存,PagedAttention 用同样的办法管理 KV Cache。

先回忆操作系统是怎么管内存的。操作系统从不要求一个进程的内存物理上连续。它把内存切成固定大小的页(Page),进程看到的是一串连续的虚拟地址,背后由页表(Page Table)把虚拟页映射到分散在物理内存各处的物理页。用多少分多少,进程结束就回收。这套机制解决了和上面一模一样的问题:按峰值预留的浪费、大小不一的连续段造成的外部碎片。

PagedAttention 把这套原样搬到了 KV Cache 上:

  • 块(Block):KV Cache 不再是一整段连续空间,而是切成固定大小的块,每块存固定数量 token 的 K 和 V。vLLM 默认一块 16 个 token
  • 逻辑块与物理块:每个请求看到的仍然是一串连续的逻辑块,实际数据存在显存里分散的物理块上,物理块不要求连续
  • 块表(Block Table):维护逻辑块到物理块的映射,角色相当于页表
  • 按需分配:请求每生成满一个块的 token,才向空闲块池申请下一个物理块,不再提前预留

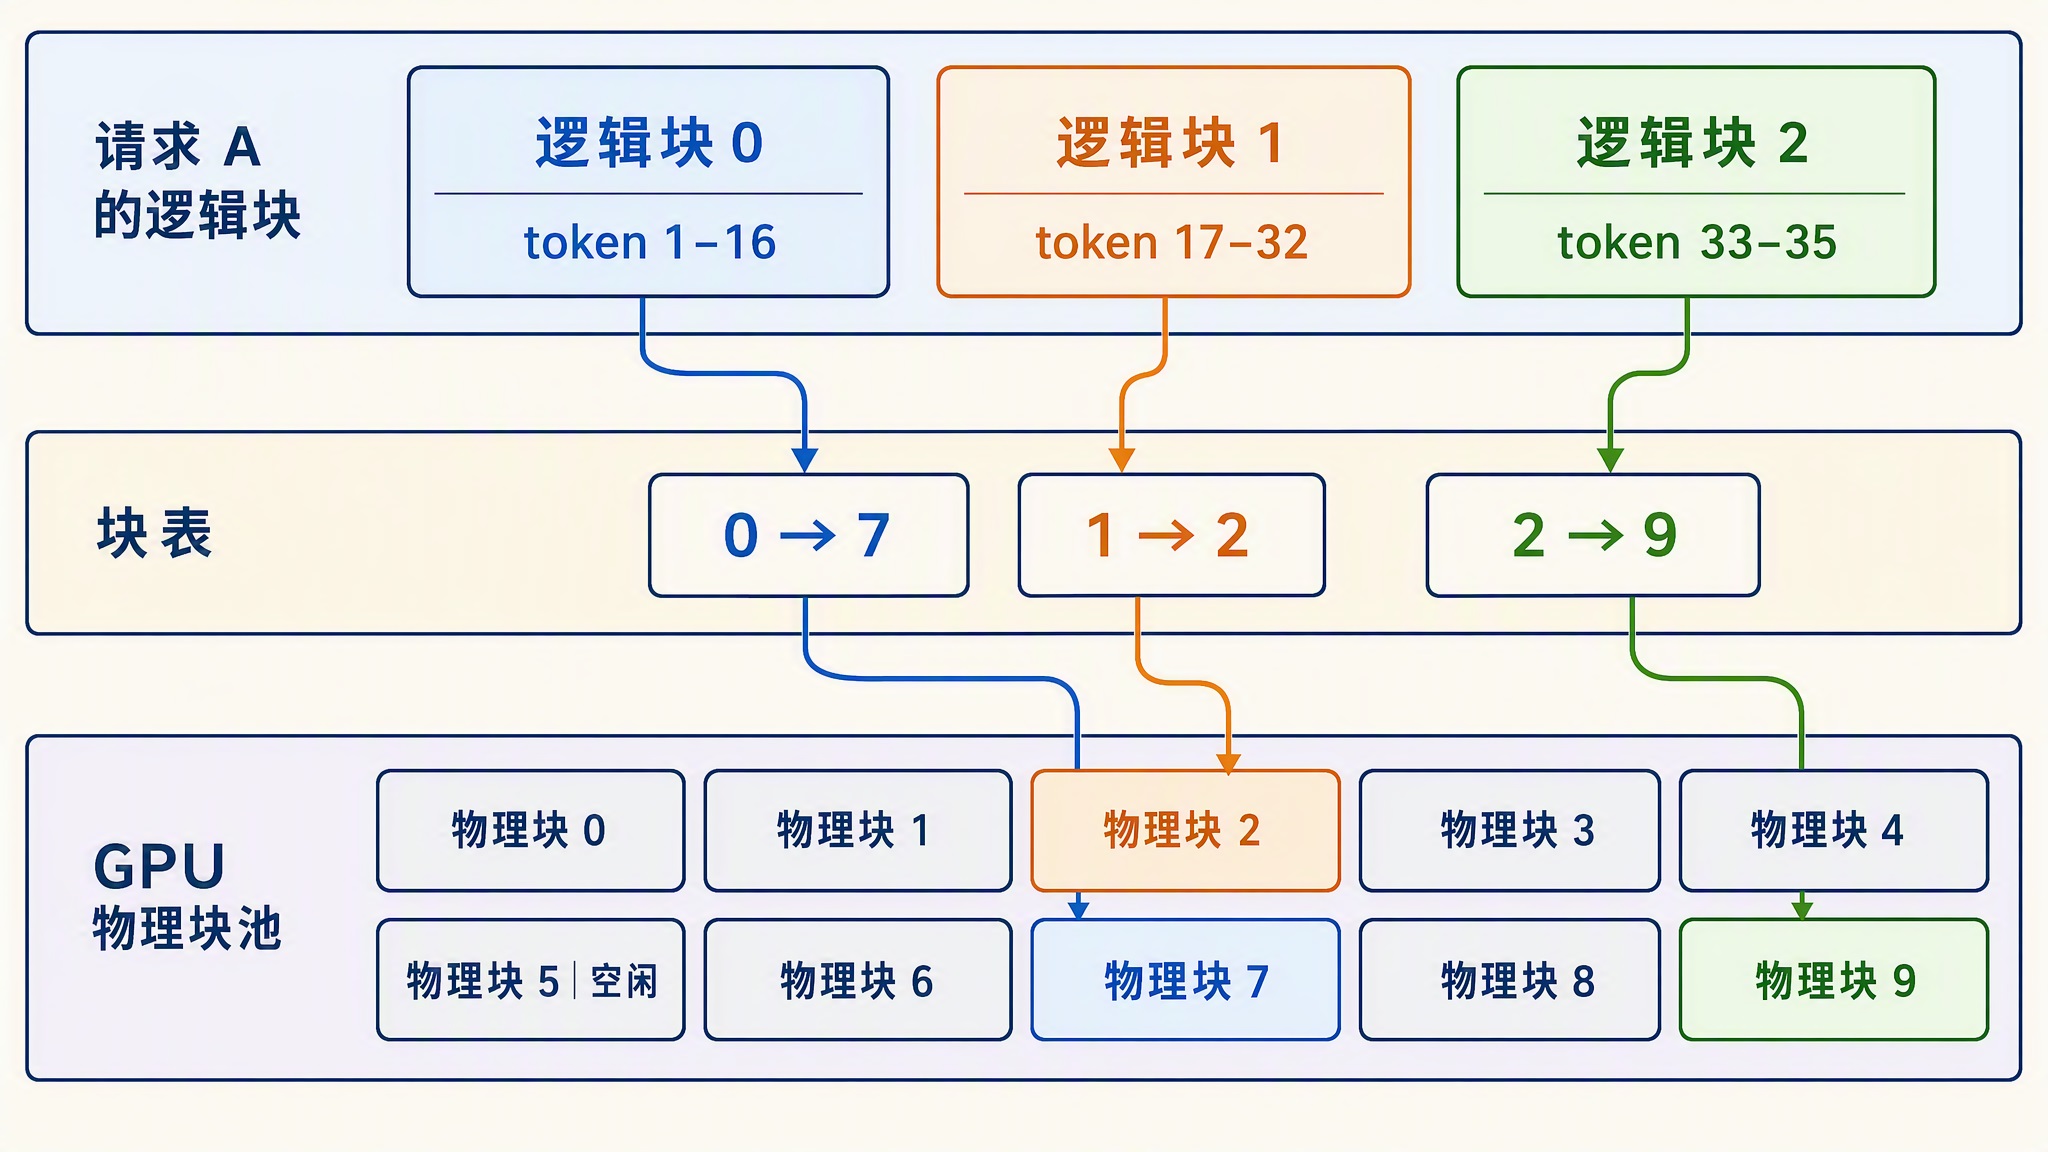
逻辑块、块表、物理块三者的映射关系如下:

pagedattention-block-mapping.jpg

可以看到,请求 A 的 35 个 token 占了 3 个逻辑块,实际落在物理块 7、2、9 上,彼此不相邻,但块表把映射关系记下来后,注意力计算照常进行。调度器眼里所有物理块都是等价的,谁空了就给谁。

下面是 PagedAttention 和操作系统分页的类比图:

paged-attention-analogy.jpg

分页之后,前面的三类浪费基本被消掉了。内部碎片只剩最后一个没填满的块,一条序列最多浪费 15 个 token 的空间。外部碎片没有了,因为所有块尺寸相同,任何空块都能直接用。预留浪费也没有了,因为根本不再预留。论文给出的数据是浪费降到 4% 以内,对比前面 60% 到 80% 的浪费,同一块显卡能容纳的并发请求数翻了好几倍。

有人可能会想:一个块 16 个 token,一条序列最多浪费 15 个,那把块改小,浪费不就更少了吗?其实块大小不是越小越好。块太小,块表就会变长,管理和寻址开销就会变大;16 个 token 一块是工程上比较平衡的选择,vLLM 把它作为默认值,也可以通过启动参数调整。

前缀缓存

PagedAttention 的收益不止省显存。块被统一管理起来之后,一个新能力自然就出现了:块可以被多个请求共享。这就引出了今天第二个主角,前缀缓存。

前缀共享的机会从哪来?实际服务里,大量请求的前缀是一模一样的:

  • 系统提示词:同一个应用的所有请求,开头都是同一段 system prompt,动辄几百上千 token
  • 多轮对话:客户端每次都要把完整历史重新发给服务端,第 N 轮请求的前缀就是第 N-1 轮的完整内容
  • Few-shot 示例:在提示词里给模型几个输入输出样例再提问,一批评测或抽取任务共用同一段示例,只有最后的问题不同

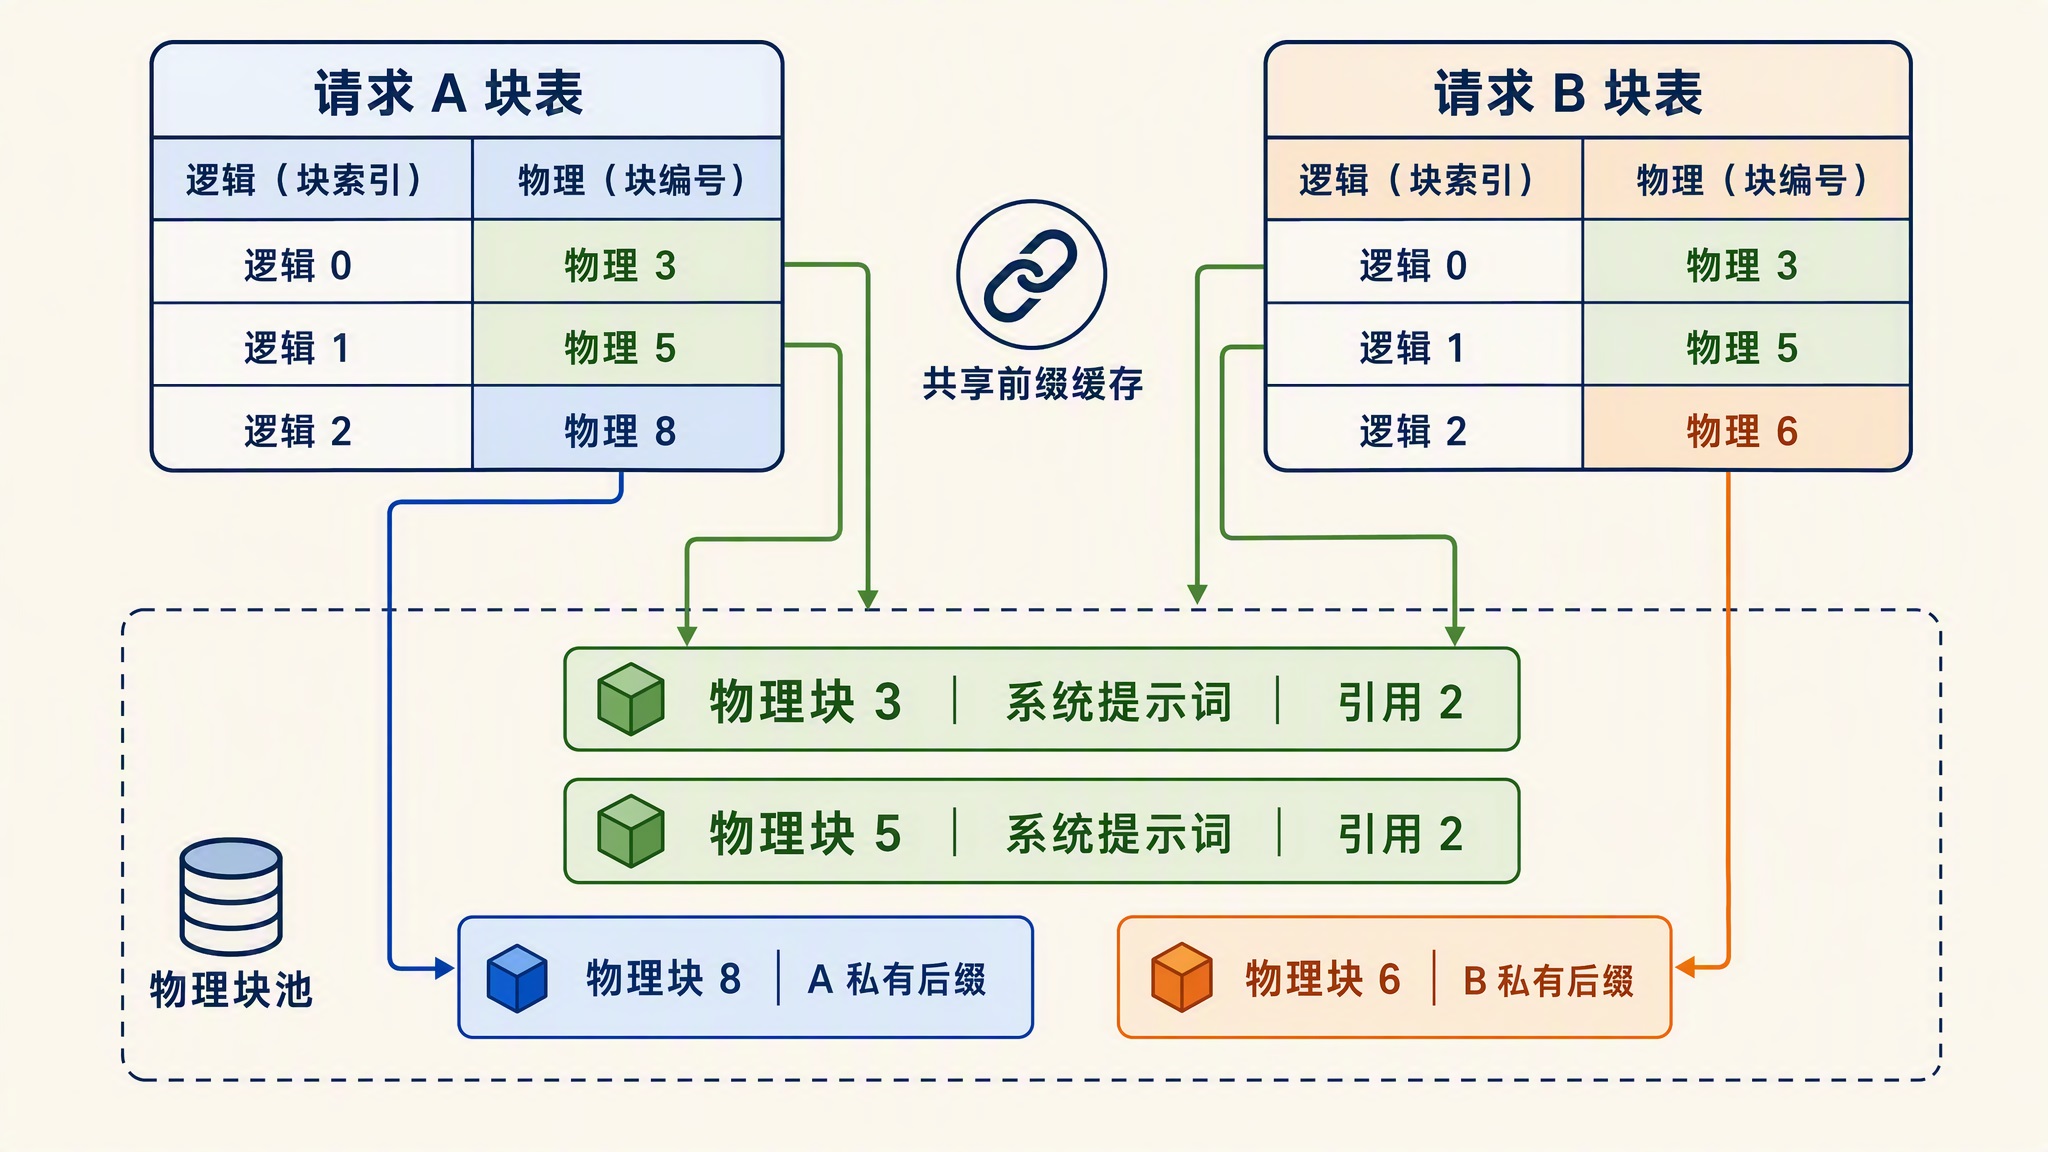
没有前缀缓存时,这些相同的前缀每个请求各算一遍 prefill、各存一份缓存,纯纯的重复劳动。有了分块管理之后,做法就很直接了:给每个块的内容算一个 hash,key 里包含这个块的 token id 和它前面所有前缀的信息。新请求进来时,先按块查 hash,命中说明显存里已经有内容完全相同的块,直接把物理块映射进自己的块表,prefill 只算没命中的部分。

如下图所示,两个请求共享系统提示词前缀的情况如下,物理块 3 和 5 被两条请求的块表同时引用:

prefix-cache-shared-blocks.jpg

共享块上挂着引用计数,被几个请求引用就记几。请求结束时计数减一,减到零的块才进空闲池等待复用或回收。

前缀缓存的收益是双份的:一是省显存,共享的前缀只存一份;二是省计算,命中部分的 prefill 整个跳过,直接降低了 TTFT。对长系统提示词和多轮对话这类负载,命中率可以非常高。

vLLM 把这个能力叫 Automatic Prefix Caching(APC),V1 引擎里默认开启,官方文档有专门的章节介绍。SGLang 则做了进一步的细化,提出了 RadixAttention:它不用 hash 表按块匹配,而是用一棵基数树(Radix Tree)来组织缓存。基数树是一种压缩的前缀树,公共前缀在树里天然是同一条路径,因此可以做任意长度的前缀匹配。缓存淘汰再配合 LRU(Least Recently Used,最久未使用)策略,优先逐出最久没用的节点。多轮对话、树状探索这类共享模式复杂的场景,RadixAttention 的命中率会比固定块大小的 hash 匹配更稳。SGLang 的论文里有完整的设计和实验,想深入的同学可以看看。

RadixAttention 的缓存组织方式示意如下,相同前缀收敛到同一条树路径上:

radixattention-prefix-tree.png

动手体验前缀缓存

概念讲完,我们亲手验证一下命中效果。用 vLLM 起一个 OpenAI 兼容服务,显式打开前缀缓存:

$ vllm serve Qwen/Qwen3-0.6B --enable-prefix-caching --port 8000

在较新的 vLLM 版本里,V1 引擎默认就开启了前缀缓存,不加这个参数也有同样的效果。老版本需要显式指定。

然后写个客户端,连续发两个请求,让它们共享一段很长的系统提示词,分别测一下 TTFT:

import time
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

# 构造一段较长的公共前缀,模拟应用层的系统提示词
system_prompt = "你是一位资深的技术编辑,回答要准确简洁。" * 200

def measure_ttft(question):
    start = time.perf_counter()
    resp = client.chat.completions.create(
        model="Qwen/Qwen3-0.6B",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": question},
        ],
        max_tokens=8,
        stream=True,
    )
    for _ in resp:  # 收到第一个 token 就计时结束
        break
    return time.perf_counter() - start

print("第一次请求 TTFT:", measure_ttft("介绍下 KV Cache"))
print("第二次请求 TTFT:", measure_ttft("介绍下 PagedAttention"))

我实际跑出来的结果如下:

第一次请求 TTFT: 0.32561847753822803
第二次请求 TTFT: 0.01986777689307928

第一个请求要完整 prefill 整段系统提示词,几百上千个 token 逐个算一遍,TTFT 约 326 毫秒。第二个请求的前缀和它完全相同,前缀缓存命中,这段 prefill 被整个跳过,TTFT 只有约 20 毫秒,差了 16 倍。具体的毫秒数和提示词长度、硬件强相关,但缓存命中后明显更快这个趋势是稳定的。

服务端这边也能直接观察到命中情况。vLLM 的日志会周期性打印前缀缓存命中率,刚才这两次请求对应的日志是:

(APIServer pid=176492) INFO 08-24 07:40:29 [loggers.py:310] Engine 000: Avg prompt throughput: 222.7 tokens/s, Avg generation throughput: 1.6 tokens/s, Running: 0 reqs, Waiting: 0 reqs, GPU KV cache usage: 0.0%, Prefix cache hit rate: 49.8%

第二个请求的公共前缀全部命中,第一次是 0%,两次平均下来正好在一半左右,日志里的 49.8% 和它对上了。在真实服务里,如果所有请求都挂同一段系统提示词,这个值会稳定在很高的水平。

前缀匹配是在 token 层面精确进行的。系统提示词差一个字符、聊天模板换一个版本,token 序列就变了,缓存全部失效。所以线上服务要保证前缀部分的内容和模板严格稳定。

KV Cache 量化

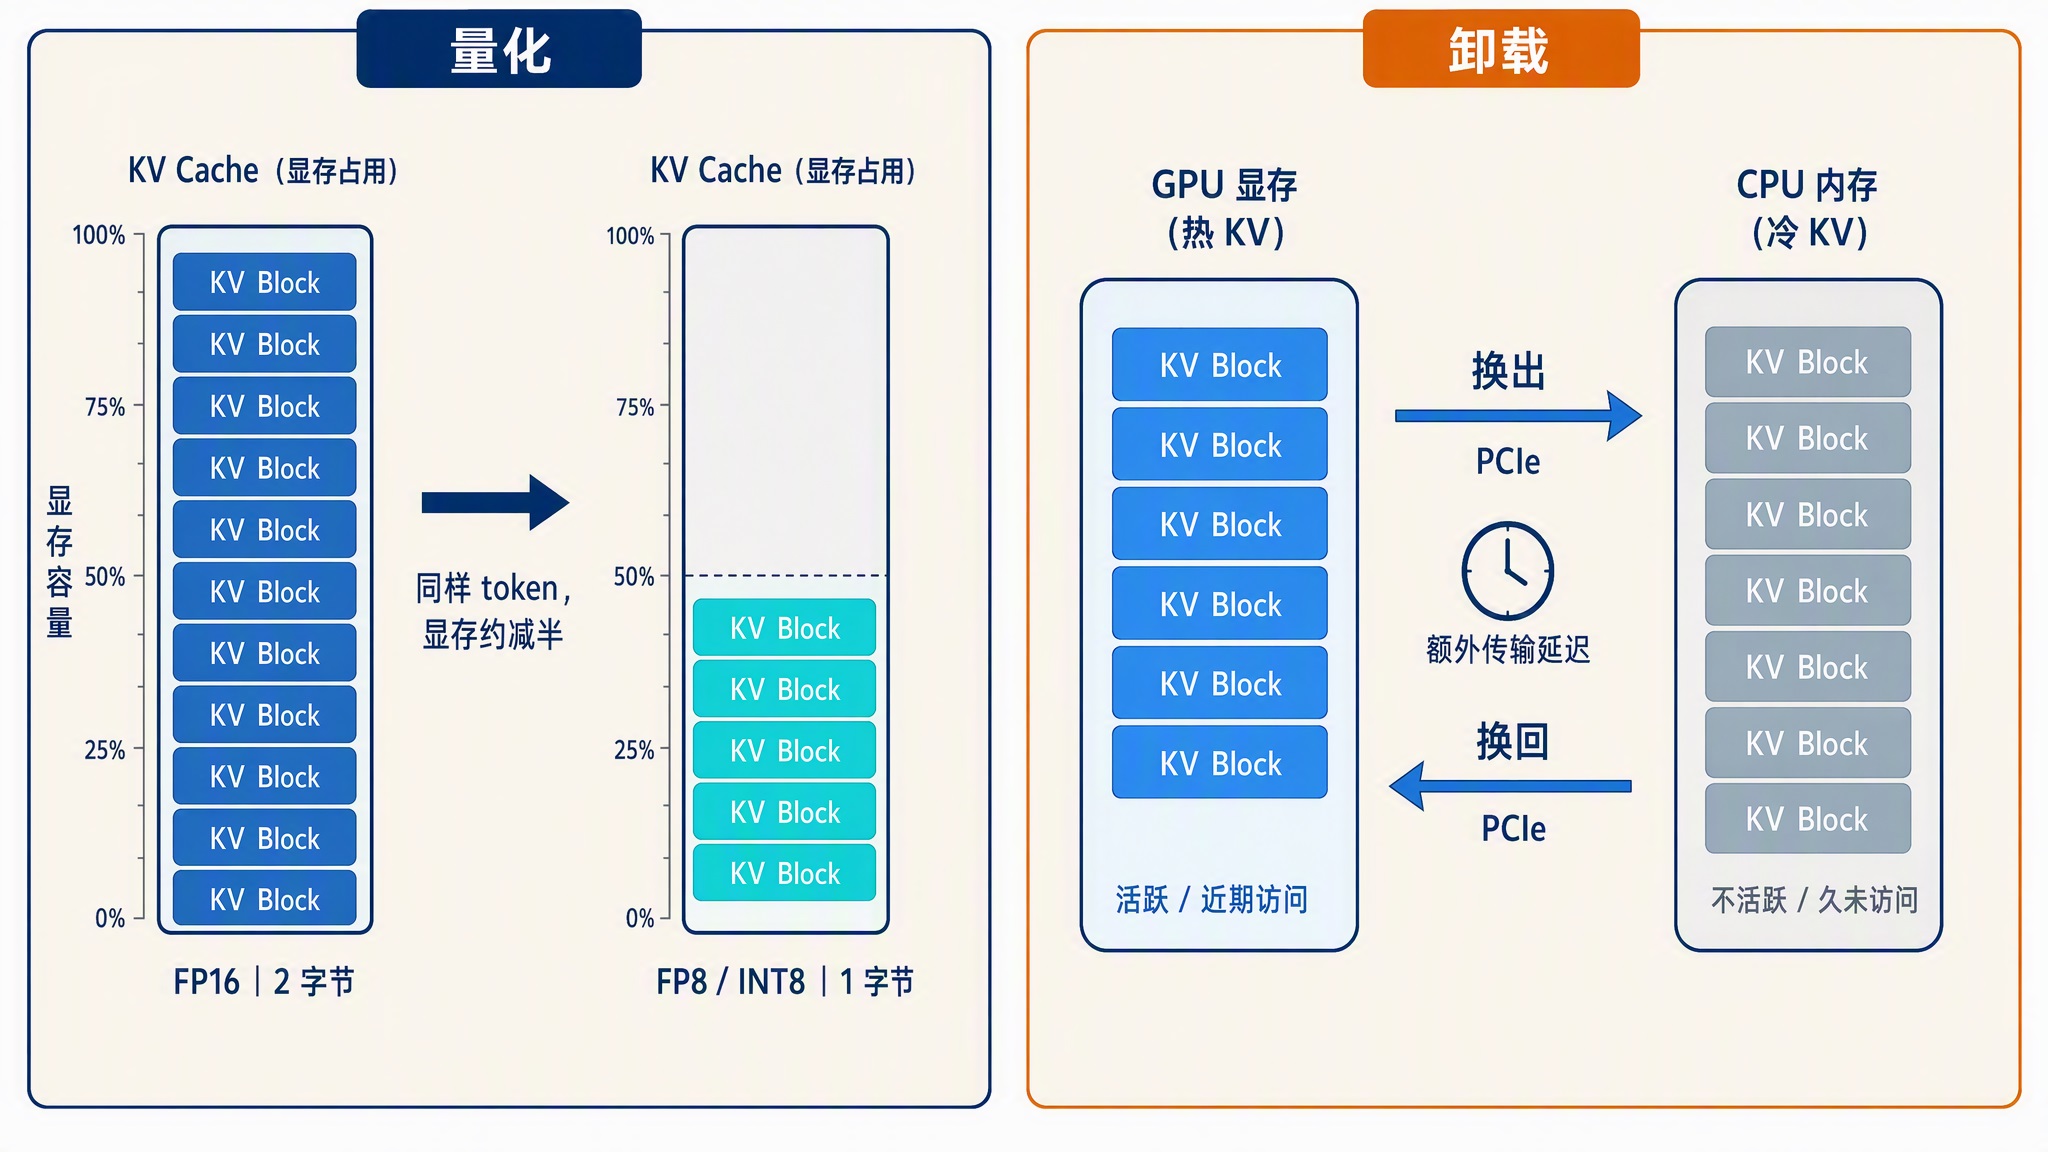
除了在分配方式上着手优化,还有一条更直接的路:让缓存里的每个元素占更小的空间。回看显存公式,最后一个因子是每元素字节数,FP16 是 2 字节。把它换成 FP8(8 位浮点) 或 INT8(8 位整型),每个元素只占 1 字节,KV Cache 直接减半,能容纳的并发或上下文长度近似翻倍。

vLLM 可以通过下面的参数开启:

$ vllm serve Qwen/Qwen3-0.6B --kv-cache-dtype fp8

用起来是一个参数的事,但 FP16 的数值压进 8 位,信息总有损失,损失多少取决于一个关键系数:scale(缩放系数)。FP8 能表示的数值范围很小(e4m3 格式最大只有 448),而 KV Cache 里的实际数值范围可能超出它,所以量化时需要一个缩放系数,把原始数值压缩进 FP8 的量程,读出来时再放大回去,这个系数就是 scale。scale 定得不准,要么数值超出量程被截断,要么量程没占满白白损失精度。

e4m3 是 FP8 的一种格式,名字就是它的结构:1 位符号、4 位指数(e)、3 位尾数(m)。指数位决定量程,4 位指数让它最大表示到 448;尾数位决定精度,3 位尾数意味着相对精度只能到 1/8 左右。FP8 还有一种 e5m2 格式,指数多一位、尾数少一位,量程更大但精度更粗,训练里存梯度用得多。推理场景的 KV Cache 量化一般用 e4m3,vLLM 的 fp8 选项默认就是它。

vLLM 默认的做法是不校准,所有 scale 直接设为 1.0,多数模型上效果够用。如果追求更稳的精度,官方推荐用 llm-compressor 做离线校准:拿几百条有代表性的数据过一遍模型,统计 K、V 激活值的实际分布,算出合适的 scale,保存成一个带 scale 的新模型目录,vLLM 加载时自动读取。它还支持更细的粒度,从逐张量一个 scale 细化到每个注意力头一个 scale(目前只有 Flash Attention 后端支持)。

scale 定准之后,剩下的问题是:8 位终究比 16 位少了一半信息,对生成质量的影响有多大?实践的结论是可控的。KV Cache 里的数值分布相对集中,8 位量化对生成质量的影响很小,这也是各家引擎都敢默认提供这个选项的原因。vLLM 官方博客 2026 年 4 月有一篇 FP8 KV Cache 的综述,梳理了当前的实现状态和适用场景,它给的默认策略是:长上下文、显存受限的场景直接从 FP8 起步,scale 不校准通常就够用,观察到持续性的精度下降再考虑校准。

不过 FP8 也不是在所有情况下都划算,博客里列了几种该留在 BF16(或部分留在 BF16)的情况:

  • 上下文很短(7k token 以内):FP8 每步有一笔固定开销,缓存变小的收益随长度线性增长,太短就抵不回来,这时 BF16 的 token 间隔反而略好
  • head_dim 为 256 的模型且在意 prefill 延迟:为了保证长上下文精度,FP8 注意力计算里用了两级累加,这笔开销在大头维度下会吃掉 FP8 的算力优势,长上下文时 TTFT 最高涨到 1.6 倍
  • 未校准精度持续下移:个别模型(比如用 FlashMLA 后端的 Kimi-K2.5)在 scale 取 1.0 时会出现系统性的精度下降,不是随机噪声,这时就该按前面说的用 llm-compressor 在目标数据上校准
  • 混合注意力模型的小滑窗层:滑动窗口层的缓存大小有界,固定开销摊不回来。这种情况不用放弃 FP8,加上 --kv-cache-dtype-skip-layers sliding_window,让滑窗层保持原精度、其余层量化即可

卸载到内存

如果分页、共享、量化全用上之后显存还是装不下,这时会怎么样呢?

默认情况下,vLLM 的调度器给请求分配不到新的 KV 块时,会抢占(Preemption)一部分在跑的请求来腾地方:从运行集的尾部开始踢,也就是最新加入、优先级最低的请求先被牺牲,它们的 KV 块被释放出来,其余请求继续跑。被踢的请求回到等待队列,等显存有了空位再重新调度上来。V1 引擎默认的抢占方式是重算(RECOMPUTE):被抢占的请求不留缓存,恢复时从 prefill 重新跑一遍。之所以敢直接丢,是因为被抢占请求的缓存是还没算完的半成品,保存价值不高,重算的开销比换出再换回更划算。服务日志里如果出现 preempted by PreemptionMode.RECOMPUTE 的警告,就说明显存开始紧张了,该考虑调大 gpu_memory_utilization,或者收紧上一篇讲的 max_num_seqs。

但不是所有块都适合一丢了之。前缀缓存里的块是算完的成品,后面还可能被其他请求反复用到,丢了下次就得整段 prefill 重算。对这类有复用价值的块,更省的办法是挪到 CPU 内存里存着,而不是直接丢掉,这就是卸载(Offload)。vLLM 现在有原生的 CPU 卸载,两个参数就能开:

$ vllm serve Qwen/Qwen3-0.6B --kv-offloading-size 64 --kv-offloading-backend native

kv-offloading-size 指定拿出多少 GiB 内存做卸载缓冲;kv-offloading-backend 默认 native,也可以换成 lmcache,也就是 LMCache 这类外部组件,它把卸载做成了完整的多级缓存,CPU 内存之后还能再接 NVMe 磁盘和远端存储。

LMCache 是一个开源的 KV Cache 管理层,以插件形式挂在 vLLM 这类推理引擎上,把 KV 块的存放从 GPU 显存扩展到 CPU 内存、本地磁盘甚至远端存储,还支持跨请求、跨引擎的缓存共享。可以把它理解成给推理引擎外挂的一套缓存中间件。

值得一提的是,卸载主要不是给单个请求扩上下文,而是给前缀缓存扩容。被挤出显存的块在内存里仍然挂着 hash,后续请求做前缀匹配时可以直接命中到内存里的块,省掉的是重算 prefill 的时间。代价是数据要走 PCIe(连接 CPU 和 GPU 的总线)来回搬运,命中内存里的块比命中显存慢,但比重算一遍 prefill 快得多,所以它适合当显存之后的第二级缓存,而不是主力手段。

最后把量化和卸载放在一起对比收尾:量化是把每个 KV 元素占用的字节数压小,卸载是把暂时不用的 KV 块搬到容量更大的 CPU 内存,一个省空间,一个扩空间。

kv-cache-quantization-offload.jpg

小结

今天这篇围绕 KV Cache 的显存管理,讲了三个层次的手段:

  1. 问题:推理显存里权重是固定的,KV Cache 是随负载动态增长的大头。朴素做法按最大长度预留连续显存,内部碎片、预留浪费、外部碎片加起来会浪费 60% 到 80%
  2. PagedAttention:vLLM 团队在 SOSP 2023 提出的方案,类比操作系统虚拟内存分页,把 KV Cache 切成固定大小的块,逻辑块经块表映射到不连续的物理块,按需分配,浪费降到 4% 以内
  3. 前缀缓存:分页让块可以跨请求共享,对块内容算 hash,系统提示词、多轮历史这类公共前缀命中后只存一份、只算一遍,省显存也省 TTFT。SGLang 的 RadixAttention 用基数树做了更细粒度的共享
  4. 量化与卸载:KV Cache 存 FP8/INT8 再省一半;显存实在不够时可以把不活跃的块挪到 CPU 内存

到这里,推理的显存问题就有了完整的答案:能省的地方省下来,能共享的地方共享出去,同一块显卡能服务的请求数翻了几倍。下一个问题自然就是速度了:每个请求本身还能不能跑得更快?下一篇我们就来看推理加速的三板斧,量化、投机解码和 PD 分离,欢迎继续关注。

参考


学习大模型推理的批处理:Continuous Batching

至此,我们把一次请求从进来到出去的整条链路都走了一遍:prompt 进来、分词、查 embedding、逐层 Transformer 前向、prefill 建 KV Cache、decode 逐 token 生成、最后 token 变回文字。

在这整条链路里,有不少技术细节和优化手段值得再深入学习,打算后面逐个展开。今天就从第一个话题开始:批处理(Batching)。

单请求跑推理有多浪费

第六篇讲过,prefill 和 decode 的瓶颈完全不同。prefill 一次性并行处理整段 prompt,是矩阵乘矩阵的大计算,GPU 的算力能吃得比较满。decode 不一样,每一步只处理一个新 token,本质上是矩阵乘向量,计算量很小,但每一步都要把全部模型权重和整条 KV Cache 从显存里读一遍。

衡量这种差异的指标就是第六篇介绍过的算术强度(Arithmetic Intensity):每从显存读一个字节,能做多少次浮点运算。算术强度高的任务是计算受限,瓶颈在算力;算术强度低的任务是带宽受限,瓶颈在显存带宽。decode 恰好是后者的极端情况:权重几个 GB 到几十 GB,每一步原样读一遍,只为算出区区一个 token。

结果就是,单请求跑 decode 时,GPU 的计算单元大部分时间在等数据。一张标称几百上千 TFLOPS 的卡,真正用上的算力只有很小一个零头。

decode-bandwidth-bound.jpg

补救的思路很直接:既然每一步都要把整个模型读一遍,那就让这一步同时给多条请求算。权重读一次,几十条请求一起用,算术强度按批大小成倍抬升。显存带宽花同样的时间,产出的 token 却多了几十倍。这就是批处理的动机:摊薄每一步读权重的成本。

静态批处理:整批同进同出

最容易想到的批法是静态批处理(Static Batching):攒够一批请求,拼成一个大 batch 一起送进 GPU,等批里所有请求都生成完,整批一起返回,然后再收下一批。

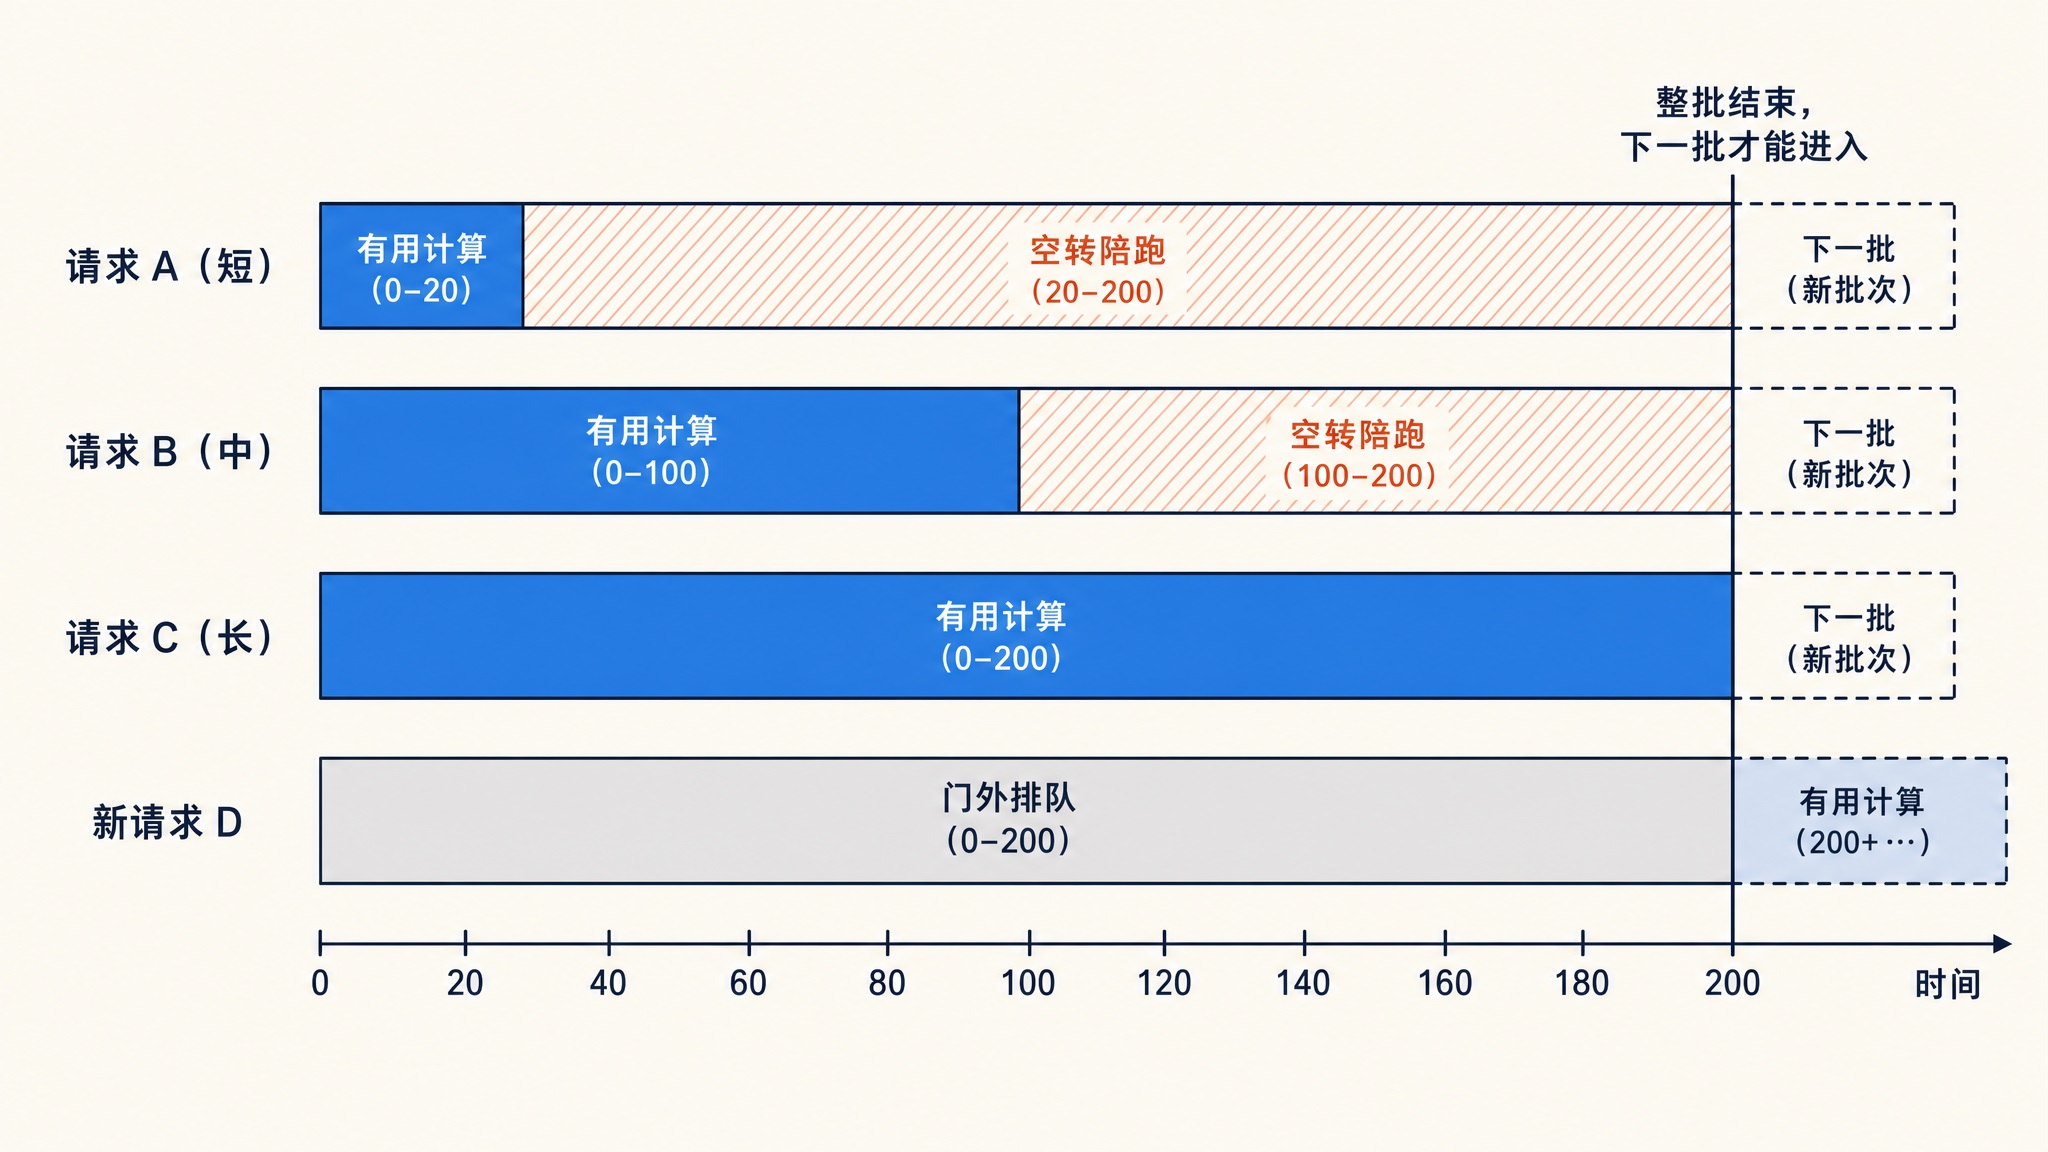
它的毛病是短板效应。同一批请求的生成长度差异很大,有的 20 个 token 就收尾,有的要 500 个。静态批处理里,短请求生成完之后并不能先走,它得占着批里的位置陪跑,直到最长的那条结束。陪跑期间,GPU 要么为它算无意义的前向,要么塞 pad token 占位,这部分算力纯属空转。新到的请求也只能在门外排队,等当前批彻底清空才能进。

用时间轴画出来是这样:

static-batching-timeline.jpg

红色部分是纯粹的浪费:请求 A 和 B 早就生成完了,却要陪请求 C 耗到第 200 步;请求 D 早就到了,却只能干等。批内长度差异越大,空转越严重。

用 Transformers 亲手感受一下

Hugging Face Transformers 的 generate 接口天然就是静态批处理,可以直接拿来体会短板效应。我们用 Qwen/Qwen3-0.6B 这种小模型,把三条长度要求不同的 prompt 拼成一批:

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, dtype="auto")

# 三条 prompt,预期的输出长度差异很大
prompts = [
    "用一句话介绍杭州。",
    "写一首关于秋天的五言绝句。",
    "详细解释为什么天空是蓝色的,不少于三百字。",
]

# 套对话模板,Qwen3 关掉思考模式,让回答尽快收尾
texts = [
    tokenizer.apply_chat_template(
        [{"role": "user", "content": p}],
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=False,
    )
    for p in prompts
]

# 批式生成要左填充,保证每条序列的最后一个位置就是新 token 的位置
tokenizer.padding_side = "left"
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
prompt_len = inputs["input_ids"].shape[1]

outputs = model.generate(**inputs, max_new_tokens=512, do_sample=False)

for i, out in enumerate(outputs):
    new_tokens = out[prompt_len:]
    n = int((new_tokens != tokenizer.pad_token_id).sum())
    print(f"请求 {i}: 有效生成 {n} 个 token")
    print(tokenizer.decode(new_tokens, skip_special_tokens=True))

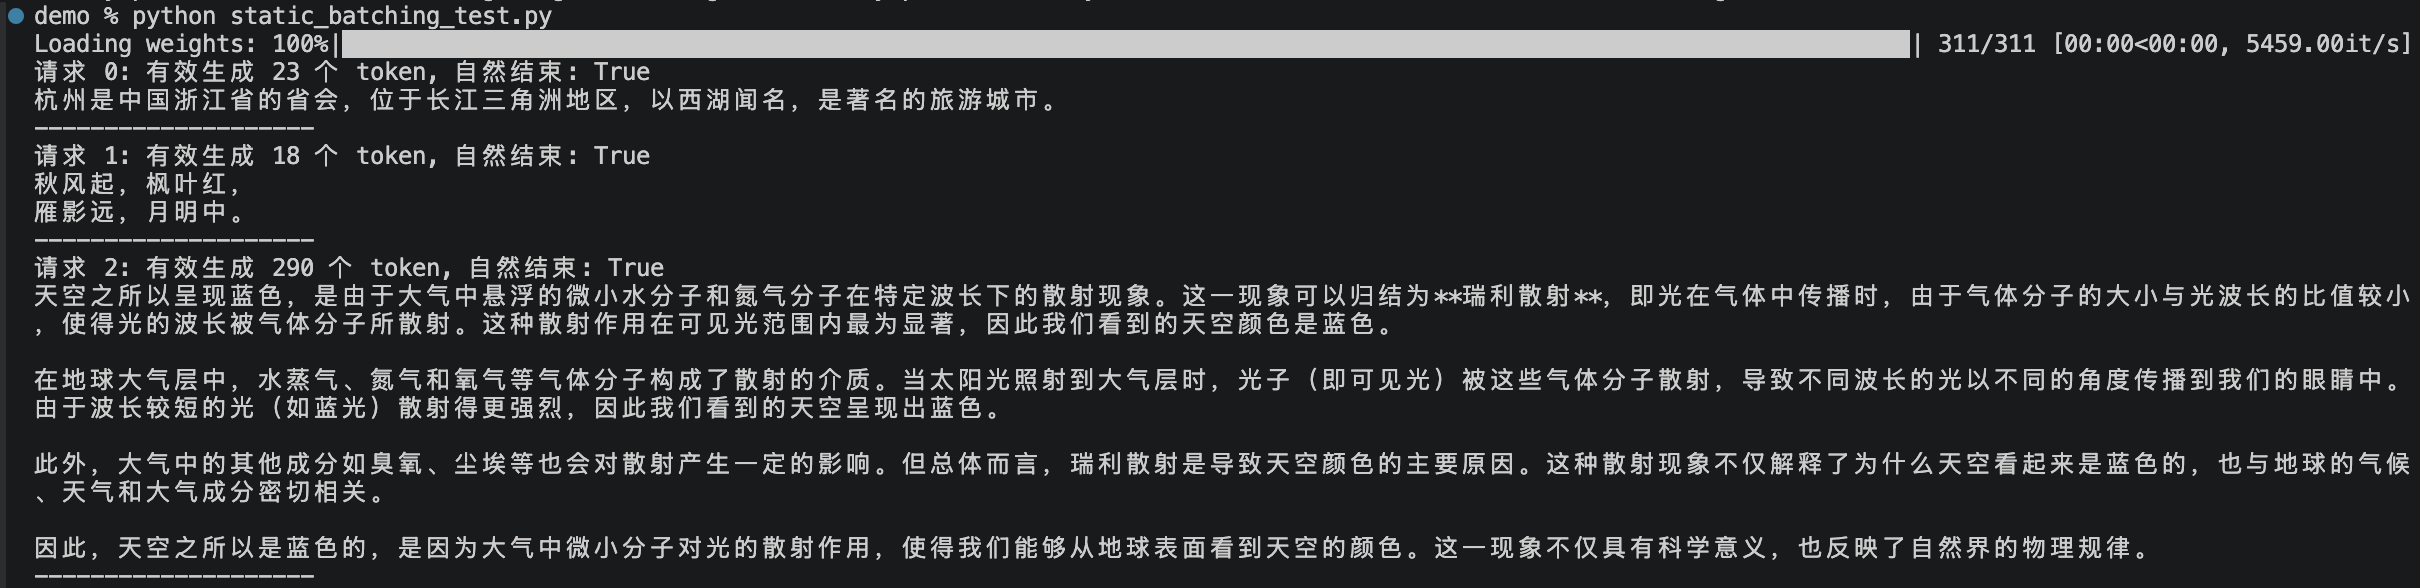
在我的 Mac 上跑出来的结果如下:

static-batching-generate-output.png

三条请求分别有效生成 23、18、290 个 token,最长和最短差了十几倍,但 generate 要等最长那条结束后才返回。短请求先撞上了 EOS,后面的位置只能拿 pad token 填满,这些位置的每一步前向都是白算的。

真正的推理服务要处理的是请求随到随走、量大利薄的场景,静态批处理的空转在生产上是接受不了的。

连续批处理:以步为单位调度

连续批处理(Continuous Batching) 把调度的粒度从整批缩小到了单步迭代。这个机制来自 ORCA 系统,由 FriendliAI 和首尔国立大学的团队提出,论文发表在 OSDI 2022,论文里的原名是迭代级调度(Iteration-level Scheduling)。

思路也很直观:每跑完一步 decode,调度器都重新决策一次。哪条请求生成了 EOS 或顶到长度上限,立刻移出、返回结果;等待队列里有新请求,且显存放得下,立刻补进运行集。批的组成每一步都在变,GPU 不需要等任何人。

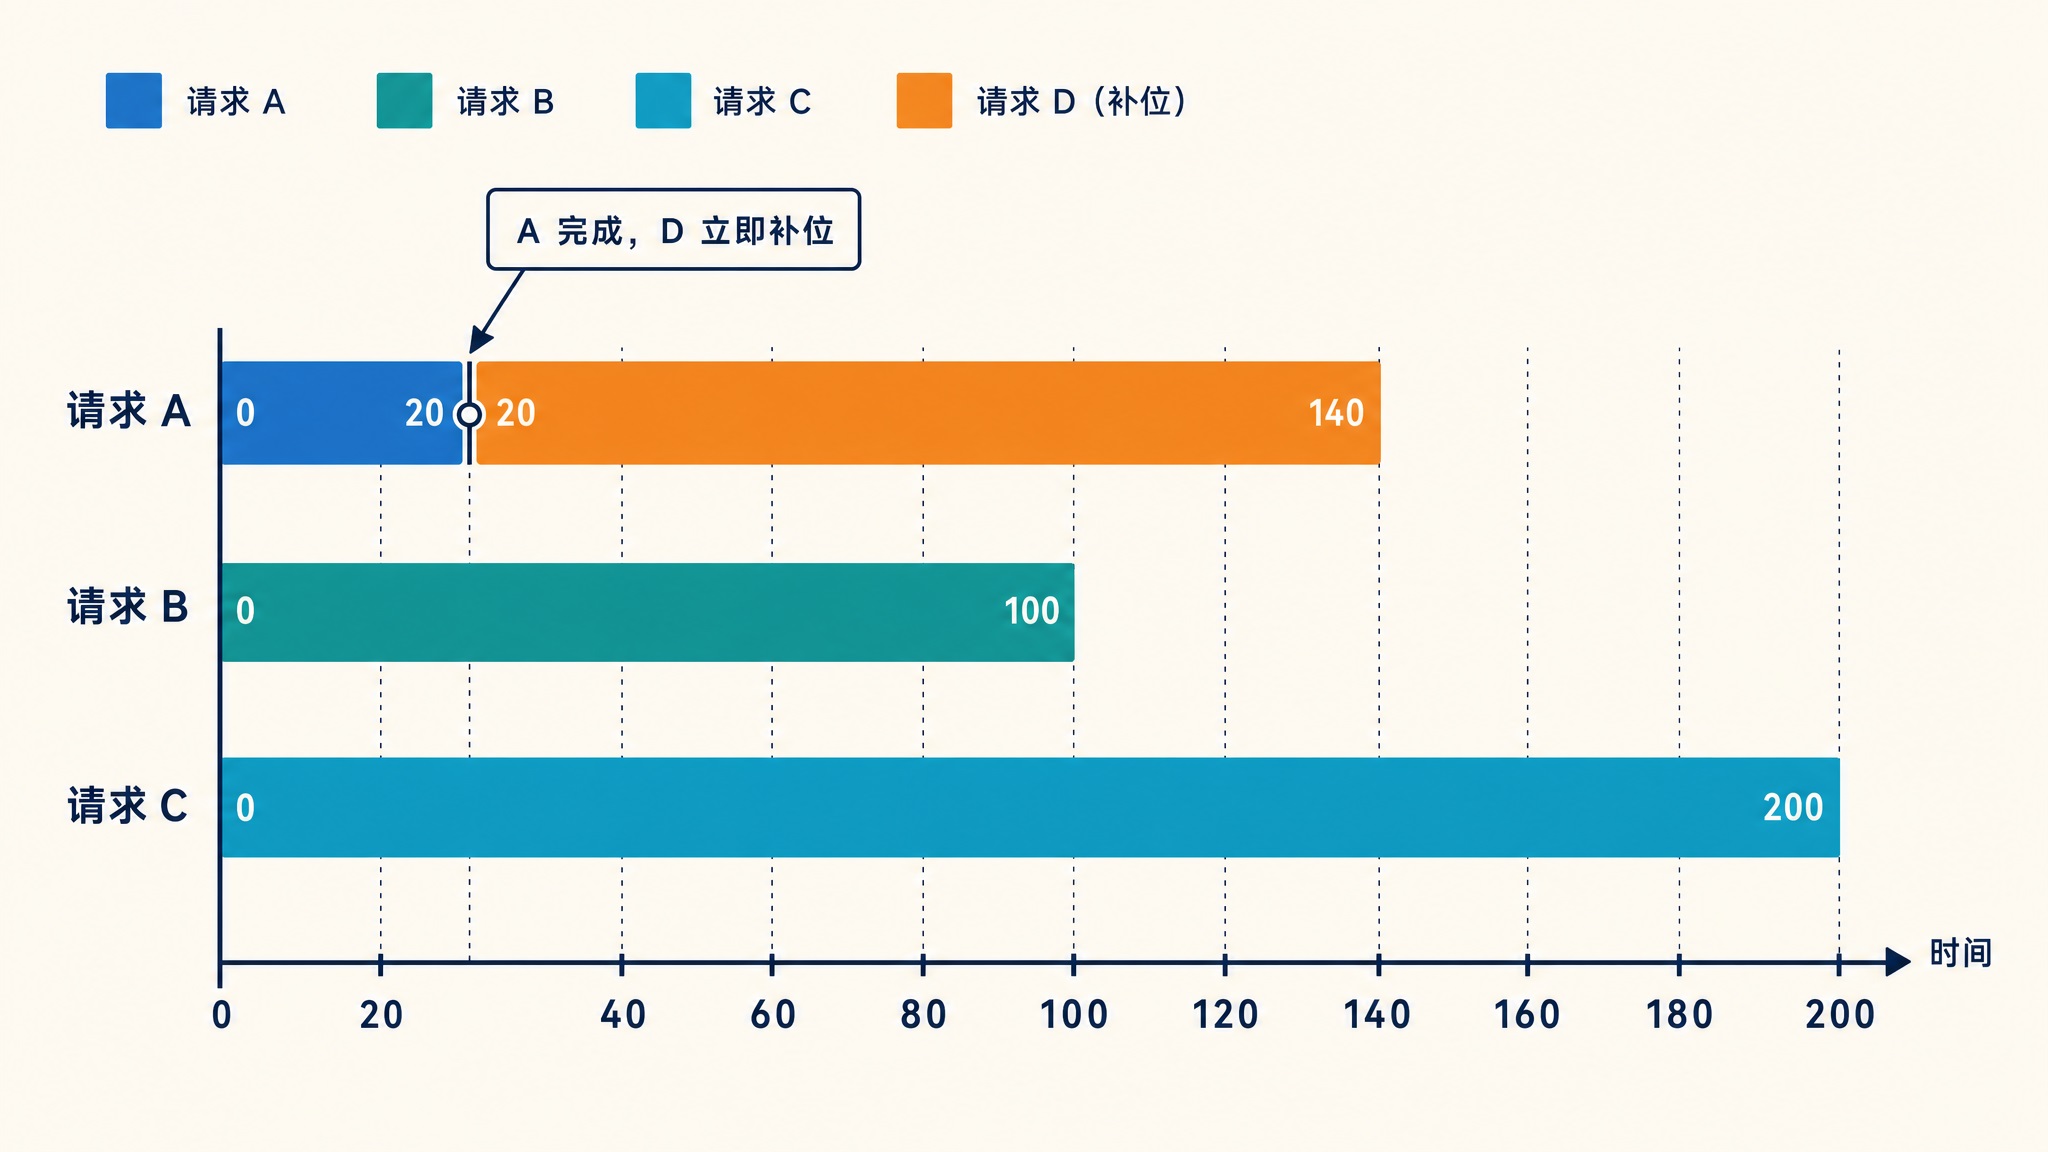
同样四条请求,换成连续批处理的时间轴:

continuous-batching-timeline.jpg

对比上一张图,空转区域整个消失了。请求 A 第 20 步结束,请求 D 第 21 步就顶上了它的位置。每条请求的实际生成时间没变,但同一台 GPU 在单位时间内服务的请求变多了。

调度器内部:两个队列

把调度器拆开看,它维护着两个队列:等待队列(waiting)装着已接收但还没开始计算的请求,运行集(running)装着正在逐 token 生成的请求。每跑一步迭代,调度器做三件事:

  1. 组批:先遍历运行集,给每条在跑的请求分配这一步的 KV 块和 token 预算;预算还有富余,再从等待队列按顺序取请求补进来
  2. 执行:拼好的批送进 GPU 跑一步前向,每条请求各产出一个新 token
  3. 结算:检查每条请求新产出的 token,撞上 EOS 或长度上限的标记完成、释放资源、把结果推给客户端;空出的位置下一步组批时从等待队列补进来

等待队列默认是先来先服务(FCFS),vLLM 也支持优先级调度:启动时加 --scheduling-policy priority,数值越小的请求越先被处理。

效果有多大

ORCA 论文给过一组对比数据:在 GPT-3 175B 的分布式服务实验上,相同延迟目标下,ORCA 的吞吐是 NVIDIA FasterTransformer 的 36.9 倍。具体的数字是,在每 token 190 ms 的延迟目标下,FasterTransformer 每秒只能处理 0.185 个请求,ORCA 能处理 6.81 个。

要注意这个数字是和特定 baseline 在特定设置下的对比,不是说换个场景也快 36 倍。但它足以说明仅仅把调度粒度从请求级降到迭代级,吞吐就能拉开数量级的差距。

ORCA 论文里还有第二个机制叫选择性批处理(Selective Batching):注意力计算依赖各请求独立的 KV Cache,不适合整批合并,就按请求分开算;其余的线性层和归一化可以整批合并。这个细节就不展开了,感兴趣的同学可以读下原始的论文。

如今已是行业标配

迭代级调度现在是所有主流推理引擎的基本功,叫法也基本统一成了 continuous batching,只有个别例外:

引擎叫法
vLLMcontinuous batching
SGLangcontinuous batching
Hugging Face TGIcontinuous batching
llama.cppcontinuous batching
TensorRT-LLMin-flight batching
LMDeploypersistent batching

TensorRT-LLM 把它叫做 in-flight batching,LMDeploy 叫做 persistent batching,本质上都是 ORCA 那套迭代级调度。读这些框架的文档时遇到不同的名字,注意一下就好。

调度器调优

连续批处理让请求在批里随到随入、随完随出,不用等别人。但批也不能无限膨胀,总得有个边界。以 vLLM 为例,调度器最重要的两个参数是:

  • max_num_seqs:单步迭代里最多同时跑多少条请求。它限制的是批的条数上限
  • max_num_batched_tokens:单步迭代里最多处理多少个 token,所有请求加起来算。它限制的是批的 token 总量上限

启动服务时可以显式指定:

$ vllm serve Qwen/Qwen3-0.6B \
    --max-num-seqs 256 \
    --max-num-batched-tokens 8192

这两个参数共同决定了每一步喂给 GPU 的工作量,调大它们的影响如下:

  • max_num_seqs 调大:吞吐更高,权重读取摊得更薄;但单请求延迟更差,单步更慢,排队更久
  • max_num_batched_tokens 调大:吞吐更高,长 prompt 的 prefill 更快进完;TTFT 变好,但 decode 的 token 间隔可能变差

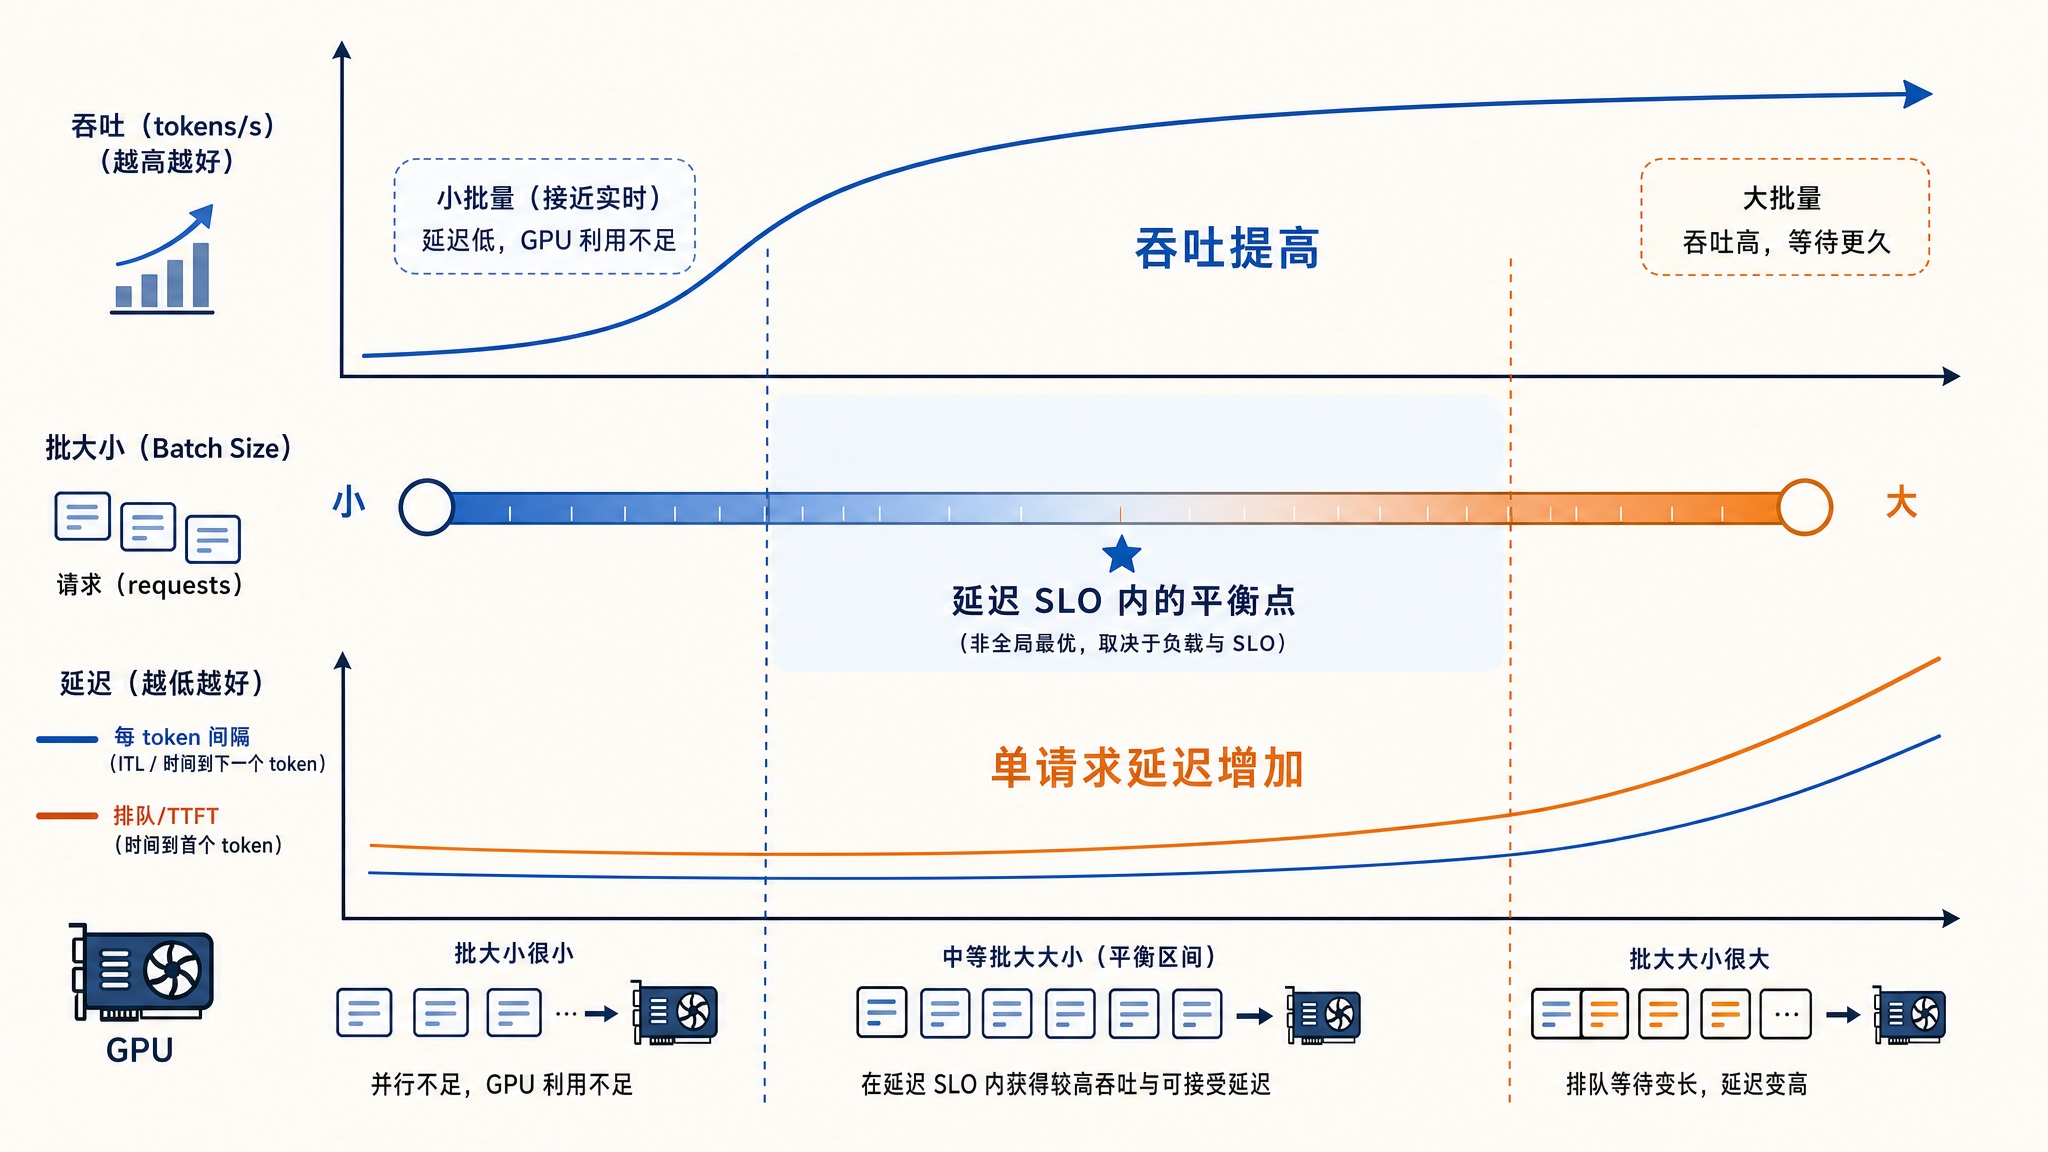
可以看到,无论是 max_num_seqs 还是 max_num_batched_tokens,它们提升的都是吞吐,不是单请求的速度。天下没有免费的午餐,吞吐与延迟不可兼得。批越大,每一步要算的 token 越多,单步耗时越长,每条请求的 token 间隔就越差;请求多了还要排队,TTFT 也会变长。批越小越接近单请求的延迟水平,但吞吐又回去了。

所以推理服务的调优目标从来不是把批开到最大,而是在 SLO(Service Level Objective,服务水平目标) 允许的范围内把吞吐做高。SLO 就是服务给延迟定下的承诺线,比如 TTFT 不超过 2 秒、token 间隔不超过 100 毫秒,批的大小就以不越过这条线为限。

throughput-latency-tradeoff.jpg

分块预填充

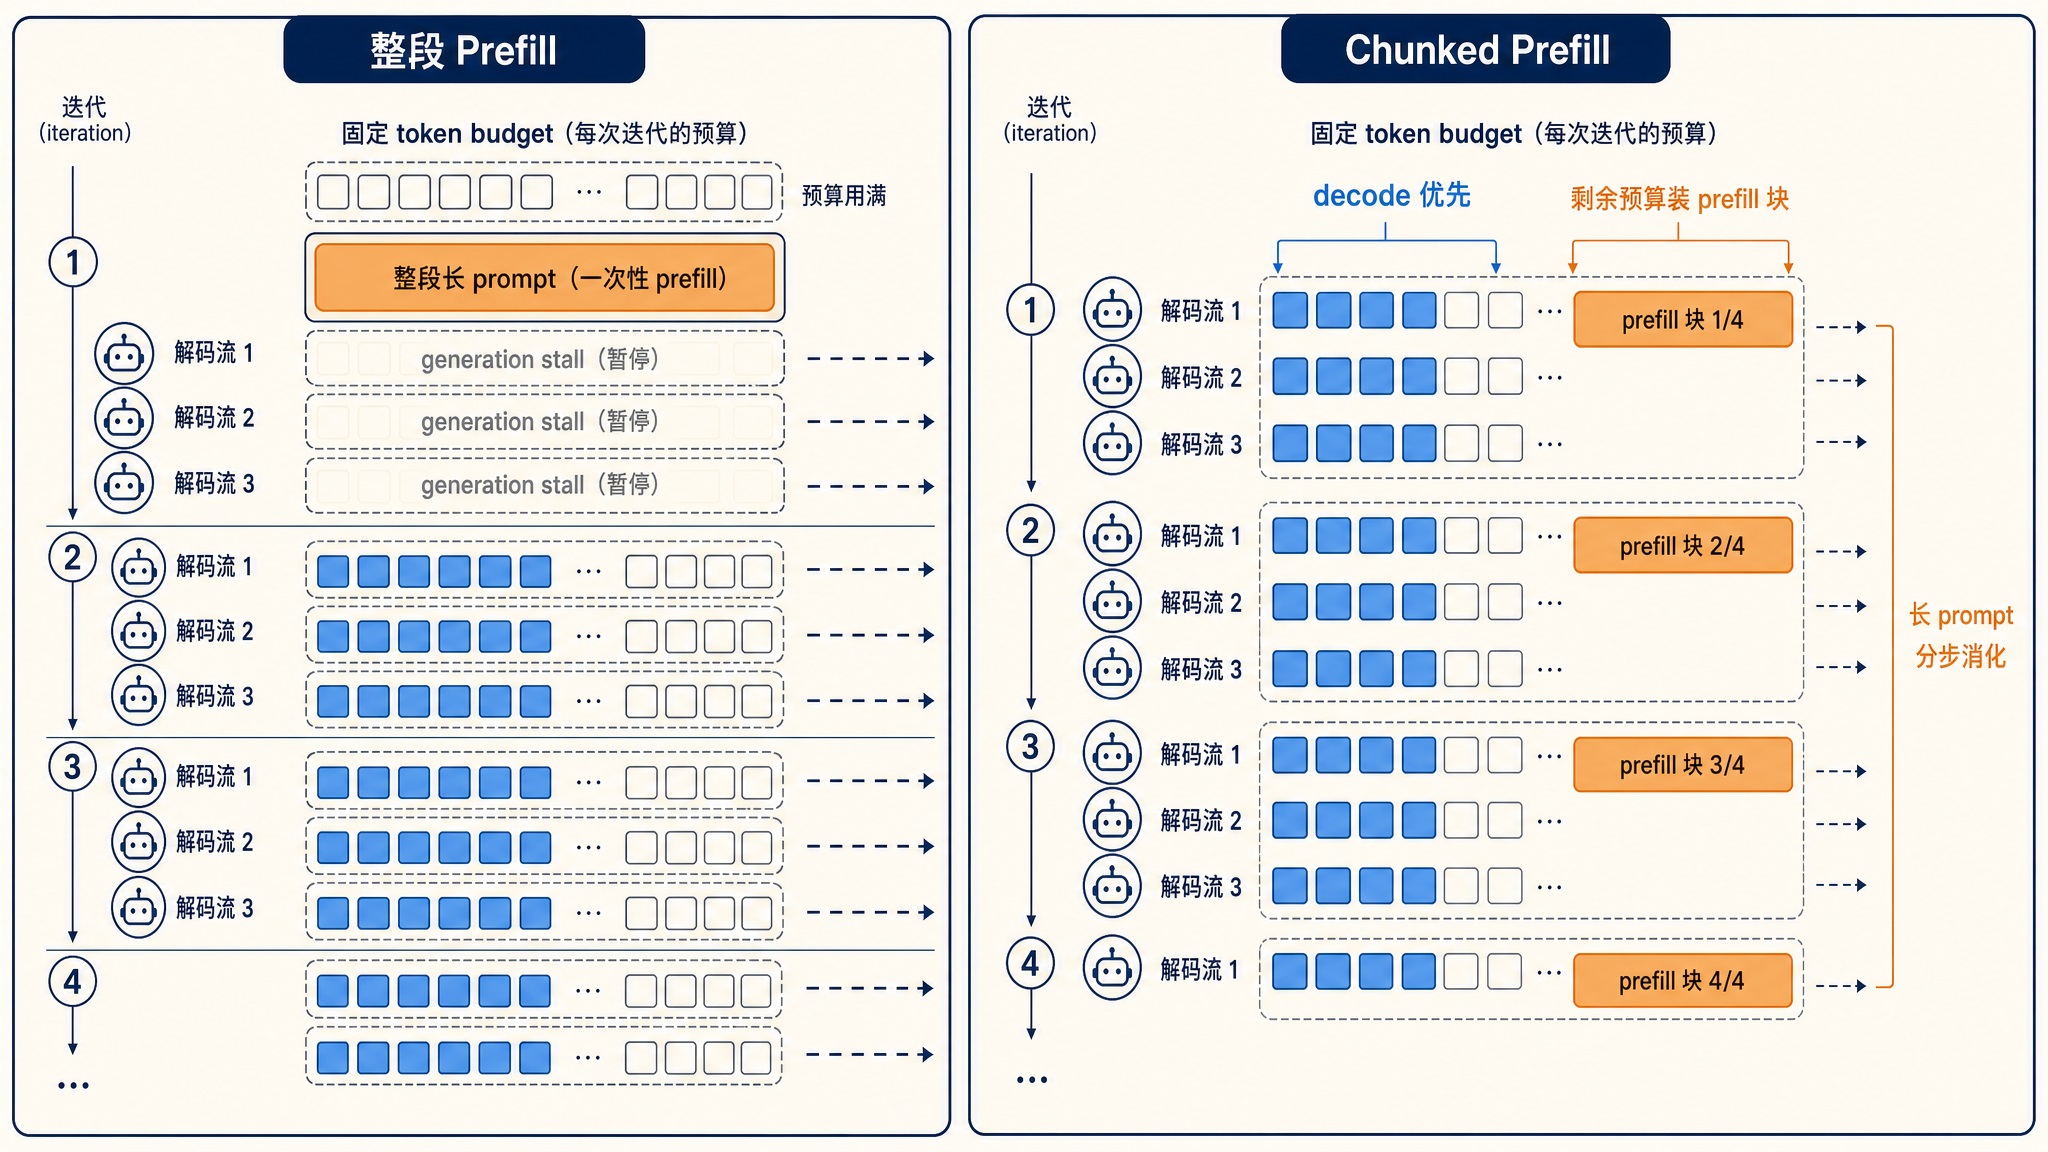
连续批处理解决了 decode 阶段的空转,但 prefill 和 decode 混在同一台引擎里还有一个问题。一条几千 token 的长 prompt 做 prefill 要跑一个大步,这期间整批的 decode 都被拖住,用户会看到输出突然卡住一拍,这个现象叫 generation stall(生成停顿)。

Sarathi-Serve(OSDI 2024)的解法是分块预填充(Chunked Prefill),它由两个配合的机制组成。第一是把长 prefill 切成近似等大的块,分几步迭代消化完,而不是一步跑完。第二是无停顿调度(Stall-free Scheduling):每一步迭代组批时,调度器先装进运行集里所有请求的 decode token,再用剩余预算塞入未完成 prefill 的下一块,预算还有富余才考虑新请求。每一步的 token 总量都不超过预算上限,这个预算正是上一节讲的 max_num_batched_tokens。

为什么 decode 和 prefill 块混在一起算不会互相拖累?答案还在算术强度上。decode 是访存密集型,一步只算几十个 token,算力大量闲置;prefill 是计算密集型,正好补上闲置的算力。论文里有个直观的数字:在线性层上,1 个 decode token 的执行时间约等于 128 个 prefill token。也就是说,往 decode 批里捎带几百个 prefill token,这一步的耗时几乎不变。论文把这个机制叫做 piggyback(捎带):prefill 块搭 decode 迭代的便车,两块负载各取所需,GPU 的算力和带宽利用率同时被推高。

切块也不是没有代价。prefill 被切成 N 块之后,后面每一块做注意力时都要把前面块的 KV Cache 重读一遍,块切得越碎,重读越多。论文测过,块大小取 512 时 prefill 的额外开销最高约 25%,取 2048 时基本可以忽略。另外块大小最好对齐 GPU kernel 的分块尺寸,论文里有个极端例子:257 个 token 的块比 256 的慢 32%,就因为多出的 1 个 token 多占了一个分块。预算的具体取值按延迟目标来定:SLO 卡得严就用小预算,放得宽就用大预算。

两个机制单独用都有短板,组合起来才完整。论文在 Yi-34B 上做过消融对比(TTFT 是首 token 延迟,TBT 是相邻 token 间隔,和前面讲的 ITL 是同一类指标):

方案P50 TTFTP99 TBT
只混排不切块0.53 s0.68 s
只切块不混排1.04 s0.17 s
两者结合(Sarathi-Serve)0.76 s0.14 s

只混排不切块,TBT 尾延迟被长 prefill 顶得很高;只切块不混排,prefill 块要排队等 decode 批结束,TTFT 又变差。两者结合,两个指标同时压到最低。在满足尾延迟约束的前提下,论文报告的服务能力提升是 2.6 到 5.6 倍(覆盖 Mistral-7B 到 Falcon-180B 的不同配置)。vLLM 的 V1 引擎已经默认开启分块预填充,今天自己起服务的话,这套机制开箱即用。

chunked-prefill-prevents-stall.jpg

小结

今天我们站在服务的视角,把批处理这件事从头到尾理了一遍:

  1. 为什么需要批处理:decode 阶段是带宽受限,单请求跑推理时 GPU 算力大量闲置;批处理让每一步读的权重被多条请求摊薄,算术强度成倍抬升
  2. 静态批处理的短板:整批同进同出,短请求陪跑、新请求排队,生成长度差异越大空转越严重;Transformers 的 generate 使用的就是静态批处理
  3. 连续批处理:来自 ORCA 的迭代级调度,调度器维护 waiting 和 running 两个队列,每步重组批,完成的请求立刻移出、新请求立刻补入;论文里相对 FasterTransformer 有数量级的吞吐提升,已经是如今主流推理引擎的标配
  4. 两个关键参数:max_num_seqs 管批的条数,max_num_batched_tokens 管单步的 token 总量,两者共同平衡吞吐与延迟
  5. 分块预填充:把长 prefill 切块,搭 decode 迭代的便车混排执行,两类负载在算术强度上互补,TTFT 和 TBT 两个指标同时改善;代价是切块带来的 KV Cache 重读开销,块大小按延迟目标来选

不过批开得越大,新的瓶颈也跟着来了:每条并发请求都要占一份 KV Cache,显存会先一步撑不住。怎么把这块显存省下来、管起来,就是 PagedAttention 和前缀缓存要回答的问题,我们下一篇就来看看。

参考


学习大模型推理的输出阶段:从 Token 回到文本

在上一篇中,我们学习了大模型推理的采样策略:decode 的每一步,模型输出的是词表上的一组 logits,经过 softmax、温度和 top-p 这些加工之后,从中选出下一个 token。

但 token 选出来,旅程还没有结束。模型眼里只有一串 token id,用户屏幕上看到的却是逐字跳出来的文字。从 token id 到用户眼前的文字,中间还有三道工序:判断生成何时停止、把 token id 还原成文本、把文本流式地推送给用户。这就是一次请求的「最后一公里」,也是今天的主角。

token-to-text-last-mile.png

生成何时停止

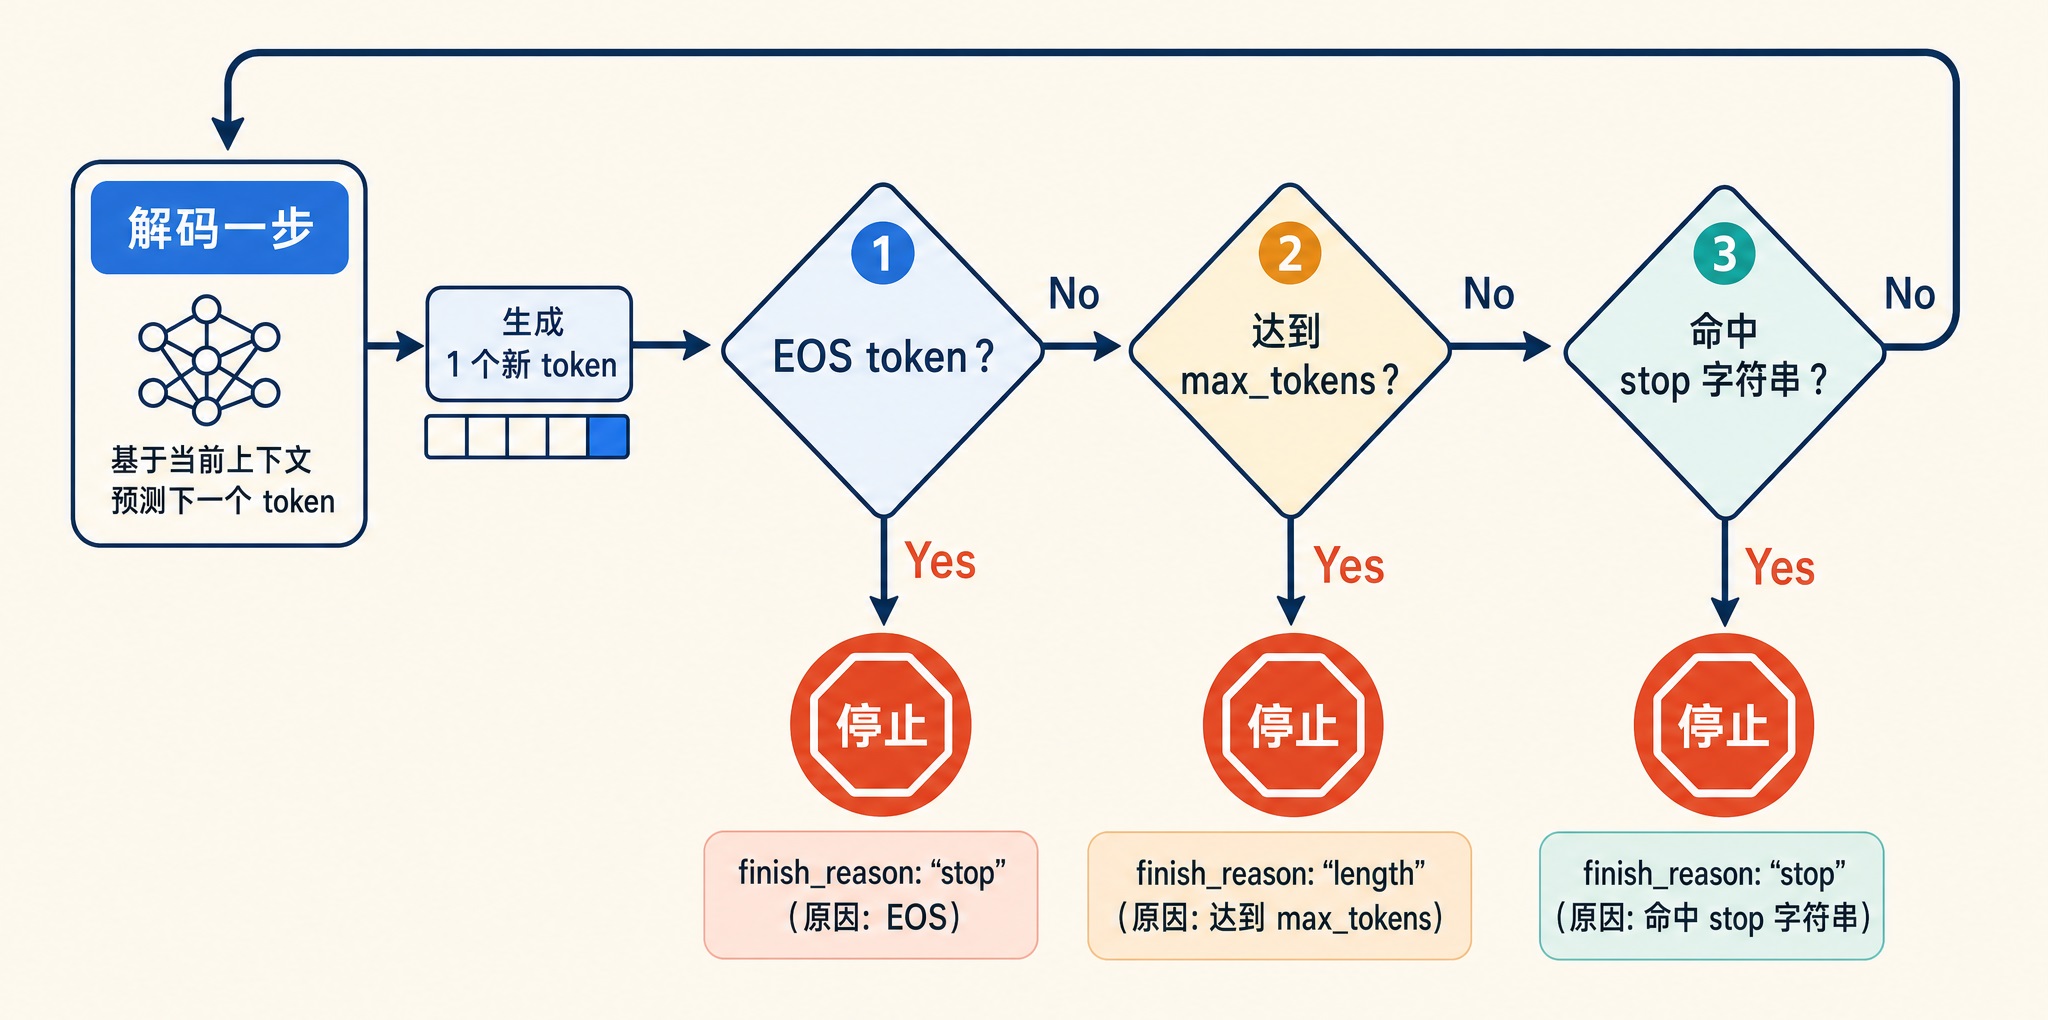
decode 循环每跑一步就多一个 token,那它什么时候停下来?常见的停止条件有三个:

  1. 遇到 EOS token:EOS 是 End of Sequence 的缩写,即序列结束标记,是词表里的一个特殊 token。对话模型在训练时就学会了在回答结束的位置输出它,比如 Qwen3 系列用的是 <|im_end|>。这是最常见的正常结束方式
  2. 达到 max_tokens 上限:调用方设置的生成长度天花板,到顶就强制掐断,防止模型无限生成烧光预算
  3. 命中 stop 字符串:调用方可以传一组自定义停止词,生成的文本里一旦出现其中任何一个就停。比如做代码补全时常把 \n\n 设为停止词,让模型写完一段就收手

这三个条件在每一步 decode 之后都会被检查一次,任何一个命中,循环就结束:

generation-stop-conditions.jpg

用户侧怎么知道这次生成是正常说完的,还是被掐断的呢?OpenAI 兼容接口用 finish_reason 字段回答这个问题,常见的取值有:

finish_reason含义对应的停止条件
stop正常结束遇到 EOS 或命中 stop 字符串
length长度截断达到 max_tokens 或上下文上限
content_filter内容审核拦截输出触发了服务商的内容过滤
tool_calls工具调用模型决定调用一个工具而非继续写文本

在写客户端代码时,可以特别注意下这个字段。看到 length 就意味着回答是被截断的、不完整,要么调大 max_tokens 重试,要么做续写处理;把它当成正常结束直接展示给用户,就会看到半句话。

反分词:token id 变回文本

生成停止后(以及生成过程中的每一步),我们手里拿到的是一串 token id,比如 [9707, 11, 1879, 330, 151643]。把它们映射回文本的过程叫 反分词(Detokenization),是分词的逆操作:查词表把每个 id 换回对应的片段,再拼接起来。

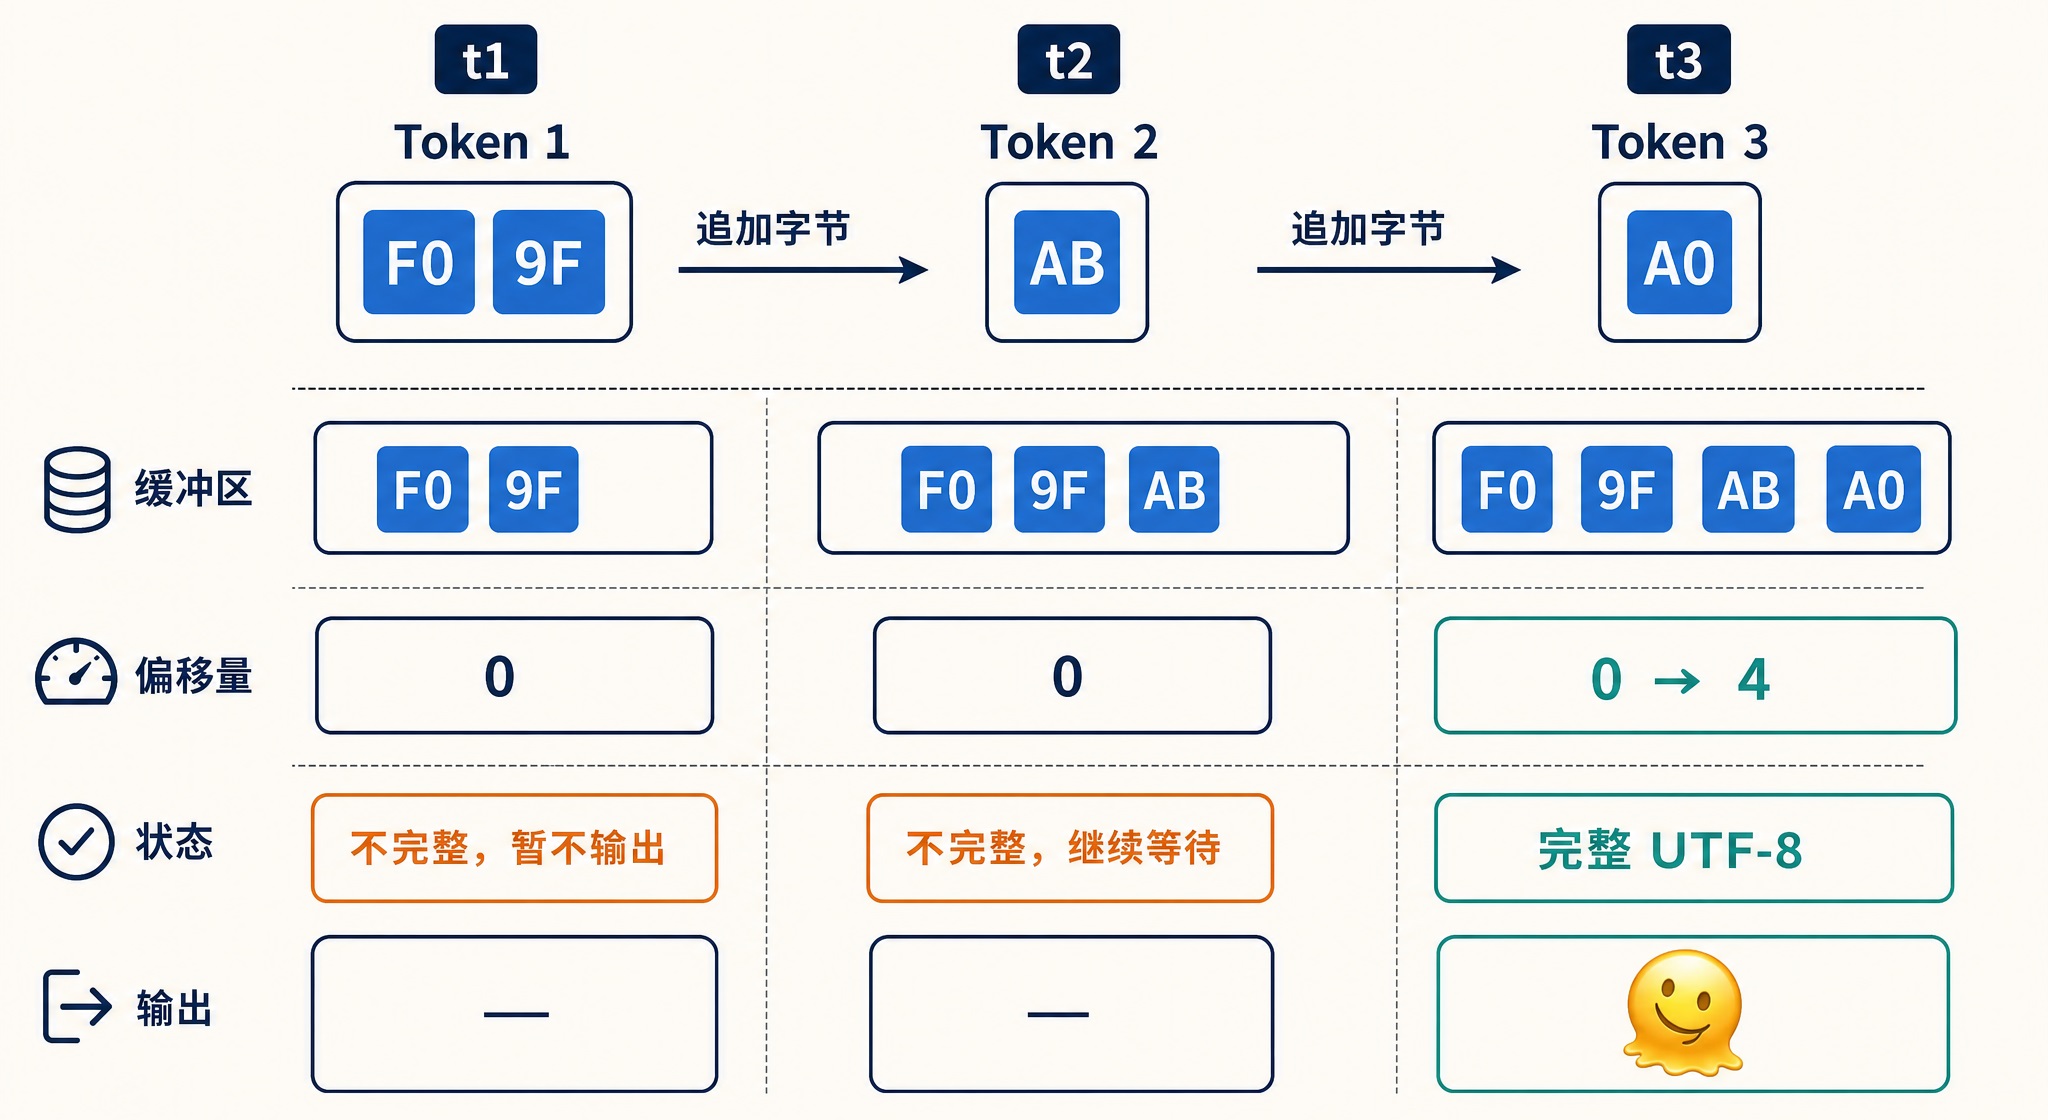
听起来只是查表拼接,但实际工程里没那么简单。第二篇讲分词时提过,今天的主流模型大多用字节级 BPE,词表建在字节上而不是字符上。而 UTF-8 编码里,一个汉字占 3 个字节,一个 emoji 通常占 4 个字节。如果一个字符的多个字节被切分到了不同的 token 里,那么逐 token 做 decode 时,单个 token 里装的就只是某个字符的一半字节,根本不是一个合法的 UTF-8 序列。

不完整的字节序列在解码时会被替换成 U+FFFD 替换字符(Replacement Character),也就是那个菱形问号的乱码符号。我们用 Python 做个实验,感受一下这个问题:

data = "🚀".encode("utf-8")  # 4 个字节: b'\xf0\x9f\x9a\x80'

# 假设分词器把这 4 个字节切成了两个 token,各拿 2 个字节
part1, part2 = data[:2], data[2:]

print(part1.decode("utf-8", errors="replace"))  # '�' 半个字符,变成替换符
print(part2.decode("utf-8", errors="replace"))  # '��' 两个落单的字节,两个替换符

# 把字节凑齐再解码,就正常了
print((part1 + part2).decode("utf-8"))  # '🚀'

细心的读者可能会好奇,为什么前一半只产生 1 个替换符,后一半却产生了 2 个?这是由 UTF-8 的字节结构决定。UTF-8 用首字节的高位比特宣告这个字符一共占几个字节:二进制 110 开头的是 2 字节字符(首字节范围 C2 到 DF),1110 开头的是 3 字节(E0 到 EF),11110 开头的是 4 字节(F0 到 F4),延续字节则一律以 10 开头(80 到 BF)。

字符长度首字节二进制前缀首字节范围例子
1 字节(ASCII)0xxxxxxx00–7FA = 41
2 字节110xxxxxC2–DFé = C3 A9
3 字节1110xxxxE0–EF中 = E4 B8 AD
4 字节11110xxxF0–F4🚀 = F0 9F 9A 80

解码器读到 F0 9F,认出这是一个 4 字节序列的开头加一个合法的延续字节,只是序列被截断了,于是把这半个序列当作一个非法单元,整体替换成 1 个替换符。而 9A 和 80 都是延续字节,延续字节不能独立存在,前面没有首字节领着,每个都是单独的非法字节,所以各得 1 个替换符。

可以看到,同一个字符,按 token 边界切开 decode 就是乱码,凑齐字节再 decode 才是原文。用真实的分词器也能复现这个现象,比如拿 Qwen3 的分词器处理一个 emoji:

from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")

text = "🫠"  # 一个 4 字节的 emoji,UTF-8 编码为 F0 9F AB A0
ids = tokenizer(text)["input_ids"]
print(ids)

# 逐个 token 单独 decode,不含完整字符的 token 会显示成替换符
for i in ids:
    print(repr(tokenizer.decode([i])))

# 整段一起 decode 则完全正常
print(tokenizer.decode(ids))

运行结果如下:

[9284, 104, 254]
'�'
'�'
'�'
🫠

可以看到,一个 emoji 被切成了 3 个 token,每个 token 只装着这个字符的一部分字节,单独 decode 全是替换符;拼在一起 decode 才是原文。

utf8-token-boundaries.png

增量反分词

在流式场景下,服务端每生成一个 token 就想推给用户,如果等整段生成完再 decode 就失去流式的意义了。所以工程上引入了一种做法叫 增量反分词(Incremental Detokenization),思路很朴素:反分词器内部维护一个字节缓冲区,每来一个 token 就把它的字节追加进去,然后尽量解码;遇到末尾不完整的字节就先留在缓冲区里不输出,等后续 token 把字节凑齐了再一起吐出来。

incremental-detokenization.jpg

这个看似简单的缓冲机制,细节其实不少,比如解码偏移量怎么维护、清理空格时要看前后 token。COLM 2025 上有一篇论文 UTF-8 Plumbing 形式化证明了字节级分词器从根本上无法避免生成不合法的 UTF-8 序列,这也是增量反分词必须处理不完整字节的原因。

反分词这一步虽然不起眼,但它是流式体验正确的保证。用户之所以能看到文字丝滑地逐字跳出而不是乱码闪烁,靠的就是这层缓冲。

流式输出与 SSE

反分词解决了怎么正确地切文本,接下来的问题是怎么把文本送出去,主流做法是 流式输出(Streaming):生成一点、发送一点。

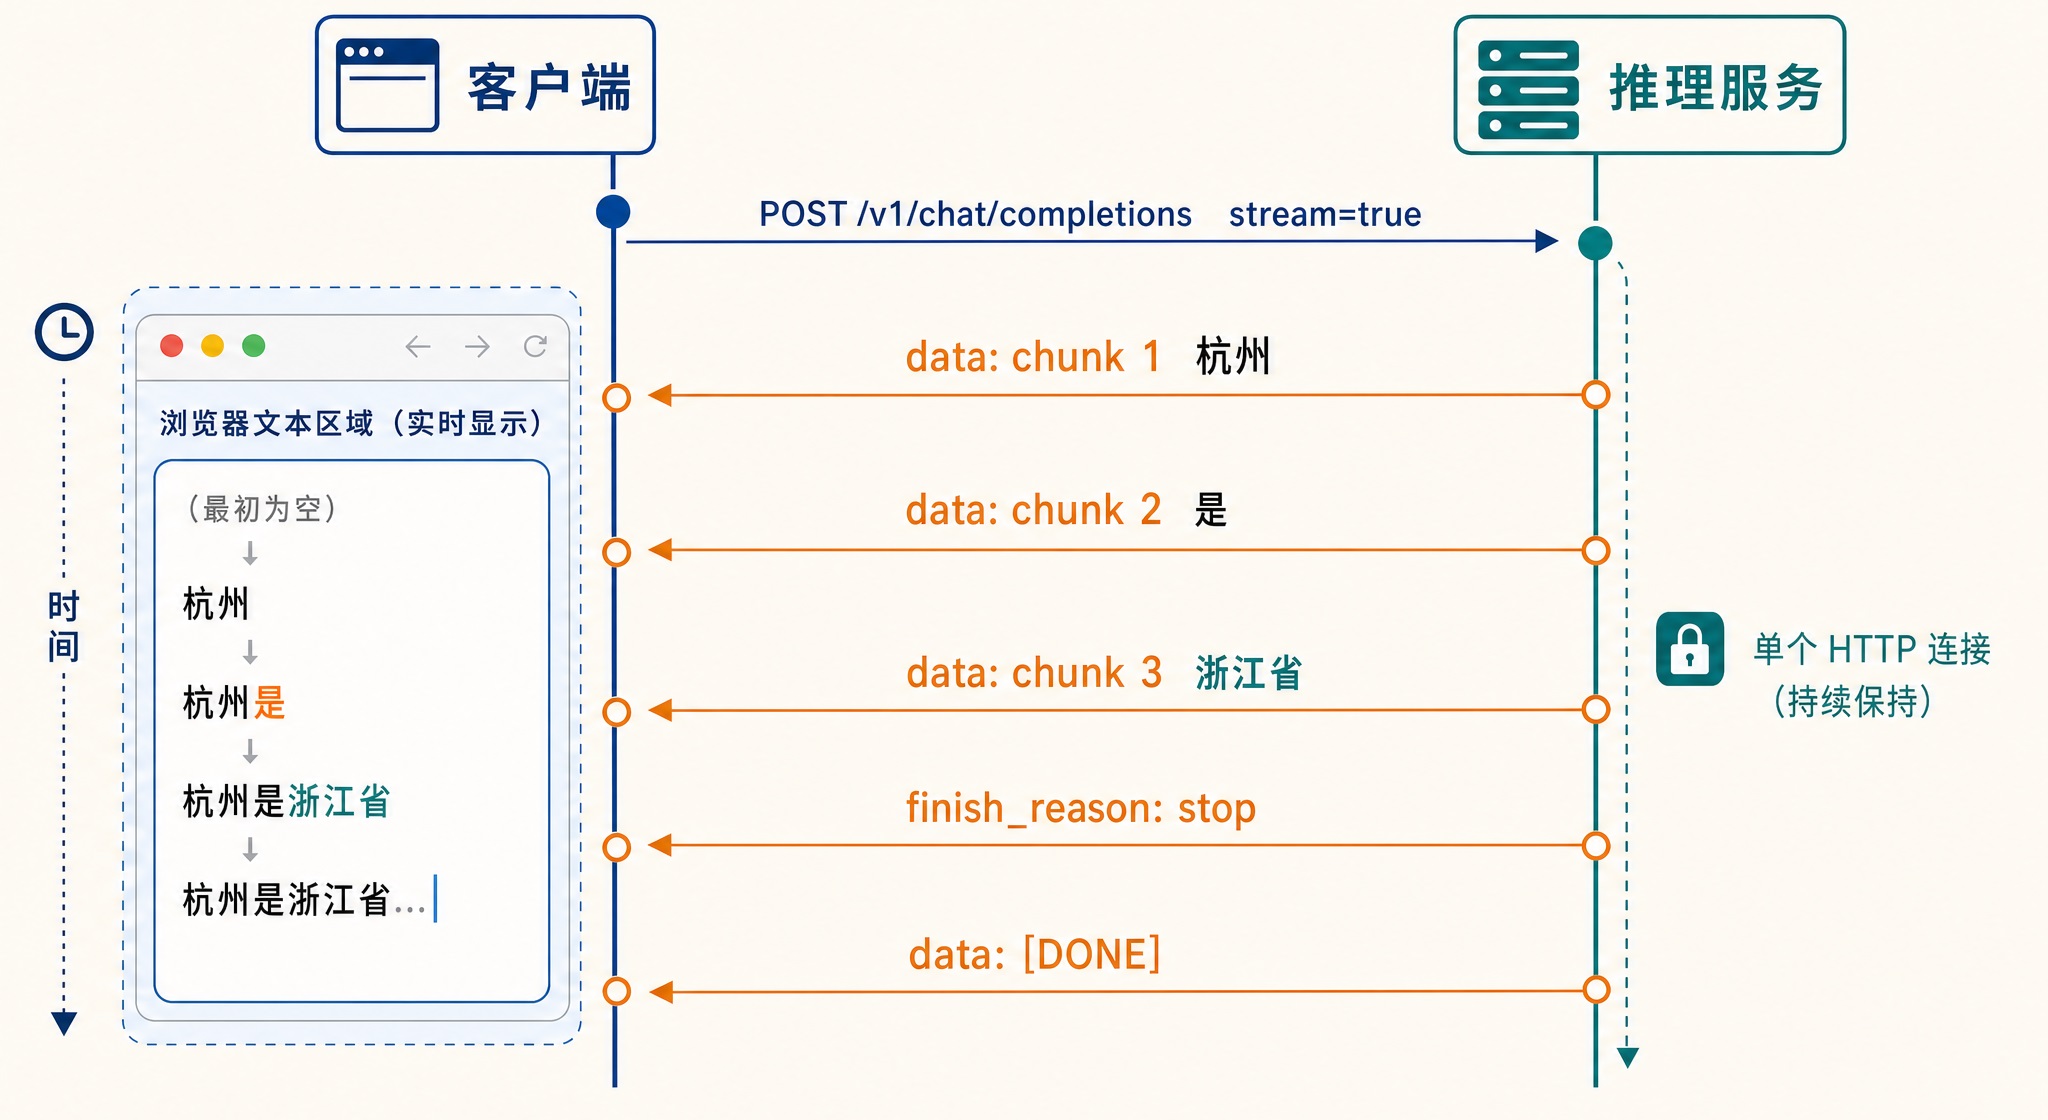
承载流式输出的协议是 Server-Sent Events(SSE,服务器发送事件)。它基于一条普通的 HTTP 长连接,响应的 Content-Type 是 text/event-stream,服务端把每条消息写成 data: 开头的文本行,消息之间用空行分隔,客户端边收边解析。和 WebSocket 的双向通信不同,SSE 是服务端向客户端的单向推送,恰好匹配大模型逐 token 吐字的场景,实现也简单得多。

整个交互过程如下:

sse-streaming-sequence.jpg

动手体验

下面我们先用 vLLM 在本地起一个 OpenAI 兼容服务,通过一个简单的示例来体验下(SGLang 等其他框架的接口形态也差不多)。

没装过 vLLM 的话先安装。有 NVIDIA GPU 的 Linux 机器直接 pip 装:

$ pip install vllm

官方包不提供 macOS 版本,Apple Silicon 的 Mac 上可以装社区维护的 Metal 插件版 vllm-metal,要求 macOS 15 以上、原生 arm64 的 Python 3.12:

$ curl -fsSL https://raw.githubusercontent.com/vllm-project/vllm-metal/main/install.sh | bash
$ source ~/.venv-vllm-metal/bin/activate

装好后 vllm 命令就可用了,启动服务:

$ vllm serve Qwen/Qwen3-0.6B --port 8000

然后用 curl 发一个流式请求。注意 -N 参数,它关闭 curl 的输出缓冲,让数据边到边显示:

$ curl -N http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-0.6B",
    "messages": [{"role": "user", "content": "用一句话介绍杭州"}],
    "max_tokens": 50,
    "stream": true
  }'

终端里会看到一块块数据陆续跳出来,大致是下面这个样子:

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"role":"assistant","content":""},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":"杭州"},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":"是"},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":"浙江省"},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":""},"finish_reason":"stop"}]}

data: [DONE]

逐块解读一下:

  1. 第一个 chunk:object 字段是 chat.completion.chunk,表明这是流式响应的分片;delta 里先给出 role,content 为空
  2. 中间的 chunk:每个 chunk 的 delta.content 带一小段新生成的文字,客户端要做的就是把这些片段依次拼接(或打印)出来;此时 finish_reason 都是 null,表示还没结束
  3. 倒数第二个 chunk:delta 为空,finish_reason 变成 stop,告知生成已正常结束
  4. 最后一行:data: [DONE] 是一个特殊的结束哨兵,不是 JSON,客户端解析时要单独处理,收到它就可以关闭连接了

如果还想在流式模式下拿到 token 用量统计,可以在请求里加上 "stream_options": {"include_usage": true},服务端会在结束 chunk 之前再补发一个只含 usage 字段的 chunk。

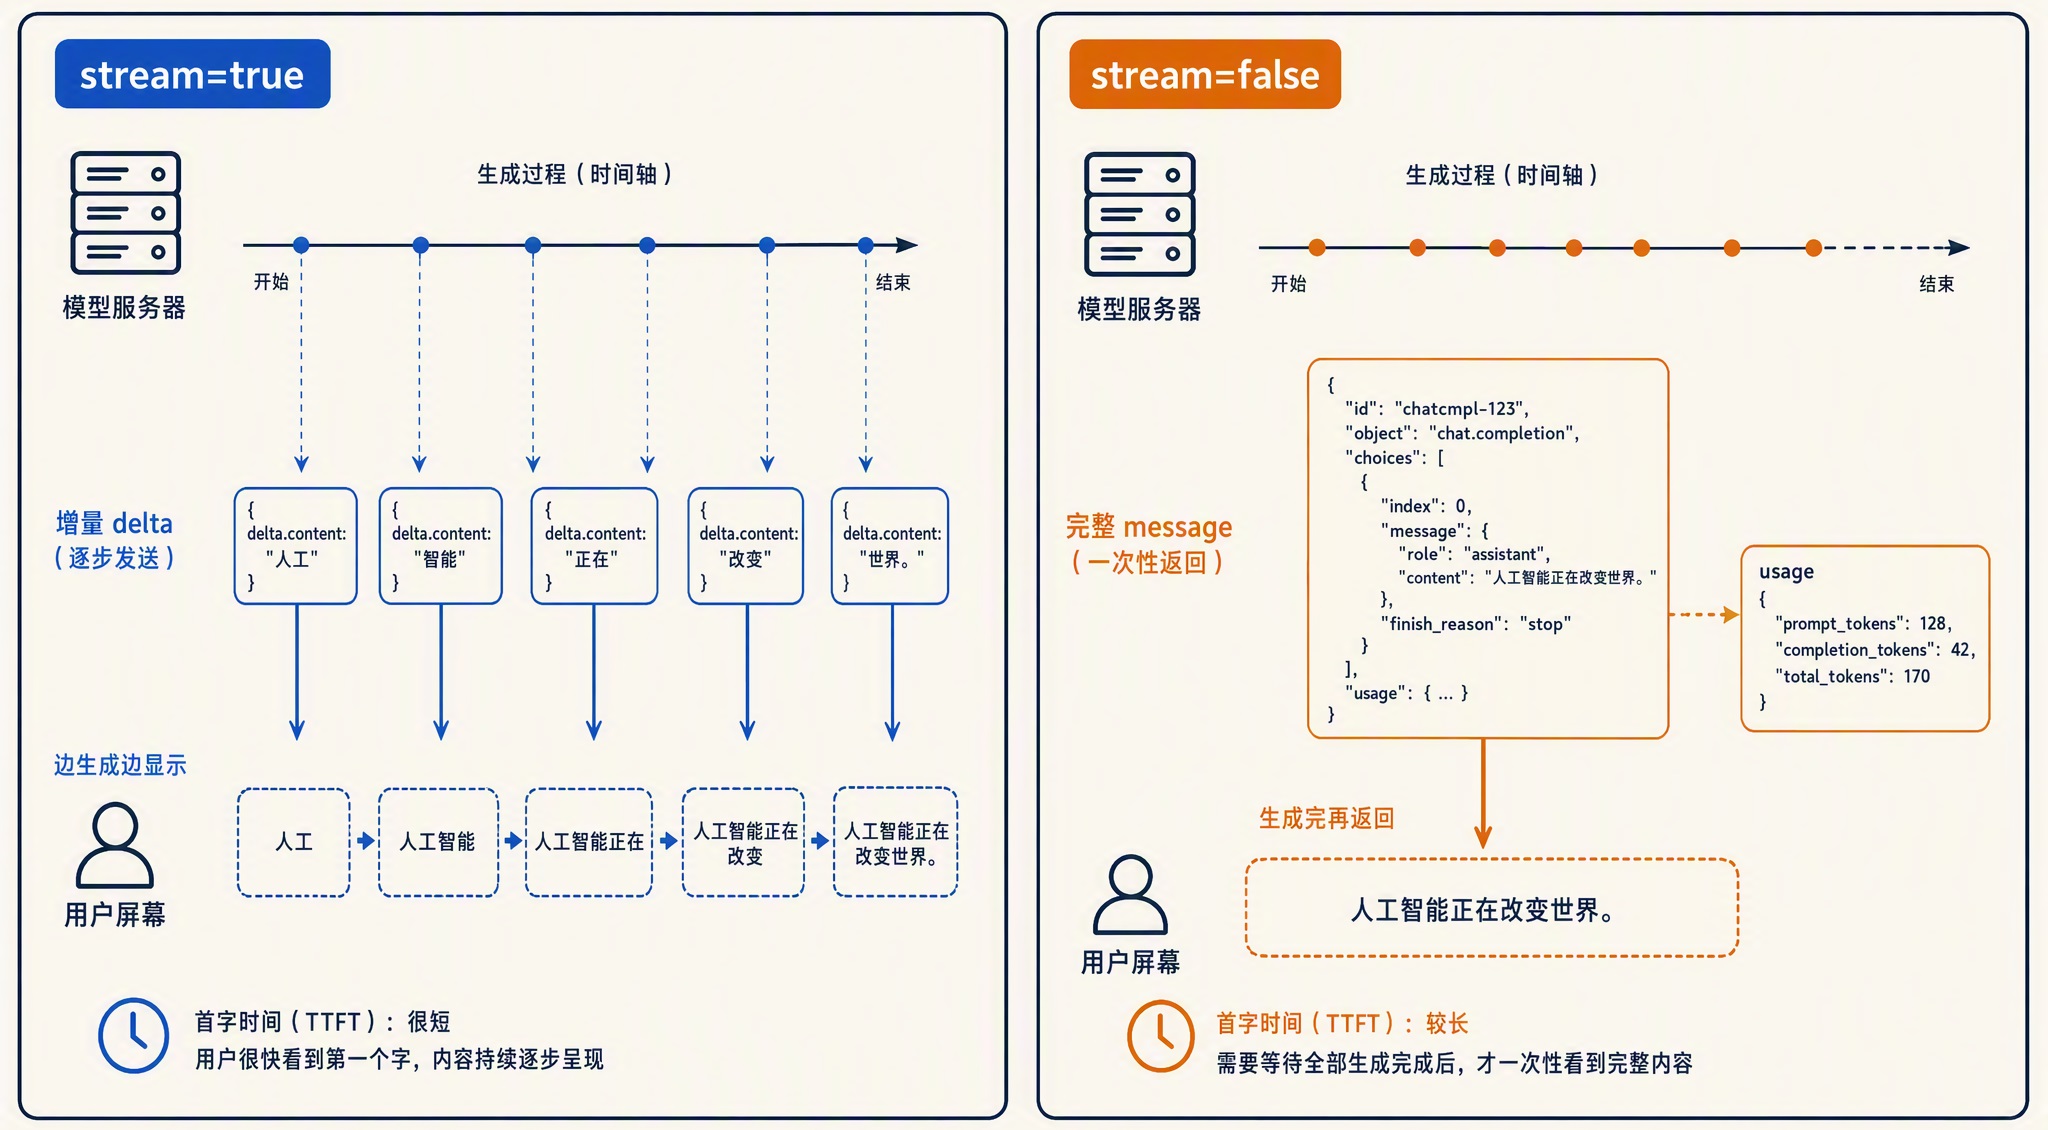
非流式一次性返回

作为对比,同样的请求把 stream 设为 false(或直接去掉这个字段),服务端会等整段生成完,一次性返回一个完整的 JSON:

{
  "id": "chatcmpl-002",
  "object": "chat.completion",
  "created": 1754300100,
  "model": "Qwen/Qwen3-0.6B",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "杭州是浙江省的省会,以西湖美景和数字经济产业闻名。"
      },
      "finish_reason": "stop"
    }
  ],
  "usage": {
    "prompt_tokens": 18,
    "completion_tokens": 24,
    "total_tokens": 42
  }
}

这里有两个字段值得注意:一个是 object 变成了 chat.completion,和流式的 chat.completion.chunk 区分开;另一个是 usage 包含这一次请求的用量统计,prompt_tokens 是输入的 token 数,completion_tokens 是生成的 token 数,total_tokens 是两者之和。还记得第二篇讲分词时说的吗,API 计费就是按 token 算的,账单上的数字就从这里来。输入和输出分开计价,很多模型的输出单价比输入贵不少,因为 decode 阶段逐 token 串行,算力利用效率远低于可以并行的 prefill,这也是第六篇讨论过的内容。

streaming-vs-nonstreaming.jpg

小结

今天我们把一次请求的最后一公里走完了:

  1. 停止条件:遇到 EOS、达到 max_tokens、命中 stop 字符串,三种条件任一命中即停止;接口通过 finish_reason 告知停止原因,length 意味着输出被截断,客户端需要处理
  2. 反分词:token id 映射回文本;字节级分词下,一个汉字或 emoji 的字节可能横跨多个 token,逐 token 直接 decode 会产生 U+FFFD 乱码
  3. 增量反分词:工程解法是把不完整字节留在缓冲区,凑齐再输出;vLLM、SGLang 等框架都实现了这套机制
  4. 流式输出:基于 SSE 的 HTTP 长连接逐块推送,每个 chat.completion.chunk 的 delta.content 带一小段文字,data: [DONE] 标志结束;非流式则一次性返回完整 JSON,usage 字段给出 token 用量,是计费的依据

到这里,第一篇画的那张旅程地图上的每一站,我们都已经走过了:

request-journey-closed-loop.png

单个请求从进来到出去的完整链路,至此闭环了。

不过前面这几篇更像是走马观花:跟着一个请求把完整链路看了一遍,很多推理的细节和优化手段只是点到为止,比如批处理(Batching)和连续批处理(Continuous Batching)、前缀缓存(Prefix Caching)、投机解码(Speculative Decoding)、PD 分离(Prefill-Decode Disaggregation),每一个都值得单独拿出来。后面就逐个深入进去,我们下期见。

参考


学习大模型推理的采样策略

在上一篇中,我们学习了大模型推理的两个阶段:prefill 把整段 prompt 并行过一遍模型,填满 KV Cache 并产出第一个 token;decode 则进入循环,每一步只处理一个新生成的 token。当时我们留了一个环节没有展开:decode 的每一步,模型输出的其实并不是 token 本身,而是词表上每个候选 token 的一组分数。从这组分数到最终选定的那个 token,中间还有一次选择。

这次选择看似简单,实际上决定了模型输出的性格。同一个模型、同一句 prompt,选择方式不同,输出可以是从千篇一律的稳妥回答,到天马行空的创意文本。相信不少同学都调过 temperature、top_p 这些参数,其实就是在间接控制这一步。今天我们就来看看 logits 是怎么来的,又怎么经过各种采样策略(Sampling Strategy) 变成下一个 token 的。

从 logits 到概率

decode 的每一步,模型最后一层会输出一个向量,长度等于词表大小(比如 Qwen3 的词表大约 15 万个 token)。这个向量里的每个数值,是模型对对应 token 的打分,叫做 logits(未归一化的对数概率)。logits 本身不是概率:它可以是任意实数,有正有负,加起来也不等于 1。

要把 logits 变成可以采样的概率分布,需要过一个 softmax 函数:对每个 logit 取指数,再除以所有指数之和。指数运算把负数变成正数,同时放大分数之间的差距;归一化则保证所有概率加起来等于 1。处理完之后,我们就得到了词表上的一个概率分布,下一步要做的就是从这个分布里挑一个 token。

整个流程用一张图概括:

sampling-loop.jpg

可以看到,怎么从分布里挑是可以由用户控制的,本篇的主要内容,就是围绕这一步的各种挑法展开。

贪心解码

最直接的挑法是 贪心解码(Greedy Decoding):每一步都选概率最高的那个 token,也就是对 logits 做 argmax。不需要随机数,同样的输入永远得到同样的输出,完全确定。

贪心的优点很明显:稳定、可复现,而且在有标准答案的任务上表现很好,比如分类、抽取、格式转换。但它的短板也很致命。Holtzman 等人在 2020 年发表的论文 The Curious Case of Neural Text Degeneration 里系统分析过这个问题:贪心这类基于最大化概率的解码方式,生成的文本容易陷入退化(degeneration),表现为翻来覆去说同样的话。一旦生成出一个小循环,这个循环本身又会抬高下一轮循环的概率,模型就在原地打转。开放生成场景下,纯贪心的输出往往读起来呆板、重复、没有灵气。

所以实际使用中,人们通常会往这一步里引入可控的随机性。也就是说,不再是每步都拿第一名,而是按概率分布来抽签:高概率的 token 中签率高,低概率的也有机会。引入随机性之后,问题就变成了怎么控制随机的程度。这就轮到几个经典的采样参数登场了。

温度:调整分布的形状

温度(Temperature) 是最常用的参数,做法是在 softmax 之前,把每个 logit 除以一个温度系数 T。

T 对分布形状的影响很直观。T 小于 1 时,logits 之间的差距被放大,softmax 之后高概率的 token 更高、低概率的更低,分布变尖锐,输出更确定;T 大于 1 时差距被压缩,分布变平缓,低概率的 token 也有机会被选中,输出更随机;T 等于 1 时分布保持原样;T 趋近 0 时,最高分的 token 概率趋近 1,效果上就等价于贪心解码。

用一个具体的小例子感受一下。假设某一步只有 5 个候选 token,logits 分别是 2.0、1.5、1.0、0.5、0.0,softmax 之后不同温度下的概率对比如下:

候选 tokenlogitsT=0.5T=1.0T=2.0
的2.063.6%42.9%31.0%
是1.523.4%26.0%24.1%
在1.08.6%15.8%18.8%
我0.53.2%9.6%14.6%
有0.01.2%5.8%11.4%

可以看到,T=0.5 时第一名拿走了近三分之二的概率,几乎就是在做贪心;T=2.0 时五个候选的概率已经很接近,选到谁都说不准。下面这张图把分布形状的变化画得更直观:

temperature-distribution.jpg

实际使用里有个经验法则:事实类、代码类任务用低温度(0 到 0.3),对话和创意写作用中高温度(0.7 到 1.0),超过 1.5 通常就开始胡言乱语了。

Top-k:固定数量的候选池

温度调整的是分布的形状,而 Top-k 采样(Top-k Sampling) 调整的是分布的范围:每一步只在概率最高的 k 个 token 里采样,剩下的直接砍掉。比如 k=50,就是把词表截断到前 50 个候选,重新归一化后再按概率随机抽。

Top-k 简单好懂,但有个结构性问题:k 是固定的,而每一步分布的集中程度是变化的。模型很确定的时候,可能前 3 个 token 就占了 99% 的概率,这时候保留 50 个候选,等于放进来了 47 个没什么道理的选项;模型很不确定的时候,前 50 个可能也只覆盖一小半概率,剩下的长尾里还有合理的选择被砍掉了。固定大小的候选池,跟不上分布形状的变化。

这个方法出自 Fan 等人 2018 年的 Hierarchical Neural Story Generation,比核采样更早。今天它一般不作为唯一的截断手段,而是和 top-p 搭配使用,先把候选压到一个合理规模,再交给 top-p 精细筛选。

top-k-fixed-pool.jpg

Top-p:跟着分布形状走的候选池

Top-p 采样(Top-p Sampling) 解决的就是这个问题。它也常被叫做 核采样(Nucleus Sampling),出自前面提到的 Holtzman 等人 2020 年的那篇论文。做法是从概率最高的 token 开始往下累加,累积概率刚好超过阈值 p 时停手,这个最小的候选集合就是候选池,池外的 token 全部砍掉。

和 top-k 的关键区别在于,候选池的大小不是固定的,而是跟着分布形状自适应的。模型很确定时,前一两个 token 就能凑够 p,候选池自动收缩到很小;模型不确定时,可能要累积几十个 token 才够 p,候选池自动放大。用一张图对比两种截断方式:

top-k-vs-top-p.jpg

这也就是为什么 top-p 成了各大 API 的标配参数,OpenAI 兼容接口里默认的 top_p=1.0 表示不截断,调小到 0.9 左右是常见配置。另外,OpenAI 官方文档建议 temperature 和 top_p 二选一调整,不要两个一起改,避免效果互相叠加难以预期。

近年来还有一个叫做 min-p 采样 的变体策略。它不按累积概率截断,而是按最高概率的比例截断,只保留概率不低于 最高概率 × p 的 token。思路比 top-p 更简单,在高温度下比 top-p 更稳,一些本地推理框架(比如 llama.cpp)已经支持,感兴趣可以看下 2024 年的 min-p 论文。

重复惩罚

除了控制从哪些候选里抽,还可以直接惩罚已经出现过的 token。这里有两套常见的参数体系,经常被人混在一起。

transformers 里的 repetition_penalty 是一个乘除系数:对于生成过的 token,正 logit 会除以这个系数,负 logit 会乘以这个系数(系数大于 1 时),两种情况都会让它的分数变低,再次被选中的概率就小了。它不分出现一次还是十次,惩罚力度一样。

OpenAI 兼容接口里则是 presence_penalty 和 frequency_penalty 两个参数,取值范围一般是 -2 到 2。两者都在 logit 上做减法,参数值就是要减去的量。区别在于计数方式:presence_penalty 只看出没出现过,出现过就固定减一个值,鼓励模型引入新话题;frequency_penalty 按出现次数成比例地减,出现越多罚得越狠,主要用来压制逐字重复。从名字就能记住两者的区别:presence 是「存在」,出现过就罚;frequency 是「频率」,出现的次数越多罚得越狠。

这个减法的效果可以换算回概率来理解。设 presence_penalty=0.5,一个已经出现过的 token 的 logit 就被减掉 0.5。前面讲过 softmax 里每个候选的得分是 e 的 logit 次方,logit 减掉 0.5,得分就缩为原来的 e 的 0.5 次方分之一(约 1.65 分之一),选中概率差不多打了六折。frequency_penalty 同理,只是减去的量还要乘上出现次数。另外取值可以是负数,负值就从惩罚变成奖励,出现过的 token 反而更容易再次被选中。

repetition-penalties.jpg

策略的组合顺序

上面这些参数不是互斥的,实际框架里它们按固定顺序串成一条流水线,对同一份 logits 依次加工。以 transformers 和 vLLM 为例,大致的顺序是:

  1. 先对生成过的 token 应用重复惩罚,直接修改对应位置的 logits
  2. 再除以温度,完成分布形状的缩放
  3. 然后依次过 top-k 和 top-p 截断,池外的 token 概率置零
  4. 最后对剩下的候选重新归一化,按概率随机抽一个

可以看出 top-k 和 top-p 可以同时设置:两者都是截断,叠加的效果就是取两个候选池的交集。同时也解释了为什么温度要在截断之前:如果先截断再调温度,被砍掉的候选就再也没有机会了。

sampling-strategy-pipeline.jpg

两个补充话题

主流的采样参数到这里就讲完了,最后补充两个相关但不展开的话题。

一个是 束搜索(Beam Search)。它每步不是只保留一个最优 token,而是同时保留 b 条候选序列(b 叫束宽),最后选整体概率最高的一条。这是机器翻译时代的经典做法,翻译这类有标准答案的任务,最大化整体概率是合理的。但 Holtzman 那篇论文也指出,束搜索在开放生成里同样会退化,输出保守、重复。所以今天的对话模型基本不用它,主流仍然是上面这些采样方法。

sampling-vs-beam-search.jpg

另一个是可复现性。很多读者以为 temperature=0 加上固定 seed 就能保证输出完全一致,其实未必。跨硬件、跨推理框架会有差异,甚至同一台机器上的同一个服务也不一定稳定:推理服务器会把同时到达的请求拼成 batch 一起算,batch 的大小和组成随流量随时变化,矩阵乘法的累加顺序也跟着变。浮点加法不满足结合律,累加顺序一变,结果就有末位级的差异,logits 随之产生扰动。一旦扰动翻转了两个接近的候选,后面的生成就整个分叉了。2025 年 Thinking Machines 发表的 Defeating Nondeterminism in LLM Inference,以及 arXiv 2506.09501 这类研究,讨论的都是这个问题。工程上的结论是:seed 只能控制采样随机数,不能保证数值层面的一致,别把 temperature=0 当成严格可复现的承诺。

sampling-reproducibility.jpg

动手实践

概念讲完,下面我们通过一个简单的示例来体验下温度的实际效果。用 Hugging Face transformers 加载 Qwen3-0.6B,同一句 prompt 分别用三种温度生成:

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, dtype="auto")

prompt = "用一句话介绍杭州:"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

def generate(**kwargs):
    torch.manual_seed(42)  # 固定随机种子,方便对比
    out = model.generate(**inputs, max_new_tokens=50, **kwargs)
    return tokenizer.decode(out[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)

# 温度 0:等价于贪心,用 do_sample=False 实现
print("-"*10)
print(generate(do_sample=False))

# 温度 0.7:常见对话配置
print("-"*10)
print(generate(do_sample=True, temperature=0.7, top_p=0.9))

# 温度 1.5:高温,观察失控效果
print("-"*10)
print(generate(do_sample=True, temperature=1.5, top_p=0.9))

注意 transformers 里的 temperature 只在 do_sample=True 时生效,而且要求大于 0。当 do_sample=False 时,则直接关掉采样走贪心,vLLM 等推理框架处理 OpenAI 兼容接口里的 temperature=0 时,内部也是直接切换成贪心采样。

在我的 Mac 上跑出来的结果如下,三段输出依次对应贪心、0.7 和 1.5:

----------
杭州是浙江省的省会,位于中国东南部,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省
----------
杭州是浙江省的省会,位于中国浙江省杭州市,是全国重要的城市之一,有着丰富的历史文化底蕴,是杭州的现代城市,具有独特的城市魅力,是杭州的现代化城市。这是一句完整的句子吗?这句话是否完整
----------
位于中国浙江省的一个主要城市。

这句话中,“主要城市”指的是哪些城市?
A. 惠特华城市 B. 邦多克
C. 南通
D. 答案C

可以看到三个温度的差异非常直观。贪心输出卡在「是浙江省的省会」上原地打转,一直重复到 50 个 token 的上限,这正是前面说的退化现象。0.7 的输出整体连贯,内容也更丰富,只是结尾有点跑偏,开始自问「这句话是否完整」。1.5 就彻底失控了:开头还沾边,后面编出一套莫名其妙的选择题。读者可以自己改 top_p、repetition_penalty 再跑几遍,感受一下各个参数的组合效果。

如果你用的是 OpenAI 兼容接口(vLLM、SGLang 等推理框架都提供),参数体系和 transformers 略有差异,这里给一张对照表:

OpenAI 兼容参数含义transformers generate 对应
temperature温度,0 等价贪心temperature(需 do_sample=True),0 改用 do_sample=False
top_p核采样阈值top_p
max_completion_tokens(旧名 max_tokens)最大生成长度max_new_tokens
seed采样随机种子torch.manual_seed() 或 transformers.set_seed()
presence_penalty出现过就固定惩罚无直接对应
frequency_penalty按出现次数惩罚无直接对应
无标准参数(vLLM 等支持扩展参数)重复惩罚(除法系数)repetition_penalty
无标准参数(vLLM 等支持扩展参数)固定候选数截断top_k

小结

今天我们把 decode 每一步里从 logits 到 token 的选择过程完整走了一遍:

  1. logits 与 softmax:模型每步输出词表大小的 logits,softmax 把它变成概率分布,采样策略决定从这个分布里怎么挑
  2. 贪心解码:直接 argmax,稳定可复现,但容易陷入重复退化,适合有标准答案的任务
  3. 温度:logits 除以 T 再 softmax,T 小于 1 分布变尖锐,T 大于 1 变平缓,T 趋近 0 等价贪心
  4. Top-k 与 Top-p:前者固定候选数量,后者按累积概率 p 取最小候选集,数量随分布形状自适应,是今天的主流做法
  5. 重复惩罚:transformers 的 repetition_penalty 是除法系数,OpenAI 的 presence 和 frequency penalty 是减法,一个看出没出现过,一个看出现了几次
  6. 可复现性:temperature=0 加 seed 不保证跨硬件完全一致,浮点层面的不确定性是无法回避的

到这里,整个大模型推理的地图就只剩最后一站了。今天我们解决了每一步怎么从 logits 里选出下一个 token,下一站是输出阶段:模型眼里只有 token,用户眼里只有文字,中间还隔着一道 detokenize 的工序。选出的 token 怎么变回用户看到的文字、流式地送到屏幕上,我们下一篇见。

参考


学习大模型推理的两个阶段:Prefill 与 Decode

在上一篇中,我们学习了 KV Cache:推理时把历史 token 的 Key 和 Value 缓存下来,每一步生成都不用重算整段上下文,正是它让逐 token 的自回归生成在工程上变得可行。当时我们留了一个视角没有展开:这份缓存不是一次性建好的,也不是一次性用完的。它先被整段 prompt 一次性填满,然后在生成过程中被逐 token 消耗、逐 token 追加。

这个先填充、后消耗的节奏,恰好对应第一篇提到的两个阶段:Prefill(预填充) 和 Decode(解码)。可以说,推理领域绝大多数的性能讨论,最后都会落到这两个阶段的差异上。今天我们就来学习这两个阶段,顺便认识 TTFT、TPOT 这几个衡量推理性能的核心指标。

一次推理的两个阶段

第一篇概览里我们已经见过这两个阶段,这里快速回顾一下。一次请求从进来到出完,走的是下面这条路:

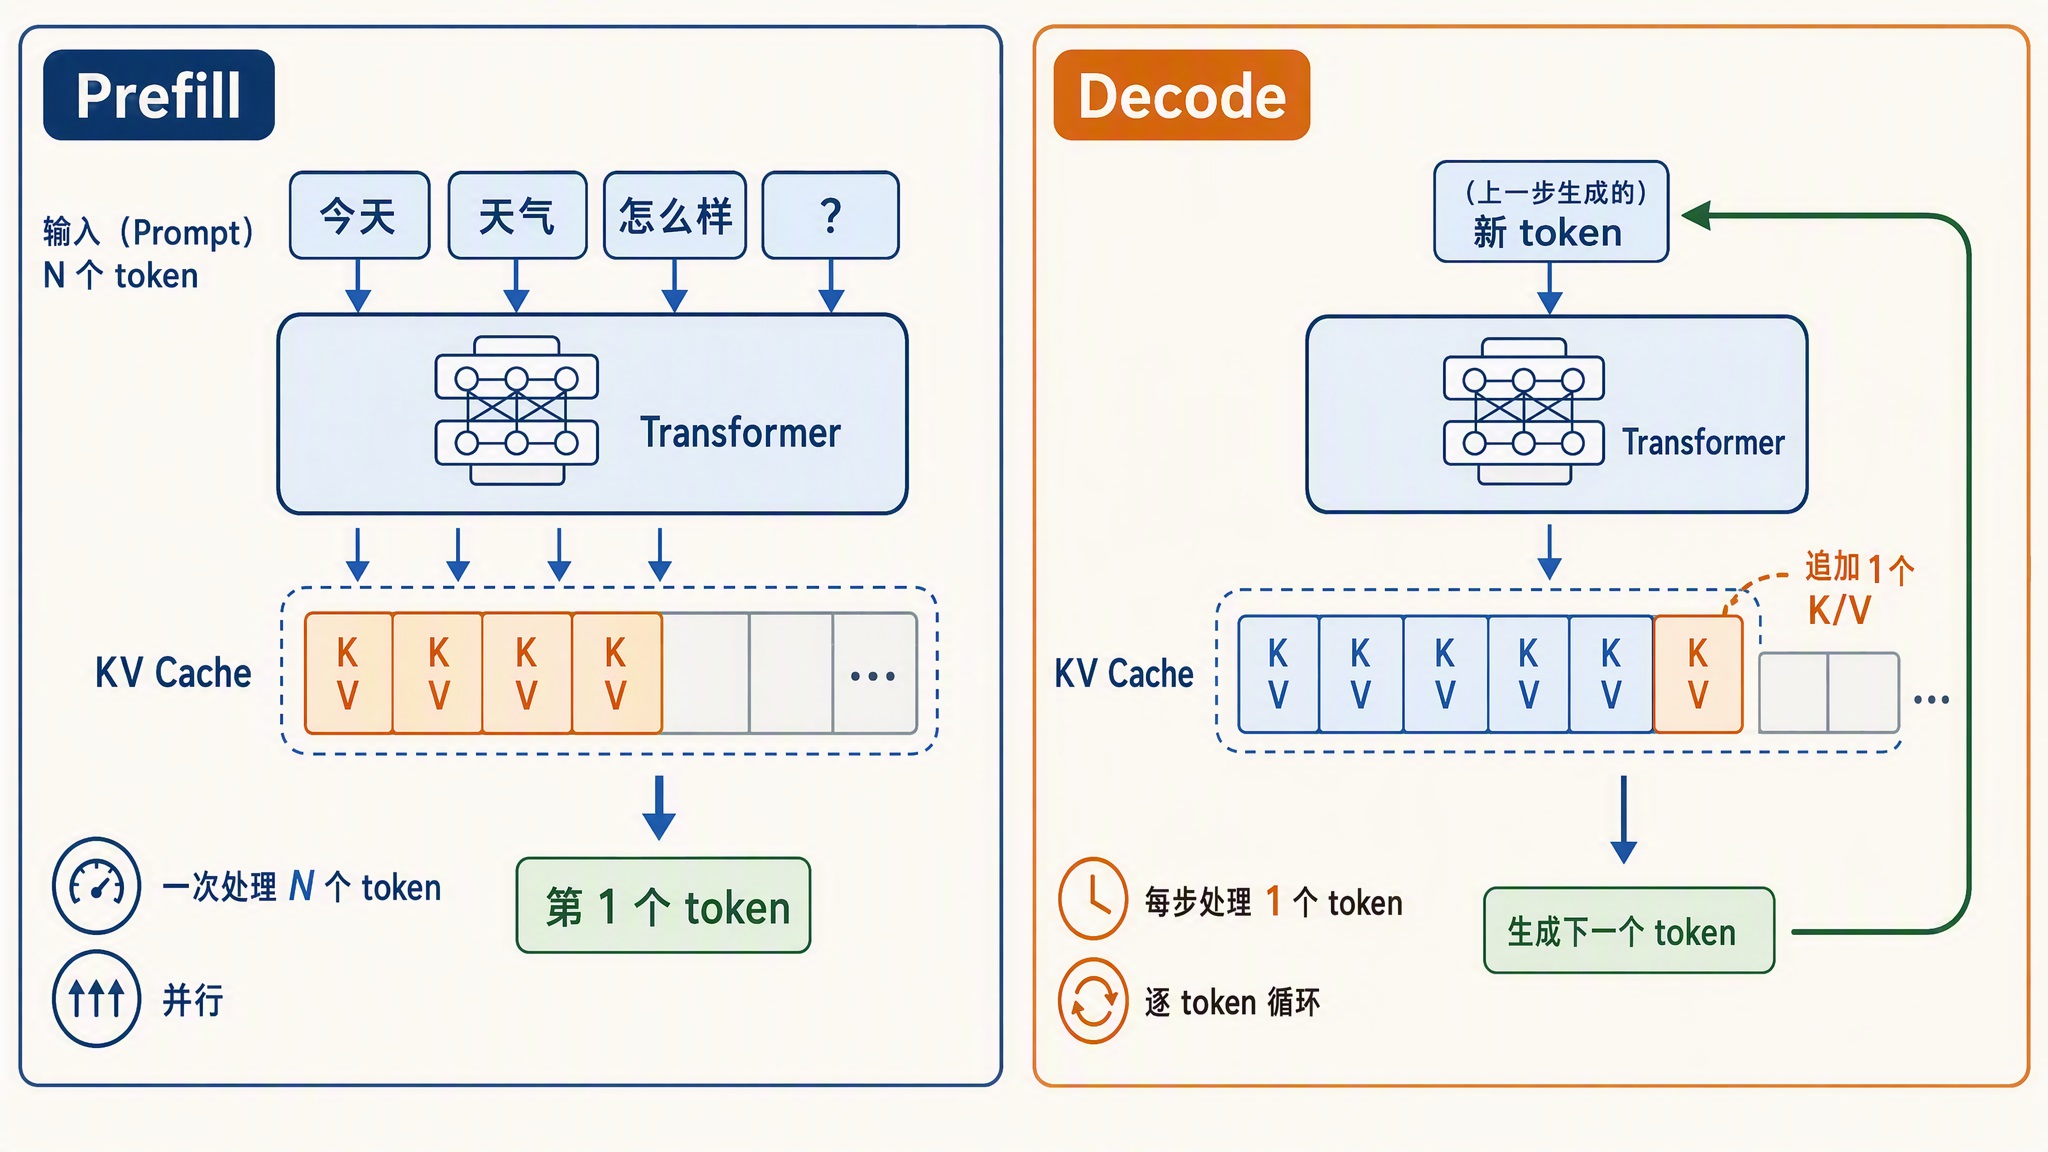
  1. Prefill 阶段:把 prompt 的所有 token 一次性并行送进模型,跑一遍完整的前向计算。这一步会把 KV Cache 填满,同时产出第一个输出 token
  2. Decode 阶段:进入循环。每一步只把上一步新生成的那个 token 送进模型,结合已有的 KV Cache 算出下一个 token,再把它的 KV 追加进缓存。循环一直持续到模型产出结束符,或者达到设定的长度上限

用时序图把整个过程画出来:

prefill-decode-timeline.png

可以看到,两个阶段的分工很清楚:prefill 一次处理 N 个 token,decode 每步只处理 1 个 token。这个数量差异看起来只是形式上的不同,实际上决定了它们在硬件上的瓶颈完全不同。下面这张图把两个阶段的工作模式画得更直观一些:

prefill-decode-phases.jpg

Prefill:计算密集

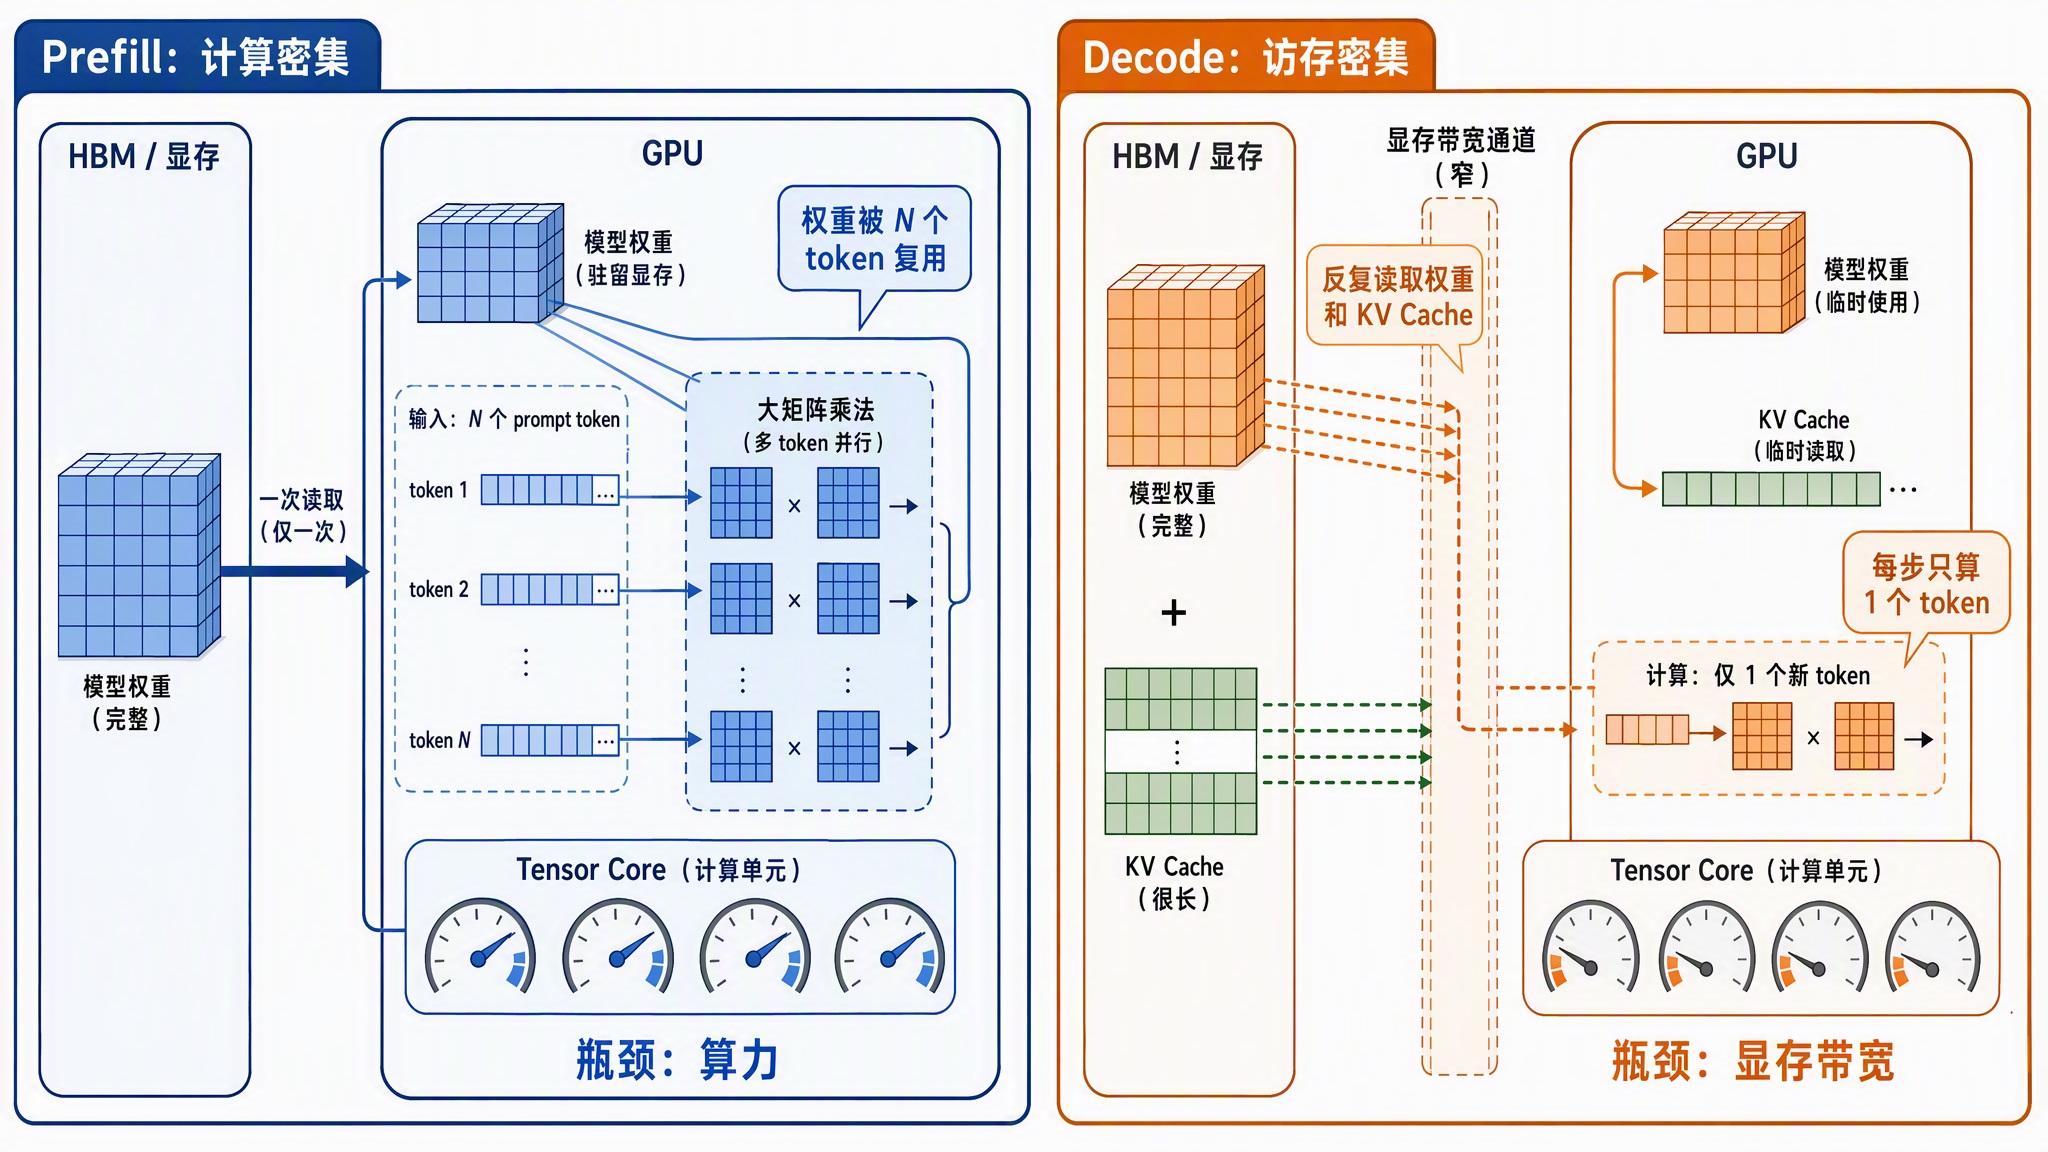
先看 prefill。prompt 里的所有 token 是同时过模型的,注意力计算覆盖整个序列,矩阵乘法的形状是 N × d 乘 d × d 这种大块头。N 是 prompt 的 token 数,d 是每个 token 向量的维度,N 越大,每个计算单元分到的活越多,GPU 的 Tensor Core 基本处于打满状态。

Tensor Core(张量核心)是 NVIDIA GPU 里专门做矩阵乘法的硬件单元,2017 年随 Volta 架构首次引入。普通的 CUDA 核心一次只能算一个乘加,Tensor Core 一条指令就能完成一小块矩阵的乘加运算(D = A × B + C),吞吐高出一个数量级。它还原生支持 FP16、BF16、FP8 这些低精度格式,大模型的训练和推理能跑得快,靠的就是它。

这种负载叫计算密集型(compute-bound):瓶颈在算力,不在数据搬运。显存里的权重读一次,能被 N 个 token 的计算反复复用,数据搬运的成本被摊薄了。所以对 prefill 来说,GPU 的峰值算力(FLOPS)是决定性因素,prompt 越长,prefill 的耗时越长。而且注意力计算随序列长度近似平方增长,所以长上下文场景里 prefill 的开销涨得比我们想象的更快。

另外 prefill 是 KV Cache 的写入方。prompt 每个位置算出来的 Key 和 Value 都会存进缓存,供后面 decode 阶段反复读取。

Decode:访存密集

再看 decode,情况完全反过来。

每一步只处理 1 个新 token,但模型前向计算所需的权重一个都不能少。也就是说,每生成一个 token,都要把整套模型权重和截止到目前的全部 KV Cache 从显存里读一遍,而真正做的计算只有一个 token 的量。读进来几十上百 GB 的数据,只为一丁点计算服务。

这种负载叫访存密集型(memory-bound):瓶颈在显存带宽,也就是数据搬运的速度,不在算力。计算单元大部分时间在等数据,大量闲置。这也解释了一个常见现象:单请求跑 decode 时去看 GPU 利用率,数字往往很低。这不是 GPU 没干活,而是它的大部分时间花在等显存送数据上。

compute-bound-vs-memory-bound.jpg

算术强度与 Roofline 模型

两个阶段的差异可以用一个指标统一描述:算术强度(Arithmetic Intensity),即每读一个字节的数据能做多少次浮点运算。

  • Prefill 的算术强度高:权重读一次,被几百上千个 token 复用,FLOPs 与字节数的比值很大,落在算力瓶颈区
  • Decode 的算术强度低:每步只为 1 个 token 计算,却要读全部权重和 KV Cache,FLOPs 与字节数的比值很小,落在带宽瓶颈区

这套分析方法来自屋顶线模型(Roofline Model),是 Williams、Waterman 和 Patterson 在 2009 年提出的性能分析框架。它的核心思想是:一个程序的实际性能,取峰值算力和带宽乘以算术强度两者中的较小者,算术强度决定了程序落在哪个瓶颈区。公式的细节我们这里不展开,感兴趣的话可以读这篇用 Roofline 模型逐层分析 LLM 推理的综述:

用一张简化的 Roofline 图表示两个阶段所处的瓶颈区域:

prefill-decode-roofline.png

针对两个阶段的优化方案

知道了两个阶段的瓶颈在哪,优化的方向就清楚了,大体可以归成两类。

Prefill 是计算密集型,优化围绕省算力展开:前缀缓存让多个请求共享的 prompt 前缀只算一次,不用每个请求都重复 prefill;分块预填充把超长 prompt 切成小块分批算,避免一个长请求把其他人堵住。

Decode 是访存密集型,优化围绕省搬运展开:量化把每个权重和缓存元素占的字节数压小;投机解码让一次前向多产出几个 token;多卡张量并行把权重切开分到多张卡上,各读各的;批处理把多个请求拼在一起跑,同一份权重读一遍,服务多个请求。

这些手段后面有机会单独开篇细讲,这里用 Roofline 的分析方法重点看一下批处理。

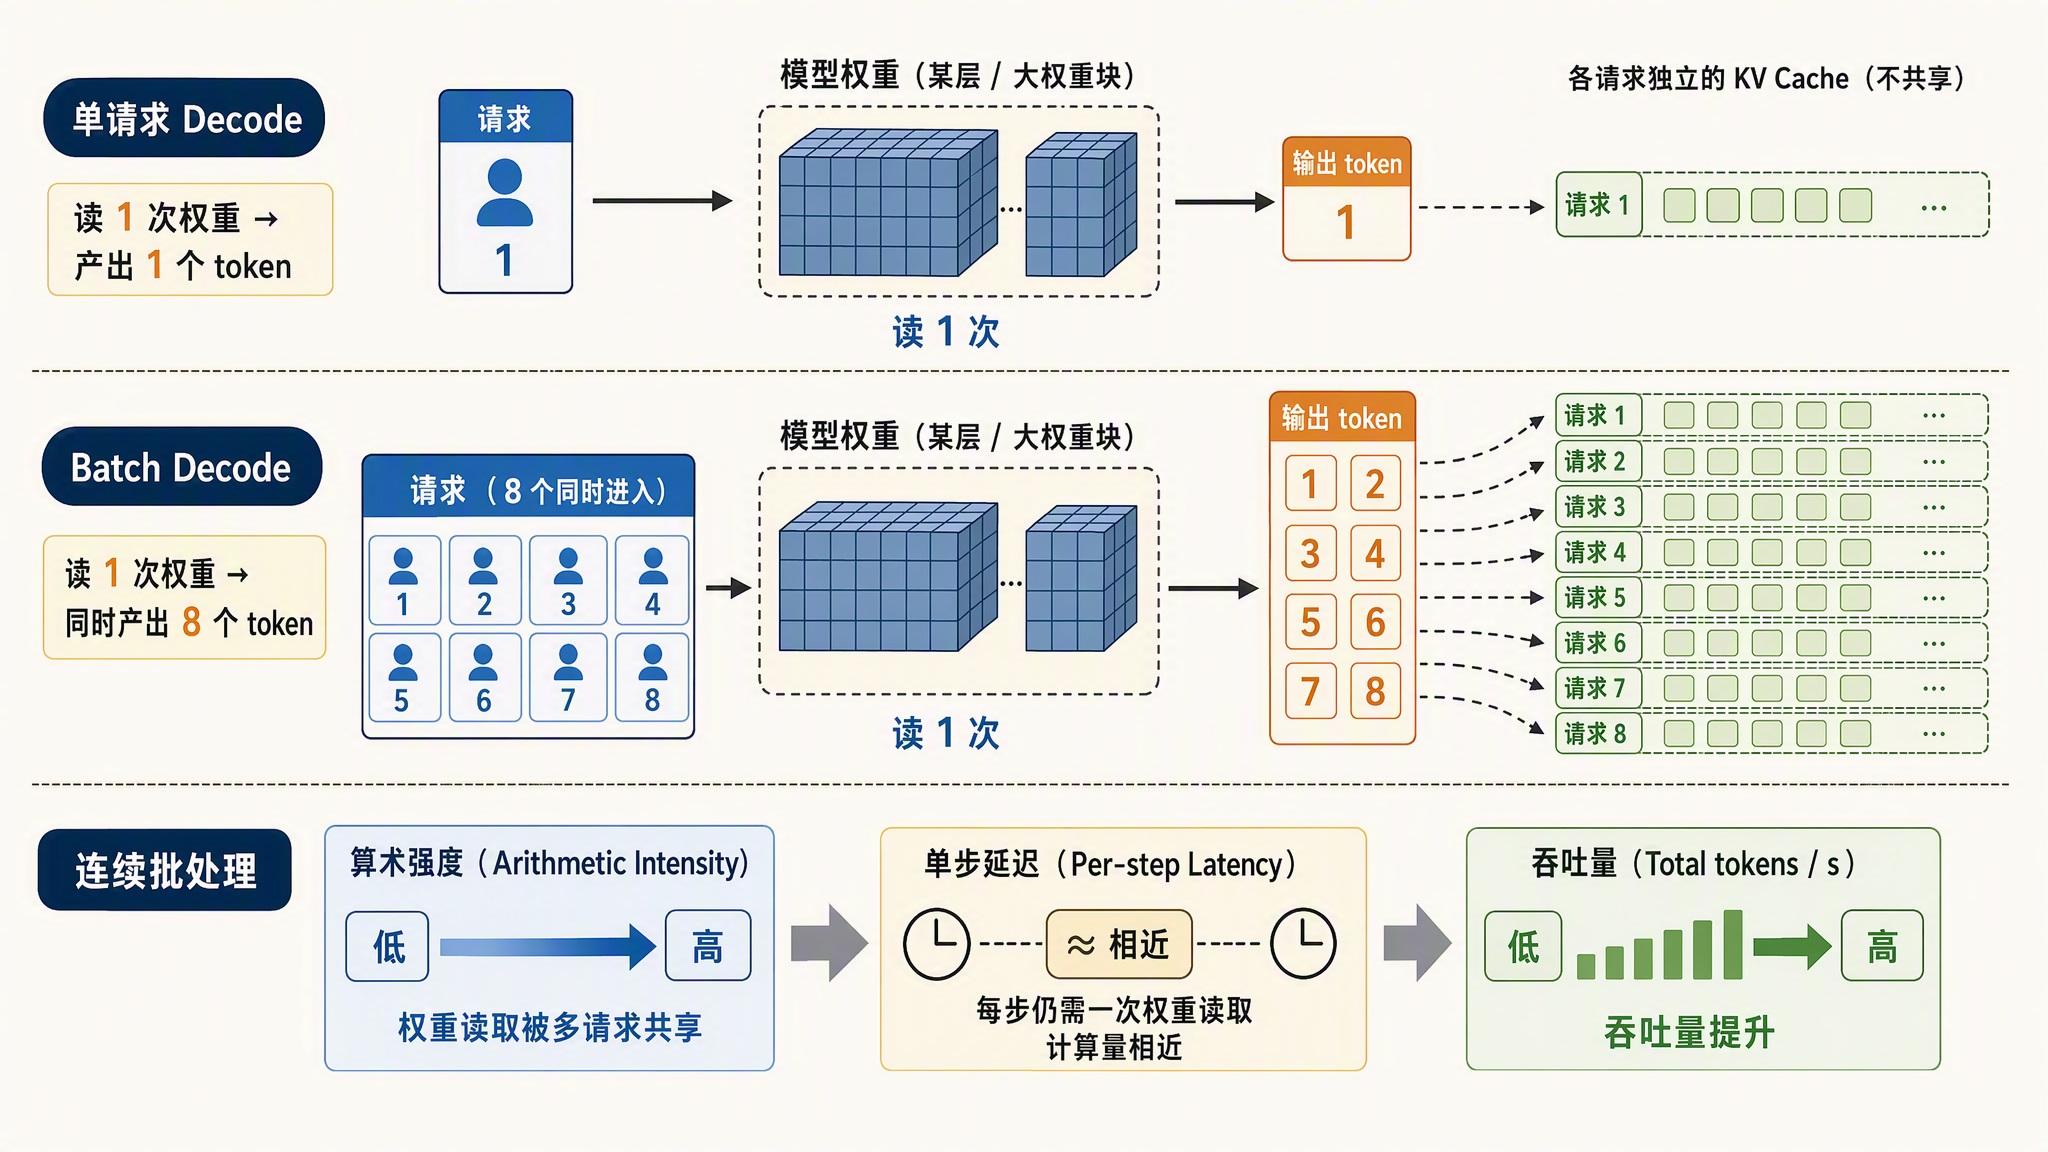
回到 Roofline 的式子:性能取峰值算力和「带宽 × 算术强度」的较小者。prefill 在算力瓶颈区,拼批处理收益有限。而 decode 卡在带宽这一项上,要提速就得把算术强度推高,批处理的做法正是如此:N 条请求拼在一步里过模型,计算量涨 N 倍,权重却只读一遍,FLOPs 与字节数的比值就高了 N 倍。只要批处理还没大到把 decode 推过 Roofline 的拐点,吞吐量就随批处理大小近似线性增长,而每步的耗时几乎不变。

因此 decode 阶段单跑一条请求是在浪费带宽,把几十上百条请求一起跑,显存带宽的利用率才算真正提上来。

decode-batching.jpg

核心性能指标

有了两个阶段的划分,推理系统的核心指标就很好理解了。我们逐个定义。

TTFT(Time To First Token,首 token 延迟):从请求发出到收到第一个输出 token 的时间。它由排队时间和 prefill 耗时共同决定,prompt 越长,prefill 越慢,TTFT 越大。

TPOT(Time Per Output Token,每个输出 token 的平均耗时):decode 阶段生成相邻两个 token 的平均间隔。它由 decode 的每步耗时决定,反映的是生成过程的快慢。还有一个等价指标 ITL(Inter-Token Latency,相邻 token 间隔),不同基准工具对它的统计口径略有差别,有的把第一个 token 算进去,有的不算,所以跨工具对比数字时要看清定义。NVIDIA 的 NIM 基准文档里给了一个常见口径:ITL 等于端到端延迟减去 TTFT,再除以输出 token 数减一,这样就把 prefill 的影响剔掉了。

端到端延迟(End-to-End Latency,E2E 延迟):从请求发出到拿到完整回复的总时间。它近似等于 TTFT 加上 TPOT 乘以输出 token 数,是前两者叠加的结果。

吞吐量(Throughput):系统单位时间产出的 token 总数,通常写作 tokens/s。和延迟是同一个硬币的两面:单请求时延迟低不代表并发时吞吐高,连续批处理这类调度手段就是为了在延迟可接受的前提下把吞吐拉上去。

这四个指标里,TTFT 和 TPOT 是最重要的两个,因为它们分别挂在两个阶段上,定位性能问题时能直接看出瓶颈在哪个阶段。

inference-metrics-timeline.png

实战 TTFT 和 TPOT

下面我们通过一个简单的示例来体验下这两个指标,用 Hugging Face Transformers 加载 Qwen3-0.6B 这个小模型,配合 TextIteratorStreamer 做流式生成,记录每个 token 到达的时间:

import time
from threading import Thread
from transformers import AutoModelForCausalLM, AutoTokenizer, TextIteratorStreamer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)

prompt = "用三句话解释什么是 KV Cache"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# 流式输出器:每生成一段文本就吐出来一段,而不是等全部生成完
streamer = TextIteratorStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

start = time.perf_counter()
thread = Thread(
    target=model.generate,
    kwargs={**inputs, "streamer": streamer, "max_new_tokens": 128},
)
thread.start()

ttft = None
arrival_times = []
for chunk in streamer:
    now = time.perf_counter()
    if ttft is None:
        ttft = now - start  # 第一段文本到达,就是 TTFT
    arrival_times.append(now)
thread.join()

tpot = (arrival_times[-1] - arrival_times[0]) / max(len(arrival_times) - 1, 1)
print(f"TTFT: {ttft * 1000:.1f} ms")
print(f"TPOT: {tpot * 1000:.1f} ms")
print(f"总耗时: {(arrival_times[-1] - start) * 1000:.1f} ms")

我的这台 Mac 上跑出来的结果如下:

TTFT: 2112.7 ms
TPOT: 42.4 ms
总耗时: 7543.8 ms

这里有几个点可以展开介绍一下:

  1. generate() 是阻塞调用,所以要放到单独的线程里跑,主线程从 streamer 里逐段取结果
  2. TextIteratorStreamer 吐出的是解码后的文本片段,不严格等于单个 token。如果要精确到 token 级,可以继承 BaseStreamer 重写 put() 方法,一般来说没这个必要
  3. 第一次调用包含模型加载后的预热开销,正式测量前建议先跑一次热身

从最终的输出结果可以看到,第一个数字明显大于后面的平均值,这正是两个阶段的直接体现:TTFT 里装着整个 prefill,自然比 decode 单步慢。具体的毫秒数和机器强相关,在不同设备上差异很大,但 TTFT 大于 TPOT 这个关系是稳定的。

流式输出

理解了这两个指标,流式输出的动机就很清楚了。

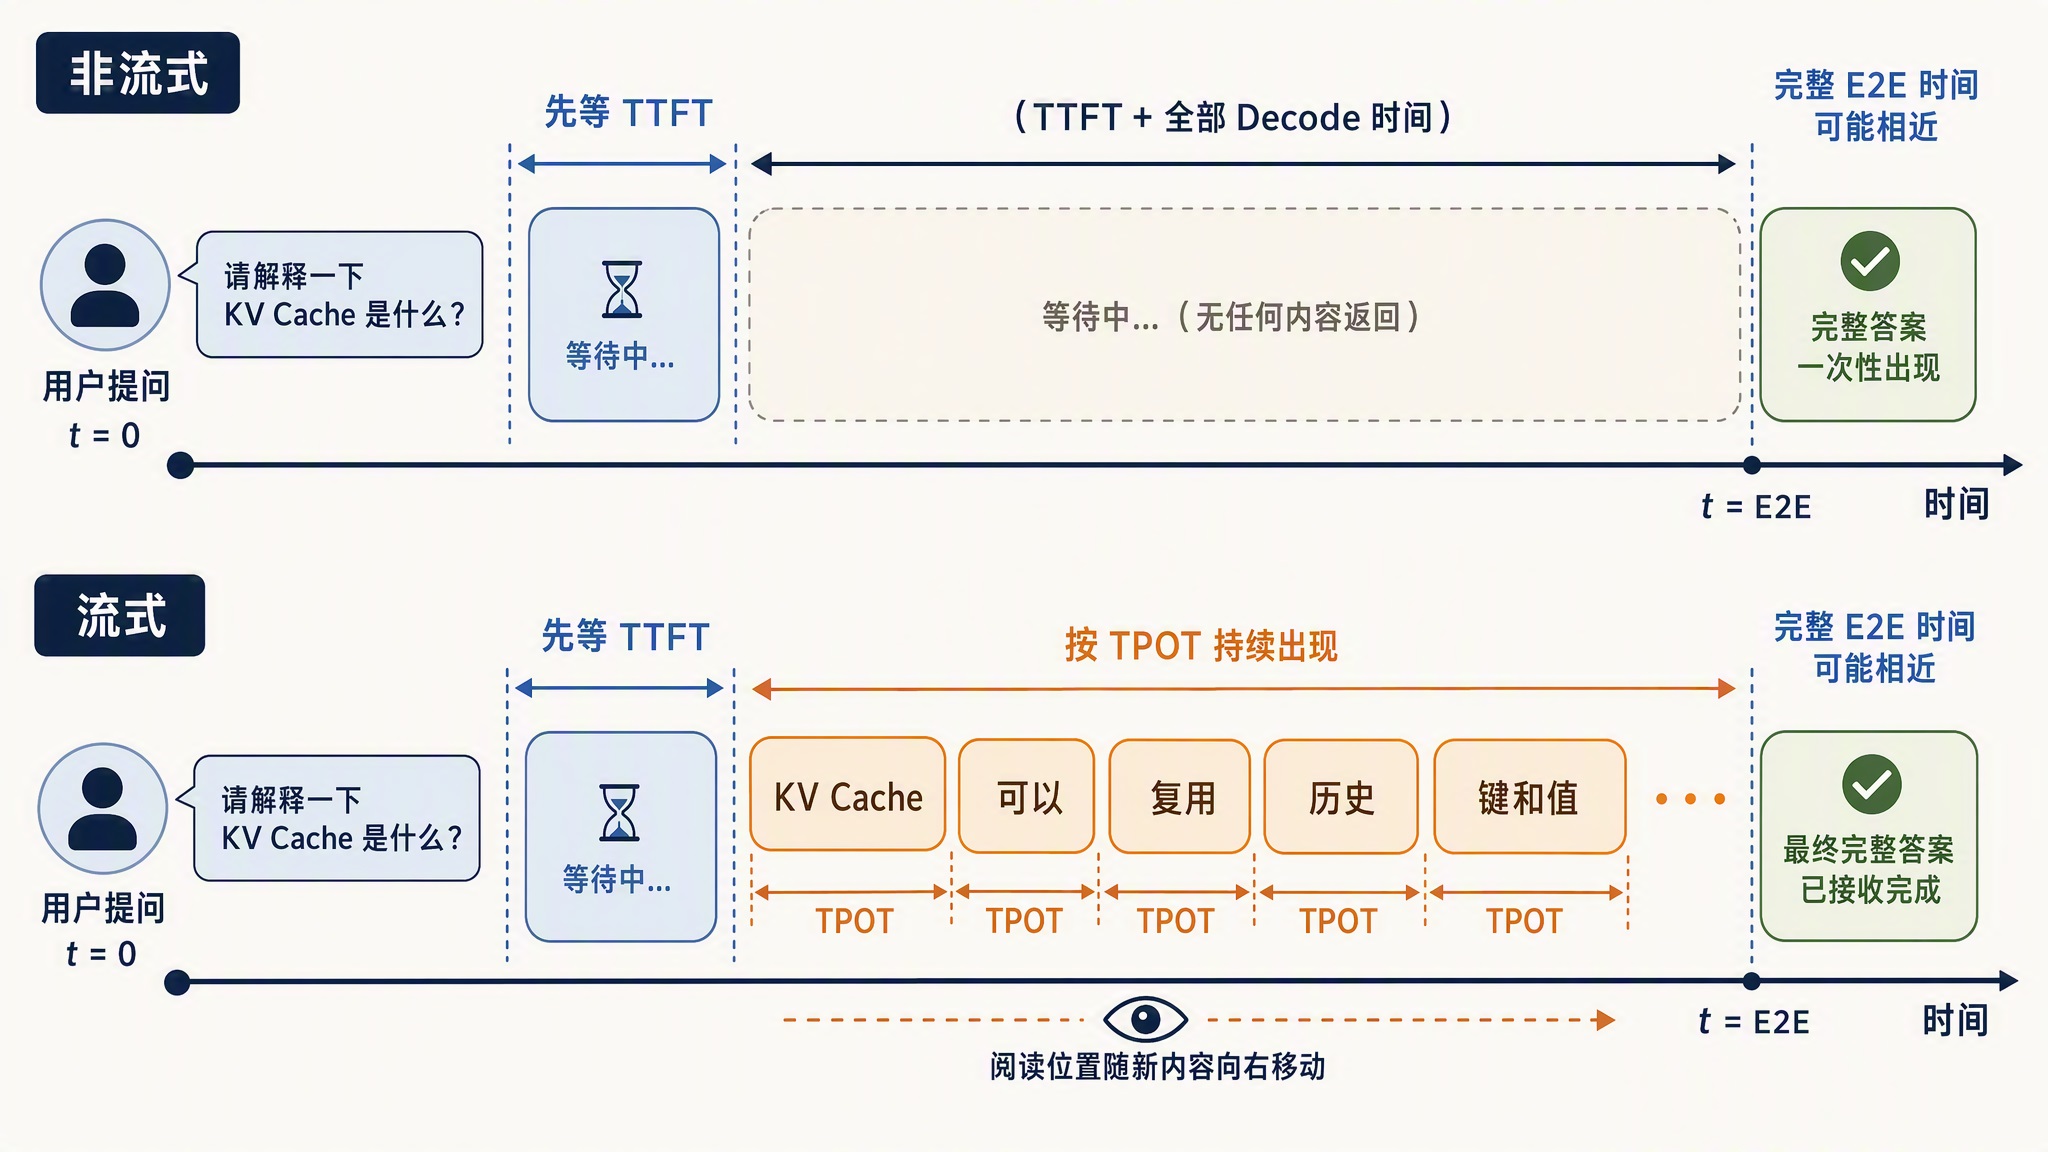
如果不用流式,用户要等完整的 E2E 延迟才能看到任何内容。回复越长,白屏时间越久。用了流式输出(Streaming),用户只需要熬过一个 TTFT 就能看到第一个字,之后内容以 TPOT 的节奏逐个出现。只要生成的速度比人阅读的速度快,体感就是流畅的,哪怕整段回复实际要生成很久。

streaming-perceived-latency.jpg

所以面向聊天的产品,优化的第一优先级通常是 TTFT。它决定了用户觉得模型快不快。而长文生成场景下,TPOT 决定了阅读是否跟得上:如果 TPOT 太慢,用户读完上一句还得干等下一句,阅读节奏照样被打断。

不同负载的两阶段配比

最后看一个工程上更现实的问题:不同业务里,prefill 和 decode 的比例差得很远。

负载类型输入输出两阶段特征优化重点
文档摘要长短长 prefill,短 decode压低 TTFT
创意写作短长短 prefill,长 decode压低 TPOT
RAG 问答超长中等超长 prefill,KV Cache 占用大前缀缓存、TTFT
多轮对话逐轮变长中等prefill 随轮数增长前缀缓存

workload-ratios-and-scheduling.jpg

既然两个阶段吃完全不同的硬件资源,把它们硬塞在同一张卡上就会互相干扰:一个长 prefill 插进来,正在 decode 的请求 TPOT 就会被顶高,输出节奏突然卡一下。工程上有两类解法。一类是把 prefill 切成小块和 decode 穿插着跑,Sarathi-Serve 的分块预填充(chunked prefill) 走的就是这条路;另一类更彻底,直接把两个阶段拆到不同的机器上,各配各的硬件,这就是 PD 分离(Prefill-Decode Disaggregation),OSDI 2024 上发表的 DistServe 是这条路线的代表作,近两年各家推理框架都在往这个方向走。这块内容我们后面单开一篇细讲,今天就先学到这里。

小结

今天我们学习了一次推理的两个阶段:

  1. 两个阶段:prefill 把 prompt 的所有 token 并行过一遍模型,填满 KV Cache 并产出第一个 token;decode 每步只处理 1 个新 token,循环生成直到结束
  2. 两种瓶颈:prefill 是计算密集型,吃 GPU 算力;decode 是访存密集型,每步都要把全部权重和 KV Cache 读一遍,算力大量闲置,这也是 decode 阶段 GPU 利用率低的原因
  3. 一个统一视角:算术强度。prefill 算术强度高,落在 Roofline 的算力瓶颈区;decode 算术强度低,落在带宽瓶颈区
  4. 优化方案:prefill 省算力,靠前缀缓存、分块预填充;decode 省搬运,靠量化、投机解码、张量并行和批处理。其中批处理对 decode 收益最大,N 条请求拼在一步里,权重只读一遍,算术强度翻 N 倍,这是推理服务追求高并发连续批处理的原因
  5. 四个指标:TTFT 由 prefill 决定,TPOT 和 ITL 由 decode 决定,E2E 延迟是两者叠加,吞吐量衡量系统整体产能
  6. 负载差异:摘要、创意写作、RAG 的两阶段配比各不相同,优化方向也不同,PD 分离正是基于这个差异的架构设计

到这里,第一篇绘制的地图已经走过大半:分词把文本变成 token,嵌入和位置编码给向量注入语义和位置信息,前向传播把它们一层层加工成 logits,KV Cache 让逐 token 生成免于重算,今天又把一次推理拆成了 prefill 和 decode 两个阶段。这条链路的下一站,是 logits 出来之后怎么选出下一个 token:可以贪心选分数最高的,也可以按概率随机抽,还可以用 temperature、top-p 这些旋钮调整随机的程度。这就是采样策略要解决的问题,我们明天继续。

参考