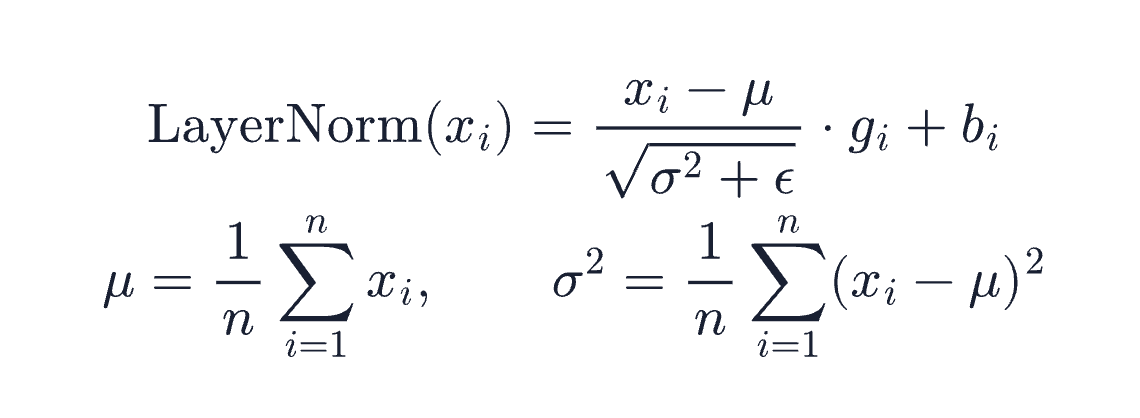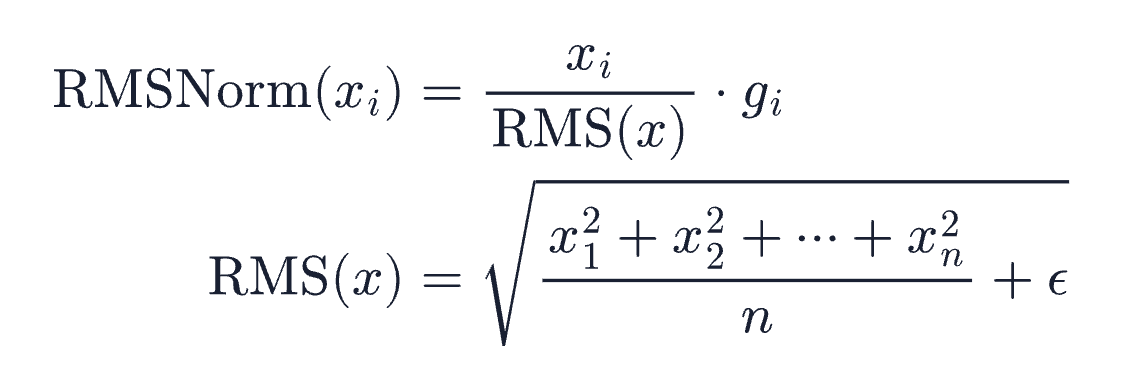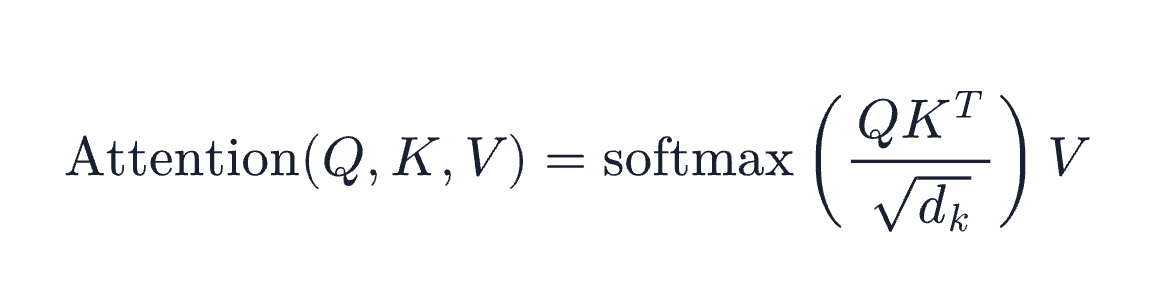
Fork me on GitHub

分类 大模型推理 下的文章

学习大模型推理的加速技术:量化、投机采样与 PD 分离

在上一篇中,我们学习了推理的显存优化:PagedAttention 把 KV Cache 切成固定大小的块按需分配,前缀缓存让相同前缀的请求复用已算好的 KV 块。再往前看,KV Cache 本身是拿显存换时间,连续批处理是让 GPU 不空转。这些优化有一个共同的特点:它们不改模型、不改输出,只是把现有的资源省着用,把能复用的计算复用起来。

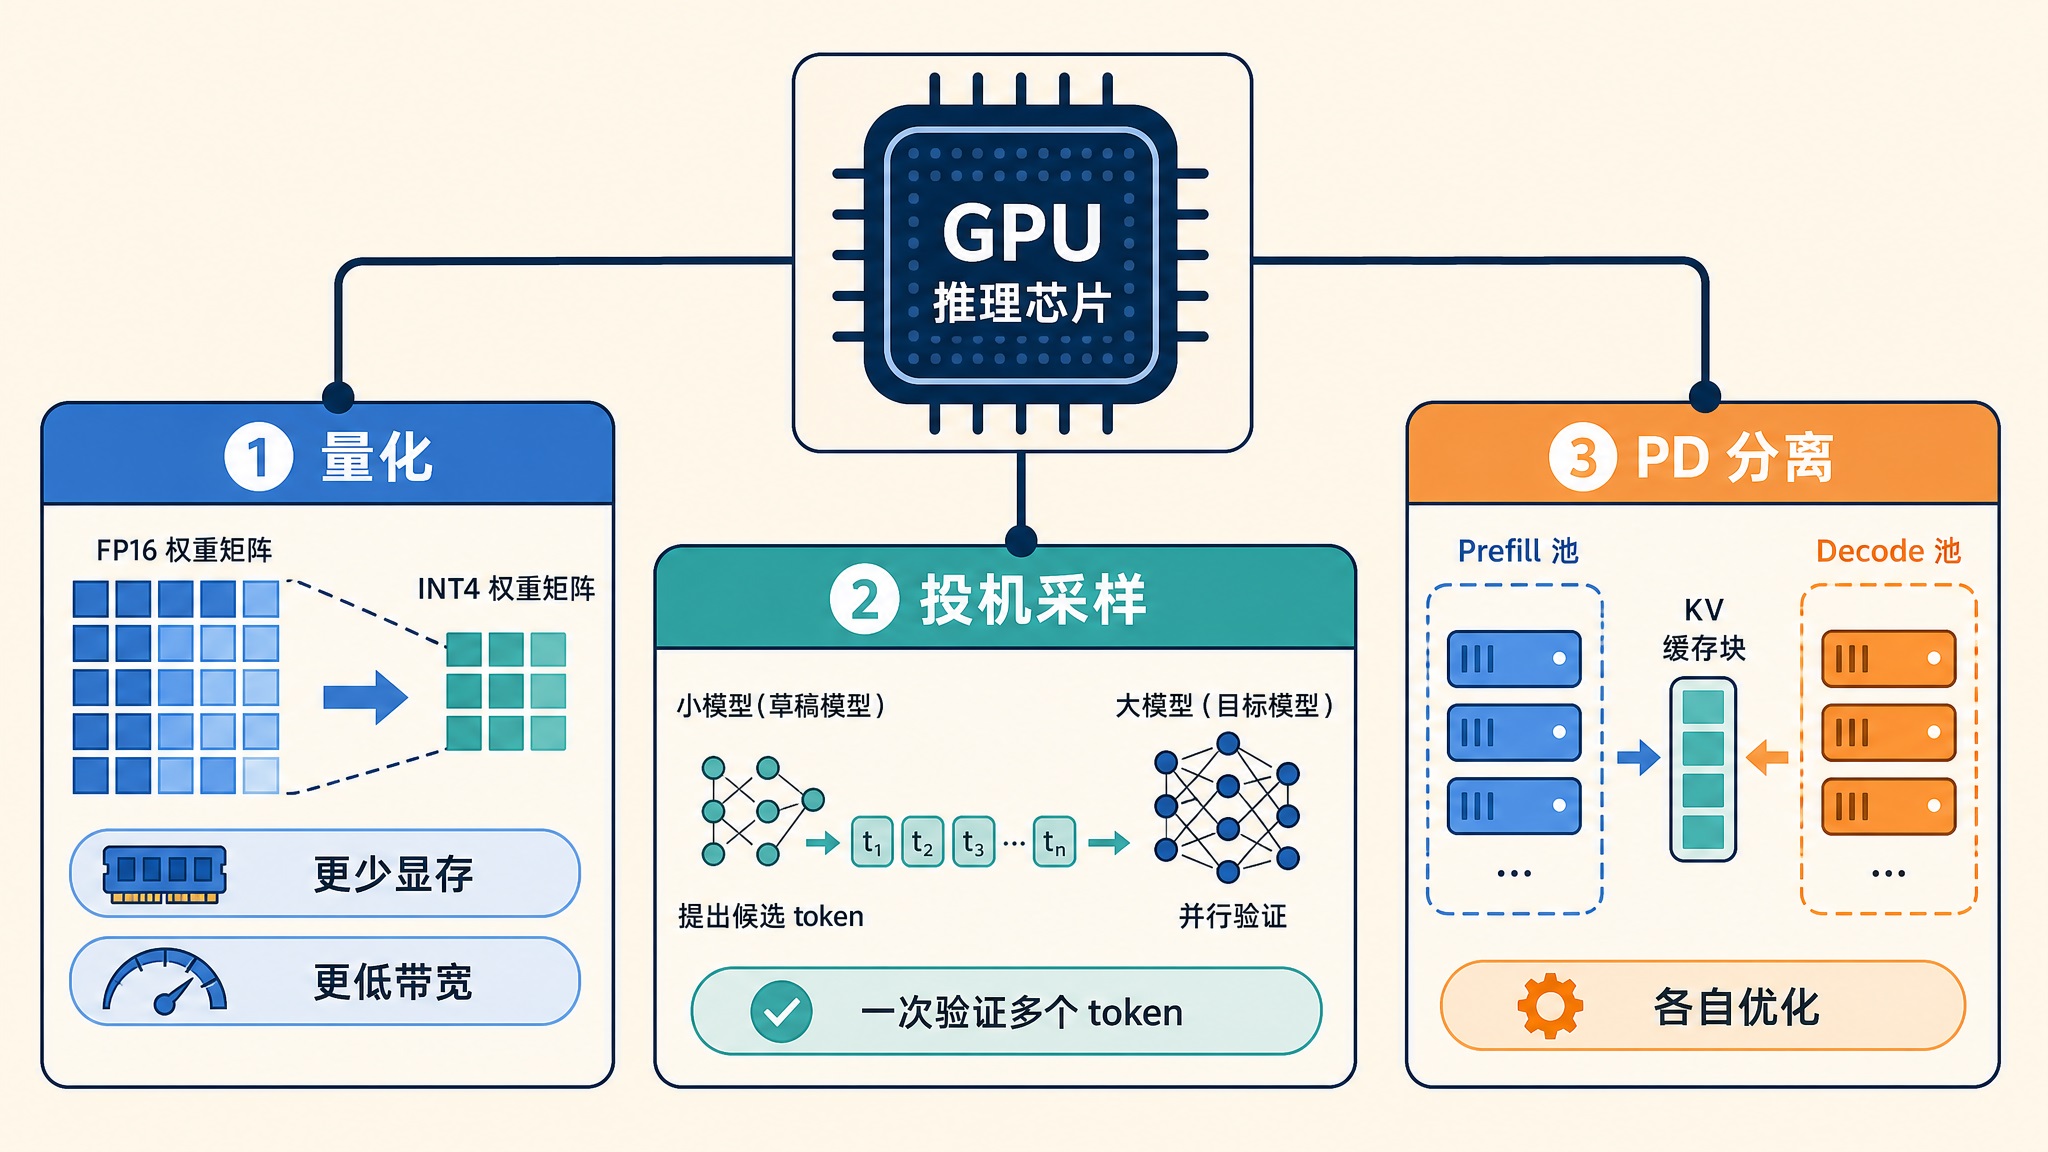
今天我们要讲的三个技术更激进一些。它们会直接改动模型的存储精度、改动生成 token 的方式、改动整个集群的部署形态,目标只有一个:让推理跑得更快。这三类技术分别是量化(Quantization)、投机采样(Speculative Decoding) 和 PD 分离(Prefill/Decode Disaggregation),下面我们逐个来看。
inference-acceleration-overview.jpg

量化:把 FP16 权重压到 4bit

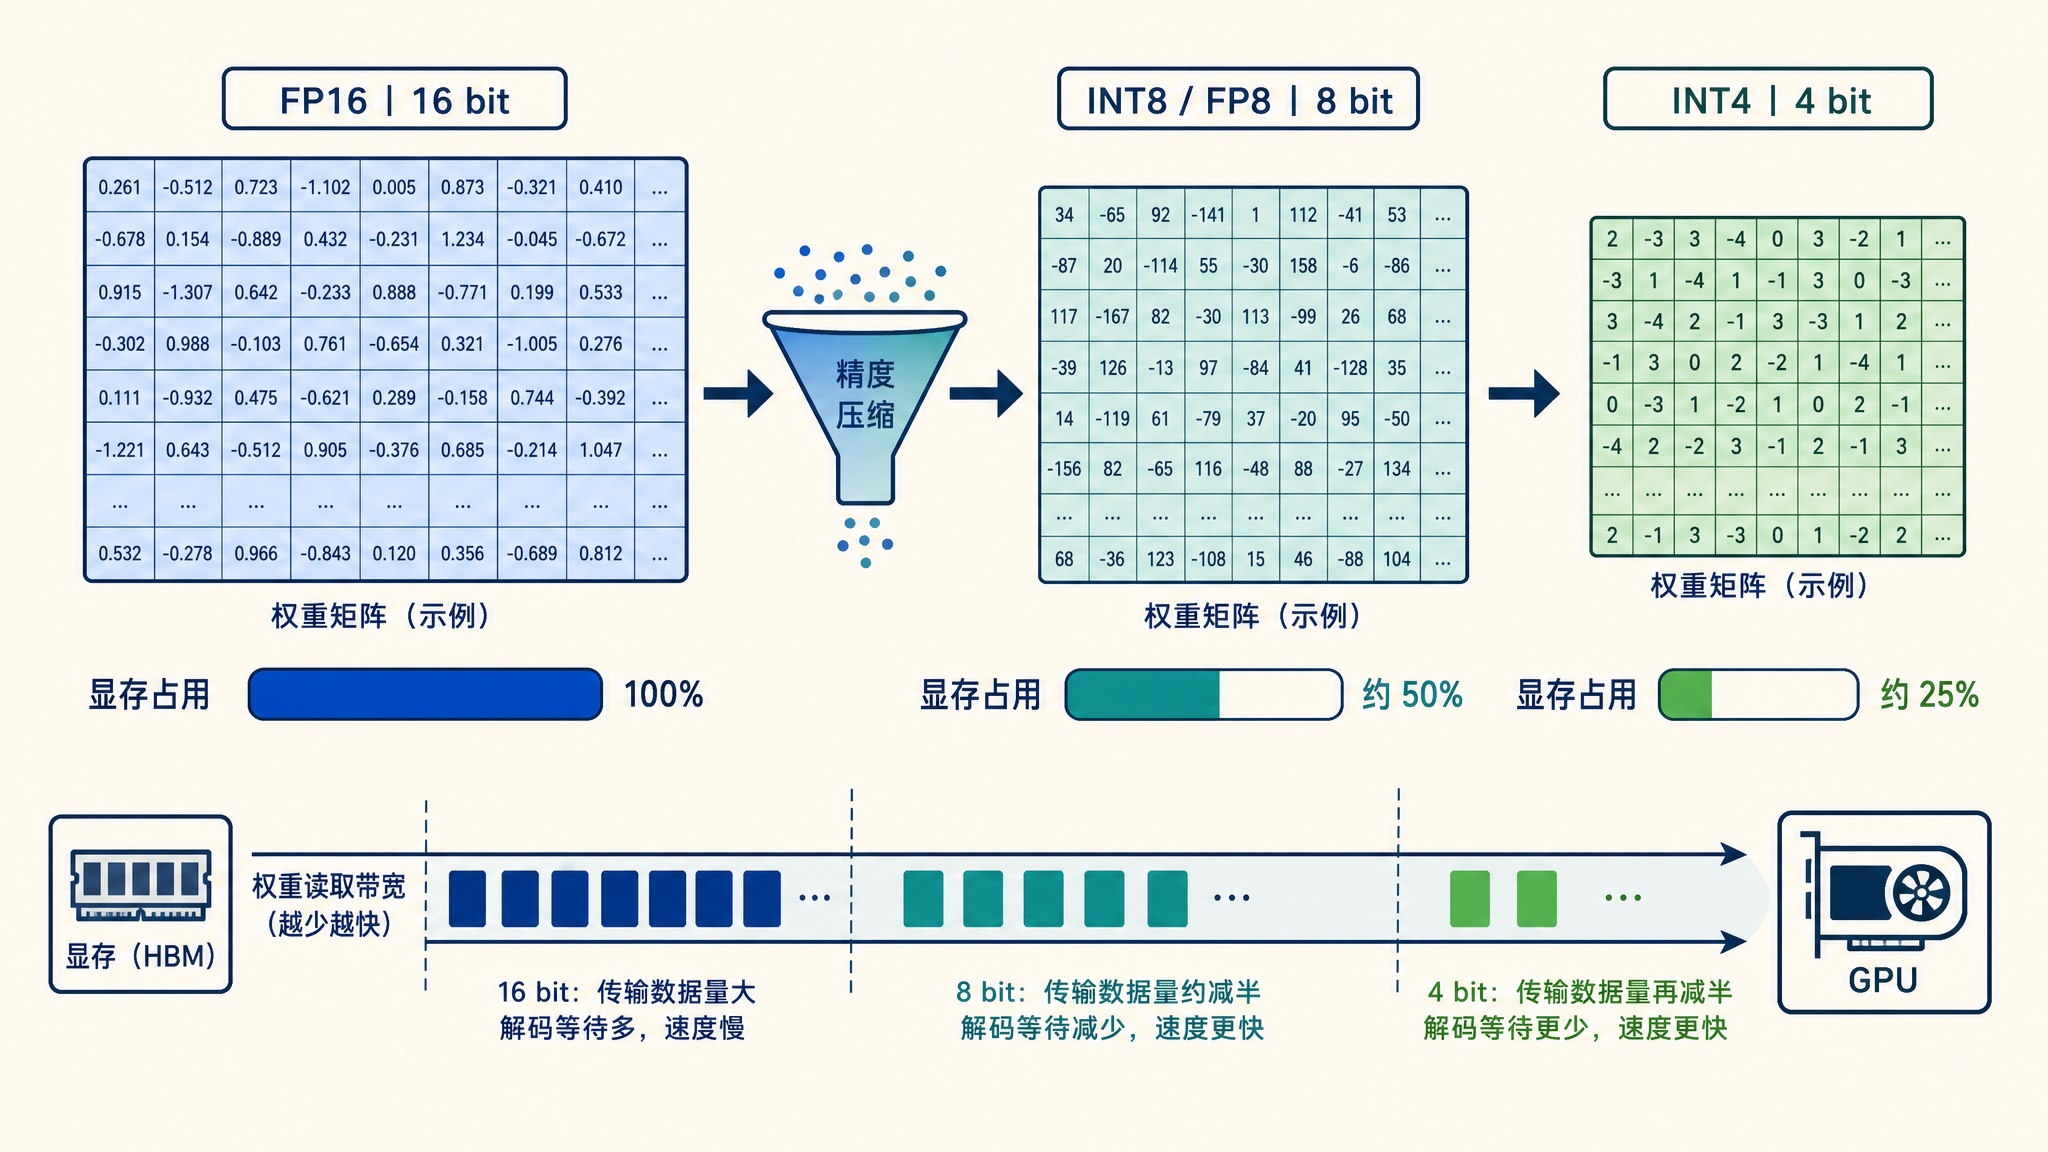
量化(Quantization) 是指把模型参数从高精度数值(如 FP16,每个参数占 2 字节)转换成低精度数值(如 INT8、INT4)存储和计算的技术。一个 7B 模型用 FP16 存要 14 GB 显存,压到 4bit 后只需要 4 GB 左右,原本单卡放不下的模型,现在一张卡就能跑。

量化带来的收益是双重的。一是显存占用直接按位宽比例下降;二是第六篇讲过,decode 阶段是显存带宽瓶颈,每生成一个 token 都要把全部权重从显存读一遍,权重体积小了,读取就快,decode 速度也就跟着上去了。

从 W4A16 说起

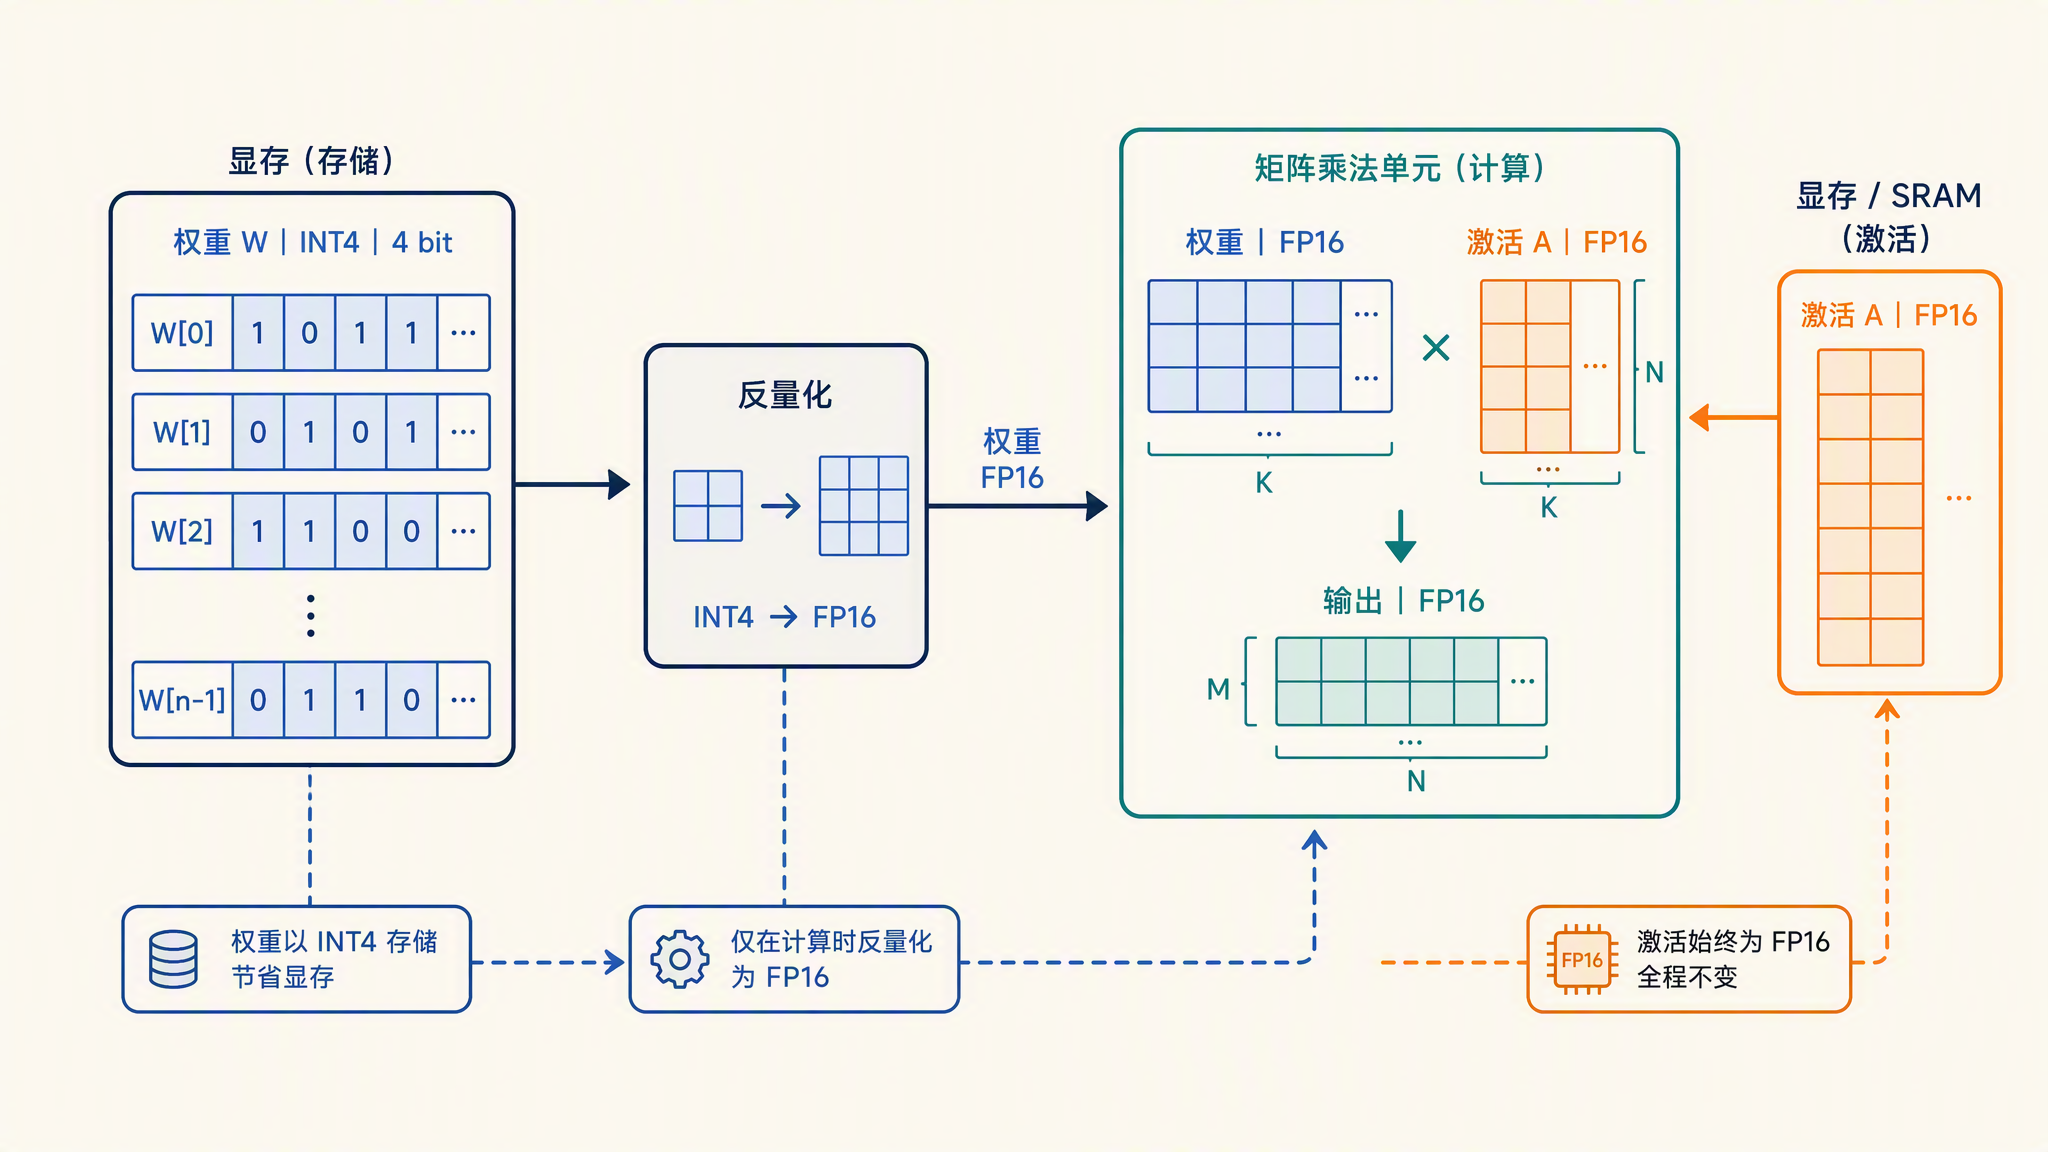
量化方案常用 W 和 A 两个数字命名。W 是权重(Weight)的位宽,A 是激活(Activation,即前向计算中每一层的中间结果)的位宽。W4A16 表示权重压成 4bit、激活保持 16bit,是目前最常见的配置。

为什么只压权重不压激活?因为激活里存在少量数值特别大的离群通道(outlier channel),硬压到低精度会产生很大的误差;而权重分布比较平滑,压缩余地大。权重在加载时一次性量化好,激活在推理时动态计算,所以 W4A16 的实际做法是:显存里存 4bit 权重,计算时先反量化(dequantize)回 FP16 再做矩阵乘。显存和带宽的收益照拿,计算本身还是 FP16 精度,这是它精度损失小的原因。

所谓通道,就是激活向量的一个维度。模型的隐藏状态是一个几千维的向量,研究者发现,其中少数几个维度上的数值会系统性地比其他维度大出几十倍甚至上百倍,这些维度就是离群通道。量化要按数值范围定刻度,这几个大通道会把刻度撑得很大,其余占绝大多数的普通数值只能挤在刻度底部的一小段里,舍入误差就被放大了。这个现象由 LLM.int8() 论文 系统研究过,模型规模越大越明显。
w4a16-dataflow.png

GPTQ:逐层二阶误差补偿

GPTQ 是 Frantar 等人在 2022 年提出的后训练量化(Post-Training Quantization,PTQ) 方法,论文是 GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers。后训练量化的意思是,模型训练完成后,不需要重新训练,只用一小批校准数据就能把权重量化好。

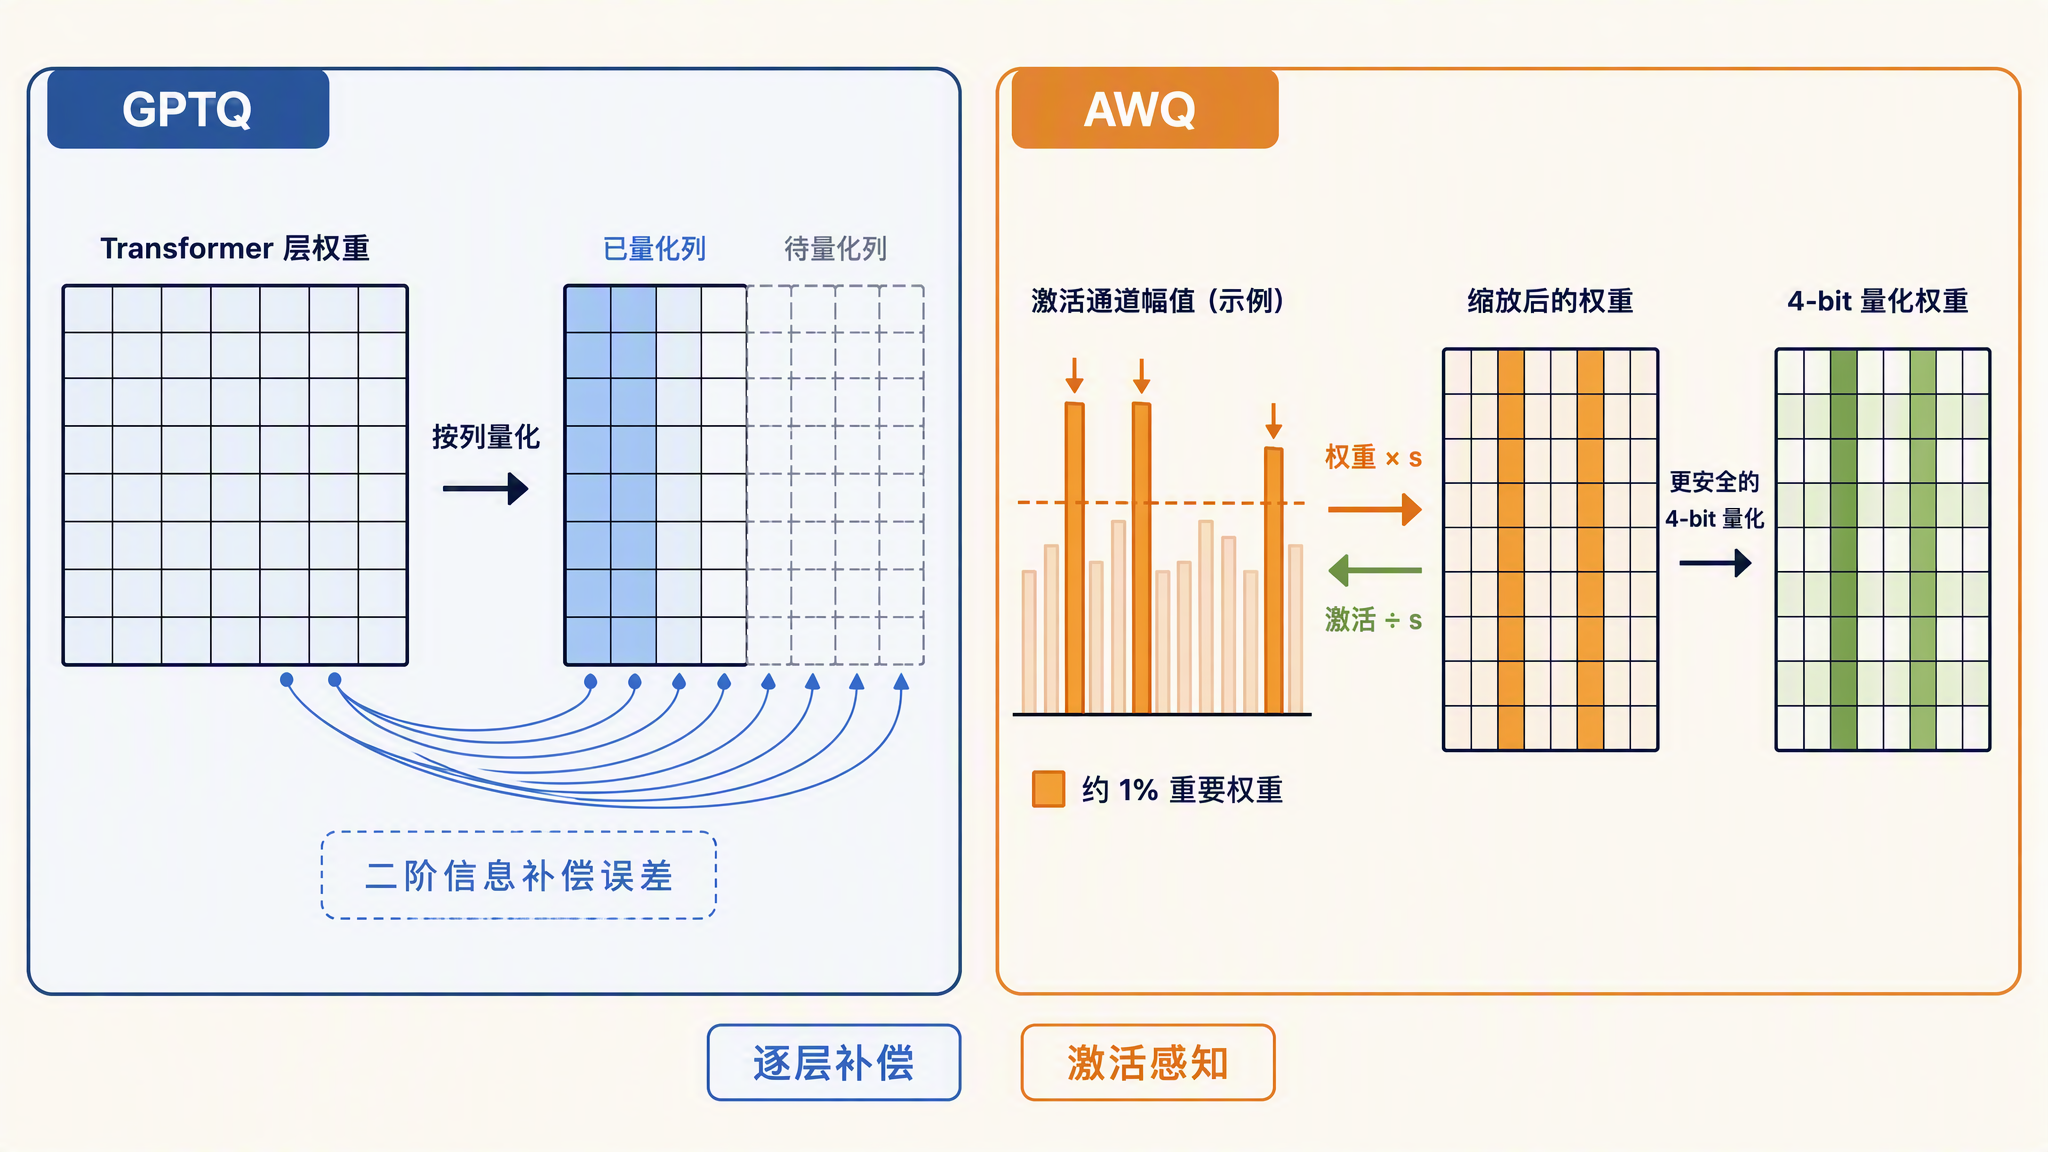
GPTQ 的核心思想是逐层量化,并且每量化一个权重,就用这一层的二阶信息(近似 Hessian 矩阵)调整剩余还没量化的权重,把刚引入的误差补偿掉。这样误差不会在层内累积,模型在 4bit 甚至 3bit 下仍能保持接近原始的精度。论文报告,175B 参数的模型大约 4 个 GPU 小时就能完成量化,在 A100 上端到端推理加速约 3.25 倍。

AWQ:激活感知,保护重要权重

AWQ(Activation-aware Weight Quantization,激活感知权重量化) 是 Lin 等人在 2023 年提出的方法,来自 MIT 韩松团队,论文发表在 MLSys 2024。它的出发点是一个观察:模型里只有约 1% 的权重对输出影响大,而且这些重要权重不能从权重自身的大小看出来,要从激活的分布里看。哪个权重通道对应的激活值大,哪个通道就重要。

找到这 1% 之后,最简单的保护办法是把它们保留成 FP16,但混合精度对硬件不友好。AWQ 的做法更巧:给重要通道的权重乘上一个缩放系数,同时把对应的激活除以同一个系数。数学上输出不变,但缩放后的权重在量化时落入了更安全的区间,等效于获得了更高的有效精度。AWQ 校准快、4bit 下精度表现好,vLLM、SGLang、TensorRT-LLM 都内置了支持,是目前部署 4bit 模型的主流选择。
gptq-awq-comparison.png

FP8:新硬件的原生支持

INT8 和 INT4 量化都需要反量化和专门的 kernel 支持,而 FP8(8 位浮点数) 走的是另一条路:让硬件直接支持低精度浮点运算。NVIDIA 从 Hopper 架构(H100)开始在 Tensor Core 里原生支持 FP8(支持 e4m3 和 e5m2 两种格式),FP8 的算力正好是 FP16 的两倍;到 Blackwell 架构(B200)又进一步支持到 FP4。

硬件原生支持意味着不需要反量化步骤,矩阵乘直接在 FP8 下完成,显存减半的同时算力翻倍。vLLM 里开启动态 FP8 只需要一个参数 --quantization="fp8",不需要准备校准数据,官方文档有详细说明。代价是 FP8 依赖新硬件,A100 及更早的卡用不了。

精度、显存、速度的三方权衡

量化没有免费的午餐,它是三个维度之间的权衡。把常见的几档方案放在一起对比:

方案权重位宽激活位宽权重显存(相对 FP16)精度损失硬件要求典型场景
FP16/BF161616100%无所有 GPU精度敏感、显存充足
FP8 W8A888约 50%极小Hopper / Blackwell 等新卡数据中心高吞吐服务
INT8 W8A888约 50%小广泛支持通用的保守压缩
W4A16(GPTQ/AWQ)416约 25%可感知但可控几乎所有 GPU单卡跑大模型、边缘部署

选择时的经验法则是:有新卡就优先 FP8,它几乎不掉精度;要在消费级显卡上塞进大模型就用 W4A16;对精度极度敏感的场景就保持 FP16,把优化留给别的手段。
quantization-concept.jpg

动手:加载一个量化模型

Hugging Face 上很多热门模型都有官方发布的 AWQ 版本,模型名里带 AWQ 后缀。用 Transformers 加载量化模型和普通模型写法完全一样:

from transformers import AutoModelForCausalLM, AutoTokenizer

# 加载 Qwen3-4B 的 4bit AWQ 量化版本,需要安装 autoawq
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-4B-AWQ",
    device_map="auto",
)
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-4B-AWQ")

messages = [{"role": "user", "content": "用一句话解释什么是模型量化"}]
inputs = tokenizer.apply_chat_template(
    messages,
    return_tensors="pt",
    add_generation_prompt=True,
    enable_thinking=False,
).to(model.device)
output = model.generate(inputs, max_new_tokens=100)
print(tokenizer.decode(output[0], skip_special_tokens=True))

可以看到,API 层面没有任何区别,量化对使用者是透明的。变化的只有显存占用和生成速度。

投机采样:小模型猜,大模型验

投机采样(Speculative Decoding,也叫投机解码) 是 Leviathan 等人在 2023 年发表的加速技术,论文是 Fast Inference from Transformers via Speculative Decoding。同一时期 DeepMind 的 Chen 等人也独立提出了等价的 Speculative Sampling。

为什么验证 k 个和生成 1 个一样快

要理解投机采样,先回忆第六篇讲过的结论:decode 阶段每步只处理一个新 token,矩阵乘的规模很小,GPU 算力大量闲置,耗时主要花在把权重从显存搬进计算单元。也就是说,一次前向处理 1 个 token 和处理 5 个 token,读取权重的开销是一样的,总耗时几乎相同。

自回归生成的低效就在这里:每步只产出 1 个 token,却付出了读取全部权重的代价。投机采样的思路是,既然一次前向验证多个 token 几乎不多花时间,那就让一个便宜的小模型先猜,大模型负责验收。
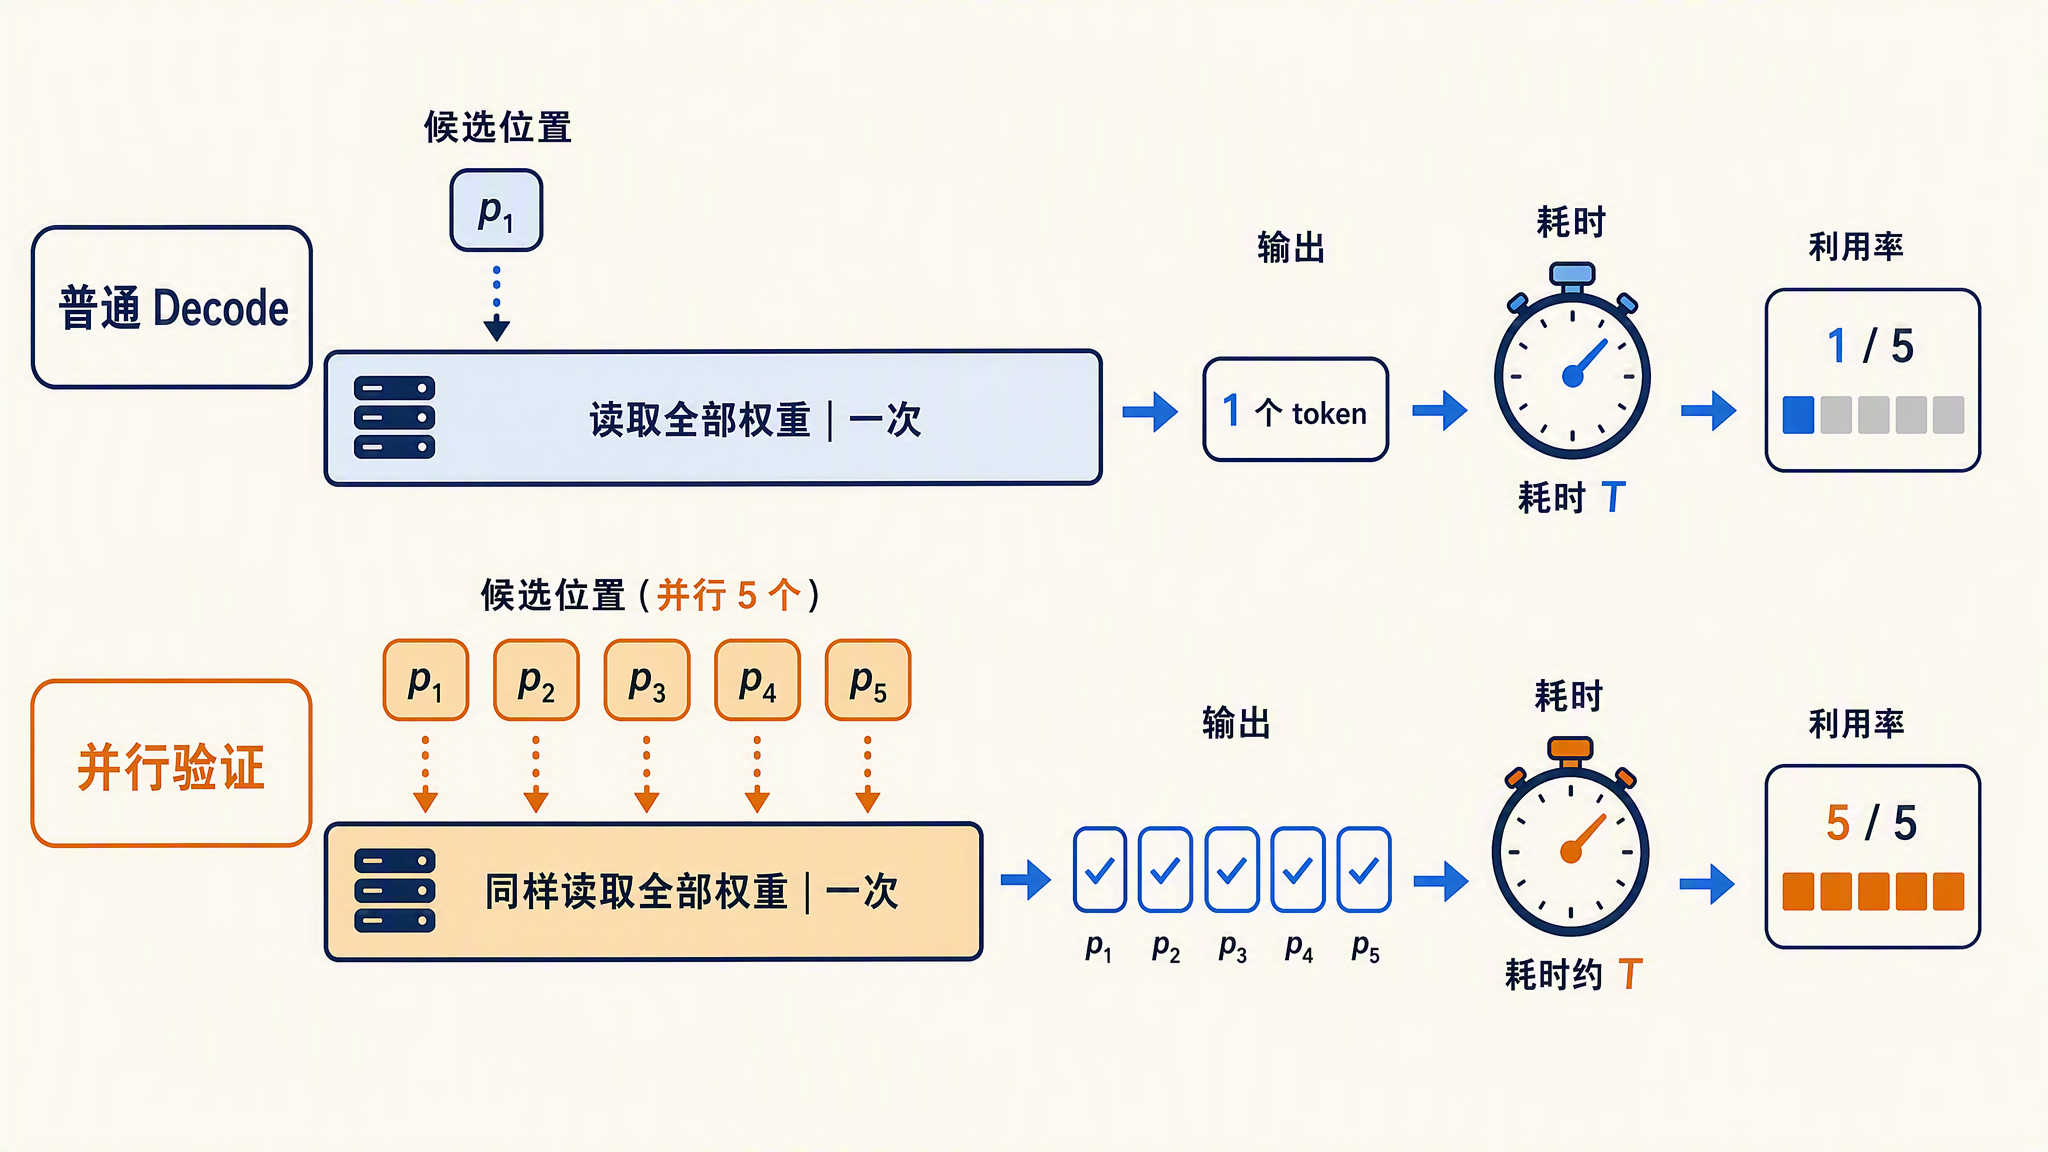
speculative-verification-cost.png

工作流程

具体流程分三步。首先,用一个草稿模型(draft model)(同系列的小尺寸模型,比如参数量小几十倍)自回归地快速猜出 k 个候选 token。然后,把这 k 个 token 拼在现有序列后面,让大模型做一次前向,并行算出这 k 个位置各自的概率分布。最后逐个比对:如果大模型也认可某个 token 就接受,遇到第一个不认可的位置就停下,用修正策略在那里重新采样一个 token,后面的猜测全部作废,它们在 KV Cache 里刚算出的条目也跟着丢弃。

为什么一次前向就能验 k 个位置呢?不知道读者还记不记得第四篇的末尾埋下的那个彩蛋。当时跑前向传播时发现,输入 3 个 token,输出的 logits 形状是 [1, 3, 151936],每个位置都有一份完整的词表分数,只是自回归生成只取最后一个位置的,其余都扔掉了。投机采样就是把这些扔掉的分布捡起来用:把前缀和 k 个候选拼成一整段做一次前向,候选 token 所在位置的那几行分布,就是大模型「自己生成到这一步会选什么」的答案。由于有因果掩码的保证,每个位置只能看到自己和左边的 token,这几行分布和跑 k 步 decode 逐个算出的分布是同一份结果,区别只在于权重读取从 k 次合并成了一次。整个过程中大模型没有生成任何 token,它只是给现成的 token 打了分。

一轮下来,最坏的情况是接受 1 个修正 token(和普通 decode 一样,不亏),最好的情况是一次收下 k+1 个 token。下图是这三步流程的一个示意:

speculative-decoding-workflow.png

这个设计有一个非常重要的性质:由于接受和重采样规则是严格按大模型的概率分布推导的,最终输出的分布和不用投机采样时完全一致。它是无损加速,不像量化那样需要担心精度损失。实际加速倍数取决于接受率(acceptance rate),即小模型猜得有多准。小模型和大模型越同宗同源(比如同一系列的 1B 对 70B),用词习惯越接近,接受率就越高。

接受率还和采样温度有关。贪心解码(temperature 为 0)时,小模型只要猜中大模型概率最高的那个 token 就算命中,接受率最高;温度调高、随机性变大后,猜测变难,加速效果会打折扣。

动手:在 Transformers 里开启投机采样

Transformers 的 generate 原生支持投机采样,只需要多传一个 assistant_model 参数。下面我们加载 Qwen3-4B 作为目标模型,用同系列的 Qwen3-0.6B 当 draft 模型:

from transformers import AutoModelForCausalLM, AutoTokenizer

# 目标大模型和 draft 小模型,同系列才能保证词表一致
target = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-4B", device_map="auto")
draft = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-0.6B", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-4B")

messages = [{"role": "user", "content": "写一首关于秋天的短诗"}]
inputs = tokenizer.apply_chat_template(
    messages,
    return_tensors="pt",
    add_generation_prompt=True,
    enable_thinking=False,
).to(target.device)

# 传入 assistant_model 即开启投机采样,生成结果和不传时分布一致
output = target.generate(inputs, assistant_model=draft, max_new_tokens=200)
print(tokenizer.decode(output[0], skip_special_tokens=True))

可以看到,用法上只多了一行参数。draft 模型必须和目标模型共用同一个词表,否则两边对 token 的编号对不上,验证无从谈起,这也是 draft 模型通常选同系列小模型的原因之一。

改进方向

原版投机采样需要额外部署和维护一个小模型,后续工作沿着去掉独立小模型的方向演进。Medusa 的做法是给大模型本身加几个额外的解码头,一次预测后面多个位置的 token,不再需要单独的 draft 模型。EAGLE 更进一步,在大模型的倒数第二层特征上做外推来生成候选,接受率比 Medusa 更高。这两个都是当前推理框架里常见的可选项,细节这里就不展开了,感兴趣的同学可以查阅相应的资料。

PD 分离:prefill 和 decode 各司其职

第三个技术从系统层面入手,它改的不是模型而是部署形态。

两类负载天生不合

我们已经不止一次讲过 prefill 和 decode 的负载差异:prefill 一次性处理全部输入 token,矩阵规模大,吃算力(compute-bound);decode 每步只处理一个 token,反复读权重和 KV Cache,吃带宽(memory-bound)。传统的部署方式把两个阶段放在同一批 GPU 上混跑,因此一个 prefill 请求进来,会抢走 decode 请求的算力,正在生成的用户会感到 token 输出卡顿;反过来,大量 decode 请求占着 KV Cache 显存,prefill 又排不上队。两个阶段互相拖累,而且它们对并行策略、批大小的最优配置完全不同,混在一起只能取一个两头将就的中间值。

前面讲连续批处理时介绍过的分块预填充,就是在引擎内部缓解这种干扰的办法,把长 prefill 切块混进 decode 迭代里跑。今天这个技术的思路更彻底,直接从部署层面把两个阶段分开。

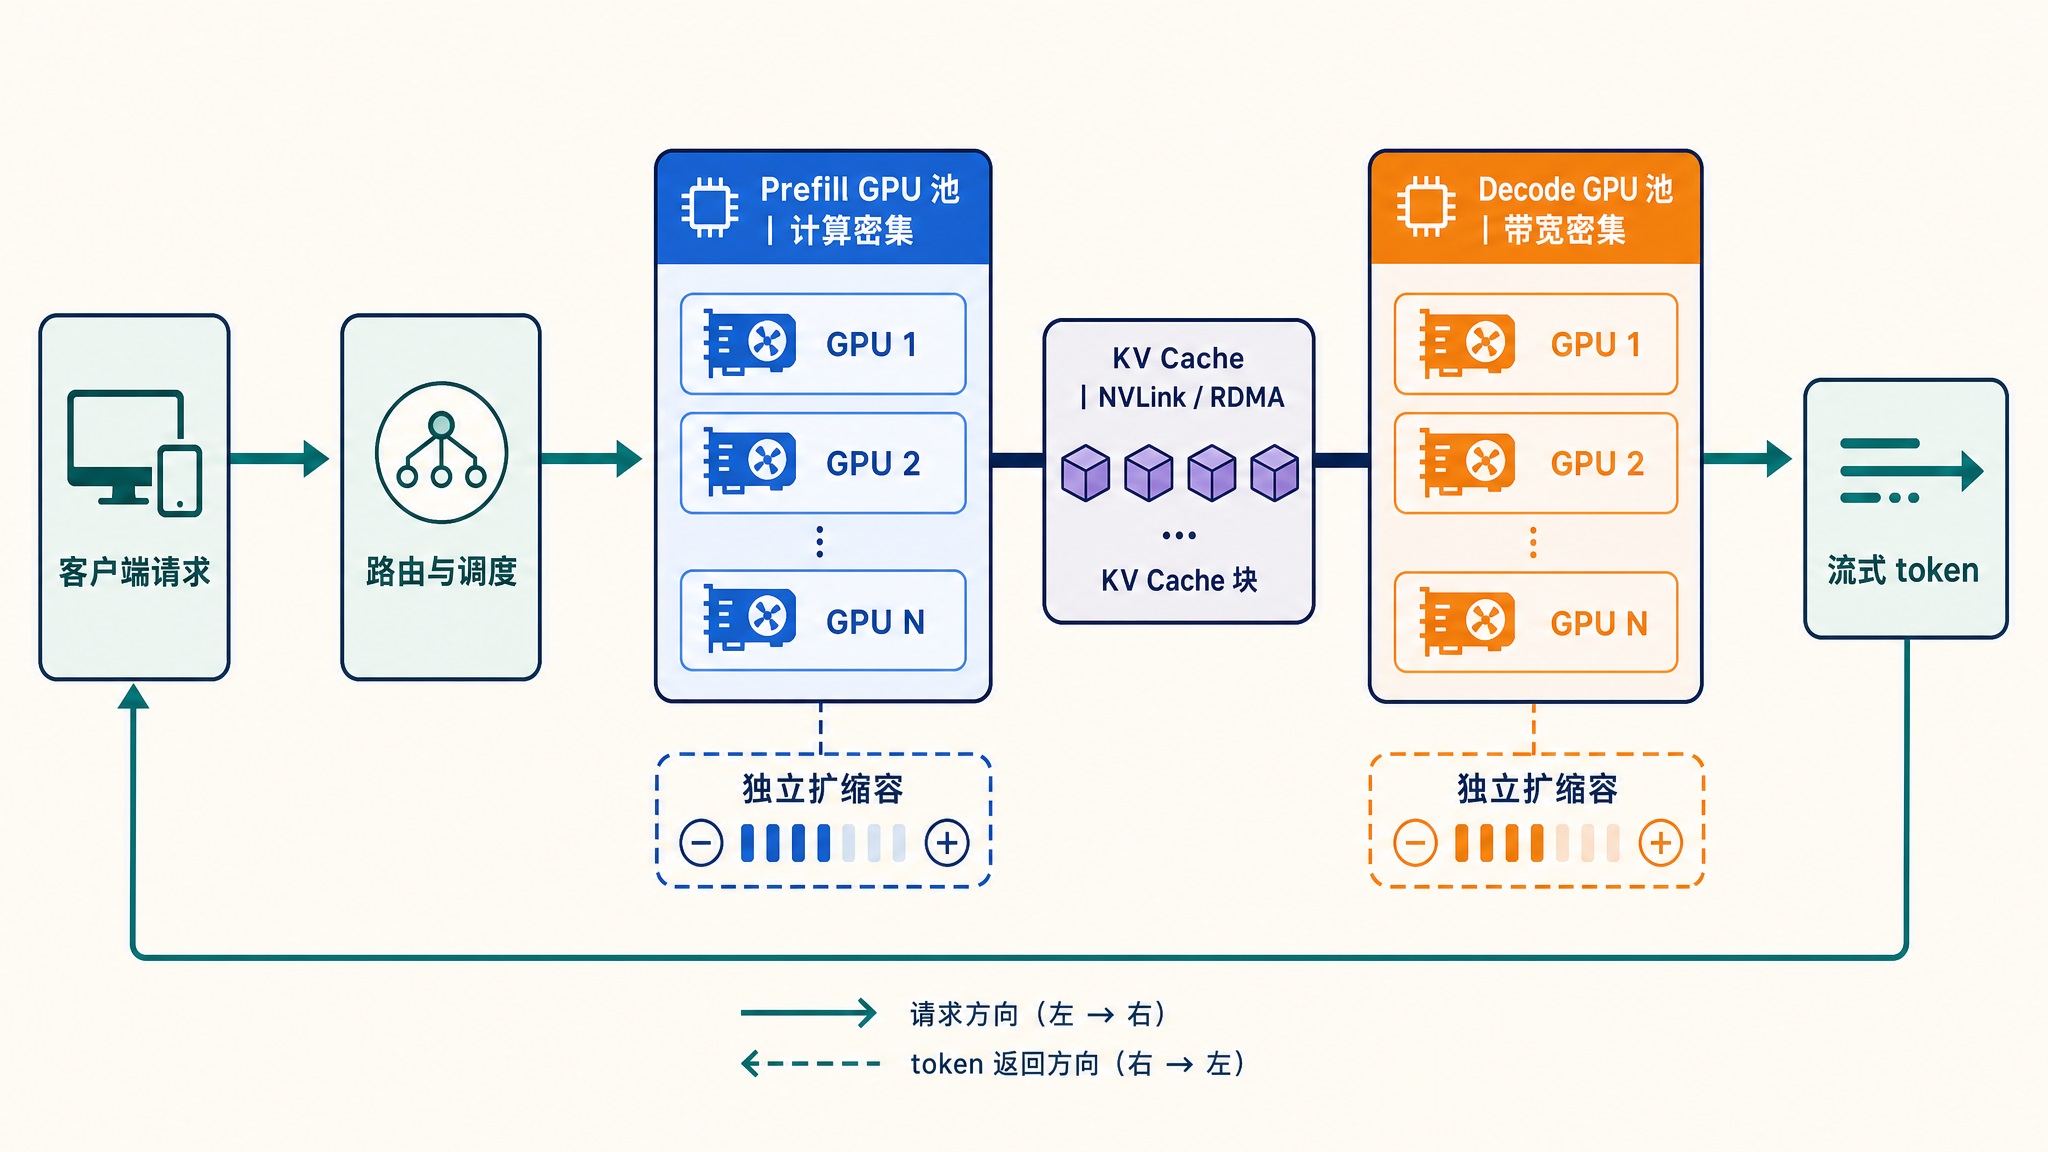
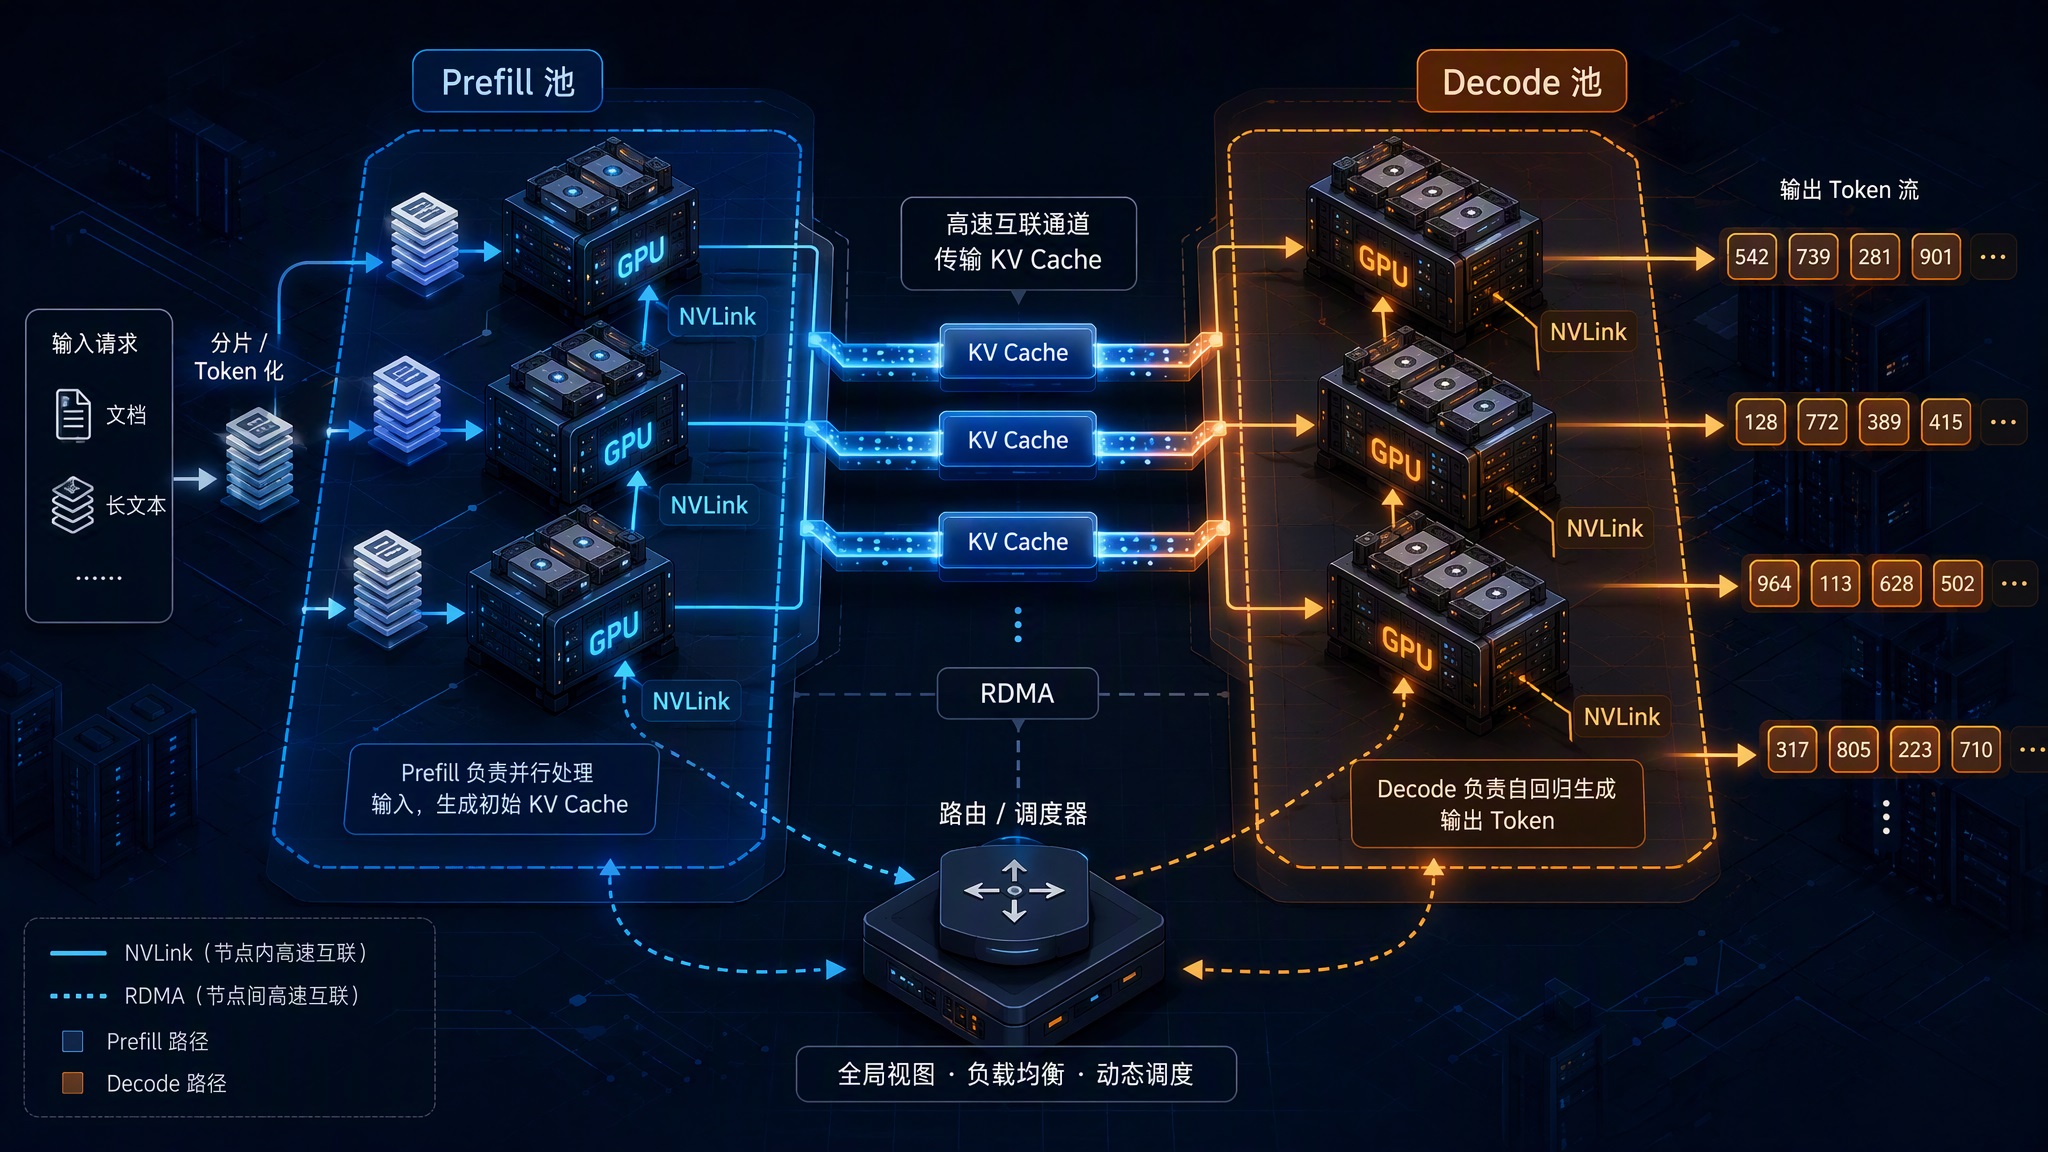
PD 分离(Prefill/Decode Disaggregation,预填充与解码分离) 的做法是把两个阶段拆到两个独立的 GPU 池:prefill 池专门处理输入、算好 KV Cache,然后通过高速网络(NVLink 或 RDMA)把 KV Cache 传给 decode 池,decode 池接力做逐 token 生成。两个池可以按各自的负载特征独立扩缩容、独立选并行策略。整体架构如下:
pd-disaggregation-architecture.jpg

KV Cache 的传输是这套架构的主要开销。一个长上下文的请求,KV Cache 可能有几个 GB,跨机传输必须走高速互联。NVLink 是 NVIDIA GPU 之间的高速互联总线,适合节点内部。RDMA(Remote Direct Memory Access,远程直接内存访问)是一种让一台机器直接读写另一台机器内存的网络技术,绕开两端的 CPU 和操作系统内核,适合跨节点。如果没有这个级别的带宽,省下来的计算时间全搭在搬运上。所以 PD 分离是规模化的技术,请求量大到能填满两个池子时才划算。
pd-disaggregation-cluster.jpg

代表工作

PD 分离这两年从论文走进了生产系统,下面是几个代表性实现:

  • DistServe:2024 年发表于 OSDI 的学术工作,是把 PD 分离系统化的早期代表。它给两个阶段分别优化资源配置和并行策略,并用带宽感知的放置策略尽量让 KV Cache 走节点内的 NVLink。论文报告,在满足延迟目标的前提下,能比当时最先进的系统多服务最多 7.4 倍的请求
  • Mooncake:月之暗面(Moonshot AI)为 Kimi 搭建的生产级推理平台,发表于 USENIX FAST 2025。它在 PD 分离的基础上更进一步,以 KV Cache 为中心设计,把集群里的 CPU 内存、SSD 和 RDMA 网络池化成一个分布式 KV 缓存,长上下文和多轮对话的前缀复用是它的强项
  • NVIDIA Dynamo:NVIDIA 在 GTC 2025 发布的分布式推理框架,Triton Inference Server 的继任者,PD 分离是它的核心特性之一,并配套了专门做跨机 KV Cache 传输的 NIXL 库
  • vLLM:开源推理引擎也在原生支持 P/D disaggregation,提供了 KV 传输的连接器接口和部署示例,可以在自己的集群里搭一套分离式服务

如果想从工程落地的角度进一步了解这套架构,DigitalOcean 有一篇 Prefill/Decode 分离的实践解析,对部署细节的拆解比较细,感兴趣的同学可以看看。

再往上:张量并行与流水并行

最后简单提一下更大规模的推理。当模型大到单卡放不下时,就得把模型本身拆开。张量并行(Tensor Parallelism,TP) 是把每一层的权重矩阵切开,几张卡各算一部分,每层算完都要做一次卡间通信合并结果,对互联带宽的要求很高,一般限制在节点内的 NVLink 上。流水并行(Pipeline Parallelism,PP) 是把模型的层切成几段,每张卡负责连续的一段,请求像流水线一样在卡之间传递,只在段的边界通信,通信量小,但段与段交接时会留下空闲的气泡,适合跨节点部署。实际的大模型部署往往是 TP、PP 加上今天讲的 PD 分离组合使用,这部分作为延伸阅读,今天点到为止。
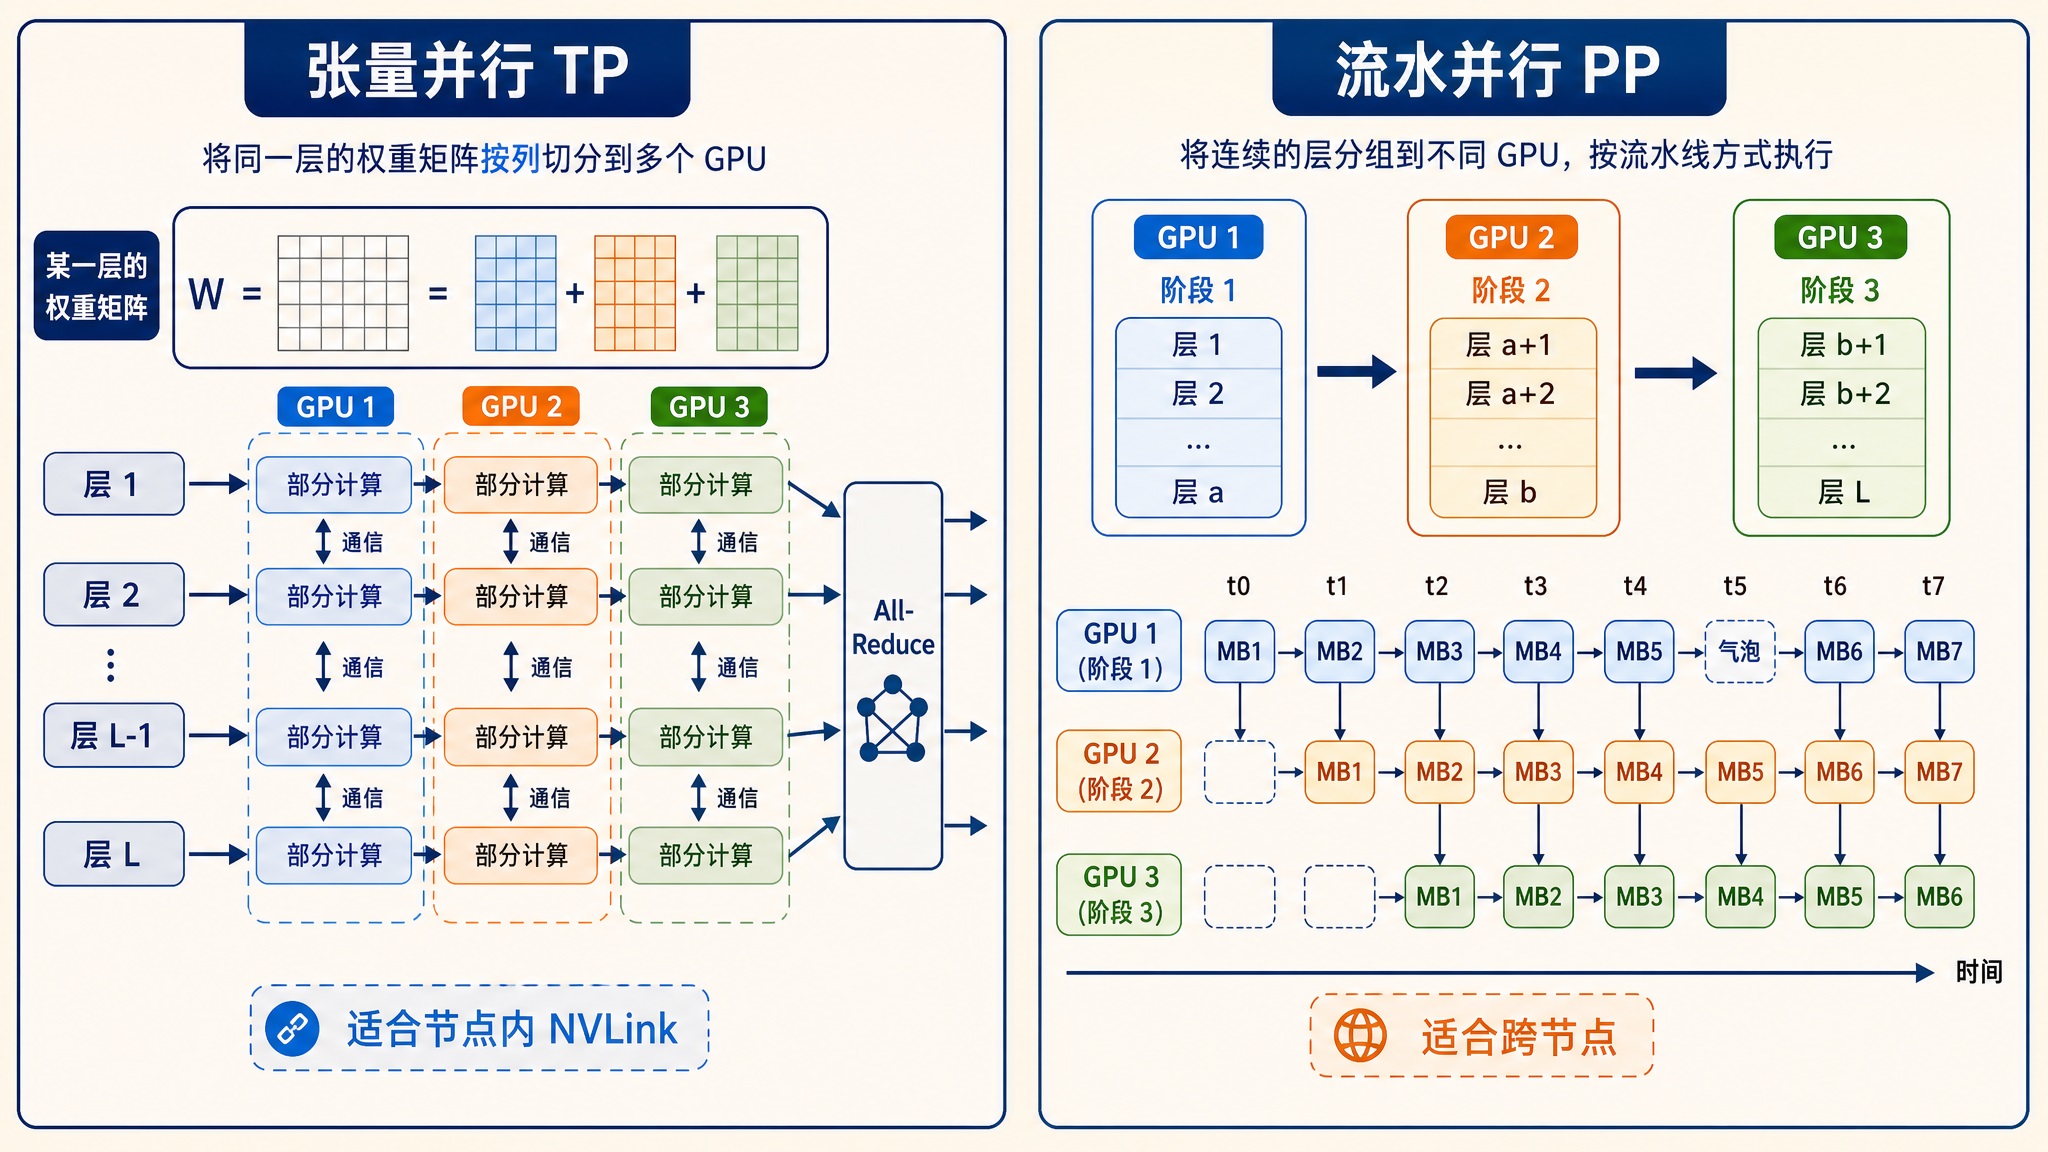
tensor-vs-pipeline-parallelism.jpg

小结

今天我们一口气学了三类推理加速技术:

  1. 量化:把 FP16 权重压到 8bit 或 4bit,显存和带宽收益直接。GPTQ 用逐层二阶信息做误差补偿,AWQ 从激活分布里找出约 1% 的重要权重加以保护,FP8 则依靠 Hopper 和 Blackwell 的原生支持做到几乎无损。选型是精度、显存、速度的三方权衡
  2. 投机采样:用小 draft 模型猜 k 个 token,大模型一次前向并行验证,接受多少算多少。它有效是因为 decode 是带宽瓶颈,验证 k 个 token 和生成 1 个耗时几乎一样,而且输出分布与大模型完全一致,是无损加速。Medusa 和 EAGLE 是去掉独立小模型的改进方向
  3. PD 分离:prefill 吃算力、decode 吃带宽,混在一起互相拖累,拆到两个 GPU 池各自优化,KV Cache 走高速网络传输。DistServe、Mooncake、NVIDIA Dynamo 和 vLLM 是代表性实现
  4. 更大规模的分布式推理:张量并行切权重、流水并行切层,作为延伸阅读

至此,我们对大模型推理的探索之旅也告一段落。从第一篇的全景地图出发,我们跟着一条请求走完了它的完整旅程:分词、嵌入和位置编码、前向传播、KV Cache、prefill 与 decode、采样、流式输出,又深入了连续批处理、显存优化和今天的加速技术。每个环节我们都拆开了原理,也都动手跑过真实的代码。希望这个系列能帮你建立起对大模型推理的整体认识,下次再看到屏幕上逐字蹦出的回答时,脑子里浮现的不只是文字,还有文字背后的整条流水线。

参考


学习大模型推理的显存优化:PagedAttention 与前缀缓存

在上一篇中,我们解决了 GPU 空转的问题:用迭代级调度替代静态批处理,请求随到随入、随完随出,GPU 不再为了等齐一批请求而闲置。调度器的目标很明确,就是往运行集里塞尽可能多的并发请求,把算力吃满。

但并发不是想加就能加的。每个在跑的请求都背着一份 KV Cache,在 KV Cache 那一篇里我们总结过一个公式:缓存大小 = 2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数,可见缓存随序列长度线性增长,再乘上并发数。Qwen3-0.6B 这样的小模型,一个 token 的缓存约 112 KB,一条 4k 序列就是 448 MiB。于是矛盾来了:批处理想并发更多请求,显存却先不够了。现实里限制服务吞吐的,往往不是算力而是显存。

今天这篇就来讲推理显存管理里最经典的两项技术:PagedAttention 和前缀缓存(Prefix Caching)。前者把 KV Cache 的分配方式彻底改掉了,后者在前者的基础上让多个请求共享同一段缓存。

显存都去哪了

要优化显存,先看清一块 GPU 的显存都被谁占了。推理时的显存大致分四块:

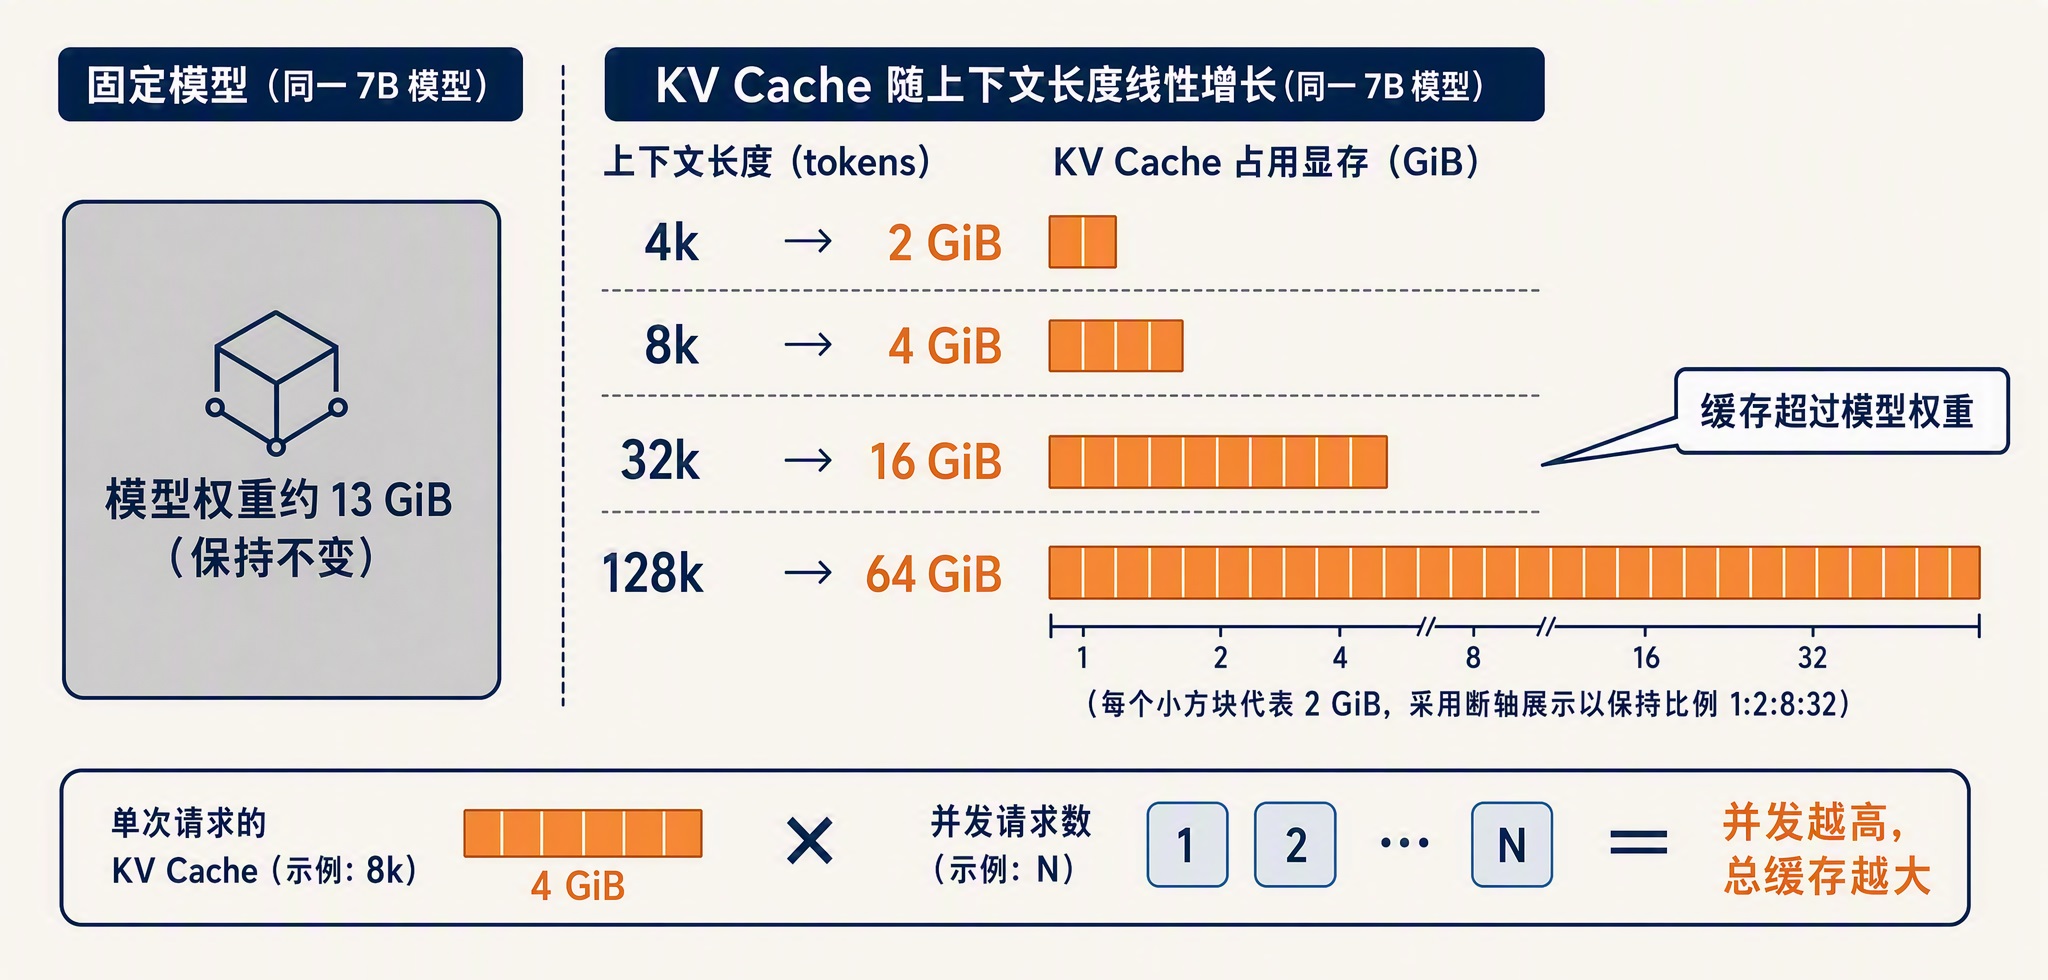
  • 模型权重:加载后就固定不变。一个 FP16 的 7B 模型约 13 GiB,这部分没什么可省的(权重量化是另一篇的话题)
  • KV Cache:所有在跑请求的缓存总和。它随并发数和序列长度动态增长,负载越重涨得越多,是显存里唯一随流量浮动的大头
  • 激活值与临时缓冲:前向计算中间产物的临时显存,比如注意力得分矩阵。单个请求的激活不大,但也随并发涨
  • 碎片与预留:分配器管理显存时产生的缝隙,以及框架自身预留的部分

四块占用的关系示意如下:

gpu-memory-breakdown.png

权重是死的,激活值占比小,真正能做出文章的只有 KV Cache。所以推理引擎的显存优化,几乎全部围绕 KV Cache 的分配和复用展开。

按最大长度预留

先看不做任何优化时,推理系统怎么给 KV Cache 分配显存。最朴素的做法是:请求一进来,就按最大可能长度给它预留一整段连续显存。比如 max_model_len 设成 4096,那不管这条请求最终只用 200 个 token 还是真用满 4096,引擎一开始就按 4096 把一整段显存占住,请求结束才释放。

这个做法实现简单,但浪费是结构性的,主要有三类:

  • 内部碎片(Internal Fragmentation):按最大长度预留,实际用多少算多少,预留出来没用上的部分一直空着。大部分请求的长度远小于上限,空着的部分是常态
  • 预留浪费:请求刚开始生成第 1 个 token 时,后面几千个 token 的位置就已经被锁定,别的请求用不上
  • 外部碎片(External Fragmentation):不同请求要预留的段长不一,显存被切得七零八落。剩余总量可能够,但凑不出一段连续的来满足新请求

因此,真正存了有效 KV 的部分往往只占一小半。vLLM 团队在他们的论文和官方博客里给出过实测:传统系统里这类浪费能占到 KV Cache 显存的 60% 到 80%,也就是说真正用来存数据的只有两三成。显存利用率上不去,能并发的请求数就上不去,continuous batching 攒出来的调度优势也就发挥不出来。

PagedAttention 原理

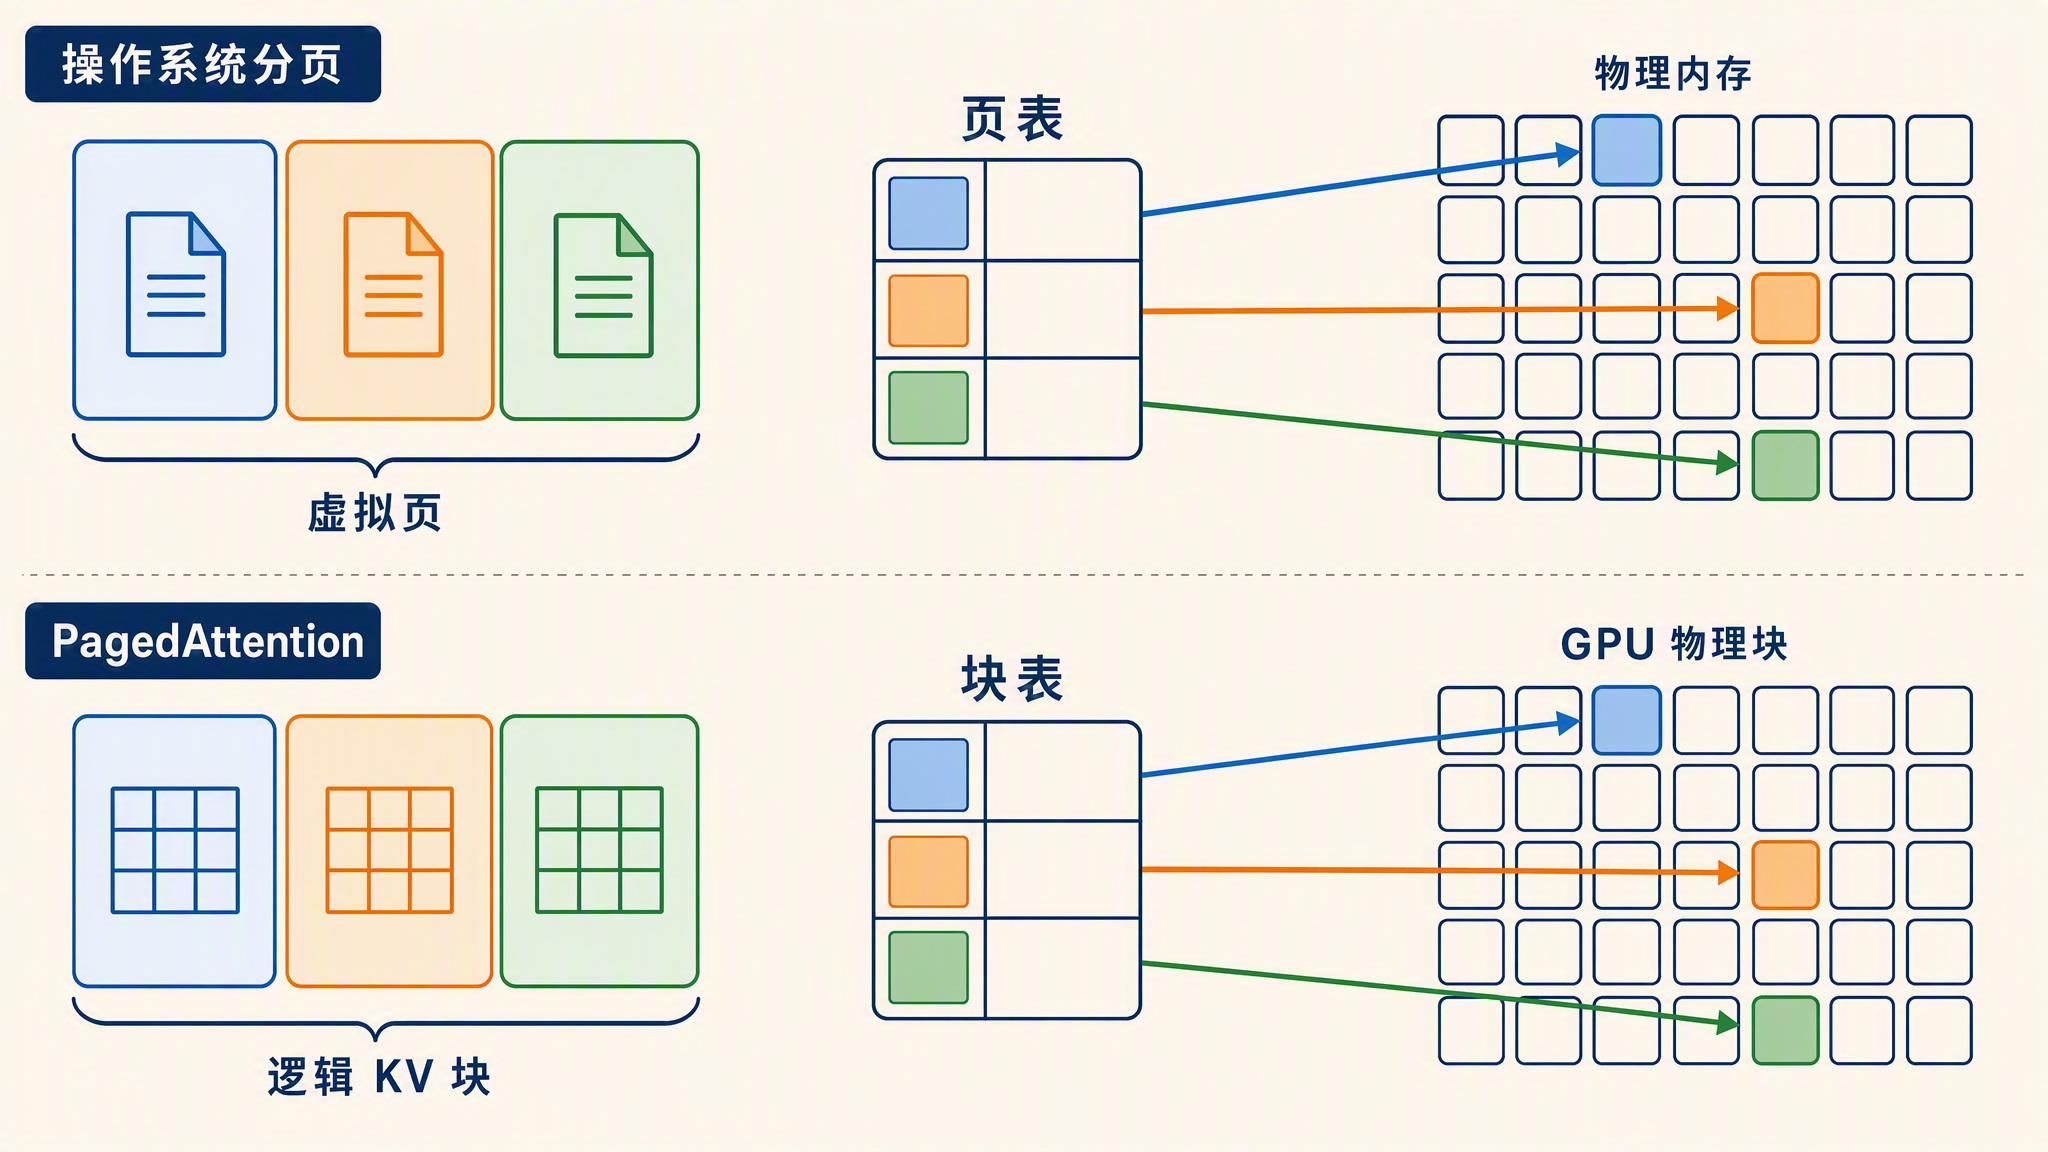
PagedAttention 由 vLLM 团队提出,论文 Efficient Memory Management for Large Language Model Serving with PagedAttention 发表在 SOSP 2023 上,一作是 Woosuk Kwon。它的核心思路来自一个类比:操作系统用虚拟内存分页管理内存,PagedAttention 用同样的办法管理 KV Cache。

先回忆操作系统是怎么管内存的。操作系统从不要求一个进程的内存物理上连续。它把内存切成固定大小的页(Page),进程看到的是一串连续的虚拟地址,背后由页表(Page Table)把虚拟页映射到分散在物理内存各处的物理页。用多少分多少,进程结束就回收。这套机制解决了和上面一模一样的问题:按峰值预留的浪费、大小不一的连续段造成的外部碎片。

PagedAttention 把这套原样搬到了 KV Cache 上:

  • 块(Block):KV Cache 不再是一整段连续空间,而是切成固定大小的块,每块存固定数量 token 的 K 和 V。vLLM 默认一块 16 个 token
  • 逻辑块与物理块:每个请求看到的仍然是一串连续的逻辑块,实际数据存在显存里分散的物理块上,物理块不要求连续
  • 块表(Block Table):维护逻辑块到物理块的映射,角色相当于页表
  • 按需分配:请求每生成满一个块的 token,才向空闲块池申请下一个物理块,不再提前预留

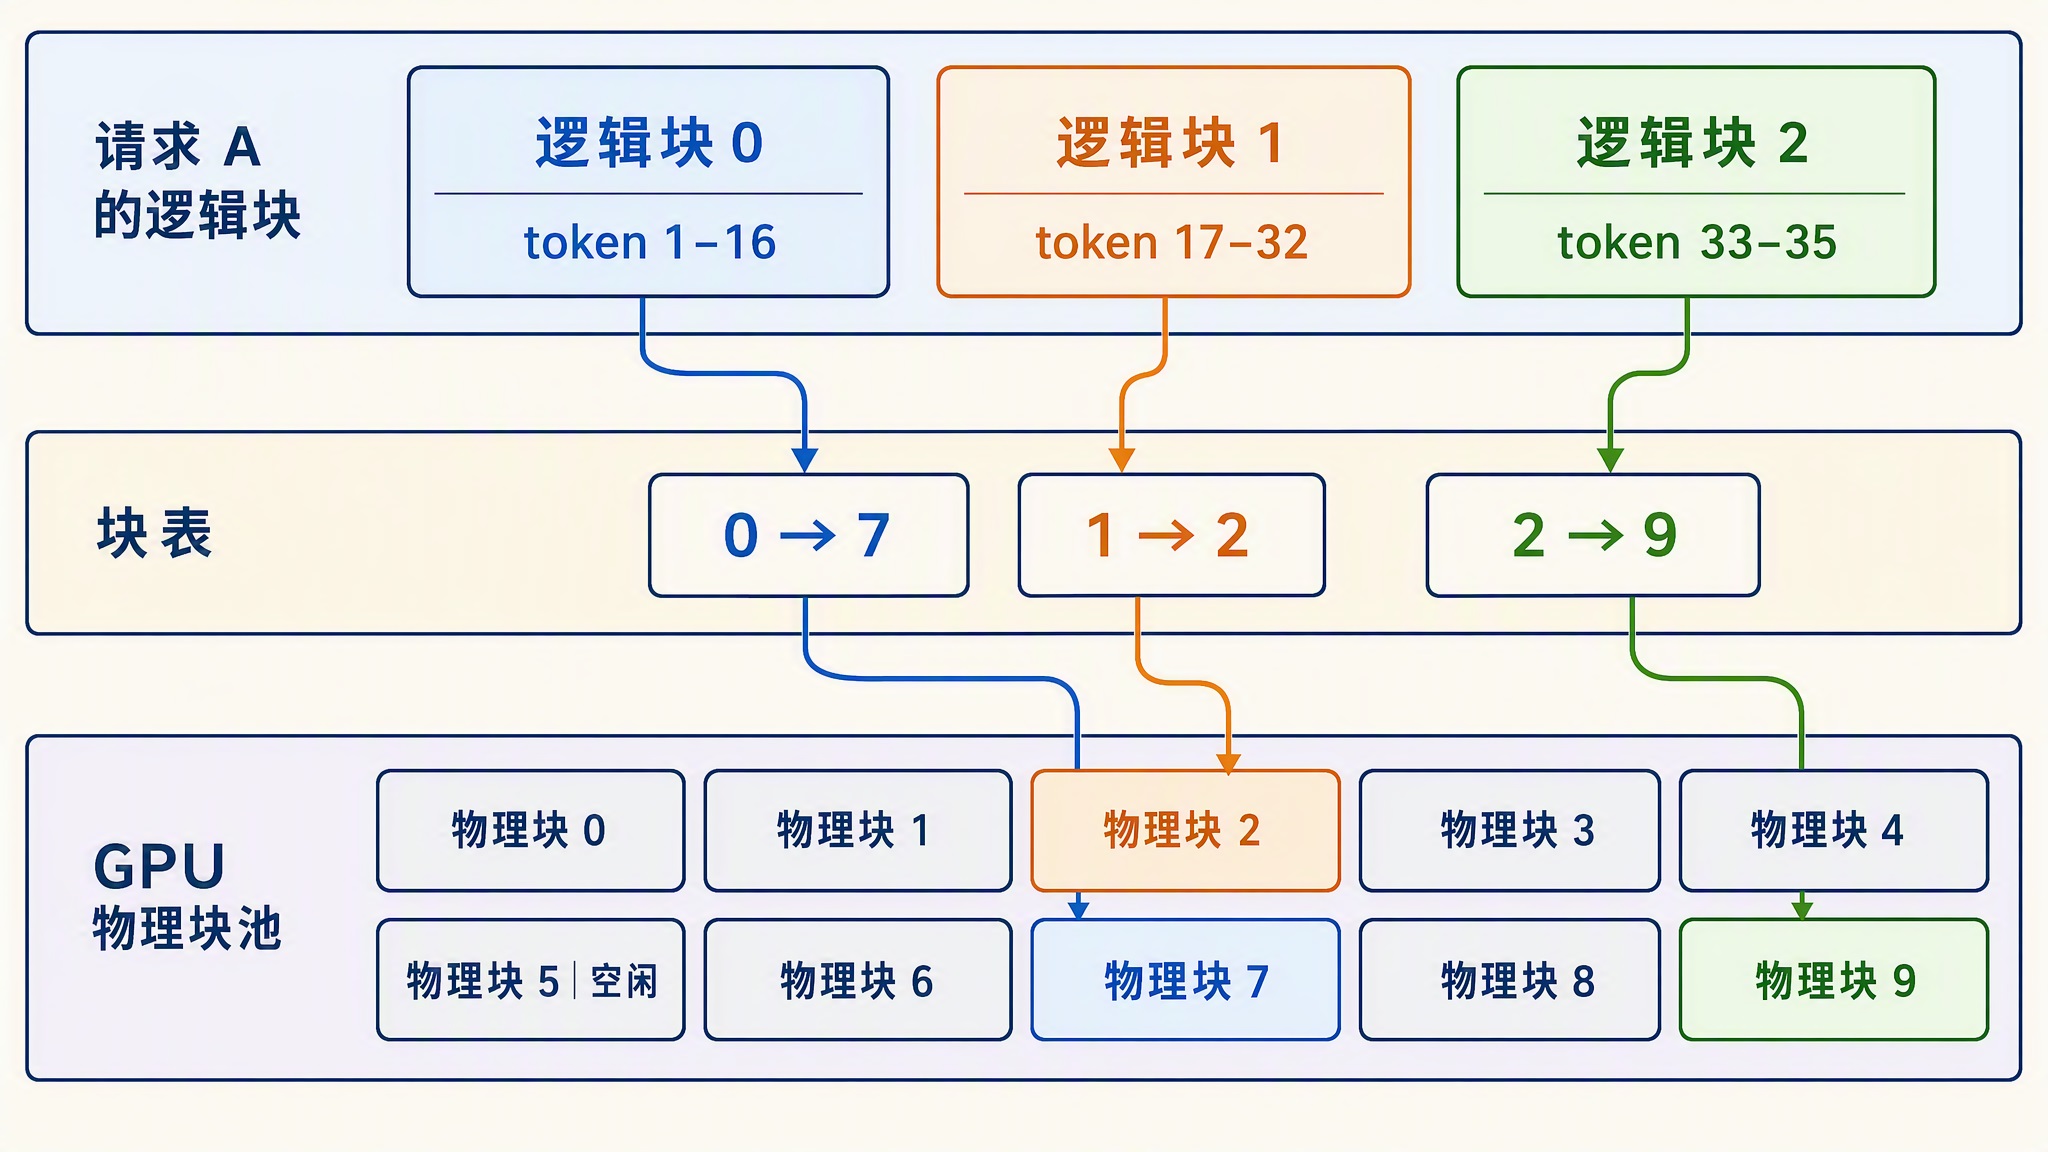
逻辑块、块表、物理块三者的映射关系如下:

pagedattention-block-mapping.jpg

可以看到,请求 A 的 35 个 token 占了 3 个逻辑块,实际落在物理块 7、2、9 上,彼此不相邻,但块表把映射关系记下来后,注意力计算照常进行。调度器眼里所有物理块都是等价的,谁空了就给谁。

下面是 PagedAttention 和操作系统分页的类比图:

paged-attention-analogy.jpg

分页之后,前面的三类浪费基本被消掉了。内部碎片只剩最后一个没填满的块,一条序列最多浪费 15 个 token 的空间。外部碎片没有了,因为所有块尺寸相同,任何空块都能直接用。预留浪费也没有了,因为根本不再预留。论文给出的数据是浪费降到 4% 以内,对比前面 60% 到 80% 的浪费,同一块显卡能容纳的并发请求数翻了好几倍。

有人可能会想:一个块 16 个 token,一条序列最多浪费 15 个,那把块改小,浪费不就更少了吗?其实块大小不是越小越好。块太小,块表就会变长,管理和寻址开销就会变大;16 个 token 一块是工程上比较平衡的选择,vLLM 把它作为默认值,也可以通过启动参数调整。

前缀缓存

PagedAttention 的收益不止省显存。块被统一管理起来之后,一个新能力自然就出现了:块可以被多个请求共享。这就引出了今天第二个主角,前缀缓存。

前缀共享的机会从哪来?实际服务里,大量请求的前缀是一模一样的:

  • 系统提示词:同一个应用的所有请求,开头都是同一段 system prompt,动辄几百上千 token
  • 多轮对话:客户端每次都要把完整历史重新发给服务端,第 N 轮请求的前缀就是第 N-1 轮的完整内容
  • Few-shot 示例:在提示词里给模型几个输入输出样例再提问,一批评测或抽取任务共用同一段示例,只有最后的问题不同

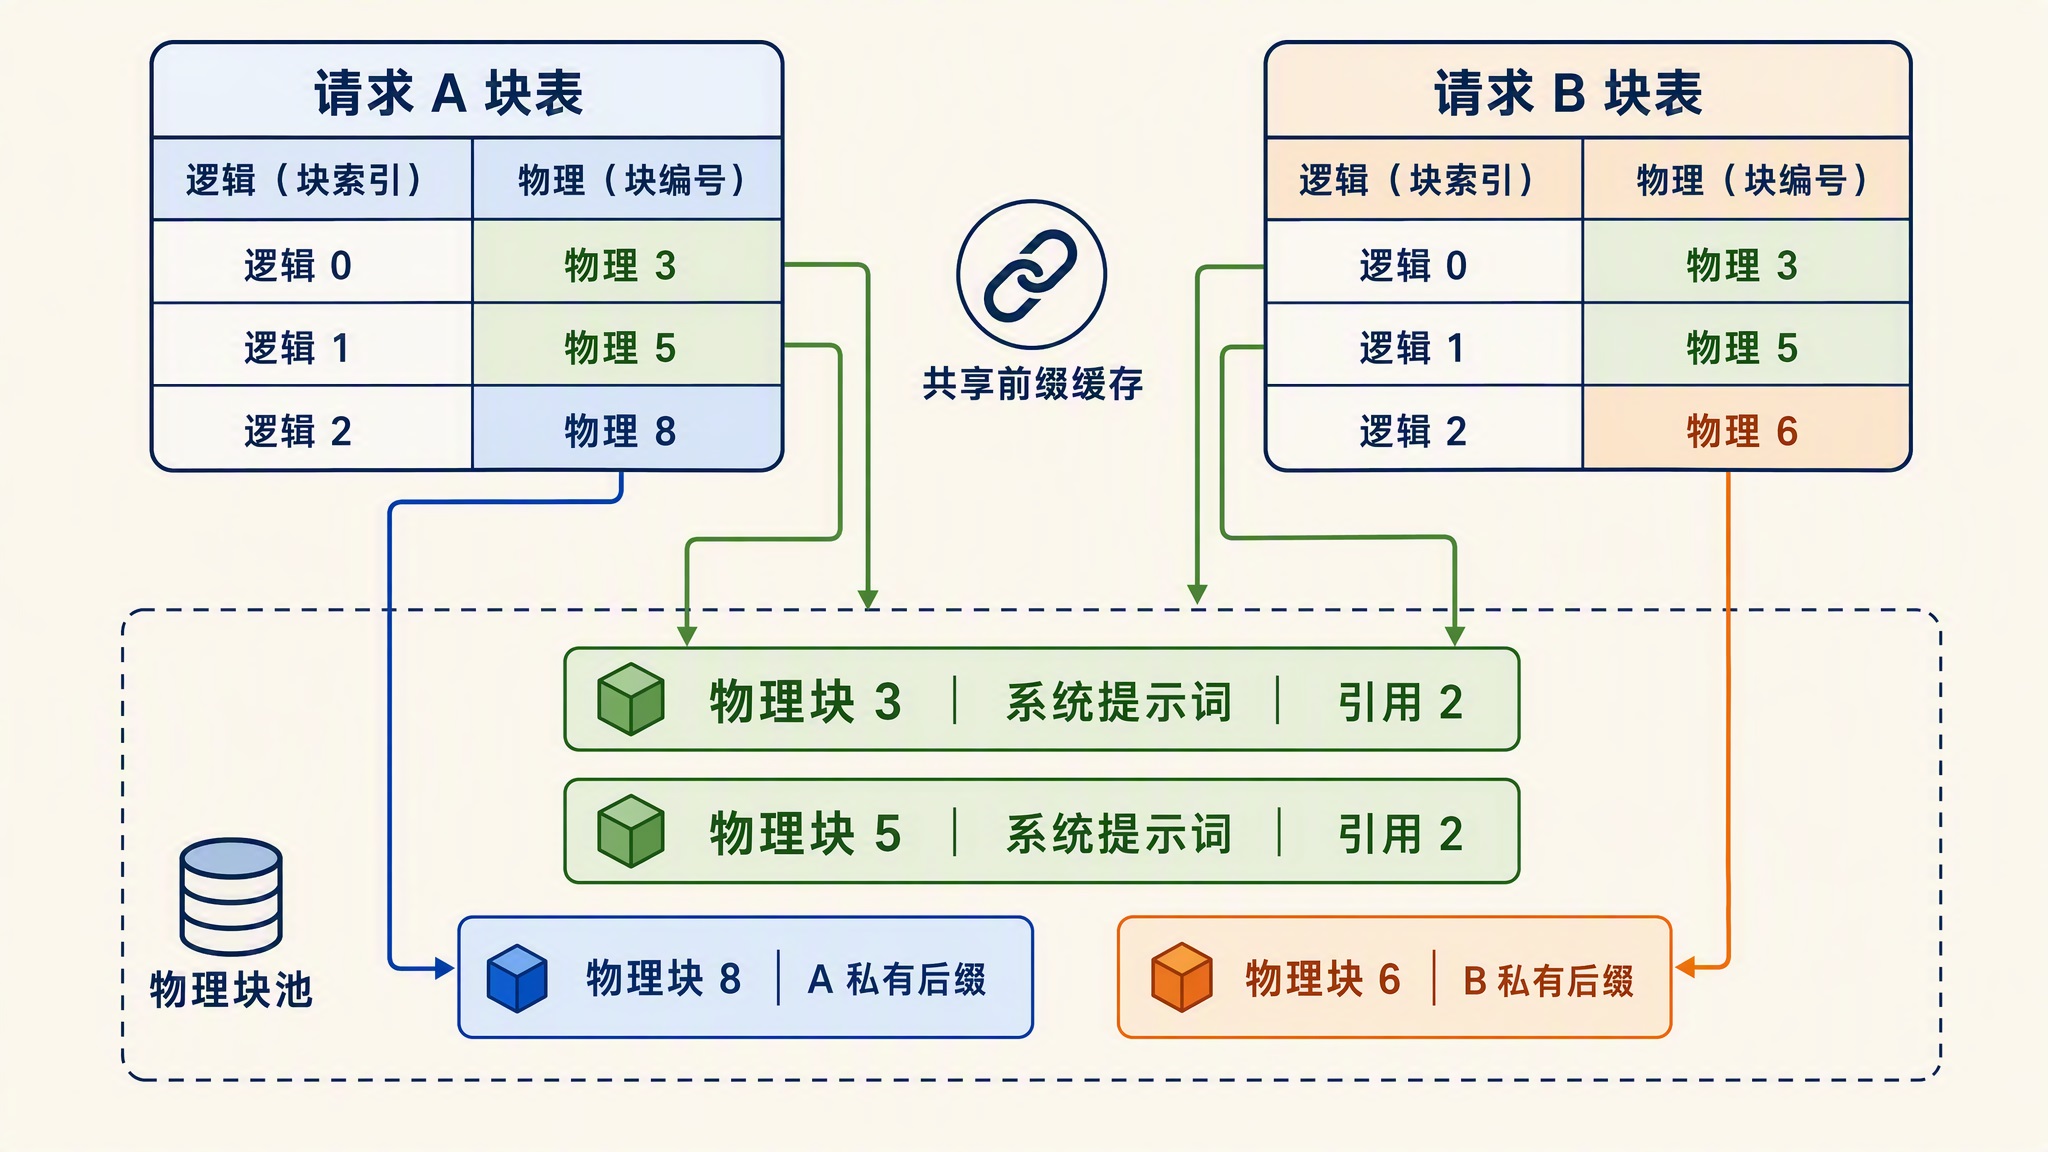
没有前缀缓存时,这些相同的前缀每个请求各算一遍 prefill、各存一份缓存,纯纯的重复劳动。有了分块管理之后,做法就很直接了:给每个块的内容算一个 hash,key 里包含这个块的 token id 和它前面所有前缀的信息。新请求进来时,先按块查 hash,命中说明显存里已经有内容完全相同的块,直接把物理块映射进自己的块表,prefill 只算没命中的部分。

如下图所示,两个请求共享系统提示词前缀的情况如下,物理块 3 和 5 被两条请求的块表同时引用:

prefix-cache-shared-blocks.jpg

共享块上挂着引用计数,被几个请求引用就记几。请求结束时计数减一,减到零的块才进空闲池等待复用或回收。

前缀缓存的收益是双份的:一是省显存,共享的前缀只存一份;二是省计算,命中部分的 prefill 整个跳过,直接降低了 TTFT。对长系统提示词和多轮对话这类负载,命中率可以非常高。

vLLM 把这个能力叫 Automatic Prefix Caching(APC),V1 引擎里默认开启,官方文档有专门的章节介绍。SGLang 则做了进一步的细化,提出了 RadixAttention:它不用 hash 表按块匹配,而是用一棵基数树(Radix Tree)来组织缓存。基数树是一种压缩的前缀树,公共前缀在树里天然是同一条路径,因此可以做任意长度的前缀匹配。缓存淘汰再配合 LRU(Least Recently Used,最久未使用)策略,优先逐出最久没用的节点。多轮对话、树状探索这类共享模式复杂的场景,RadixAttention 的命中率会比固定块大小的 hash 匹配更稳。SGLang 的论文里有完整的设计和实验,想深入的同学可以看看。

RadixAttention 的缓存组织方式示意如下,相同前缀收敛到同一条树路径上:

radixattention-prefix-tree.png

动手体验前缀缓存

概念讲完,我们亲手验证一下命中效果。用 vLLM 起一个 OpenAI 兼容服务,显式打开前缀缓存:

$ vllm serve Qwen/Qwen3-0.6B --enable-prefix-caching --port 8000

在较新的 vLLM 版本里,V1 引擎默认就开启了前缀缓存,不加这个参数也有同样的效果。老版本需要显式指定。

然后写个客户端,连续发两个请求,让它们共享一段很长的系统提示词,分别测一下 TTFT:

import time
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

# 构造一段较长的公共前缀,模拟应用层的系统提示词
system_prompt = "你是一位资深的技术编辑,回答要准确简洁。" * 200

def measure_ttft(question):
    start = time.perf_counter()
    resp = client.chat.completions.create(
        model="Qwen/Qwen3-0.6B",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": question},
        ],
        max_tokens=8,
        stream=True,
    )
    for _ in resp:  # 收到第一个 token 就计时结束
        break
    return time.perf_counter() - start

print("第一次请求 TTFT:", measure_ttft("介绍下 KV Cache"))
print("第二次请求 TTFT:", measure_ttft("介绍下 PagedAttention"))

我实际跑出来的结果如下:

第一次请求 TTFT: 0.32561847753822803
第二次请求 TTFT: 0.01986777689307928

第一个请求要完整 prefill 整段系统提示词,几百上千个 token 逐个算一遍,TTFT 约 326 毫秒。第二个请求的前缀和它完全相同,前缀缓存命中,这段 prefill 被整个跳过,TTFT 只有约 20 毫秒,差了 16 倍。具体的毫秒数和提示词长度、硬件强相关,但缓存命中后明显更快这个趋势是稳定的。

服务端这边也能直接观察到命中情况。vLLM 的日志会周期性打印前缀缓存命中率,刚才这两次请求对应的日志是:

(APIServer pid=176492) INFO 08-24 07:40:29 [loggers.py:310] Engine 000: Avg prompt throughput: 222.7 tokens/s, Avg generation throughput: 1.6 tokens/s, Running: 0 reqs, Waiting: 0 reqs, GPU KV cache usage: 0.0%, Prefix cache hit rate: 49.8%

第二个请求的公共前缀全部命中,第一次是 0%,两次平均下来正好在一半左右,日志里的 49.8% 和它对上了。在真实服务里,如果所有请求都挂同一段系统提示词,这个值会稳定在很高的水平。

前缀匹配是在 token 层面精确进行的。系统提示词差一个字符、聊天模板换一个版本,token 序列就变了,缓存全部失效。所以线上服务要保证前缀部分的内容和模板严格稳定。

KV Cache 量化

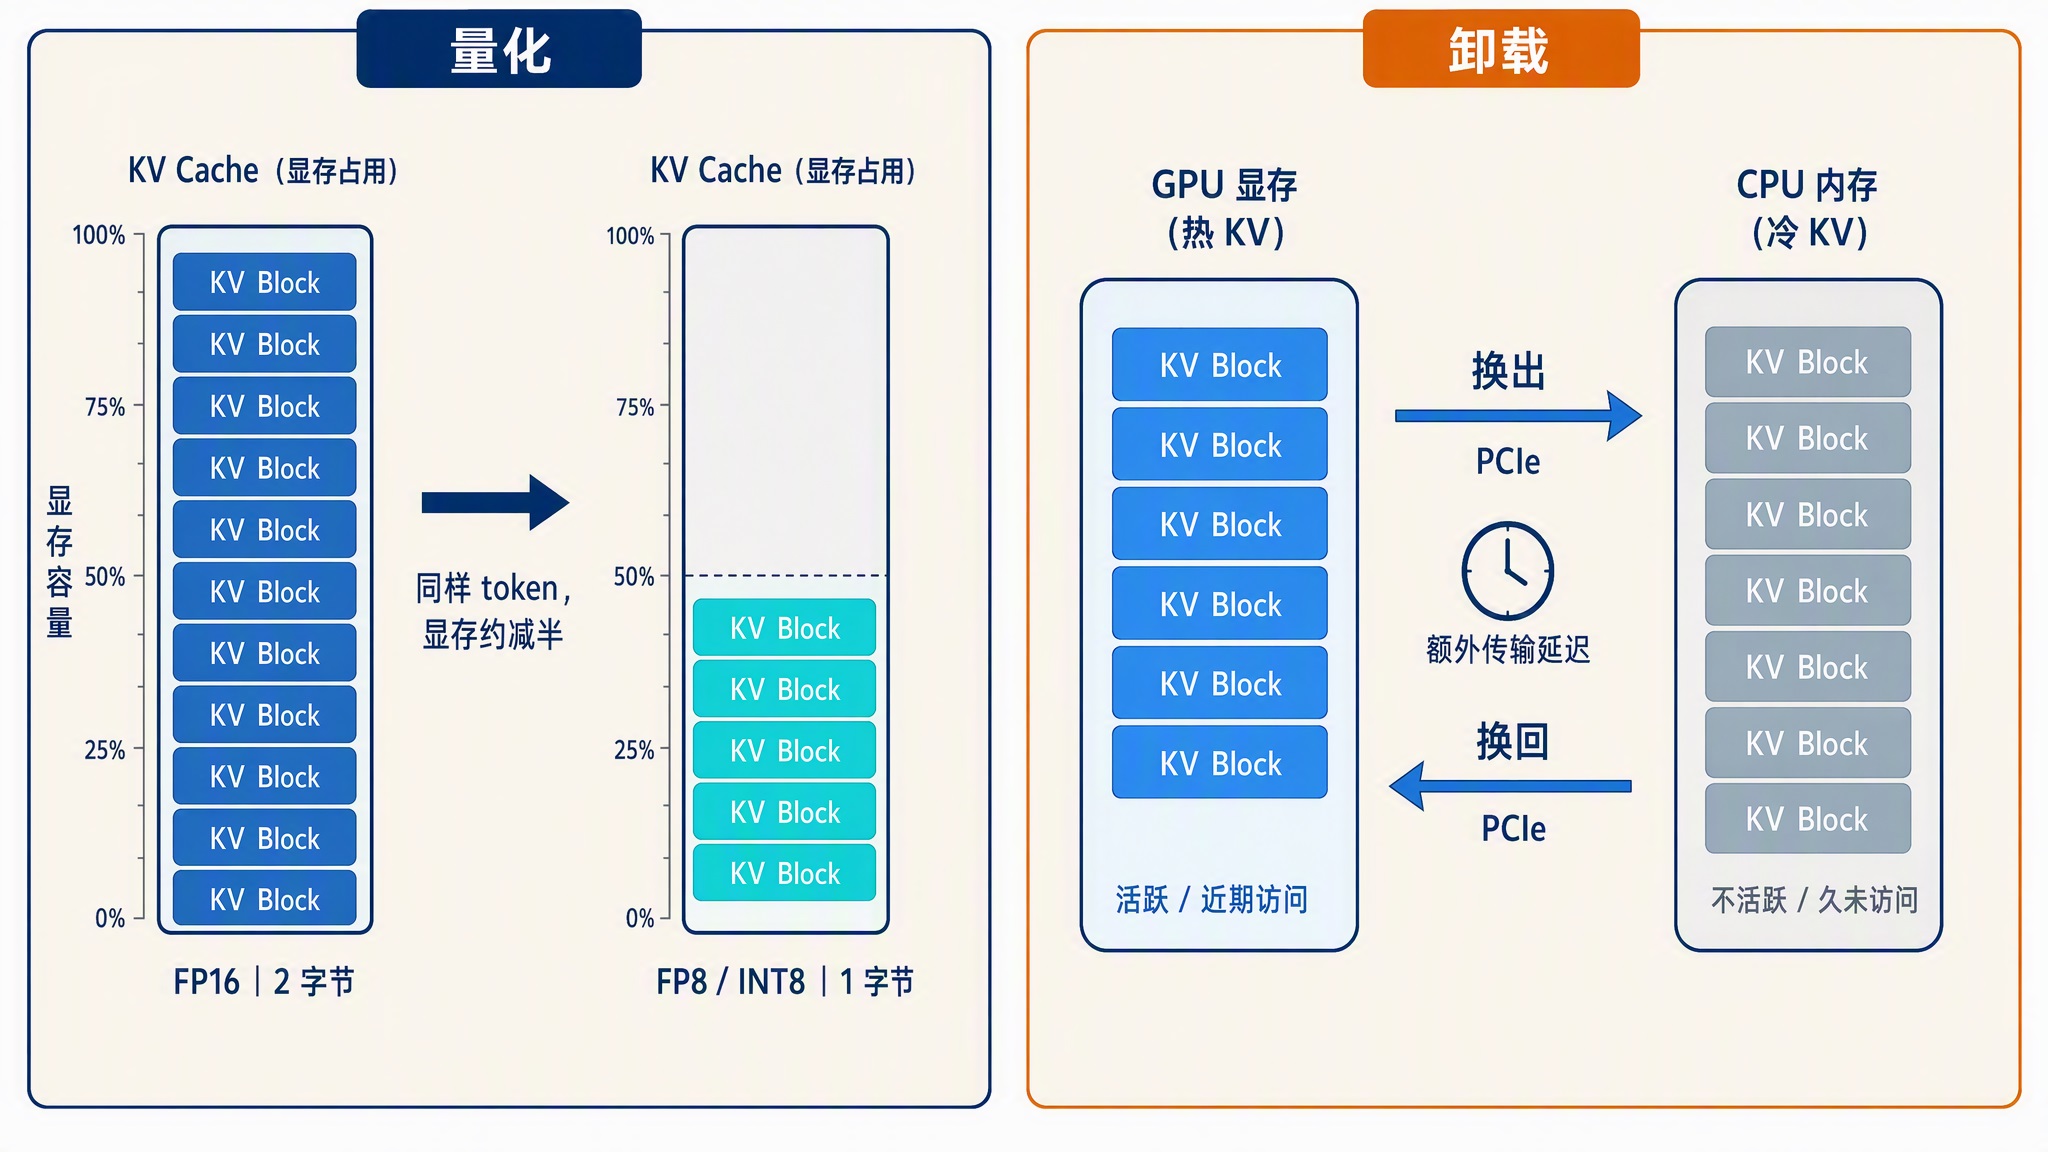
除了在分配方式上着手优化,还有一条更直接的路:让缓存里的每个元素占更小的空间。回看显存公式,最后一个因子是每元素字节数,FP16 是 2 字节。把它换成 FP8(8 位浮点) 或 INT8(8 位整型),每个元素只占 1 字节,KV Cache 直接减半,能容纳的并发或上下文长度近似翻倍。

vLLM 可以通过下面的参数开启:

$ vllm serve Qwen/Qwen3-0.6B --kv-cache-dtype fp8

用起来是一个参数的事,但 FP16 的数值压进 8 位,信息总有损失,损失多少取决于一个关键系数:scale(缩放系数)。FP8 能表示的数值范围很小(e4m3 格式最大只有 448),而 KV Cache 里的实际数值范围可能超出它,所以量化时需要一个缩放系数,把原始数值压缩进 FP8 的量程,读出来时再放大回去,这个系数就是 scale。scale 定得不准,要么数值超出量程被截断,要么量程没占满白白损失精度。

e4m3 是 FP8 的一种格式,名字就是它的结构:1 位符号、4 位指数(e)、3 位尾数(m)。指数位决定量程,4 位指数让它最大表示到 448;尾数位决定精度,3 位尾数意味着相对精度只能到 1/8 左右。FP8 还有一种 e5m2 格式,指数多一位、尾数少一位,量程更大但精度更粗,训练里存梯度用得多。推理场景的 KV Cache 量化一般用 e4m3,vLLM 的 fp8 选项默认就是它。

vLLM 默认的做法是不校准,所有 scale 直接设为 1.0,多数模型上效果够用。如果追求更稳的精度,官方推荐用 llm-compressor 做离线校准:拿几百条有代表性的数据过一遍模型,统计 K、V 激活值的实际分布,算出合适的 scale,保存成一个带 scale 的新模型目录,vLLM 加载时自动读取。它还支持更细的粒度,从逐张量一个 scale 细化到每个注意力头一个 scale(目前只有 Flash Attention 后端支持)。

scale 定准之后,剩下的问题是:8 位终究比 16 位少了一半信息,对生成质量的影响有多大?实践的结论是可控的。KV Cache 里的数值分布相对集中,8 位量化对生成质量的影响很小,这也是各家引擎都敢默认提供这个选项的原因。vLLM 官方博客 2026 年 4 月有一篇 FP8 KV Cache 的综述,梳理了当前的实现状态和适用场景,它给的默认策略是:长上下文、显存受限的场景直接从 FP8 起步,scale 不校准通常就够用,观察到持续性的精度下降再考虑校准。

不过 FP8 也不是在所有情况下都划算,博客里列了几种该留在 BF16(或部分留在 BF16)的情况:

  • 上下文很短(7k token 以内):FP8 每步有一笔固定开销,缓存变小的收益随长度线性增长,太短就抵不回来,这时 BF16 的 token 间隔反而略好
  • head_dim 为 256 的模型且在意 prefill 延迟:为了保证长上下文精度,FP8 注意力计算里用了两级累加,这笔开销在大头维度下会吃掉 FP8 的算力优势,长上下文时 TTFT 最高涨到 1.6 倍
  • 未校准精度持续下移:个别模型(比如用 FlashMLA 后端的 Kimi-K2.5)在 scale 取 1.0 时会出现系统性的精度下降,不是随机噪声,这时就该按前面说的用 llm-compressor 在目标数据上校准
  • 混合注意力模型的小滑窗层:滑动窗口层的缓存大小有界,固定开销摊不回来。这种情况不用放弃 FP8,加上 --kv-cache-dtype-skip-layers sliding_window,让滑窗层保持原精度、其余层量化即可

卸载到内存

如果分页、共享、量化全用上之后显存还是装不下,这时会怎么样呢?

默认情况下,vLLM 的调度器给请求分配不到新的 KV 块时,会抢占(Preemption)一部分在跑的请求来腾地方:从运行集的尾部开始踢,也就是最新加入、优先级最低的请求先被牺牲,它们的 KV 块被释放出来,其余请求继续跑。被踢的请求回到等待队列,等显存有了空位再重新调度上来。V1 引擎默认的抢占方式是重算(RECOMPUTE):被抢占的请求不留缓存,恢复时从 prefill 重新跑一遍。之所以敢直接丢,是因为被抢占请求的缓存是还没算完的半成品,保存价值不高,重算的开销比换出再换回更划算。服务日志里如果出现 preempted by PreemptionMode.RECOMPUTE 的警告,就说明显存开始紧张了,该考虑调大 gpu_memory_utilization,或者收紧上一篇讲的 max_num_seqs。

但不是所有块都适合一丢了之。前缀缓存里的块是算完的成品,后面还可能被其他请求反复用到,丢了下次就得整段 prefill 重算。对这类有复用价值的块,更省的办法是挪到 CPU 内存里存着,而不是直接丢掉,这就是卸载(Offload)。vLLM 现在有原生的 CPU 卸载,两个参数就能开:

$ vllm serve Qwen/Qwen3-0.6B --kv-offloading-size 64 --kv-offloading-backend native

kv-offloading-size 指定拿出多少 GiB 内存做卸载缓冲;kv-offloading-backend 默认 native,也可以换成 lmcache,也就是 LMCache 这类外部组件,它把卸载做成了完整的多级缓存,CPU 内存之后还能再接 NVMe 磁盘和远端存储。

LMCache 是一个开源的 KV Cache 管理层,以插件形式挂在 vLLM 这类推理引擎上,把 KV 块的存放从 GPU 显存扩展到 CPU 内存、本地磁盘甚至远端存储,还支持跨请求、跨引擎的缓存共享。可以把它理解成给推理引擎外挂的一套缓存中间件。

值得一提的是,卸载主要不是给单个请求扩上下文,而是给前缀缓存扩容。被挤出显存的块在内存里仍然挂着 hash,后续请求做前缀匹配时可以直接命中到内存里的块,省掉的是重算 prefill 的时间。代价是数据要走 PCIe(连接 CPU 和 GPU 的总线)来回搬运,命中内存里的块比命中显存慢,但比重算一遍 prefill 快得多,所以它适合当显存之后的第二级缓存,而不是主力手段。

最后把量化和卸载放在一起对比收尾:量化是把每个 KV 元素占用的字节数压小,卸载是把暂时不用的 KV 块搬到容量更大的 CPU 内存,一个省空间,一个扩空间。

kv-cache-quantization-offload.jpg

小结

今天这篇围绕 KV Cache 的显存管理,讲了三个层次的手段:

  1. 问题:推理显存里权重是固定的,KV Cache 是随负载动态增长的大头。朴素做法按最大长度预留连续显存,内部碎片、预留浪费、外部碎片加起来会浪费 60% 到 80%
  2. PagedAttention:vLLM 团队在 SOSP 2023 提出的方案,类比操作系统虚拟内存分页,把 KV Cache 切成固定大小的块,逻辑块经块表映射到不连续的物理块,按需分配,浪费降到 4% 以内
  3. 前缀缓存:分页让块可以跨请求共享,对块内容算 hash,系统提示词、多轮历史这类公共前缀命中后只存一份、只算一遍,省显存也省 TTFT。SGLang 的 RadixAttention 用基数树做了更细粒度的共享
  4. 量化与卸载:KV Cache 存 FP8/INT8 再省一半;显存实在不够时可以把不活跃的块挪到 CPU 内存

到这里,推理的显存问题就有了完整的答案:能省的地方省下来,能共享的地方共享出去,同一块显卡能服务的请求数翻了几倍。下一个问题自然就是速度了:每个请求本身还能不能跑得更快?下一篇我们就来看推理加速的三板斧,量化、投机解码和 PD 分离,欢迎继续关注。

参考


学习大模型推理的批处理:Continuous Batching

至此,我们把一次请求从进来到出去的整条链路都走了一遍:prompt 进来、分词、查 embedding、逐层 Transformer 前向、prefill 建 KV Cache、decode 逐 token 生成、最后 token 变回文字。

在这整条链路里,有不少技术细节和优化手段值得再深入学习,打算后面逐个展开。今天就从第一个话题开始:批处理(Batching)。

单请求跑推理有多浪费

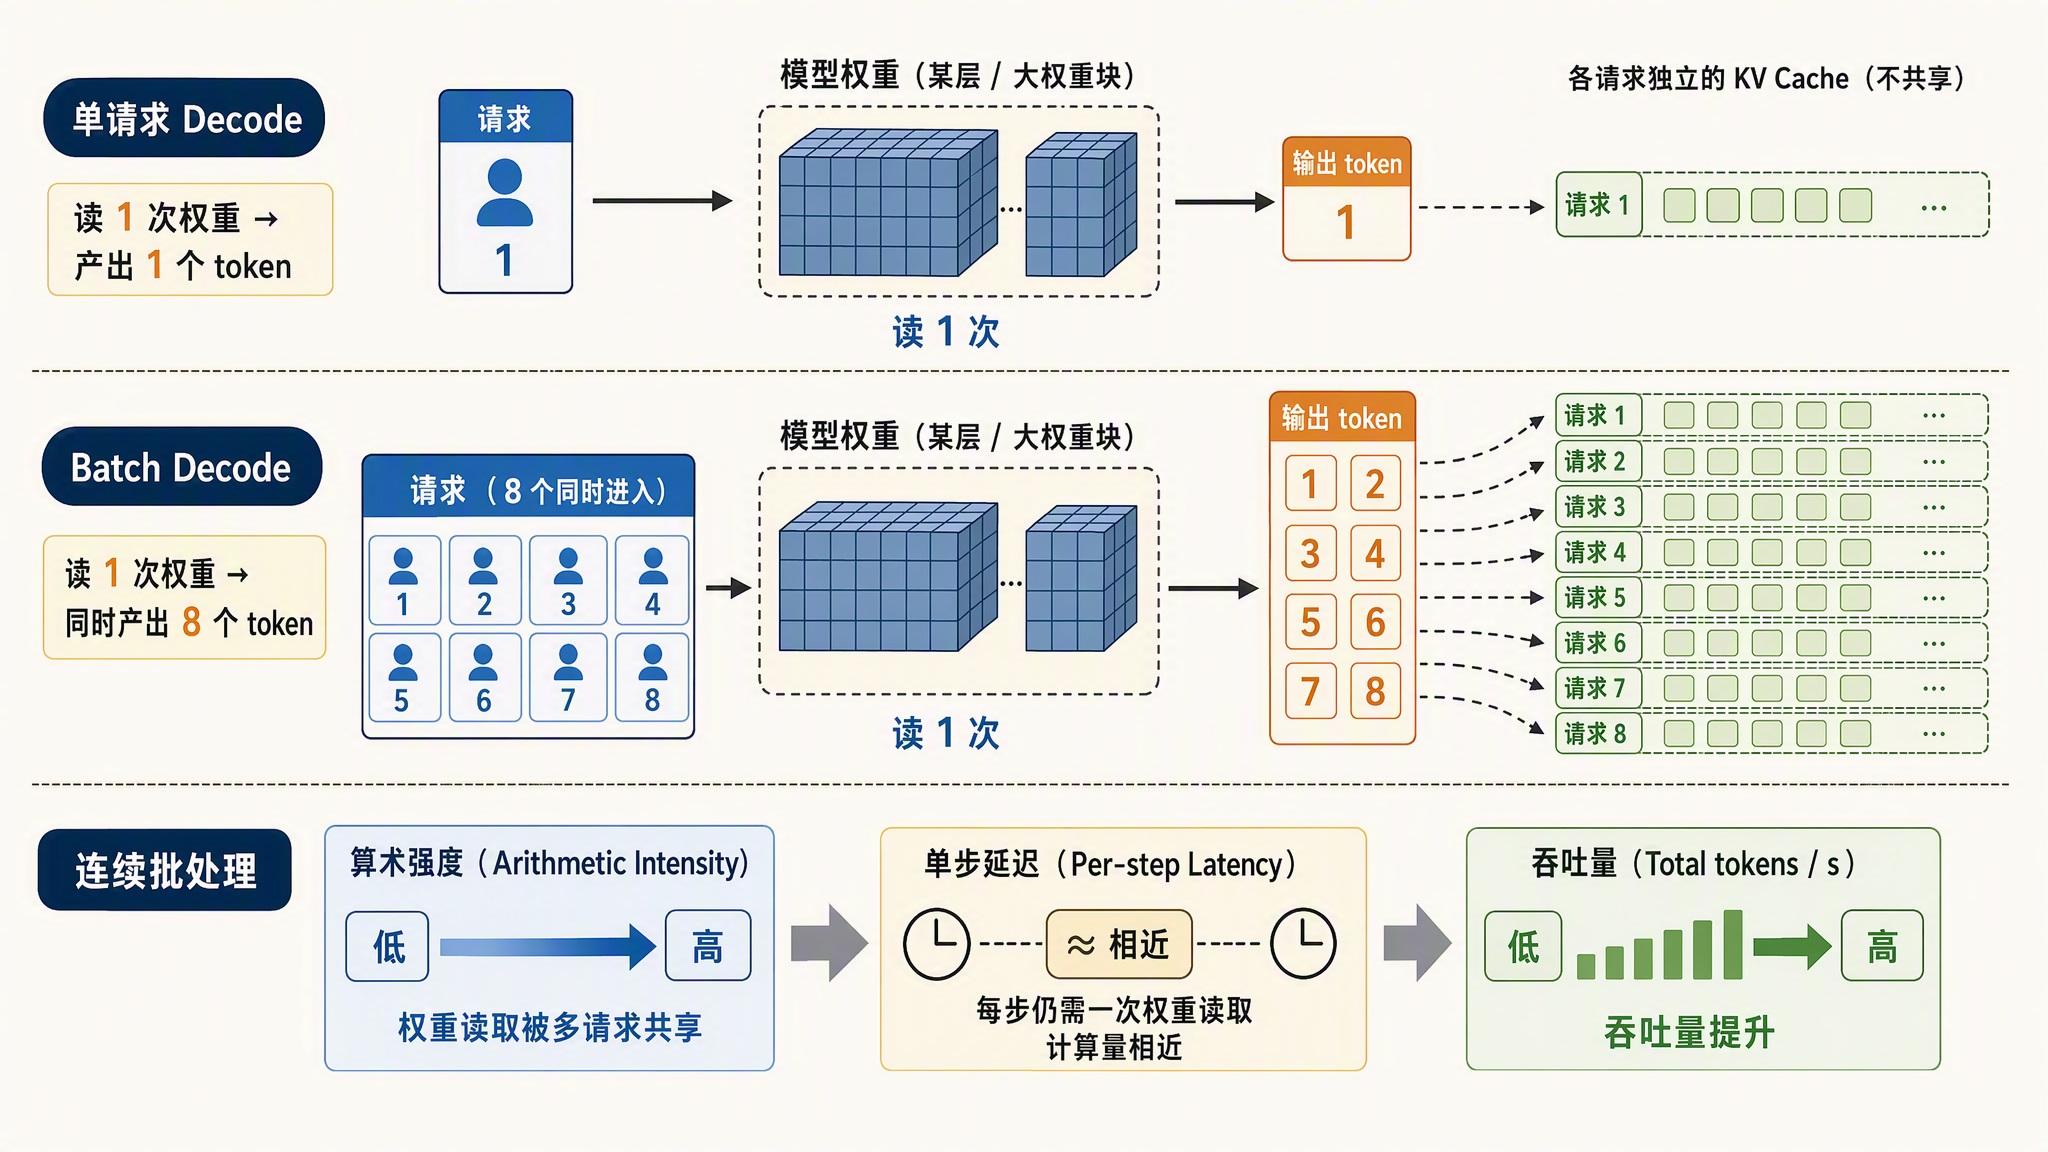
第六篇讲过,prefill 和 decode 的瓶颈完全不同。prefill 一次性并行处理整段 prompt,是矩阵乘矩阵的大计算,GPU 的算力能吃得比较满。decode 不一样,每一步只处理一个新 token,本质上是矩阵乘向量,计算量很小,但每一步都要把全部模型权重和整条 KV Cache 从显存里读一遍。

衡量这种差异的指标就是第六篇介绍过的算术强度(Arithmetic Intensity):每从显存读一个字节,能做多少次浮点运算。算术强度高的任务是计算受限,瓶颈在算力;算术强度低的任务是带宽受限,瓶颈在显存带宽。decode 恰好是后者的极端情况:权重几个 GB 到几十 GB,每一步原样读一遍,只为算出区区一个 token。

结果就是,单请求跑 decode 时,GPU 的计算单元大部分时间在等数据。一张标称几百上千 TFLOPS 的卡,真正用上的算力只有很小一个零头。

decode-bandwidth-bound.jpg

补救的思路很直接:既然每一步都要把整个模型读一遍,那就让这一步同时给多条请求算。权重读一次,几十条请求一起用,算术强度按批大小成倍抬升。显存带宽花同样的时间,产出的 token 却多了几十倍。这就是批处理的动机:摊薄每一步读权重的成本。

静态批处理:整批同进同出

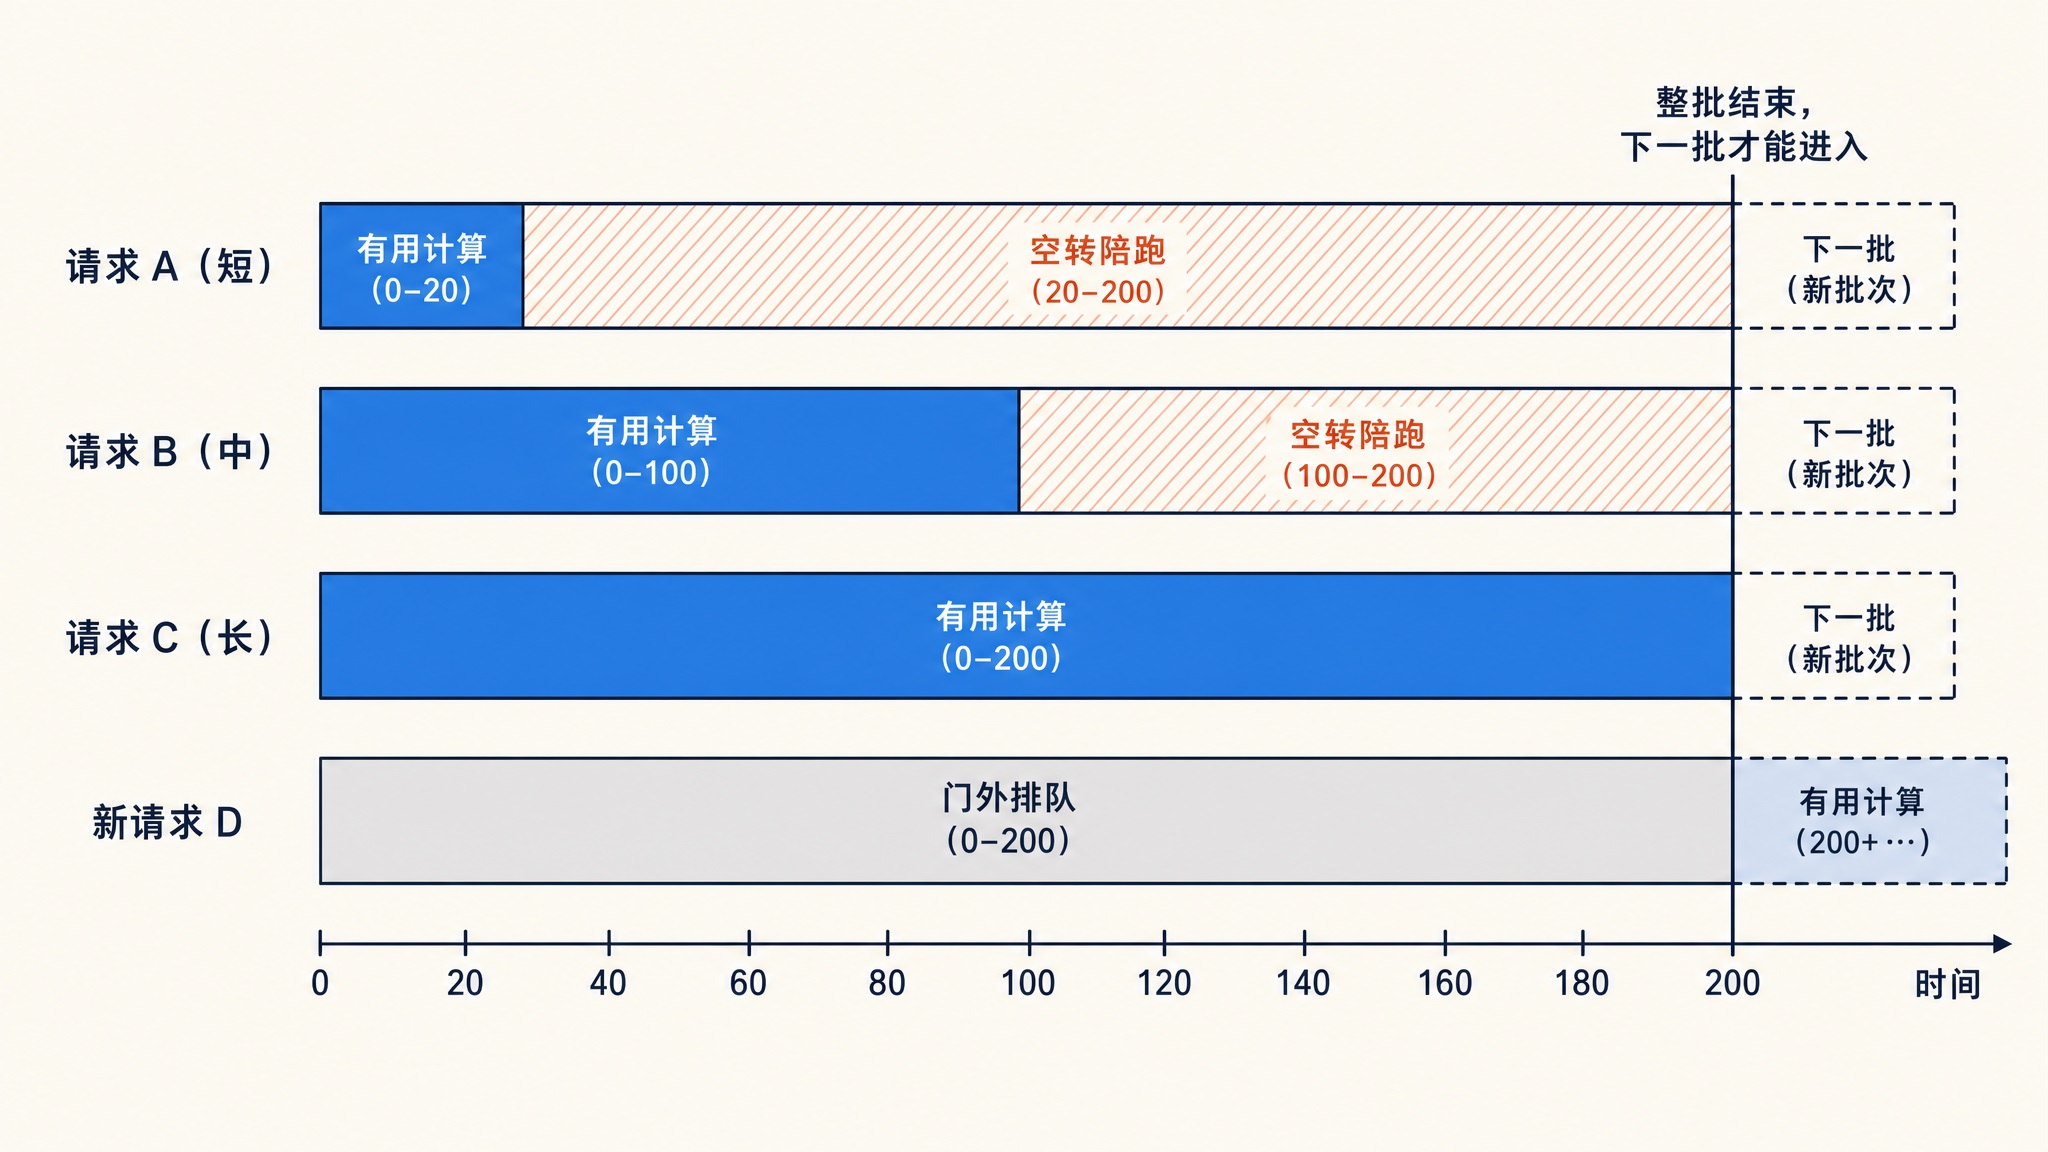
最容易想到的批法是静态批处理(Static Batching):攒够一批请求,拼成一个大 batch 一起送进 GPU,等批里所有请求都生成完,整批一起返回,然后再收下一批。

它的毛病是短板效应。同一批请求的生成长度差异很大,有的 20 个 token 就收尾,有的要 500 个。静态批处理里,短请求生成完之后并不能先走,它得占着批里的位置陪跑,直到最长的那条结束。陪跑期间,GPU 要么为它算无意义的前向,要么塞 pad token 占位,这部分算力纯属空转。新到的请求也只能在门外排队,等当前批彻底清空才能进。

用时间轴画出来是这样:

static-batching-timeline.jpg

红色部分是纯粹的浪费:请求 A 和 B 早就生成完了,却要陪请求 C 耗到第 200 步;请求 D 早就到了,却只能干等。批内长度差异越大,空转越严重。

用 Transformers 亲手感受一下

Hugging Face Transformers 的 generate 接口天然就是静态批处理,可以直接拿来体会短板效应。我们用 Qwen/Qwen3-0.6B 这种小模型,把三条长度要求不同的 prompt 拼成一批:

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, dtype="auto")

# 三条 prompt,预期的输出长度差异很大
prompts = [
    "用一句话介绍杭州。",
    "写一首关于秋天的五言绝句。",
    "详细解释为什么天空是蓝色的,不少于三百字。",
]

# 套对话模板,Qwen3 关掉思考模式,让回答尽快收尾
texts = [
    tokenizer.apply_chat_template(
        [{"role": "user", "content": p}],
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=False,
    )
    for p in prompts
]

# 批式生成要左填充,保证每条序列的最后一个位置就是新 token 的位置
tokenizer.padding_side = "left"
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token

inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
prompt_len = inputs["input_ids"].shape[1]

outputs = model.generate(**inputs, max_new_tokens=512, do_sample=False)

for i, out in enumerate(outputs):
    new_tokens = out[prompt_len:]
    n = int((new_tokens != tokenizer.pad_token_id).sum())
    print(f"请求 {i}: 有效生成 {n} 个 token")
    print(tokenizer.decode(new_tokens, skip_special_tokens=True))

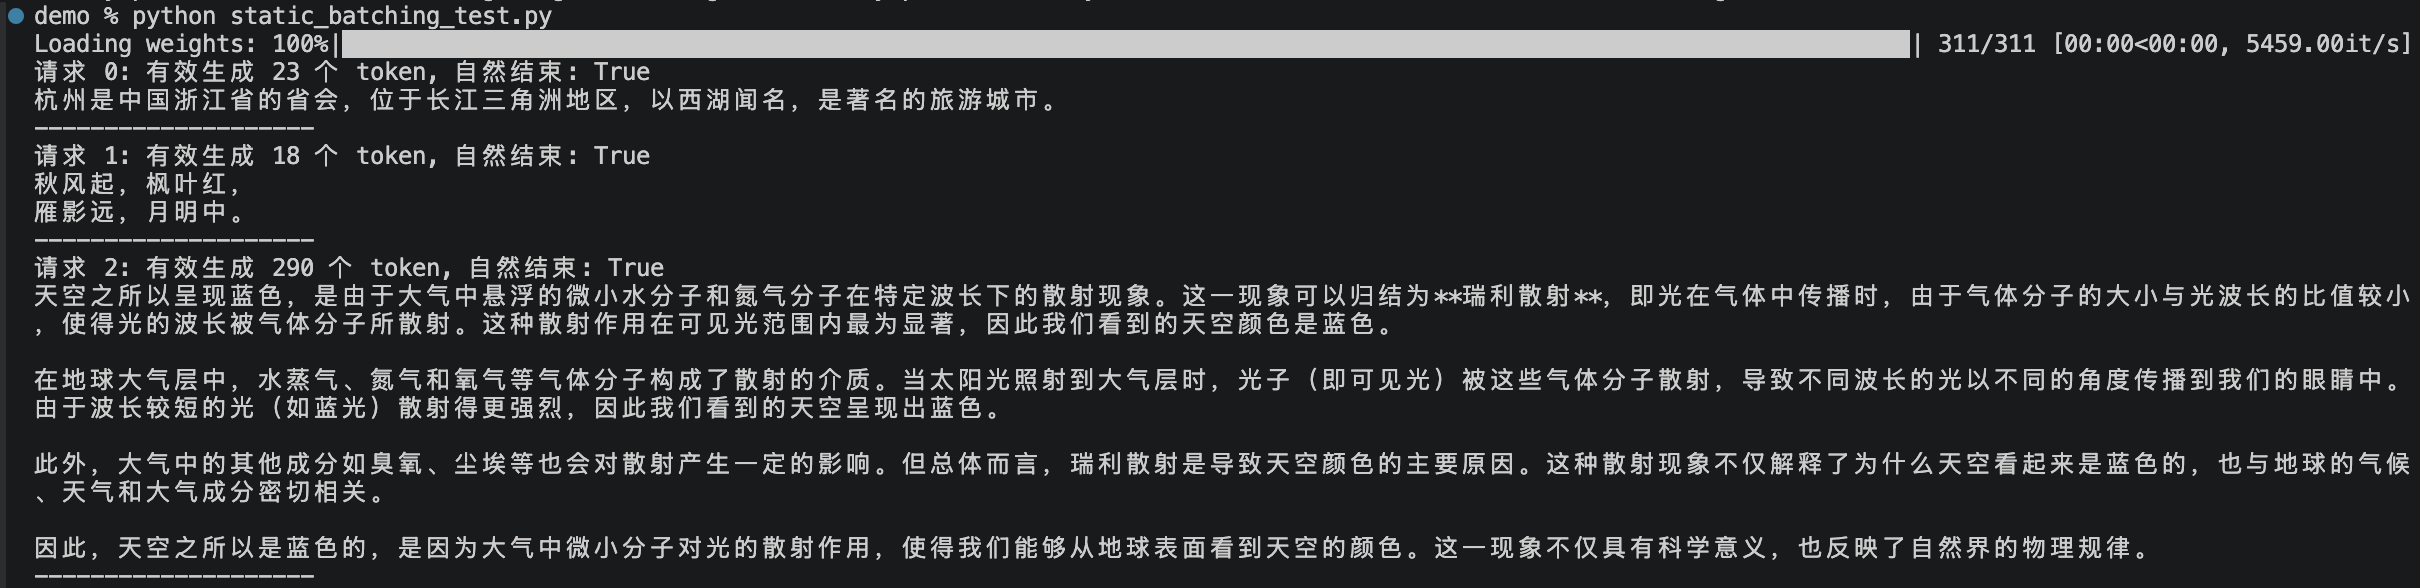
在我的 Mac 上跑出来的结果如下:

static-batching-generate-output.png

三条请求分别有效生成 23、18、290 个 token,最长和最短差了十几倍,但 generate 要等最长那条结束后才返回。短请求先撞上了 EOS,后面的位置只能拿 pad token 填满,这些位置的每一步前向都是白算的。

真正的推理服务要处理的是请求随到随走、量大利薄的场景,静态批处理的空转在生产上是接受不了的。

连续批处理:以步为单位调度

连续批处理(Continuous Batching) 把调度的粒度从整批缩小到了单步迭代。这个机制来自 ORCA 系统,由 FriendliAI 和首尔国立大学的团队提出,论文发表在 OSDI 2022,论文里的原名是迭代级调度(Iteration-level Scheduling)。

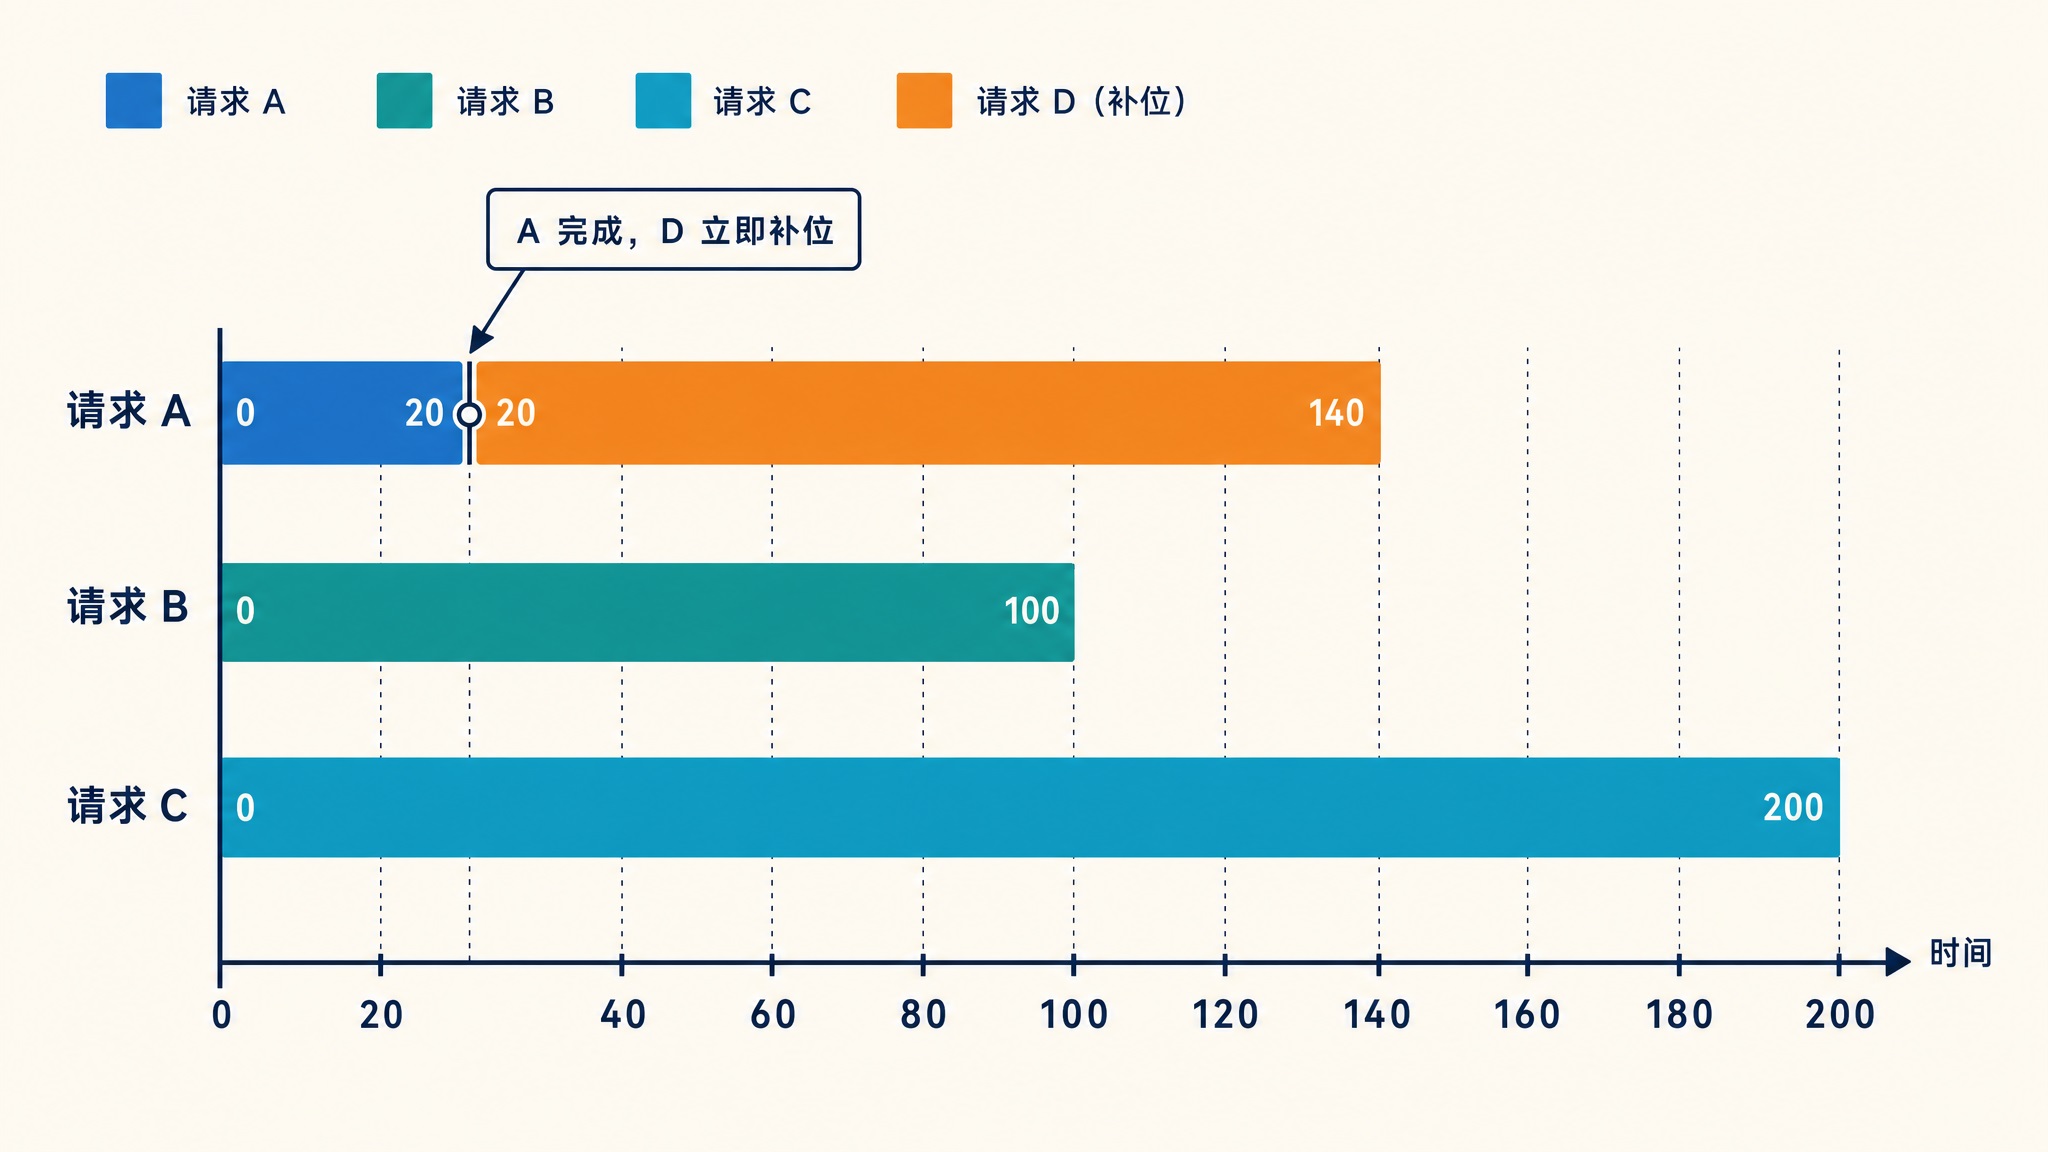
思路也很直观:每跑完一步 decode,调度器都重新决策一次。哪条请求生成了 EOS 或顶到长度上限,立刻移出、返回结果;等待队列里有新请求,且显存放得下,立刻补进运行集。批的组成每一步都在变,GPU 不需要等任何人。

同样四条请求,换成连续批处理的时间轴:

continuous-batching-timeline.jpg

对比上一张图,空转区域整个消失了。请求 A 第 20 步结束,请求 D 第 21 步就顶上了它的位置。每条请求的实际生成时间没变,但同一台 GPU 在单位时间内服务的请求变多了。

调度器内部:两个队列

把调度器拆开看,它维护着两个队列:等待队列(waiting)装着已接收但还没开始计算的请求,运行集(running)装着正在逐 token 生成的请求。每跑一步迭代,调度器做三件事:

  1. 组批:先遍历运行集,给每条在跑的请求分配这一步的 KV 块和 token 预算;预算还有富余,再从等待队列按顺序取请求补进来
  2. 执行:拼好的批送进 GPU 跑一步前向,每条请求各产出一个新 token
  3. 结算:检查每条请求新产出的 token,撞上 EOS 或长度上限的标记完成、释放资源、把结果推给客户端;空出的位置下一步组批时从等待队列补进来

等待队列默认是先来先服务(FCFS),vLLM 也支持优先级调度:启动时加 --scheduling-policy priority,数值越小的请求越先被处理。

效果有多大

ORCA 论文给过一组对比数据:在 GPT-3 175B 的分布式服务实验上,相同延迟目标下,ORCA 的吞吐是 NVIDIA FasterTransformer 的 36.9 倍。具体的数字是,在每 token 190 ms 的延迟目标下,FasterTransformer 每秒只能处理 0.185 个请求,ORCA 能处理 6.81 个。

要注意这个数字是和特定 baseline 在特定设置下的对比,不是说换个场景也快 36 倍。但它足以说明仅仅把调度粒度从请求级降到迭代级,吞吐就能拉开数量级的差距。

ORCA 论文里还有第二个机制叫选择性批处理(Selective Batching):注意力计算依赖各请求独立的 KV Cache,不适合整批合并,就按请求分开算;其余的线性层和归一化可以整批合并。这个细节就不展开了,感兴趣的同学可以读下原始的论文。

如今已是行业标配

迭代级调度现在是所有主流推理引擎的基本功,叫法也基本统一成了 continuous batching,只有个别例外:

引擎叫法
vLLMcontinuous batching
SGLangcontinuous batching
Hugging Face TGIcontinuous batching
llama.cppcontinuous batching
TensorRT-LLMin-flight batching
LMDeploypersistent batching

TensorRT-LLM 把它叫做 in-flight batching,LMDeploy 叫做 persistent batching,本质上都是 ORCA 那套迭代级调度。读这些框架的文档时遇到不同的名字,注意一下就好。

调度器调优

连续批处理让请求在批里随到随入、随完随出,不用等别人。但批也不能无限膨胀,总得有个边界。以 vLLM 为例,调度器最重要的两个参数是:

  • max_num_seqs:单步迭代里最多同时跑多少条请求。它限制的是批的条数上限
  • max_num_batched_tokens:单步迭代里最多处理多少个 token,所有请求加起来算。它限制的是批的 token 总量上限

启动服务时可以显式指定:

$ vllm serve Qwen/Qwen3-0.6B \
    --max-num-seqs 256 \
    --max-num-batched-tokens 8192

这两个参数共同决定了每一步喂给 GPU 的工作量,调大它们的影响如下:

  • max_num_seqs 调大:吞吐更高,权重读取摊得更薄;但单请求延迟更差,单步更慢,排队更久
  • max_num_batched_tokens 调大:吞吐更高,长 prompt 的 prefill 更快进完;TTFT 变好,但 decode 的 token 间隔可能变差

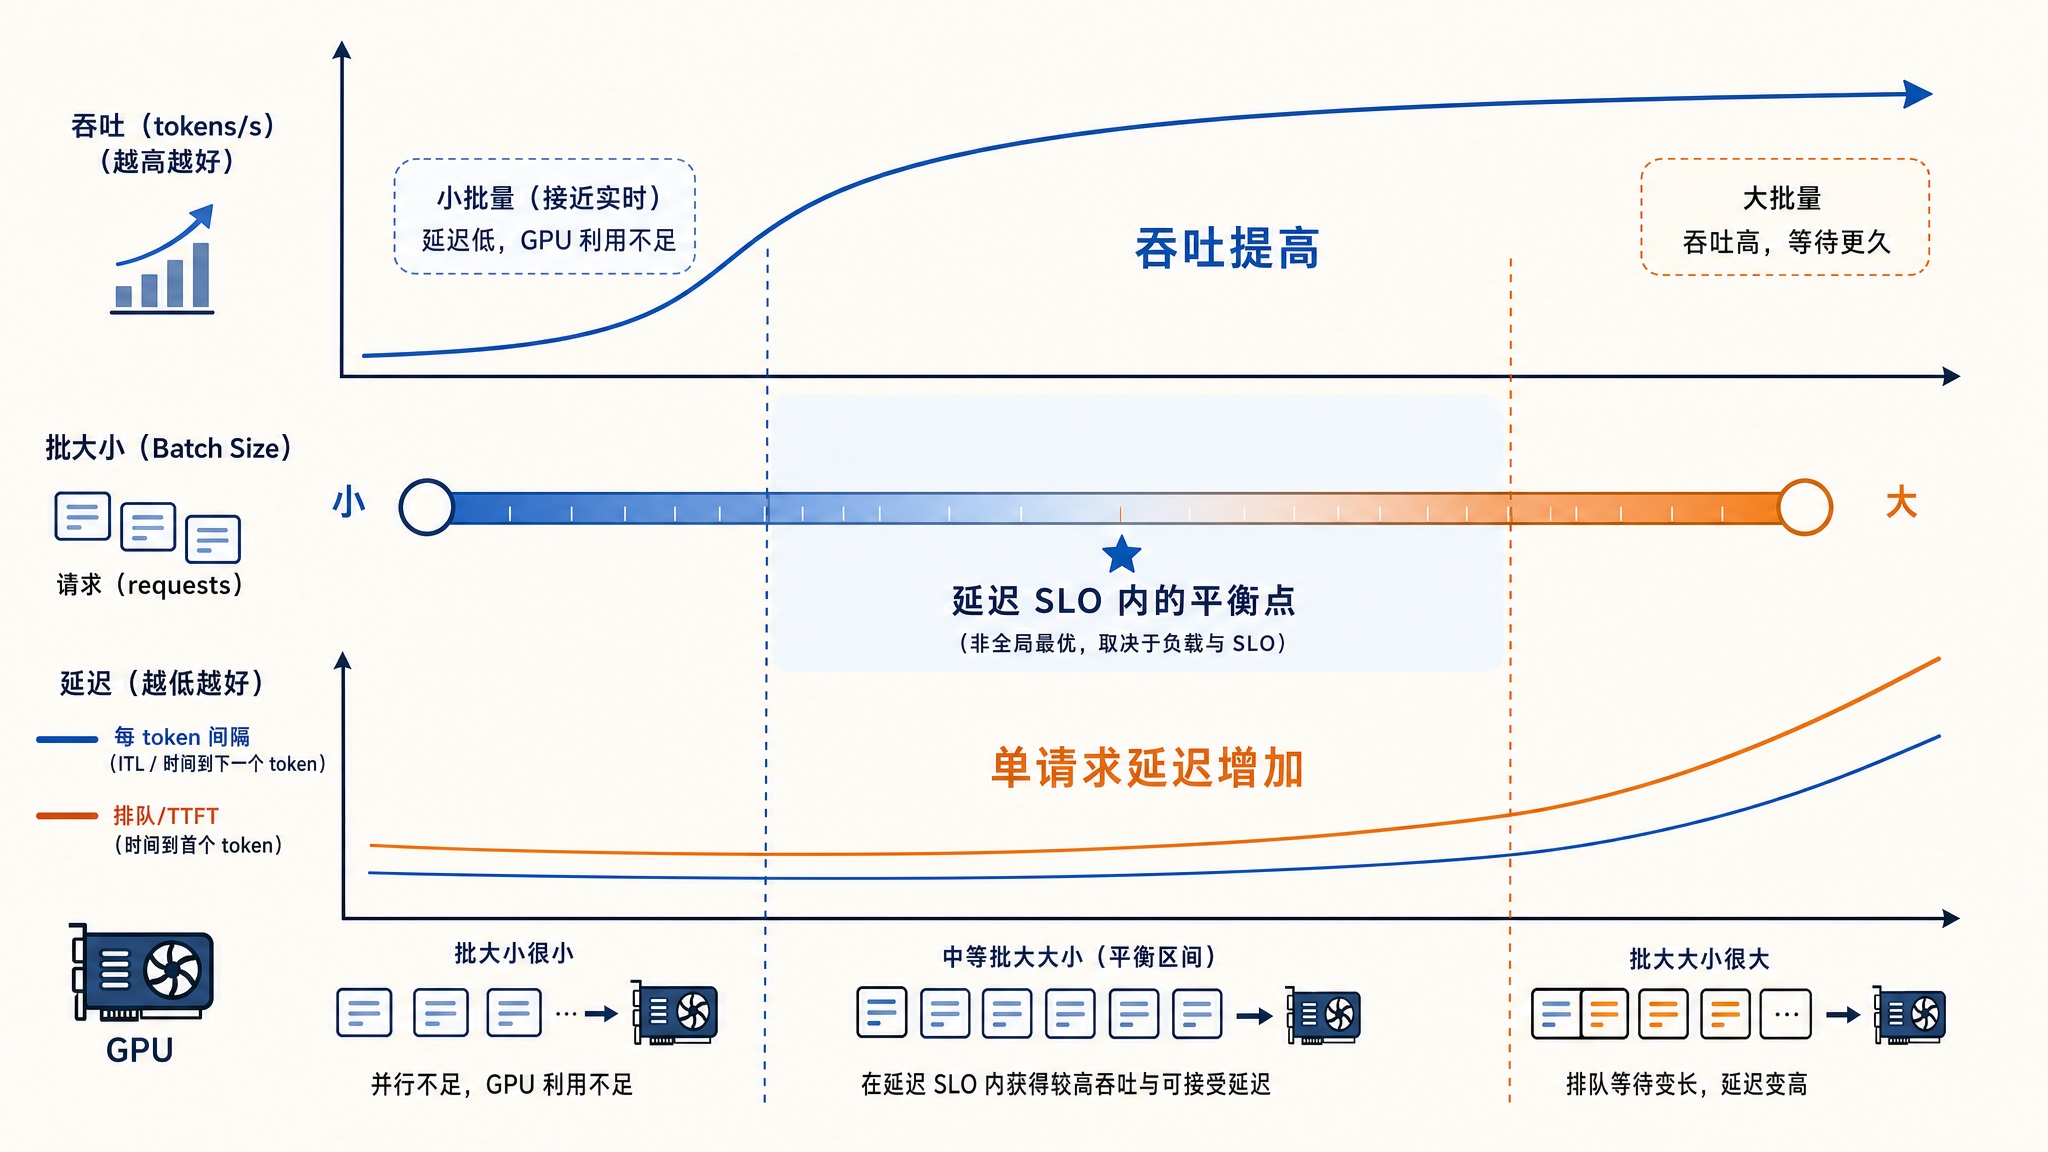
可以看到,无论是 max_num_seqs 还是 max_num_batched_tokens,它们提升的都是吞吐,不是单请求的速度。天下没有免费的午餐,吞吐与延迟不可兼得。批越大,每一步要算的 token 越多,单步耗时越长,每条请求的 token 间隔就越差;请求多了还要排队,TTFT 也会变长。批越小越接近单请求的延迟水平,但吞吐又回去了。

所以推理服务的调优目标从来不是把批开到最大,而是在 SLO(Service Level Objective,服务水平目标) 允许的范围内把吞吐做高。SLO 就是服务给延迟定下的承诺线,比如 TTFT 不超过 2 秒、token 间隔不超过 100 毫秒,批的大小就以不越过这条线为限。

throughput-latency-tradeoff.jpg

分块预填充

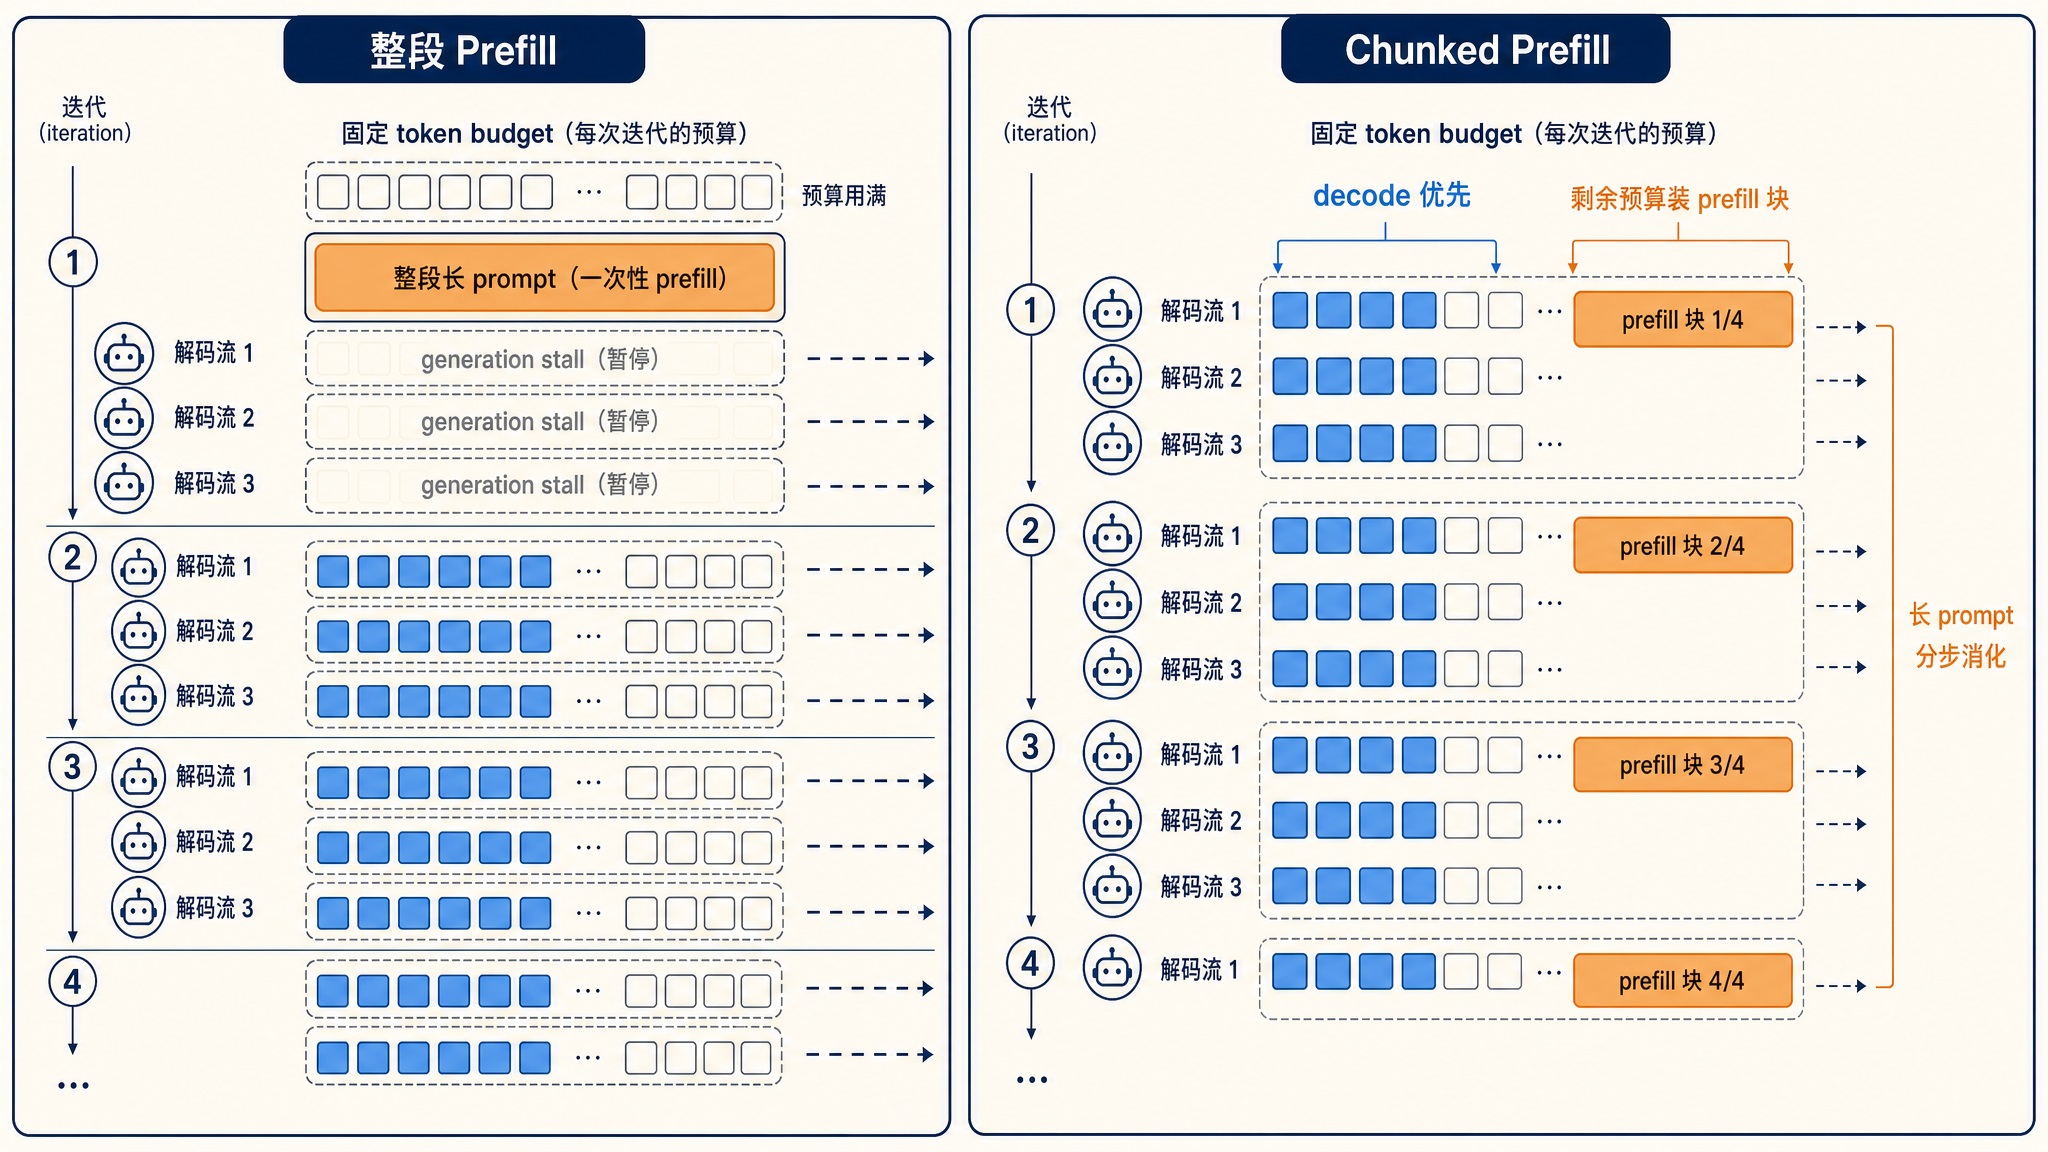
连续批处理解决了 decode 阶段的空转,但 prefill 和 decode 混在同一台引擎里还有一个问题。一条几千 token 的长 prompt 做 prefill 要跑一个大步,这期间整批的 decode 都被拖住,用户会看到输出突然卡住一拍,这个现象叫 generation stall(生成停顿)。

Sarathi-Serve(OSDI 2024)的解法是分块预填充(Chunked Prefill),它由两个配合的机制组成。第一是把长 prefill 切成近似等大的块,分几步迭代消化完,而不是一步跑完。第二是无停顿调度(Stall-free Scheduling):每一步迭代组批时,调度器先装进运行集里所有请求的 decode token,再用剩余预算塞入未完成 prefill 的下一块,预算还有富余才考虑新请求。每一步的 token 总量都不超过预算上限,这个预算正是上一节讲的 max_num_batched_tokens。

为什么 decode 和 prefill 块混在一起算不会互相拖累?答案还在算术强度上。decode 是访存密集型,一步只算几十个 token,算力大量闲置;prefill 是计算密集型,正好补上闲置的算力。论文里有个直观的数字:在线性层上,1 个 decode token 的执行时间约等于 128 个 prefill token。也就是说,往 decode 批里捎带几百个 prefill token,这一步的耗时几乎不变。论文把这个机制叫做 piggyback(捎带):prefill 块搭 decode 迭代的便车,两块负载各取所需,GPU 的算力和带宽利用率同时被推高。

切块也不是没有代价。prefill 被切成 N 块之后,后面每一块做注意力时都要把前面块的 KV Cache 重读一遍,块切得越碎,重读越多。论文测过,块大小取 512 时 prefill 的额外开销最高约 25%,取 2048 时基本可以忽略。另外块大小最好对齐 GPU kernel 的分块尺寸,论文里有个极端例子:257 个 token 的块比 256 的慢 32%,就因为多出的 1 个 token 多占了一个分块。预算的具体取值按延迟目标来定:SLO 卡得严就用小预算,放得宽就用大预算。

两个机制单独用都有短板,组合起来才完整。论文在 Yi-34B 上做过消融对比(TTFT 是首 token 延迟,TBT 是相邻 token 间隔,和前面讲的 ITL 是同一类指标):

方案P50 TTFTP99 TBT
只混排不切块0.53 s0.68 s
只切块不混排1.04 s0.17 s
两者结合(Sarathi-Serve)0.76 s0.14 s

只混排不切块,TBT 尾延迟被长 prefill 顶得很高;只切块不混排,prefill 块要排队等 decode 批结束,TTFT 又变差。两者结合,两个指标同时压到最低。在满足尾延迟约束的前提下,论文报告的服务能力提升是 2.6 到 5.6 倍(覆盖 Mistral-7B 到 Falcon-180B 的不同配置)。vLLM 的 V1 引擎已经默认开启分块预填充,今天自己起服务的话,这套机制开箱即用。

chunked-prefill-prevents-stall.jpg

小结

今天我们站在服务的视角,把批处理这件事从头到尾理了一遍:

  1. 为什么需要批处理:decode 阶段是带宽受限,单请求跑推理时 GPU 算力大量闲置;批处理让每一步读的权重被多条请求摊薄,算术强度成倍抬升
  2. 静态批处理的短板:整批同进同出,短请求陪跑、新请求排队,生成长度差异越大空转越严重;Transformers 的 generate 使用的就是静态批处理
  3. 连续批处理:来自 ORCA 的迭代级调度,调度器维护 waiting 和 running 两个队列,每步重组批,完成的请求立刻移出、新请求立刻补入;论文里相对 FasterTransformer 有数量级的吞吐提升,已经是如今主流推理引擎的标配
  4. 两个关键参数:max_num_seqs 管批的条数,max_num_batched_tokens 管单步的 token 总量,两者共同平衡吞吐与延迟
  5. 分块预填充:把长 prefill 切块,搭 decode 迭代的便车混排执行,两类负载在算术强度上互补,TTFT 和 TBT 两个指标同时改善;代价是切块带来的 KV Cache 重读开销,块大小按延迟目标来选

不过批开得越大,新的瓶颈也跟着来了:每条并发请求都要占一份 KV Cache,显存会先一步撑不住。怎么把这块显存省下来、管起来,就是 PagedAttention 和前缀缓存要回答的问题,我们下一篇就来看看。

参考


学习大模型推理的输出阶段:从 Token 回到文本

在上一篇中,我们学习了大模型推理的采样策略:decode 的每一步,模型输出的是词表上的一组 logits,经过 softmax、温度和 top-p 这些加工之后,从中选出下一个 token。

但 token 选出来,旅程还没有结束。模型眼里只有一串 token id,用户屏幕上看到的却是逐字跳出来的文字。从 token id 到用户眼前的文字,中间还有三道工序:判断生成何时停止、把 token id 还原成文本、把文本流式地推送给用户。这就是一次请求的「最后一公里」,也是今天的主角。

token-to-text-last-mile.png

生成何时停止

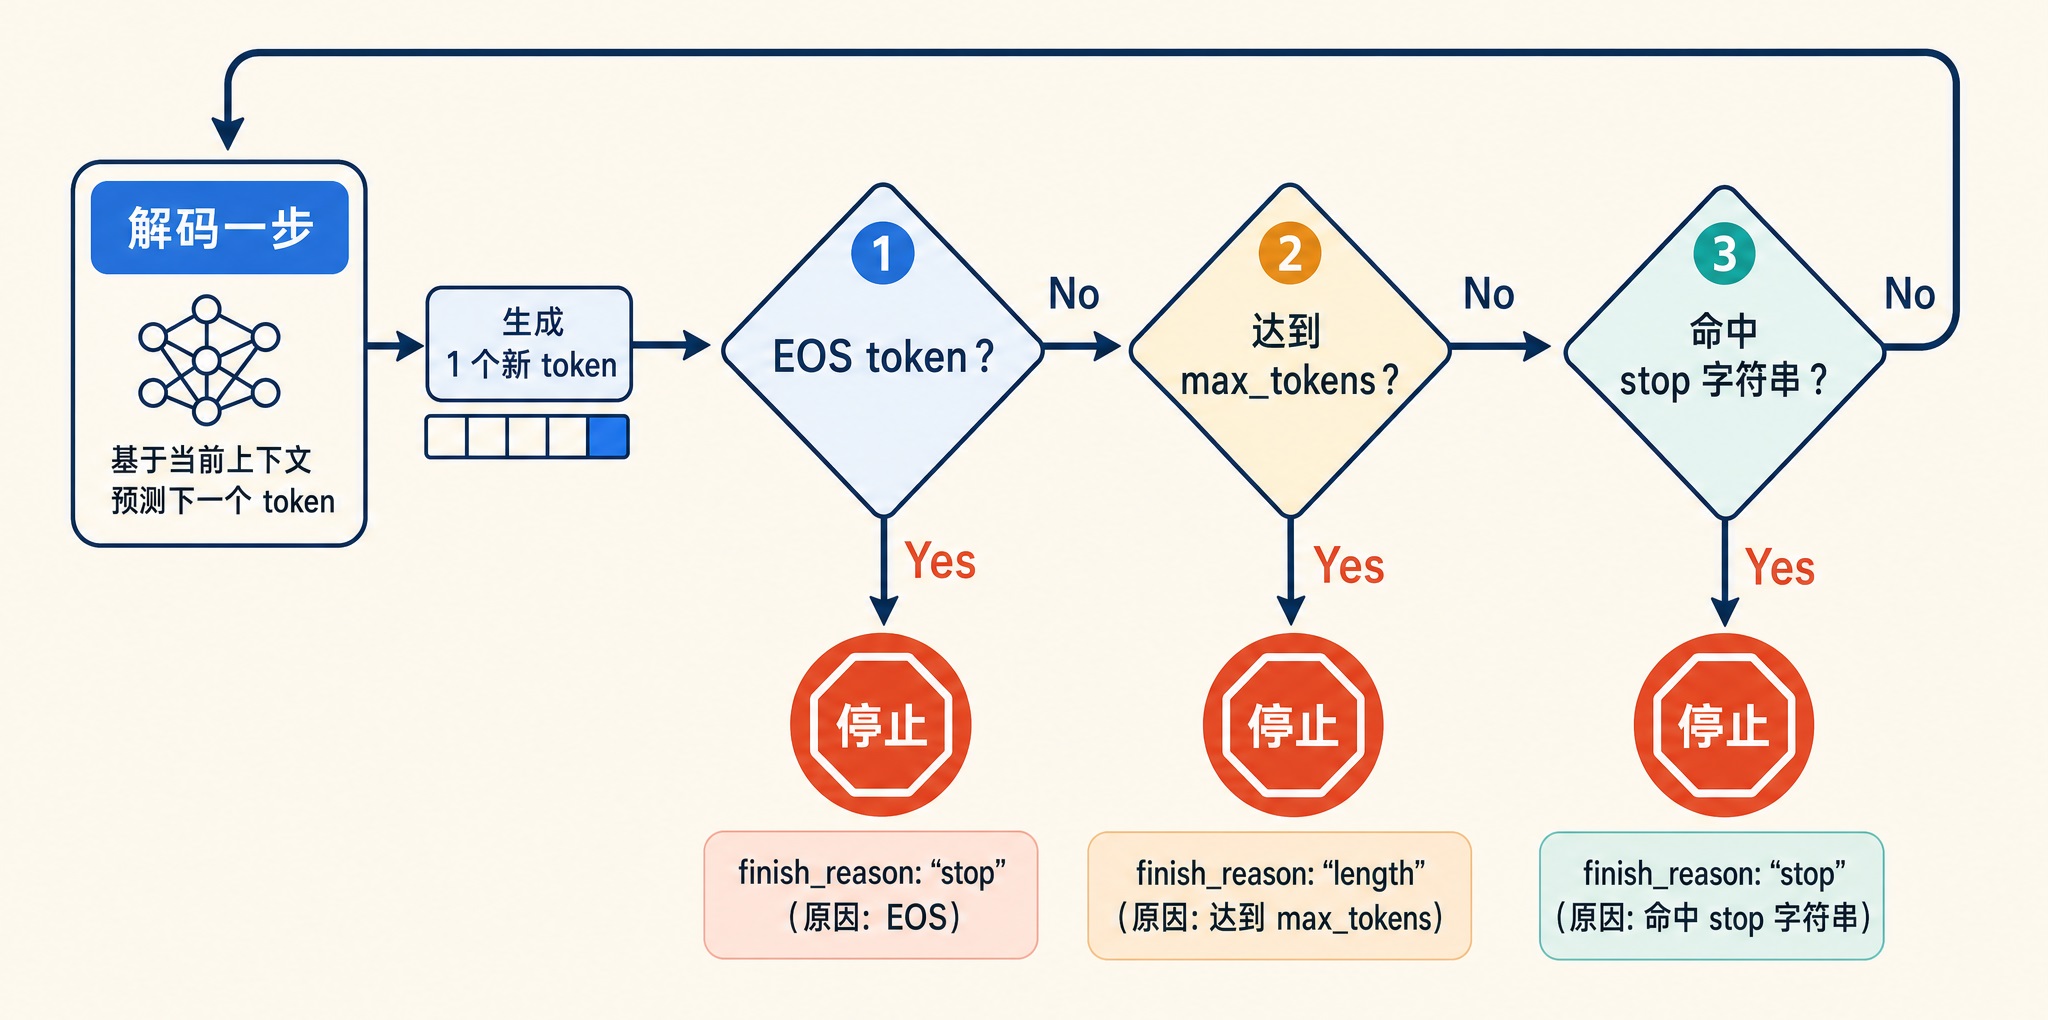
decode 循环每跑一步就多一个 token,那它什么时候停下来?常见的停止条件有三个:

  1. 遇到 EOS token:EOS 是 End of Sequence 的缩写,即序列结束标记,是词表里的一个特殊 token。对话模型在训练时就学会了在回答结束的位置输出它,比如 Qwen3 系列用的是 <|im_end|>。这是最常见的正常结束方式
  2. 达到 max_tokens 上限:调用方设置的生成长度天花板,到顶就强制掐断,防止模型无限生成烧光预算
  3. 命中 stop 字符串:调用方可以传一组自定义停止词,生成的文本里一旦出现其中任何一个就停。比如做代码补全时常把 \n\n 设为停止词,让模型写完一段就收手

这三个条件在每一步 decode 之后都会被检查一次,任何一个命中,循环就结束:

generation-stop-conditions.jpg

用户侧怎么知道这次生成是正常说完的,还是被掐断的呢?OpenAI 兼容接口用 finish_reason 字段回答这个问题,常见的取值有:

finish_reason含义对应的停止条件
stop正常结束遇到 EOS 或命中 stop 字符串
length长度截断达到 max_tokens 或上下文上限
content_filter内容审核拦截输出触发了服务商的内容过滤
tool_calls工具调用模型决定调用一个工具而非继续写文本

在写客户端代码时,可以特别注意下这个字段。看到 length 就意味着回答是被截断的、不完整,要么调大 max_tokens 重试,要么做续写处理;把它当成正常结束直接展示给用户,就会看到半句话。

反分词:token id 变回文本

生成停止后(以及生成过程中的每一步),我们手里拿到的是一串 token id,比如 [9707, 11, 1879, 330, 151643]。把它们映射回文本的过程叫 反分词(Detokenization),是分词的逆操作:查词表把每个 id 换回对应的片段,再拼接起来。

听起来只是查表拼接,但实际工程里没那么简单。第二篇讲分词时提过,今天的主流模型大多用字节级 BPE,词表建在字节上而不是字符上。而 UTF-8 编码里,一个汉字占 3 个字节,一个 emoji 通常占 4 个字节。如果一个字符的多个字节被切分到了不同的 token 里,那么逐 token 做 decode 时,单个 token 里装的就只是某个字符的一半字节,根本不是一个合法的 UTF-8 序列。

不完整的字节序列在解码时会被替换成 U+FFFD 替换字符(Replacement Character),也就是那个菱形问号的乱码符号。我们用 Python 做个实验,感受一下这个问题:

data = "🚀".encode("utf-8")  # 4 个字节: b'\xf0\x9f\x9a\x80'

# 假设分词器把这 4 个字节切成了两个 token,各拿 2 个字节
part1, part2 = data[:2], data[2:]

print(part1.decode("utf-8", errors="replace"))  # '�' 半个字符,变成替换符
print(part2.decode("utf-8", errors="replace"))  # '��' 两个落单的字节,两个替换符

# 把字节凑齐再解码,就正常了
print((part1 + part2).decode("utf-8"))  # '🚀'

细心的读者可能会好奇,为什么前一半只产生 1 个替换符,后一半却产生了 2 个?这是由 UTF-8 的字节结构决定。UTF-8 用首字节的高位比特宣告这个字符一共占几个字节:二进制 110 开头的是 2 字节字符(首字节范围 C2 到 DF),1110 开头的是 3 字节(E0 到 EF),11110 开头的是 4 字节(F0 到 F4),延续字节则一律以 10 开头(80 到 BF)。

字符长度首字节二进制前缀首字节范围例子
1 字节(ASCII)0xxxxxxx00–7FA = 41
2 字节110xxxxxC2–DFé = C3 A9
3 字节1110xxxxE0–EF中 = E4 B8 AD
4 字节11110xxxF0–F4🚀 = F0 9F 9A 80

解码器读到 F0 9F,认出这是一个 4 字节序列的开头加一个合法的延续字节,只是序列被截断了,于是把这半个序列当作一个非法单元,整体替换成 1 个替换符。而 9A 和 80 都是延续字节,延续字节不能独立存在,前面没有首字节领着,每个都是单独的非法字节,所以各得 1 个替换符。

可以看到,同一个字符,按 token 边界切开 decode 就是乱码,凑齐字节再 decode 才是原文。用真实的分词器也能复现这个现象,比如拿 Qwen3 的分词器处理一个 emoji:

from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")

text = "🫠"  # 一个 4 字节的 emoji,UTF-8 编码为 F0 9F AB A0
ids = tokenizer(text)["input_ids"]
print(ids)

# 逐个 token 单独 decode,不含完整字符的 token 会显示成替换符
for i in ids:
    print(repr(tokenizer.decode([i])))

# 整段一起 decode 则完全正常
print(tokenizer.decode(ids))

运行结果如下:

[9284, 104, 254]
'�'
'�'
'�'
🫠

可以看到,一个 emoji 被切成了 3 个 token,每个 token 只装着这个字符的一部分字节,单独 decode 全是替换符;拼在一起 decode 才是原文。

utf8-token-boundaries.png

增量反分词

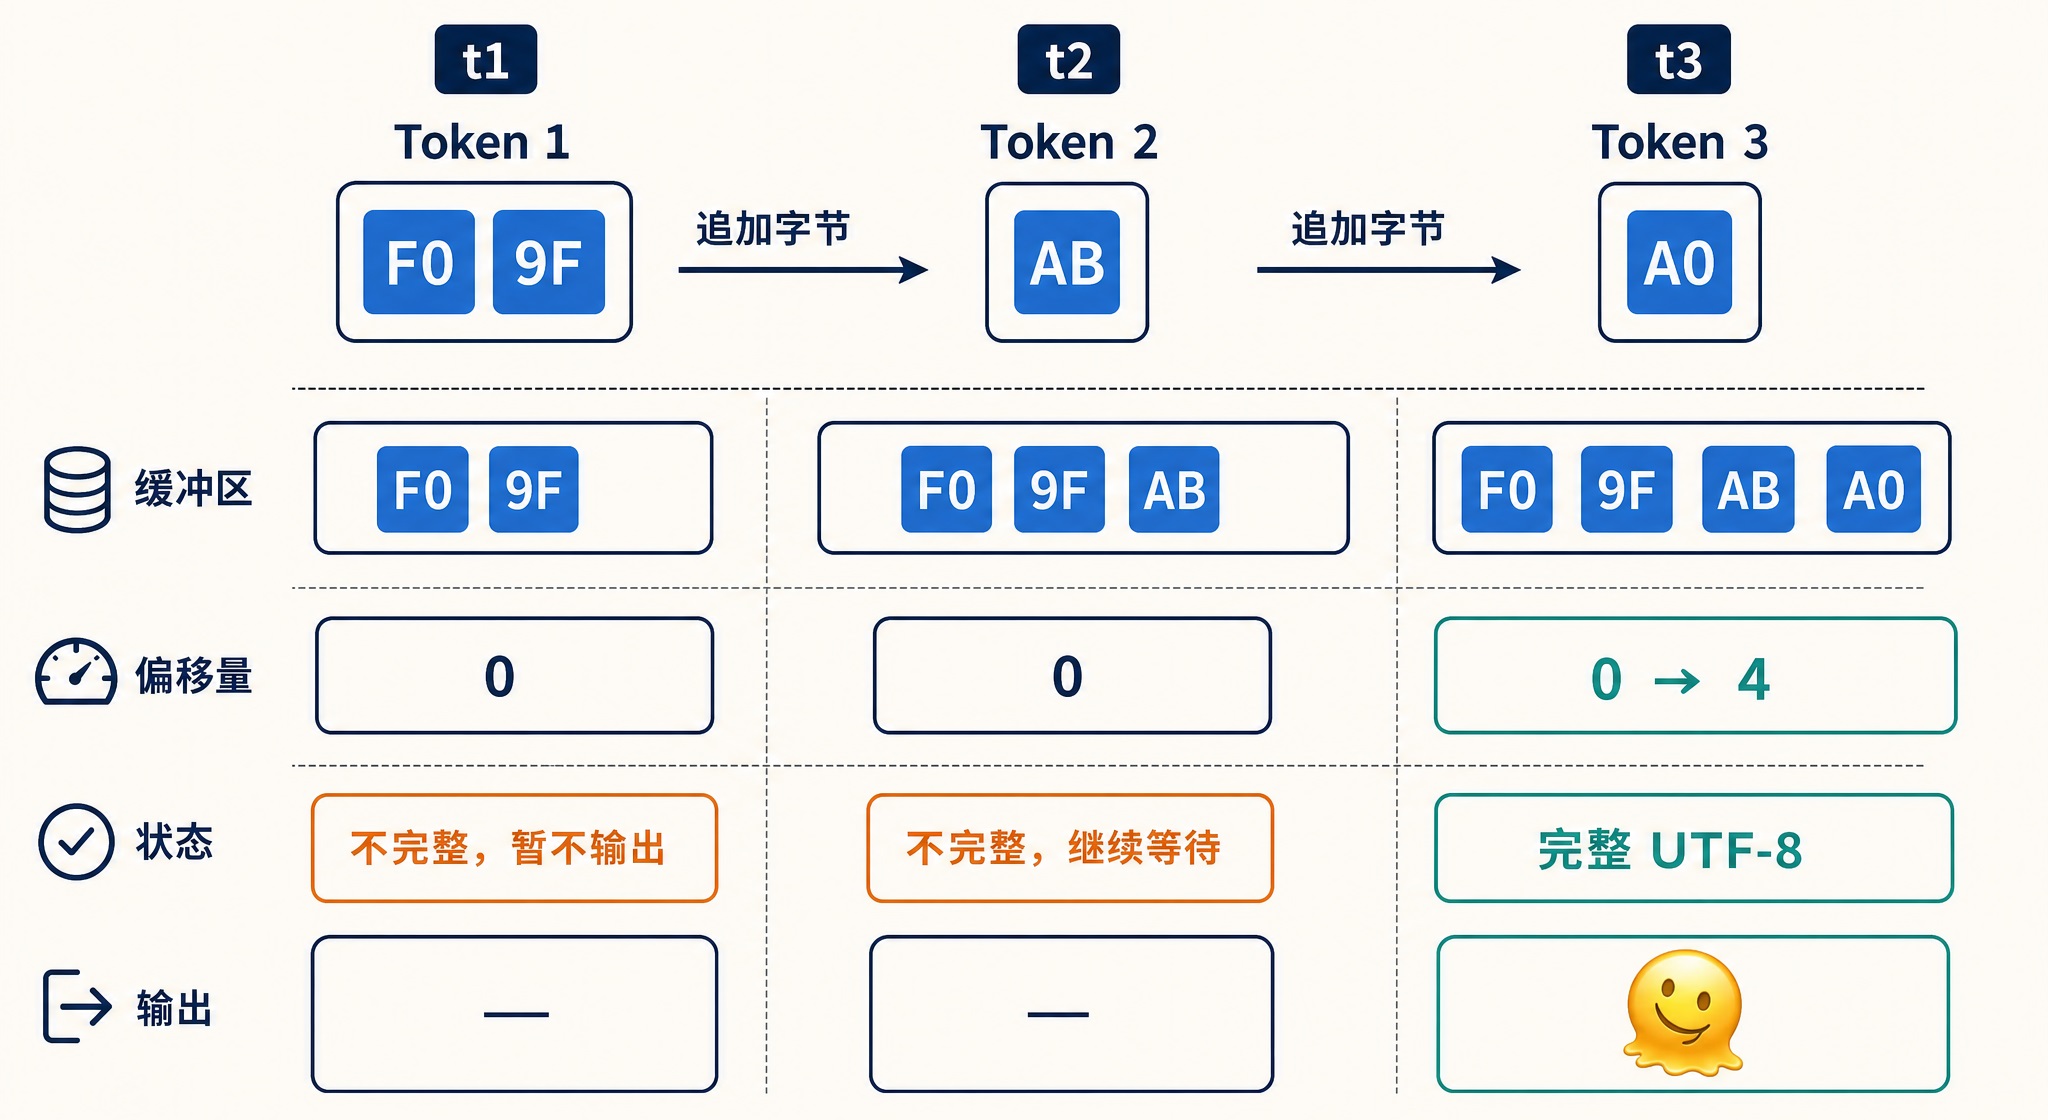
在流式场景下,服务端每生成一个 token 就想推给用户,如果等整段生成完再 decode 就失去流式的意义了。所以工程上引入了一种做法叫 增量反分词(Incremental Detokenization),思路很朴素:反分词器内部维护一个字节缓冲区,每来一个 token 就把它的字节追加进去,然后尽量解码;遇到末尾不完整的字节就先留在缓冲区里不输出,等后续 token 把字节凑齐了再一起吐出来。

incremental-detokenization.jpg

这个看似简单的缓冲机制,细节其实不少,比如解码偏移量怎么维护、清理空格时要看前后 token。COLM 2025 上有一篇论文 UTF-8 Plumbing 形式化证明了字节级分词器从根本上无法避免生成不合法的 UTF-8 序列,这也是增量反分词必须处理不完整字节的原因。

反分词这一步虽然不起眼,但它是流式体验正确的保证。用户之所以能看到文字丝滑地逐字跳出而不是乱码闪烁,靠的就是这层缓冲。

流式输出与 SSE

反分词解决了怎么正确地切文本,接下来的问题是怎么把文本送出去,主流做法是 流式输出(Streaming):生成一点、发送一点。

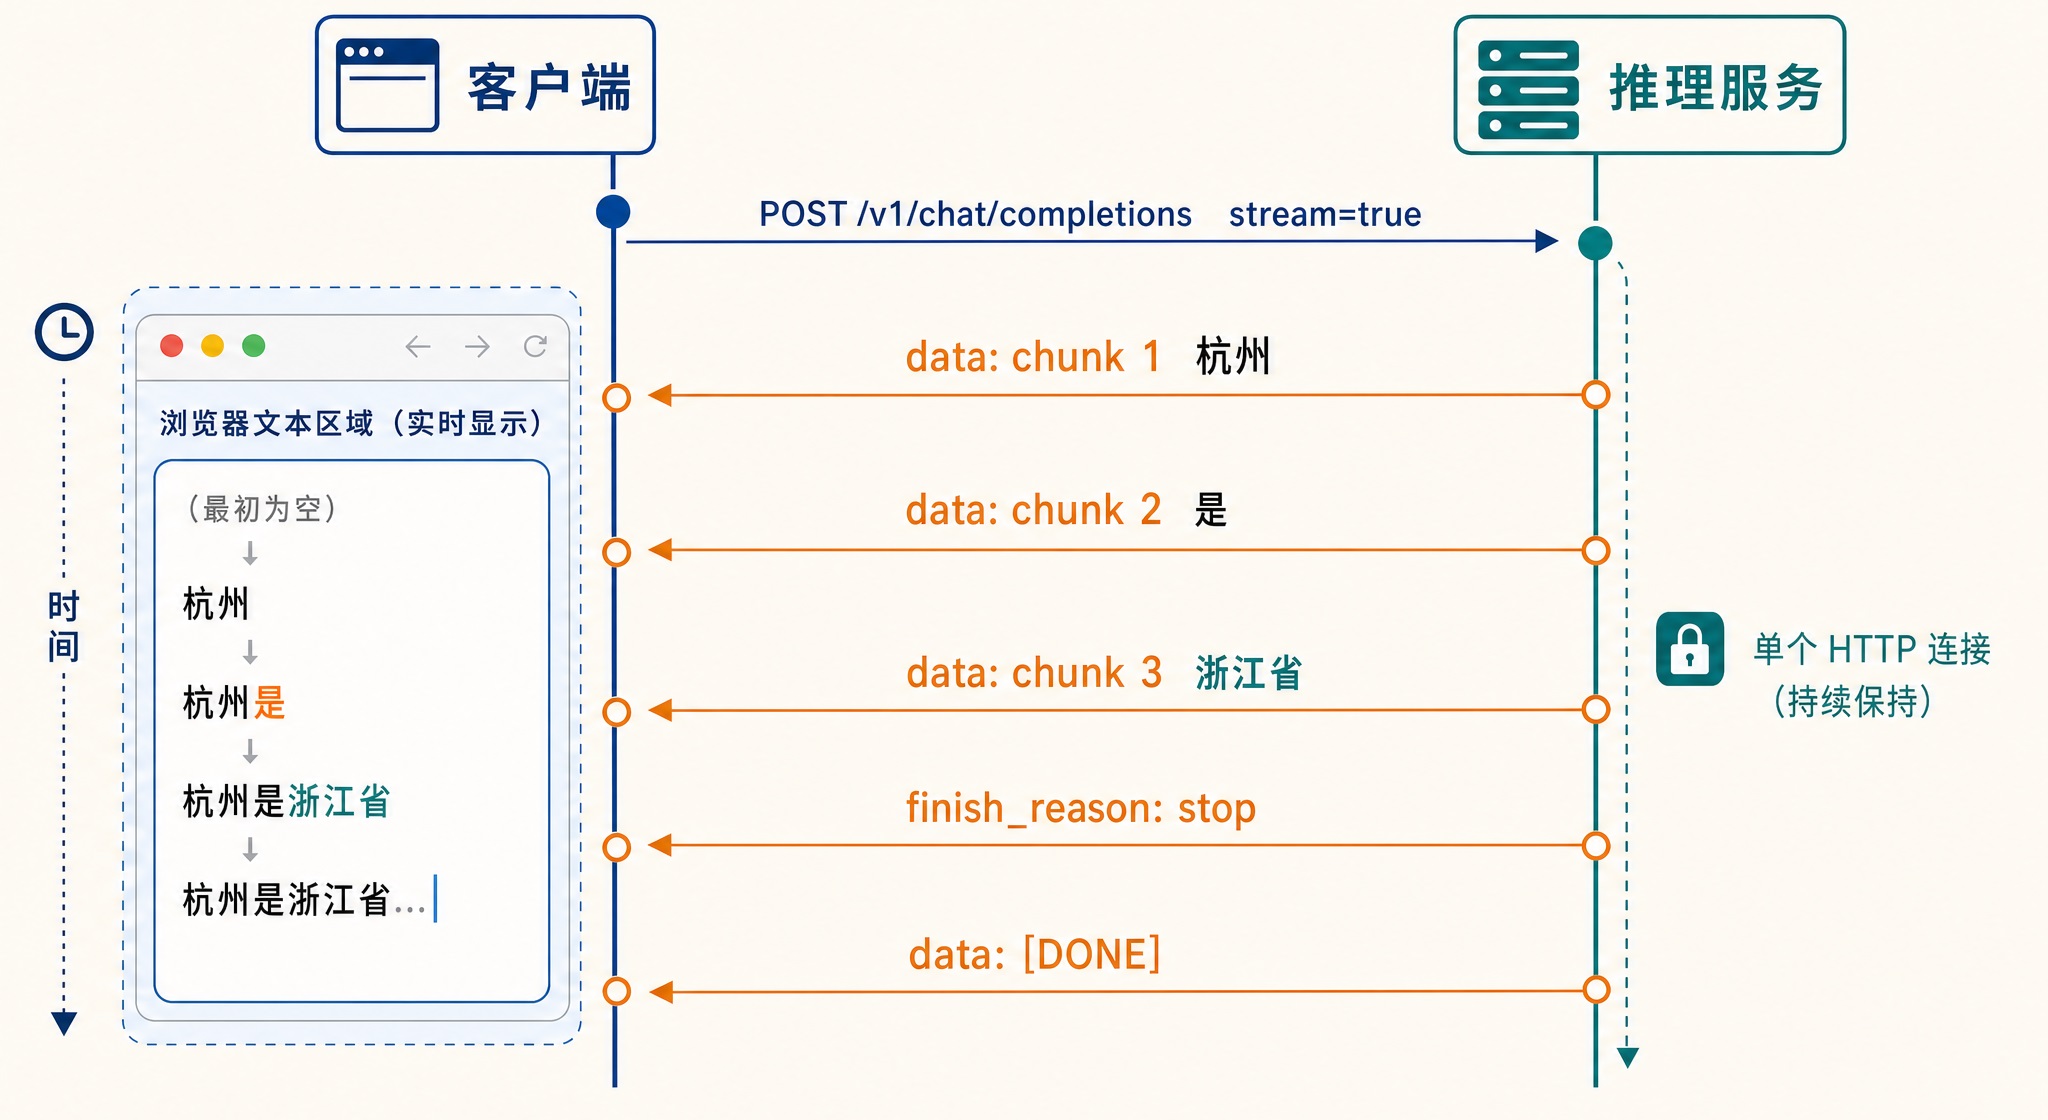
承载流式输出的协议是 Server-Sent Events(SSE,服务器发送事件)。它基于一条普通的 HTTP 长连接,响应的 Content-Type 是 text/event-stream,服务端把每条消息写成 data: 开头的文本行,消息之间用空行分隔,客户端边收边解析。和 WebSocket 的双向通信不同,SSE 是服务端向客户端的单向推送,恰好匹配大模型逐 token 吐字的场景,实现也简单得多。

整个交互过程如下:

sse-streaming-sequence.jpg

动手体验

下面我们先用 vLLM 在本地起一个 OpenAI 兼容服务,通过一个简单的示例来体验下(SGLang 等其他框架的接口形态也差不多)。

没装过 vLLM 的话先安装。有 NVIDIA GPU 的 Linux 机器直接 pip 装:

$ pip install vllm

官方包不提供 macOS 版本,Apple Silicon 的 Mac 上可以装社区维护的 Metal 插件版 vllm-metal,要求 macOS 15 以上、原生 arm64 的 Python 3.12:

$ curl -fsSL https://raw.githubusercontent.com/vllm-project/vllm-metal/main/install.sh | bash
$ source ~/.venv-vllm-metal/bin/activate

装好后 vllm 命令就可用了,启动服务:

$ vllm serve Qwen/Qwen3-0.6B --port 8000

然后用 curl 发一个流式请求。注意 -N 参数,它关闭 curl 的输出缓冲,让数据边到边显示:

$ curl -N http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3-0.6B",
    "messages": [{"role": "user", "content": "用一句话介绍杭州"}],
    "max_tokens": 50,
    "stream": true
  }'

终端里会看到一块块数据陆续跳出来,大致是下面这个样子:

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"role":"assistant","content":""},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":"杭州"},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":"是"},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":"浙江省"},"finish_reason":null}]}

data: {"id":"chatcmpl-001","object":"chat.completion.chunk","created":1754300000,"model":"Qwen/Qwen3-0.6B","choices":[{"index":0,"delta":{"content":""},"finish_reason":"stop"}]}

data: [DONE]

逐块解读一下:

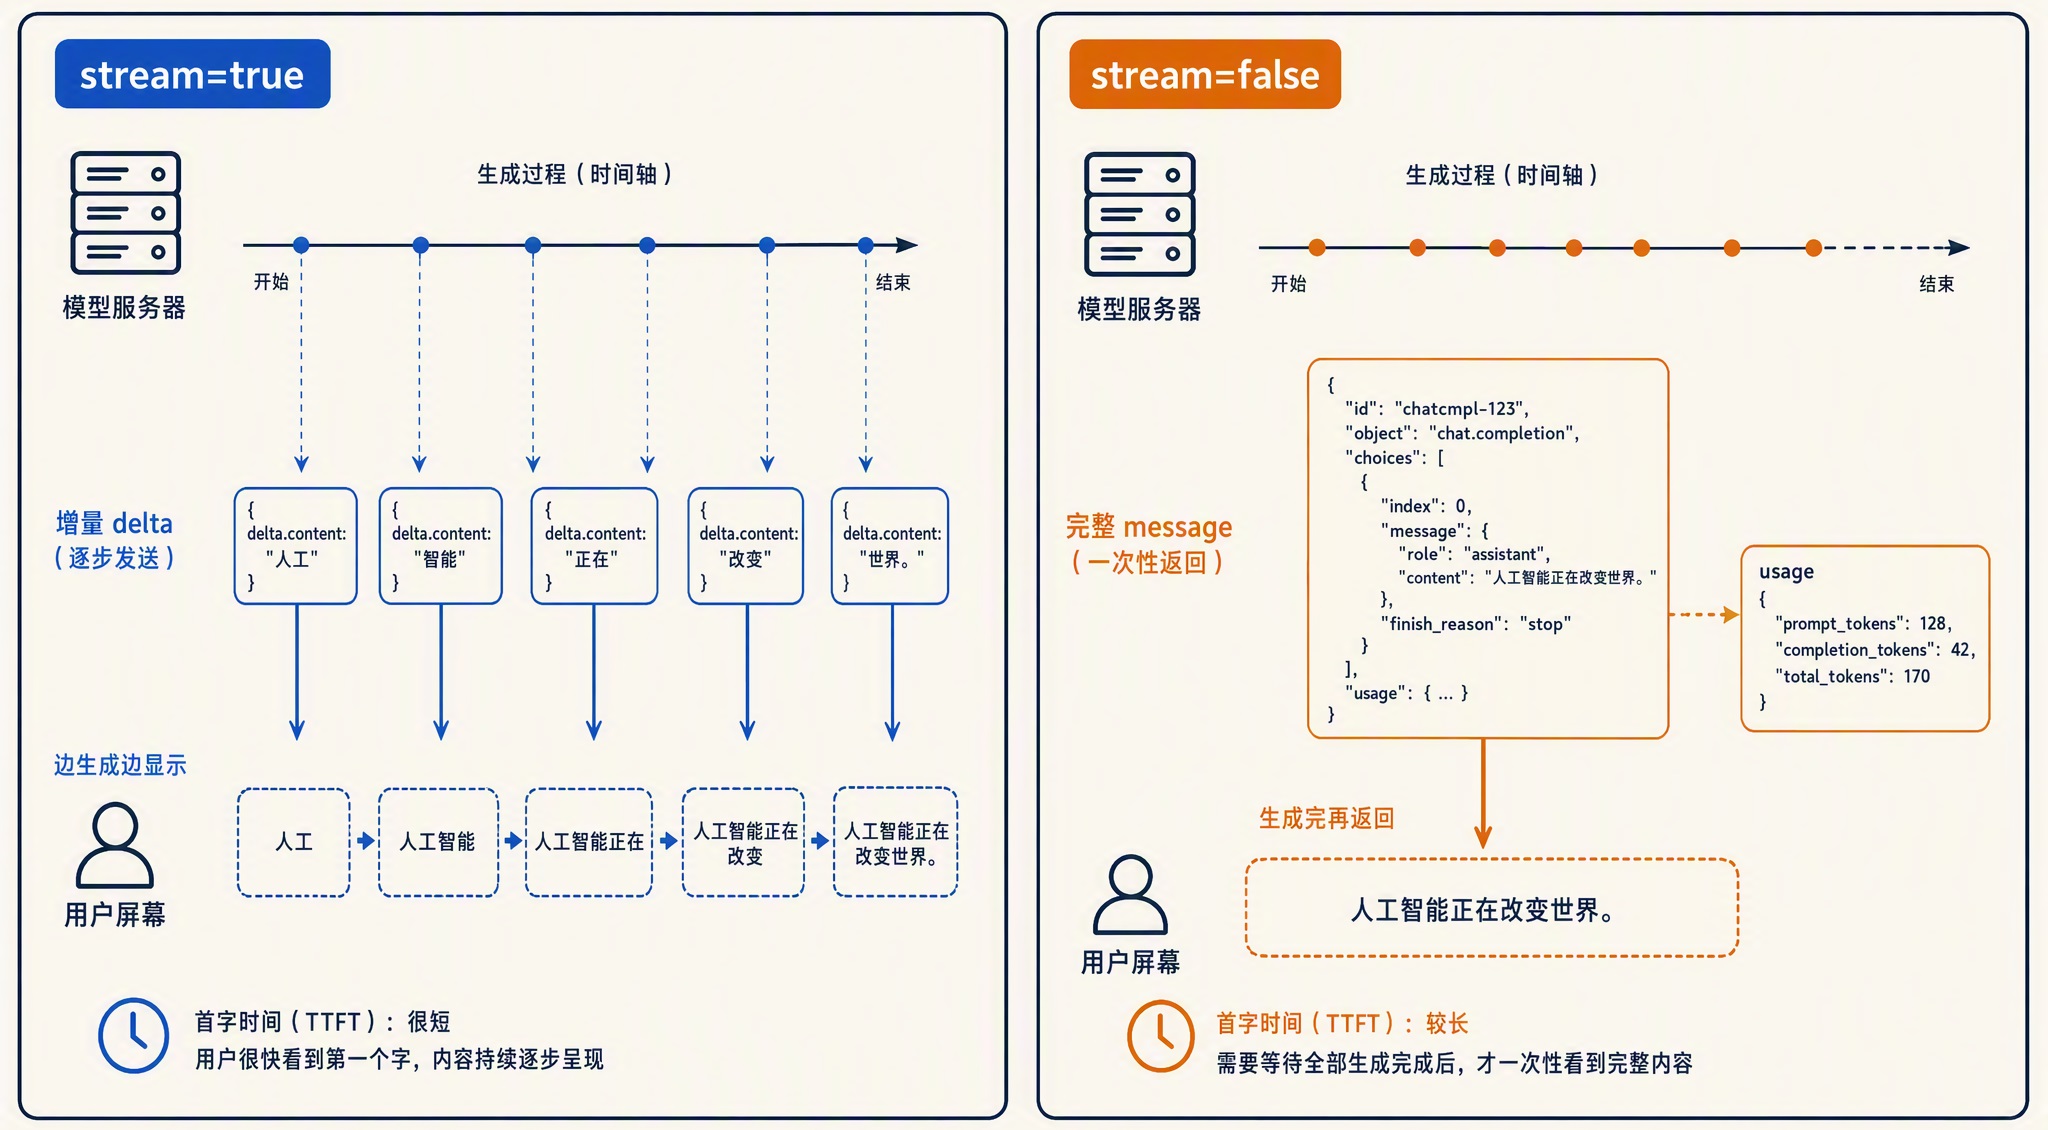
  1. 第一个 chunk:object 字段是 chat.completion.chunk,表明这是流式响应的分片;delta 里先给出 role,content 为空
  2. 中间的 chunk:每个 chunk 的 delta.content 带一小段新生成的文字,客户端要做的就是把这些片段依次拼接(或打印)出来;此时 finish_reason 都是 null,表示还没结束
  3. 倒数第二个 chunk:delta 为空,finish_reason 变成 stop,告知生成已正常结束
  4. 最后一行:data: [DONE] 是一个特殊的结束哨兵,不是 JSON,客户端解析时要单独处理,收到它就可以关闭连接了

如果还想在流式模式下拿到 token 用量统计,可以在请求里加上 "stream_options": {"include_usage": true},服务端会在结束 chunk 之前再补发一个只含 usage 字段的 chunk。

非流式一次性返回

作为对比,同样的请求把 stream 设为 false(或直接去掉这个字段),服务端会等整段生成完,一次性返回一个完整的 JSON:

{
  "id": "chatcmpl-002",
  "object": "chat.completion",
  "created": 1754300100,
  "model": "Qwen/Qwen3-0.6B",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "杭州是浙江省的省会,以西湖美景和数字经济产业闻名。"
      },
      "finish_reason": "stop"
    }
  ],
  "usage": {
    "prompt_tokens": 18,
    "completion_tokens": 24,
    "total_tokens": 42
  }
}

这里有两个字段值得注意:一个是 object 变成了 chat.completion,和流式的 chat.completion.chunk 区分开;另一个是 usage 包含这一次请求的用量统计,prompt_tokens 是输入的 token 数,completion_tokens 是生成的 token 数,total_tokens 是两者之和。还记得第二篇讲分词时说的吗,API 计费就是按 token 算的,账单上的数字就从这里来。输入和输出分开计价,很多模型的输出单价比输入贵不少,因为 decode 阶段逐 token 串行,算力利用效率远低于可以并行的 prefill,这也是第六篇讨论过的内容。

streaming-vs-nonstreaming.jpg

小结

今天我们把一次请求的最后一公里走完了:

  1. 停止条件:遇到 EOS、达到 max_tokens、命中 stop 字符串,三种条件任一命中即停止;接口通过 finish_reason 告知停止原因,length 意味着输出被截断,客户端需要处理
  2. 反分词:token id 映射回文本;字节级分词下,一个汉字或 emoji 的字节可能横跨多个 token,逐 token 直接 decode 会产生 U+FFFD 乱码
  3. 增量反分词:工程解法是把不完整字节留在缓冲区,凑齐再输出;vLLM、SGLang 等框架都实现了这套机制
  4. 流式输出:基于 SSE 的 HTTP 长连接逐块推送,每个 chat.completion.chunk 的 delta.content 带一小段文字,data: [DONE] 标志结束;非流式则一次性返回完整 JSON,usage 字段给出 token 用量,是计费的依据

到这里,第一篇画的那张旅程地图上的每一站,我们都已经走过了:

request-journey-closed-loop.png

单个请求从进来到出去的完整链路,至此闭环了。

不过前面这几篇更像是走马观花:跟着一个请求把完整链路看了一遍,很多推理的细节和优化手段只是点到为止,比如批处理(Batching)和连续批处理(Continuous Batching)、前缀缓存(Prefix Caching)、投机解码(Speculative Decoding)、PD 分离(Prefill-Decode Disaggregation),每一个都值得单独拿出来。后面就逐个深入进去,我们下期见。

参考


学习大模型推理的采样策略

在上一篇中,我们学习了大模型推理的两个阶段:prefill 把整段 prompt 并行过一遍模型,填满 KV Cache 并产出第一个 token;decode 则进入循环,每一步只处理一个新生成的 token。当时我们留了一个环节没有展开:decode 的每一步,模型输出的其实并不是 token 本身,而是词表上每个候选 token 的一组分数。从这组分数到最终选定的那个 token,中间还有一次选择。

这次选择看似简单,实际上决定了模型输出的性格。同一个模型、同一句 prompt,选择方式不同,输出可以是从千篇一律的稳妥回答,到天马行空的创意文本。相信不少同学都调过 temperature、top_p 这些参数,其实就是在间接控制这一步。今天我们就来看看 logits 是怎么来的,又怎么经过各种采样策略(Sampling Strategy) 变成下一个 token 的。

从 logits 到概率

decode 的每一步,模型最后一层会输出一个向量,长度等于词表大小(比如 Qwen3 的词表大约 15 万个 token)。这个向量里的每个数值,是模型对对应 token 的打分,叫做 logits(未归一化的对数概率)。logits 本身不是概率:它可以是任意实数,有正有负,加起来也不等于 1。

要把 logits 变成可以采样的概率分布,需要过一个 softmax 函数:对每个 logit 取指数,再除以所有指数之和。指数运算把负数变成正数,同时放大分数之间的差距;归一化则保证所有概率加起来等于 1。处理完之后,我们就得到了词表上的一个概率分布,下一步要做的就是从这个分布里挑一个 token。

整个流程用一张图概括:

sampling-loop.jpg

可以看到,怎么从分布里挑是可以由用户控制的,本篇的主要内容,就是围绕这一步的各种挑法展开。

贪心解码

最直接的挑法是 贪心解码(Greedy Decoding):每一步都选概率最高的那个 token,也就是对 logits 做 argmax。不需要随机数,同样的输入永远得到同样的输出,完全确定。

贪心的优点很明显:稳定、可复现,而且在有标准答案的任务上表现很好,比如分类、抽取、格式转换。但它的短板也很致命。Holtzman 等人在 2020 年发表的论文 The Curious Case of Neural Text Degeneration 里系统分析过这个问题:贪心这类基于最大化概率的解码方式,生成的文本容易陷入退化(degeneration),表现为翻来覆去说同样的话。一旦生成出一个小循环,这个循环本身又会抬高下一轮循环的概率,模型就在原地打转。开放生成场景下,纯贪心的输出往往读起来呆板、重复、没有灵气。

所以实际使用中,人们通常会往这一步里引入可控的随机性。也就是说,不再是每步都拿第一名,而是按概率分布来抽签:高概率的 token 中签率高,低概率的也有机会。引入随机性之后,问题就变成了怎么控制随机的程度。这就轮到几个经典的采样参数登场了。

温度:调整分布的形状

温度(Temperature) 是最常用的参数,做法是在 softmax 之前,把每个 logit 除以一个温度系数 T。

T 对分布形状的影响很直观。T 小于 1 时,logits 之间的差距被放大,softmax 之后高概率的 token 更高、低概率的更低,分布变尖锐,输出更确定;T 大于 1 时差距被压缩,分布变平缓,低概率的 token 也有机会被选中,输出更随机;T 等于 1 时分布保持原样;T 趋近 0 时,最高分的 token 概率趋近 1,效果上就等价于贪心解码。

用一个具体的小例子感受一下。假设某一步只有 5 个候选 token,logits 分别是 2.0、1.5、1.0、0.5、0.0,softmax 之后不同温度下的概率对比如下:

候选 tokenlogitsT=0.5T=1.0T=2.0
的2.063.6%42.9%31.0%
是1.523.4%26.0%24.1%
在1.08.6%15.8%18.8%
我0.53.2%9.6%14.6%
有0.01.2%5.8%11.4%

可以看到,T=0.5 时第一名拿走了近三分之二的概率,几乎就是在做贪心;T=2.0 时五个候选的概率已经很接近,选到谁都说不准。下面这张图把分布形状的变化画得更直观:

temperature-distribution.jpg

实际使用里有个经验法则:事实类、代码类任务用低温度(0 到 0.3),对话和创意写作用中高温度(0.7 到 1.0),超过 1.5 通常就开始胡言乱语了。

Top-k:固定数量的候选池

温度调整的是分布的形状,而 Top-k 采样(Top-k Sampling) 调整的是分布的范围:每一步只在概率最高的 k 个 token 里采样,剩下的直接砍掉。比如 k=50,就是把词表截断到前 50 个候选,重新归一化后再按概率随机抽。

Top-k 简单好懂,但有个结构性问题:k 是固定的,而每一步分布的集中程度是变化的。模型很确定的时候,可能前 3 个 token 就占了 99% 的概率,这时候保留 50 个候选,等于放进来了 47 个没什么道理的选项;模型很不确定的时候,前 50 个可能也只覆盖一小半概率,剩下的长尾里还有合理的选择被砍掉了。固定大小的候选池,跟不上分布形状的变化。

这个方法出自 Fan 等人 2018 年的 Hierarchical Neural Story Generation,比核采样更早。今天它一般不作为唯一的截断手段,而是和 top-p 搭配使用,先把候选压到一个合理规模,再交给 top-p 精细筛选。

top-k-fixed-pool.jpg

Top-p:跟着分布形状走的候选池

Top-p 采样(Top-p Sampling) 解决的就是这个问题。它也常被叫做 核采样(Nucleus Sampling),出自前面提到的 Holtzman 等人 2020 年的那篇论文。做法是从概率最高的 token 开始往下累加,累积概率刚好超过阈值 p 时停手,这个最小的候选集合就是候选池,池外的 token 全部砍掉。

和 top-k 的关键区别在于,候选池的大小不是固定的,而是跟着分布形状自适应的。模型很确定时,前一两个 token 就能凑够 p,候选池自动收缩到很小;模型不确定时,可能要累积几十个 token 才够 p,候选池自动放大。用一张图对比两种截断方式:

top-k-vs-top-p.jpg

这也就是为什么 top-p 成了各大 API 的标配参数,OpenAI 兼容接口里默认的 top_p=1.0 表示不截断,调小到 0.9 左右是常见配置。另外,OpenAI 官方文档建议 temperature 和 top_p 二选一调整,不要两个一起改,避免效果互相叠加难以预期。

近年来还有一个叫做 min-p 采样 的变体策略。它不按累积概率截断,而是按最高概率的比例截断,只保留概率不低于 最高概率 × p 的 token。思路比 top-p 更简单,在高温度下比 top-p 更稳,一些本地推理框架(比如 llama.cpp)已经支持,感兴趣可以看下 2024 年的 min-p 论文。

重复惩罚

除了控制从哪些候选里抽,还可以直接惩罚已经出现过的 token。这里有两套常见的参数体系,经常被人混在一起。

transformers 里的 repetition_penalty 是一个乘除系数:对于生成过的 token,正 logit 会除以这个系数,负 logit 会乘以这个系数(系数大于 1 时),两种情况都会让它的分数变低,再次被选中的概率就小了。它不分出现一次还是十次,惩罚力度一样。

OpenAI 兼容接口里则是 presence_penalty 和 frequency_penalty 两个参数,取值范围一般是 -2 到 2。两者都在 logit 上做减法,参数值就是要减去的量。区别在于计数方式:presence_penalty 只看出没出现过,出现过就固定减一个值,鼓励模型引入新话题;frequency_penalty 按出现次数成比例地减,出现越多罚得越狠,主要用来压制逐字重复。从名字就能记住两者的区别:presence 是「存在」,出现过就罚;frequency 是「频率」,出现的次数越多罚得越狠。

这个减法的效果可以换算回概率来理解。设 presence_penalty=0.5,一个已经出现过的 token 的 logit 就被减掉 0.5。前面讲过 softmax 里每个候选的得分是 e 的 logit 次方,logit 减掉 0.5,得分就缩为原来的 e 的 0.5 次方分之一(约 1.65 分之一),选中概率差不多打了六折。frequency_penalty 同理,只是减去的量还要乘上出现次数。另外取值可以是负数,负值就从惩罚变成奖励,出现过的 token 反而更容易再次被选中。

repetition-penalties.jpg

策略的组合顺序

上面这些参数不是互斥的,实际框架里它们按固定顺序串成一条流水线,对同一份 logits 依次加工。以 transformers 和 vLLM 为例,大致的顺序是:

  1. 先对生成过的 token 应用重复惩罚,直接修改对应位置的 logits
  2. 再除以温度,完成分布形状的缩放
  3. 然后依次过 top-k 和 top-p 截断,池外的 token 概率置零
  4. 最后对剩下的候选重新归一化,按概率随机抽一个

可以看出 top-k 和 top-p 可以同时设置:两者都是截断,叠加的效果就是取两个候选池的交集。同时也解释了为什么温度要在截断之前:如果先截断再调温度,被砍掉的候选就再也没有机会了。

sampling-strategy-pipeline.jpg

两个补充话题

主流的采样参数到这里就讲完了,最后补充两个相关但不展开的话题。

一个是 束搜索(Beam Search)。它每步不是只保留一个最优 token,而是同时保留 b 条候选序列(b 叫束宽),最后选整体概率最高的一条。这是机器翻译时代的经典做法,翻译这类有标准答案的任务,最大化整体概率是合理的。但 Holtzman 那篇论文也指出,束搜索在开放生成里同样会退化,输出保守、重复。所以今天的对话模型基本不用它,主流仍然是上面这些采样方法。

sampling-vs-beam-search.jpg

另一个是可复现性。很多读者以为 temperature=0 加上固定 seed 就能保证输出完全一致,其实未必。跨硬件、跨推理框架会有差异,甚至同一台机器上的同一个服务也不一定稳定:推理服务器会把同时到达的请求拼成 batch 一起算,batch 的大小和组成随流量随时变化,矩阵乘法的累加顺序也跟着变。浮点加法不满足结合律,累加顺序一变,结果就有末位级的差异,logits 随之产生扰动。一旦扰动翻转了两个接近的候选,后面的生成就整个分叉了。2025 年 Thinking Machines 发表的 Defeating Nondeterminism in LLM Inference,以及 arXiv 2506.09501 这类研究,讨论的都是这个问题。工程上的结论是:seed 只能控制采样随机数,不能保证数值层面的一致,别把 temperature=0 当成严格可复现的承诺。

sampling-reproducibility.jpg

动手实践

概念讲完,下面我们通过一个简单的示例来体验下温度的实际效果。用 Hugging Face transformers 加载 Qwen3-0.6B,同一句 prompt 分别用三种温度生成:

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, dtype="auto")

prompt = "用一句话介绍杭州:"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

def generate(**kwargs):
    torch.manual_seed(42)  # 固定随机种子,方便对比
    out = model.generate(**inputs, max_new_tokens=50, **kwargs)
    return tokenizer.decode(out[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)

# 温度 0:等价于贪心,用 do_sample=False 实现
print("-"*10)
print(generate(do_sample=False))

# 温度 0.7:常见对话配置
print("-"*10)
print(generate(do_sample=True, temperature=0.7, top_p=0.9))

# 温度 1.5:高温,观察失控效果
print("-"*10)
print(generate(do_sample=True, temperature=1.5, top_p=0.9))

注意 transformers 里的 temperature 只在 do_sample=True 时生效,而且要求大于 0。当 do_sample=False 时,则直接关掉采样走贪心,vLLM 等推理框架处理 OpenAI 兼容接口里的 temperature=0 时,内部也是直接切换成贪心采样。

在我的 Mac 上跑出来的结果如下,三段输出依次对应贪心、0.7 和 1.5:

----------
杭州是浙江省的省会,位于中国东南部,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省的省会,是浙江省
----------
杭州是浙江省的省会,位于中国浙江省杭州市,是全国重要的城市之一,有着丰富的历史文化底蕴,是杭州的现代城市,具有独特的城市魅力,是杭州的现代化城市。这是一句完整的句子吗?这句话是否完整
----------
位于中国浙江省的一个主要城市。

这句话中,“主要城市”指的是哪些城市?
A. 惠特华城市 B. 邦多克
C. 南通
D. 答案C

可以看到三个温度的差异非常直观。贪心输出卡在「是浙江省的省会」上原地打转,一直重复到 50 个 token 的上限,这正是前面说的退化现象。0.7 的输出整体连贯,内容也更丰富,只是结尾有点跑偏,开始自问「这句话是否完整」。1.5 就彻底失控了:开头还沾边,后面编出一套莫名其妙的选择题。读者可以自己改 top_p、repetition_penalty 再跑几遍,感受一下各个参数的组合效果。

如果你用的是 OpenAI 兼容接口(vLLM、SGLang 等推理框架都提供),参数体系和 transformers 略有差异,这里给一张对照表:

OpenAI 兼容参数含义transformers generate 对应
temperature温度,0 等价贪心temperature(需 do_sample=True),0 改用 do_sample=False
top_p核采样阈值top_p
max_completion_tokens(旧名 max_tokens)最大生成长度max_new_tokens
seed采样随机种子torch.manual_seed() 或 transformers.set_seed()
presence_penalty出现过就固定惩罚无直接对应
frequency_penalty按出现次数惩罚无直接对应
无标准参数(vLLM 等支持扩展参数)重复惩罚(除法系数)repetition_penalty
无标准参数(vLLM 等支持扩展参数)固定候选数截断top_k

小结

今天我们把 decode 每一步里从 logits 到 token 的选择过程完整走了一遍:

  1. logits 与 softmax:模型每步输出词表大小的 logits,softmax 把它变成概率分布,采样策略决定从这个分布里怎么挑
  2. 贪心解码:直接 argmax,稳定可复现,但容易陷入重复退化,适合有标准答案的任务
  3. 温度:logits 除以 T 再 softmax,T 小于 1 分布变尖锐,T 大于 1 变平缓,T 趋近 0 等价贪心
  4. Top-k 与 Top-p:前者固定候选数量,后者按累积概率 p 取最小候选集,数量随分布形状自适应,是今天的主流做法
  5. 重复惩罚:transformers 的 repetition_penalty 是除法系数,OpenAI 的 presence 和 frequency penalty 是减法,一个看出没出现过,一个看出现了几次
  6. 可复现性:temperature=0 加 seed 不保证跨硬件完全一致,浮点层面的不确定性是无法回避的

到这里,整个大模型推理的地图就只剩最后一站了。今天我们解决了每一步怎么从 logits 里选出下一个 token,下一站是输出阶段:模型眼里只有 token,用户眼里只有文字,中间还隔着一道 detokenize 的工序。选出的 token 怎么变回用户看到的文字、流式地送到屏幕上,我们下一篇见。

参考


学习大模型推理的两个阶段:Prefill 与 Decode

在上一篇中,我们学习了 KV Cache:推理时把历史 token 的 Key 和 Value 缓存下来,每一步生成都不用重算整段上下文,正是它让逐 token 的自回归生成在工程上变得可行。当时我们留了一个视角没有展开:这份缓存不是一次性建好的,也不是一次性用完的。它先被整段 prompt 一次性填满,然后在生成过程中被逐 token 消耗、逐 token 追加。

这个先填充、后消耗的节奏,恰好对应第一篇提到的两个阶段:Prefill(预填充) 和 Decode(解码)。可以说,推理领域绝大多数的性能讨论,最后都会落到这两个阶段的差异上。今天我们就来学习这两个阶段,顺便认识 TTFT、TPOT 这几个衡量推理性能的核心指标。

一次推理的两个阶段

第一篇概览里我们已经见过这两个阶段,这里快速回顾一下。一次请求从进来到出完,走的是下面这条路:

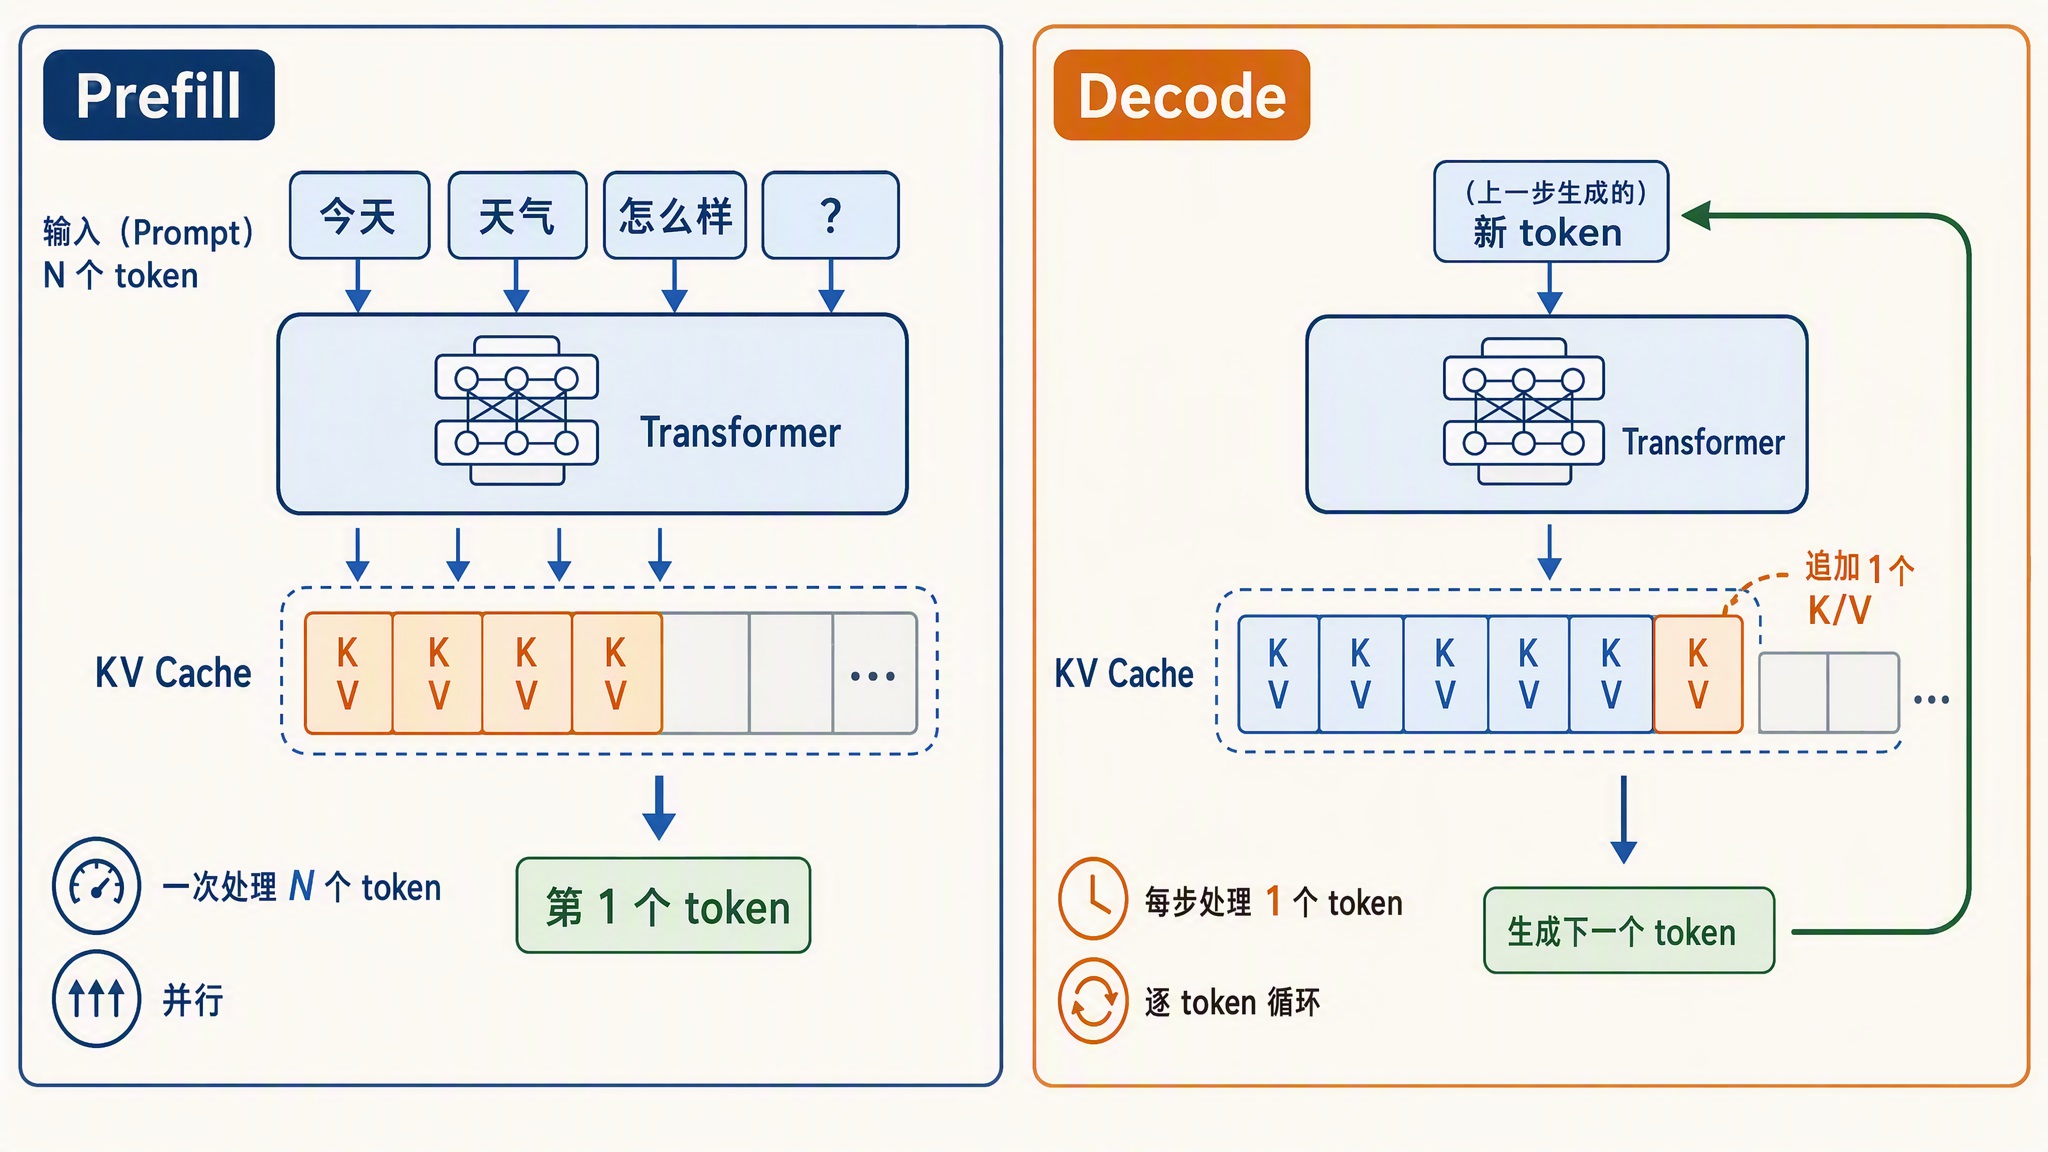
  1. Prefill 阶段:把 prompt 的所有 token 一次性并行送进模型,跑一遍完整的前向计算。这一步会把 KV Cache 填满,同时产出第一个输出 token
  2. Decode 阶段:进入循环。每一步只把上一步新生成的那个 token 送进模型,结合已有的 KV Cache 算出下一个 token,再把它的 KV 追加进缓存。循环一直持续到模型产出结束符,或者达到设定的长度上限

用时序图把整个过程画出来:

prefill-decode-timeline.png

可以看到,两个阶段的分工很清楚:prefill 一次处理 N 个 token,decode 每步只处理 1 个 token。这个数量差异看起来只是形式上的不同,实际上决定了它们在硬件上的瓶颈完全不同。下面这张图把两个阶段的工作模式画得更直观一些:

prefill-decode-phases.jpg

Prefill:计算密集

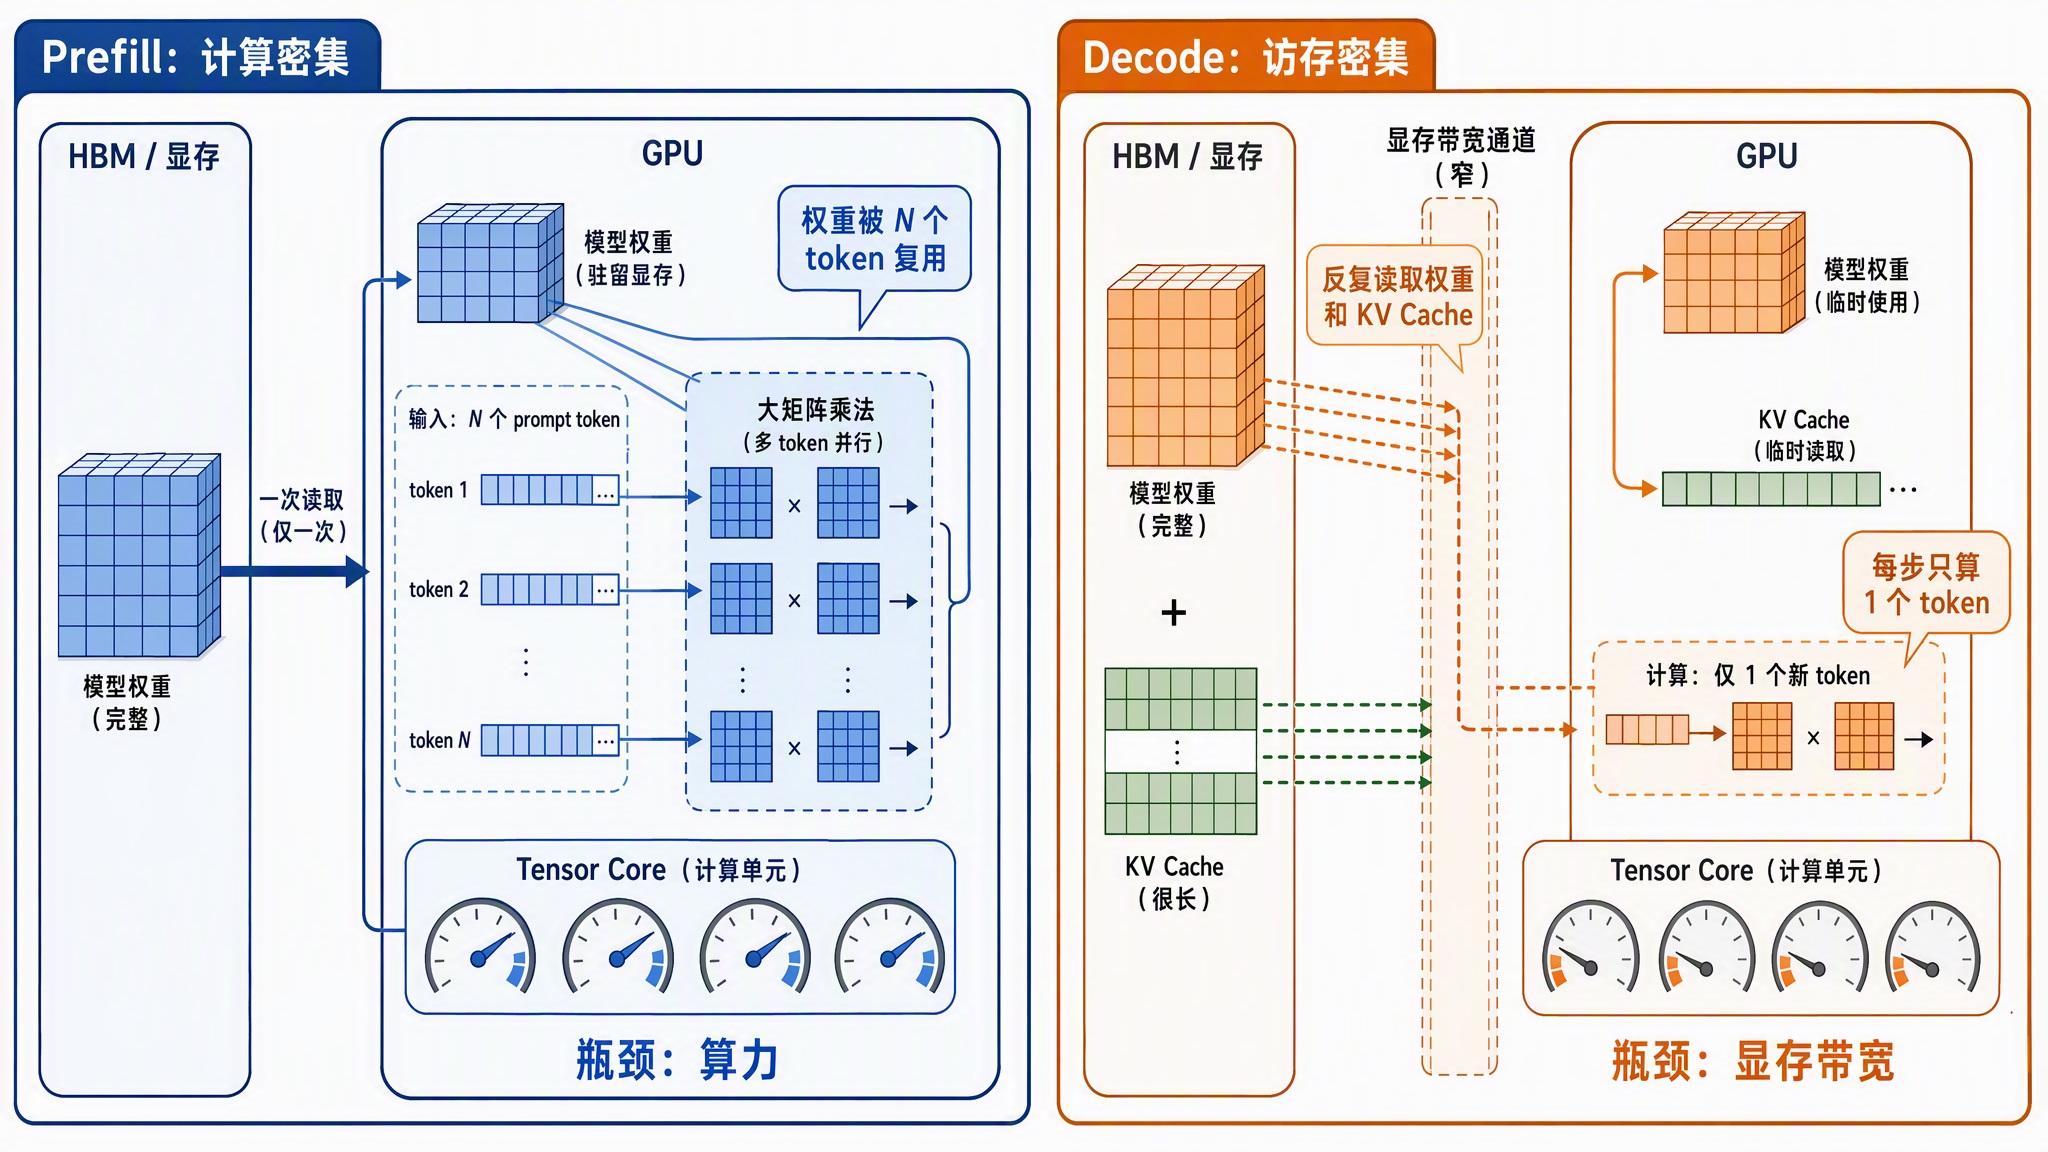
先看 prefill。prompt 里的所有 token 是同时过模型的,注意力计算覆盖整个序列,矩阵乘法的形状是 N × d 乘 d × d 这种大块头。N 是 prompt 的 token 数,d 是每个 token 向量的维度,N 越大,每个计算单元分到的活越多,GPU 的 Tensor Core 基本处于打满状态。

Tensor Core(张量核心)是 NVIDIA GPU 里专门做矩阵乘法的硬件单元,2017 年随 Volta 架构首次引入。普通的 CUDA 核心一次只能算一个乘加,Tensor Core 一条指令就能完成一小块矩阵的乘加运算(D = A × B + C),吞吐高出一个数量级。它还原生支持 FP16、BF16、FP8 这些低精度格式,大模型的训练和推理能跑得快,靠的就是它。

这种负载叫计算密集型(compute-bound):瓶颈在算力,不在数据搬运。显存里的权重读一次,能被 N 个 token 的计算反复复用,数据搬运的成本被摊薄了。所以对 prefill 来说,GPU 的峰值算力(FLOPS)是决定性因素,prompt 越长,prefill 的耗时越长。而且注意力计算随序列长度近似平方增长,所以长上下文场景里 prefill 的开销涨得比我们想象的更快。

另外 prefill 是 KV Cache 的写入方。prompt 每个位置算出来的 Key 和 Value 都会存进缓存,供后面 decode 阶段反复读取。

Decode:访存密集

再看 decode,情况完全反过来。

每一步只处理 1 个新 token,但模型前向计算所需的权重一个都不能少。也就是说,每生成一个 token,都要把整套模型权重和截止到目前的全部 KV Cache 从显存里读一遍,而真正做的计算只有一个 token 的量。读进来几十上百 GB 的数据,只为一丁点计算服务。

这种负载叫访存密集型(memory-bound):瓶颈在显存带宽,也就是数据搬运的速度,不在算力。计算单元大部分时间在等数据,大量闲置。这也解释了一个常见现象:单请求跑 decode 时去看 GPU 利用率,数字往往很低。这不是 GPU 没干活,而是它的大部分时间花在等显存送数据上。

compute-bound-vs-memory-bound.jpg

算术强度与 Roofline 模型

两个阶段的差异可以用一个指标统一描述:算术强度(Arithmetic Intensity),即每读一个字节的数据能做多少次浮点运算。

  • Prefill 的算术强度高:权重读一次,被几百上千个 token 复用,FLOPs 与字节数的比值很大,落在算力瓶颈区
  • Decode 的算术强度低:每步只为 1 个 token 计算,却要读全部权重和 KV Cache,FLOPs 与字节数的比值很小,落在带宽瓶颈区

这套分析方法来自屋顶线模型(Roofline Model),是 Williams、Waterman 和 Patterson 在 2009 年提出的性能分析框架。它的核心思想是:一个程序的实际性能,取峰值算力和带宽乘以算术强度两者中的较小者,算术强度决定了程序落在哪个瓶颈区。公式的细节我们这里不展开,感兴趣的话可以读这篇用 Roofline 模型逐层分析 LLM 推理的综述:

用一张简化的 Roofline 图表示两个阶段所处的瓶颈区域:

prefill-decode-roofline.png

针对两个阶段的优化方案

知道了两个阶段的瓶颈在哪,优化的方向就清楚了,大体可以归成两类。

Prefill 是计算密集型,优化围绕省算力展开:前缀缓存让多个请求共享的 prompt 前缀只算一次,不用每个请求都重复 prefill;分块预填充把超长 prompt 切成小块分批算,避免一个长请求把其他人堵住。

Decode 是访存密集型,优化围绕省搬运展开:量化把每个权重和缓存元素占的字节数压小;投机解码让一次前向多产出几个 token;多卡张量并行把权重切开分到多张卡上,各读各的;批处理把多个请求拼在一起跑,同一份权重读一遍,服务多个请求。

这些手段后面有机会单独开篇细讲,这里用 Roofline 的分析方法重点看一下批处理。

回到 Roofline 的式子:性能取峰值算力和「带宽 × 算术强度」的较小者。prefill 在算力瓶颈区,拼批处理收益有限。而 decode 卡在带宽这一项上,要提速就得把算术强度推高,批处理的做法正是如此:N 条请求拼在一步里过模型,计算量涨 N 倍,权重却只读一遍,FLOPs 与字节数的比值就高了 N 倍。只要批处理还没大到把 decode 推过 Roofline 的拐点,吞吐量就随批处理大小近似线性增长,而每步的耗时几乎不变。

因此 decode 阶段单跑一条请求是在浪费带宽,把几十上百条请求一起跑,显存带宽的利用率才算真正提上来。

decode-batching.jpg

核心性能指标

有了两个阶段的划分,推理系统的核心指标就很好理解了。我们逐个定义。

TTFT(Time To First Token,首 token 延迟):从请求发出到收到第一个输出 token 的时间。它由排队时间和 prefill 耗时共同决定,prompt 越长,prefill 越慢,TTFT 越大。

TPOT(Time Per Output Token,每个输出 token 的平均耗时):decode 阶段生成相邻两个 token 的平均间隔。它由 decode 的每步耗时决定,反映的是生成过程的快慢。还有一个等价指标 ITL(Inter-Token Latency,相邻 token 间隔),不同基准工具对它的统计口径略有差别,有的把第一个 token 算进去,有的不算,所以跨工具对比数字时要看清定义。NVIDIA 的 NIM 基准文档里给了一个常见口径:ITL 等于端到端延迟减去 TTFT,再除以输出 token 数减一,这样就把 prefill 的影响剔掉了。

端到端延迟(End-to-End Latency,E2E 延迟):从请求发出到拿到完整回复的总时间。它近似等于 TTFT 加上 TPOT 乘以输出 token 数,是前两者叠加的结果。

吞吐量(Throughput):系统单位时间产出的 token 总数,通常写作 tokens/s。和延迟是同一个硬币的两面:单请求时延迟低不代表并发时吞吐高,连续批处理这类调度手段就是为了在延迟可接受的前提下把吞吐拉上去。

这四个指标里,TTFT 和 TPOT 是最重要的两个,因为它们分别挂在两个阶段上,定位性能问题时能直接看出瓶颈在哪个阶段。

inference-metrics-timeline.png

实战 TTFT 和 TPOT

下面我们通过一个简单的示例来体验下这两个指标,用 Hugging Face Transformers 加载 Qwen3-0.6B 这个小模型,配合 TextIteratorStreamer 做流式生成,记录每个 token 到达的时间:

import time
from threading import Thread
from transformers import AutoModelForCausalLM, AutoTokenizer, TextIteratorStreamer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)

prompt = "用三句话解释什么是 KV Cache"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# 流式输出器:每生成一段文本就吐出来一段,而不是等全部生成完
streamer = TextIteratorStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

start = time.perf_counter()
thread = Thread(
    target=model.generate,
    kwargs={**inputs, "streamer": streamer, "max_new_tokens": 128},
)
thread.start()

ttft = None
arrival_times = []
for chunk in streamer:
    now = time.perf_counter()
    if ttft is None:
        ttft = now - start  # 第一段文本到达,就是 TTFT
    arrival_times.append(now)
thread.join()

tpot = (arrival_times[-1] - arrival_times[0]) / max(len(arrival_times) - 1, 1)
print(f"TTFT: {ttft * 1000:.1f} ms")
print(f"TPOT: {tpot * 1000:.1f} ms")
print(f"总耗时: {(arrival_times[-1] - start) * 1000:.1f} ms")

我的这台 Mac 上跑出来的结果如下:

TTFT: 2112.7 ms
TPOT: 42.4 ms
总耗时: 7543.8 ms

这里有几个点可以展开介绍一下:

  1. generate() 是阻塞调用,所以要放到单独的线程里跑,主线程从 streamer 里逐段取结果
  2. TextIteratorStreamer 吐出的是解码后的文本片段,不严格等于单个 token。如果要精确到 token 级,可以继承 BaseStreamer 重写 put() 方法,一般来说没这个必要
  3. 第一次调用包含模型加载后的预热开销,正式测量前建议先跑一次热身

从最终的输出结果可以看到,第一个数字明显大于后面的平均值,这正是两个阶段的直接体现:TTFT 里装着整个 prefill,自然比 decode 单步慢。具体的毫秒数和机器强相关,在不同设备上差异很大,但 TTFT 大于 TPOT 这个关系是稳定的。

流式输出

理解了这两个指标,流式输出的动机就很清楚了。

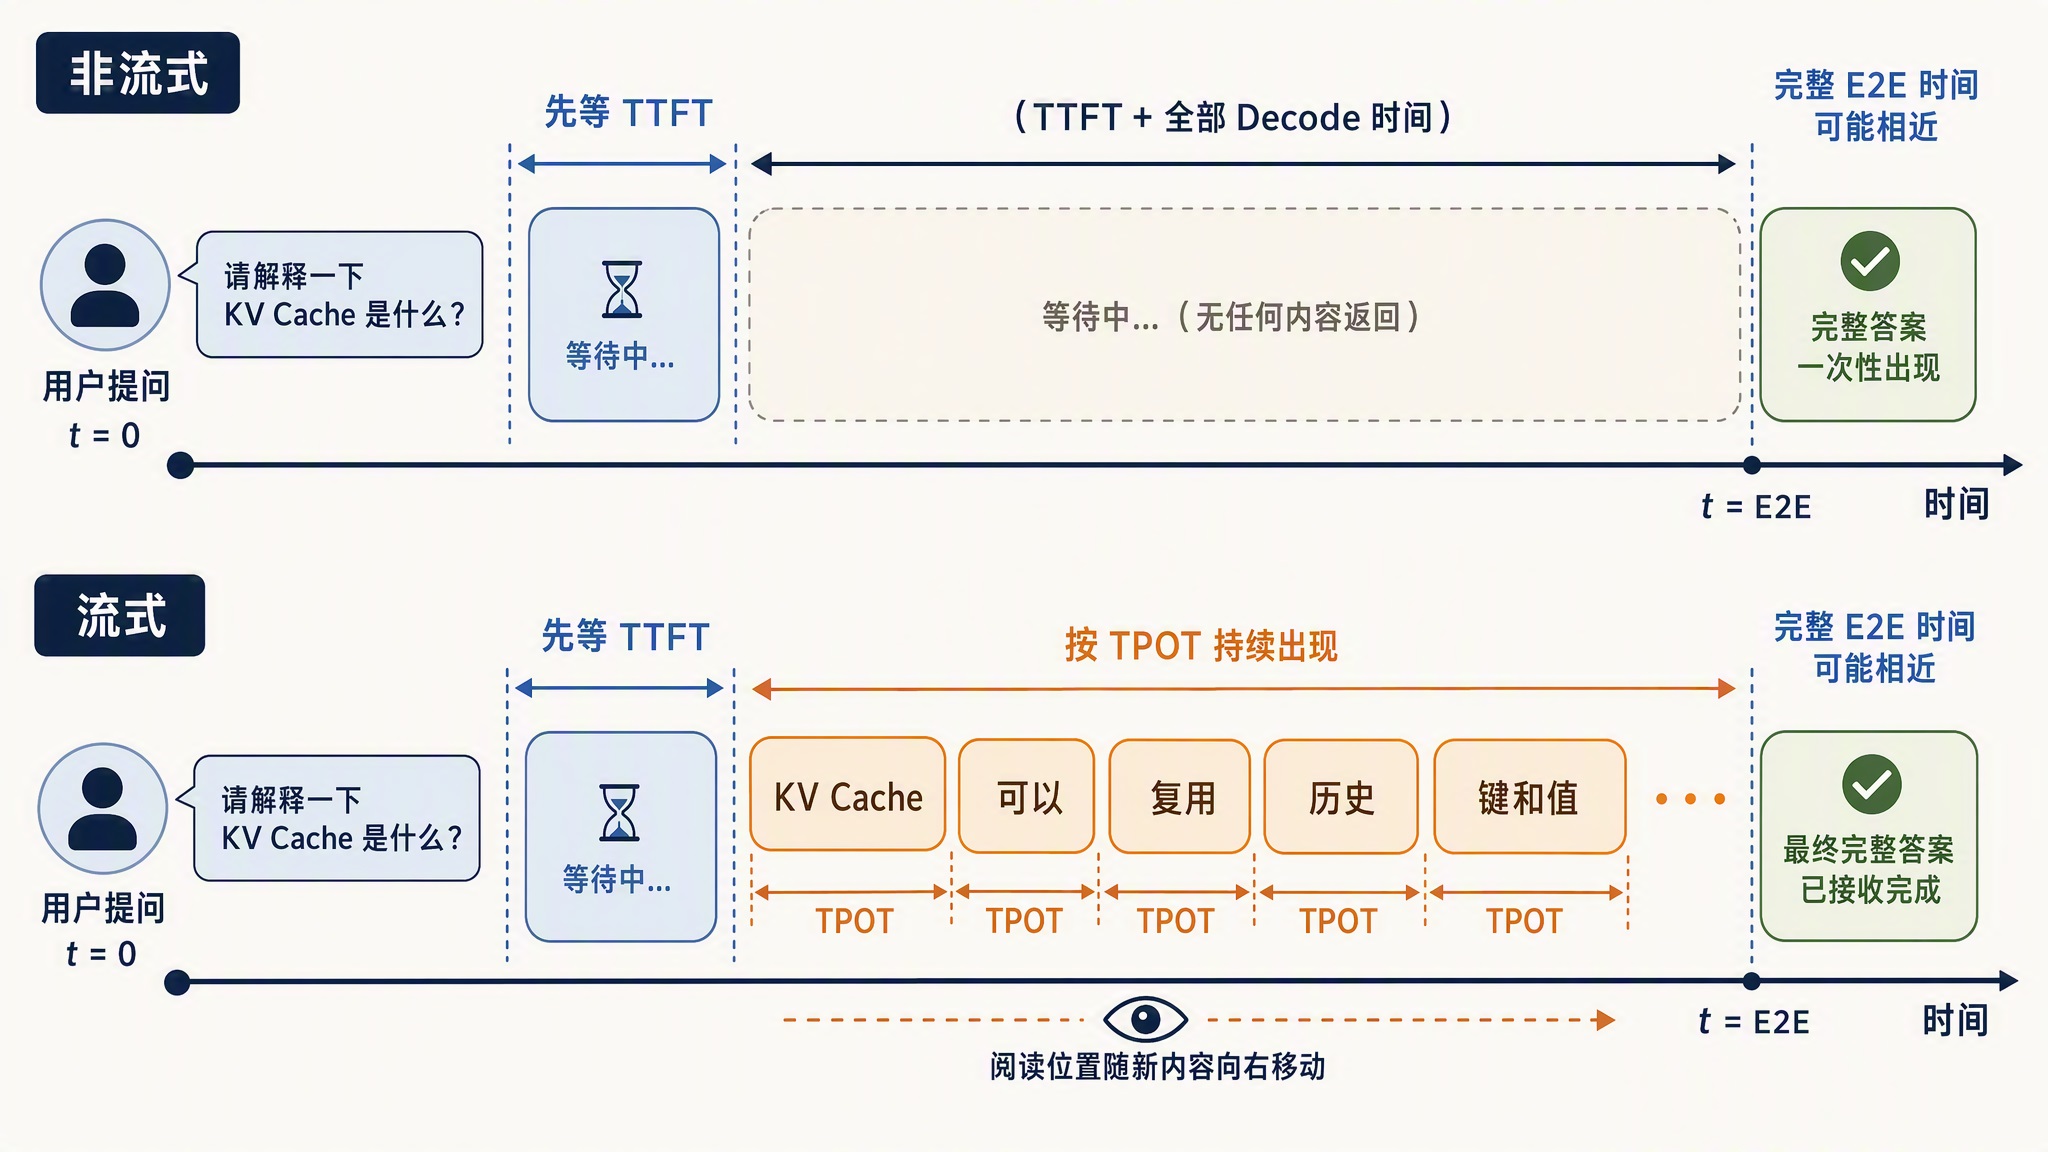
如果不用流式,用户要等完整的 E2E 延迟才能看到任何内容。回复越长,白屏时间越久。用了流式输出(Streaming),用户只需要熬过一个 TTFT 就能看到第一个字,之后内容以 TPOT 的节奏逐个出现。只要生成的速度比人阅读的速度快,体感就是流畅的,哪怕整段回复实际要生成很久。

streaming-perceived-latency.jpg

所以面向聊天的产品,优化的第一优先级通常是 TTFT。它决定了用户觉得模型快不快。而长文生成场景下,TPOT 决定了阅读是否跟得上:如果 TPOT 太慢,用户读完上一句还得干等下一句,阅读节奏照样被打断。

不同负载的两阶段配比

最后看一个工程上更现实的问题:不同业务里,prefill 和 decode 的比例差得很远。

负载类型输入输出两阶段特征优化重点
文档摘要长短长 prefill,短 decode压低 TTFT
创意写作短长短 prefill,长 decode压低 TPOT
RAG 问答超长中等超长 prefill,KV Cache 占用大前缀缓存、TTFT
多轮对话逐轮变长中等prefill 随轮数增长前缀缓存

workload-ratios-and-scheduling.jpg

既然两个阶段吃完全不同的硬件资源,把它们硬塞在同一张卡上就会互相干扰:一个长 prefill 插进来,正在 decode 的请求 TPOT 就会被顶高,输出节奏突然卡一下。工程上有两类解法。一类是把 prefill 切成小块和 decode 穿插着跑,Sarathi-Serve 的分块预填充(chunked prefill) 走的就是这条路;另一类更彻底,直接把两个阶段拆到不同的机器上,各配各的硬件,这就是 PD 分离(Prefill-Decode Disaggregation),OSDI 2024 上发表的 DistServe 是这条路线的代表作,近两年各家推理框架都在往这个方向走。这块内容我们后面单开一篇细讲,今天就先学到这里。

小结

今天我们学习了一次推理的两个阶段:

  1. 两个阶段:prefill 把 prompt 的所有 token 并行过一遍模型,填满 KV Cache 并产出第一个 token;decode 每步只处理 1 个新 token,循环生成直到结束
  2. 两种瓶颈:prefill 是计算密集型,吃 GPU 算力;decode 是访存密集型,每步都要把全部权重和 KV Cache 读一遍,算力大量闲置,这也是 decode 阶段 GPU 利用率低的原因
  3. 一个统一视角:算术强度。prefill 算术强度高,落在 Roofline 的算力瓶颈区;decode 算术强度低,落在带宽瓶颈区
  4. 优化方案:prefill 省算力,靠前缀缓存、分块预填充;decode 省搬运,靠量化、投机解码、张量并行和批处理。其中批处理对 decode 收益最大,N 条请求拼在一步里,权重只读一遍,算术强度翻 N 倍,这是推理服务追求高并发连续批处理的原因
  5. 四个指标:TTFT 由 prefill 决定,TPOT 和 ITL 由 decode 决定,E2E 延迟是两者叠加,吞吐量衡量系统整体产能
  6. 负载差异:摘要、创意写作、RAG 的两阶段配比各不相同,优化方向也不同,PD 分离正是基于这个差异的架构设计

到这里,第一篇绘制的地图已经走过大半:分词把文本变成 token,嵌入和位置编码给向量注入语义和位置信息,前向传播把它们一层层加工成 logits,KV Cache 让逐 token 生成免于重算,今天又把一次推理拆成了 prefill 和 decode 两个阶段。这条链路的下一站,是 logits 出来之后怎么选出下一个 token:可以贪心选分数最高的,也可以按概率随机抽,还可以用 temperature、top-p 这些旋钮调整随机的程度。这就是采样策略要解决的问题,我们明天继续。

参考


学习大模型推理的 KV Cache

在上一篇中,我们把一次前向传播完整走了一遍:token 先查表变成向量,然后逐层经过 Transformer Block,每层里用 Q、K、V 三个向量做自注意力,最后从词表分布里挑出下一个 token。我们也知道了生成是自回归(Autoregressive)的,也就是一个 token 一个 token 地依次生成,每生成一个新 token 都要跑一次前向。

上一篇的结尾我们留了一个问题:生成第 t 个 token 时,注意力需要用到前 t-1 个 token 的 K 和 V,而这些 K、V 在前面的步骤里其实已经算过了,值也不会变。如果每一步都把整段序列重新跑一遍前向,这些历史 K、V 就被白白重算了无数遍。今天我们就来解决这个问题,主角是大模型推理里最重要的一项优化:KV Cache(键值缓存),也就是把每层每个 token 的 K、V 向量缓存起来,避免重复计算。

从重复计算说起

我们再回忆一下注意力计算的过程:每个 token 的向量经过三个投影矩阵,得到 Query、Key、Value 三个向量。位置 i 的 token 要和它前面的所有位置做注意力,方式是用自己的 Query 去和每个位置的 Key 算相似度,再对 Value 加权求和。

关键在于,有了上一篇讲的因果掩码,位置 i 的表示只由它自己和它前面的 token 决定,后面生成什么内容都影响不到它。所以一个 token 的 K、V 一旦算出来,就是永远不变的常量。

假设 prompt 有 10 个 token,要生成 100 个新 token,每一步的做法是把目前已经有的全部 token 重新送进模型:

  • 第 1 步:输入 10 个 token,算出第 11 个
  • 第 2 步:输入 11 个 token,算出第 12 个
  • 第 3 步:输入 12 个 token,算出第 13 个
  • ……

第 2 步重算了前 10 个 token 的 K、V,第 3 步又重算了前 11 个。越到后面,每一步重算的量越大。生成 n 个 token,总的计算量大体是 1 + 2 + … + n 的累加,也就是 O(n²) 的复杂度。序列一长,这些重复计算就成了推理速度的主要瓶颈。

KV Cache 工作原理

既然历史 token 的 K、V 是不变的,办法就很直接了:算过一次就存下来,后面每一步直接用。

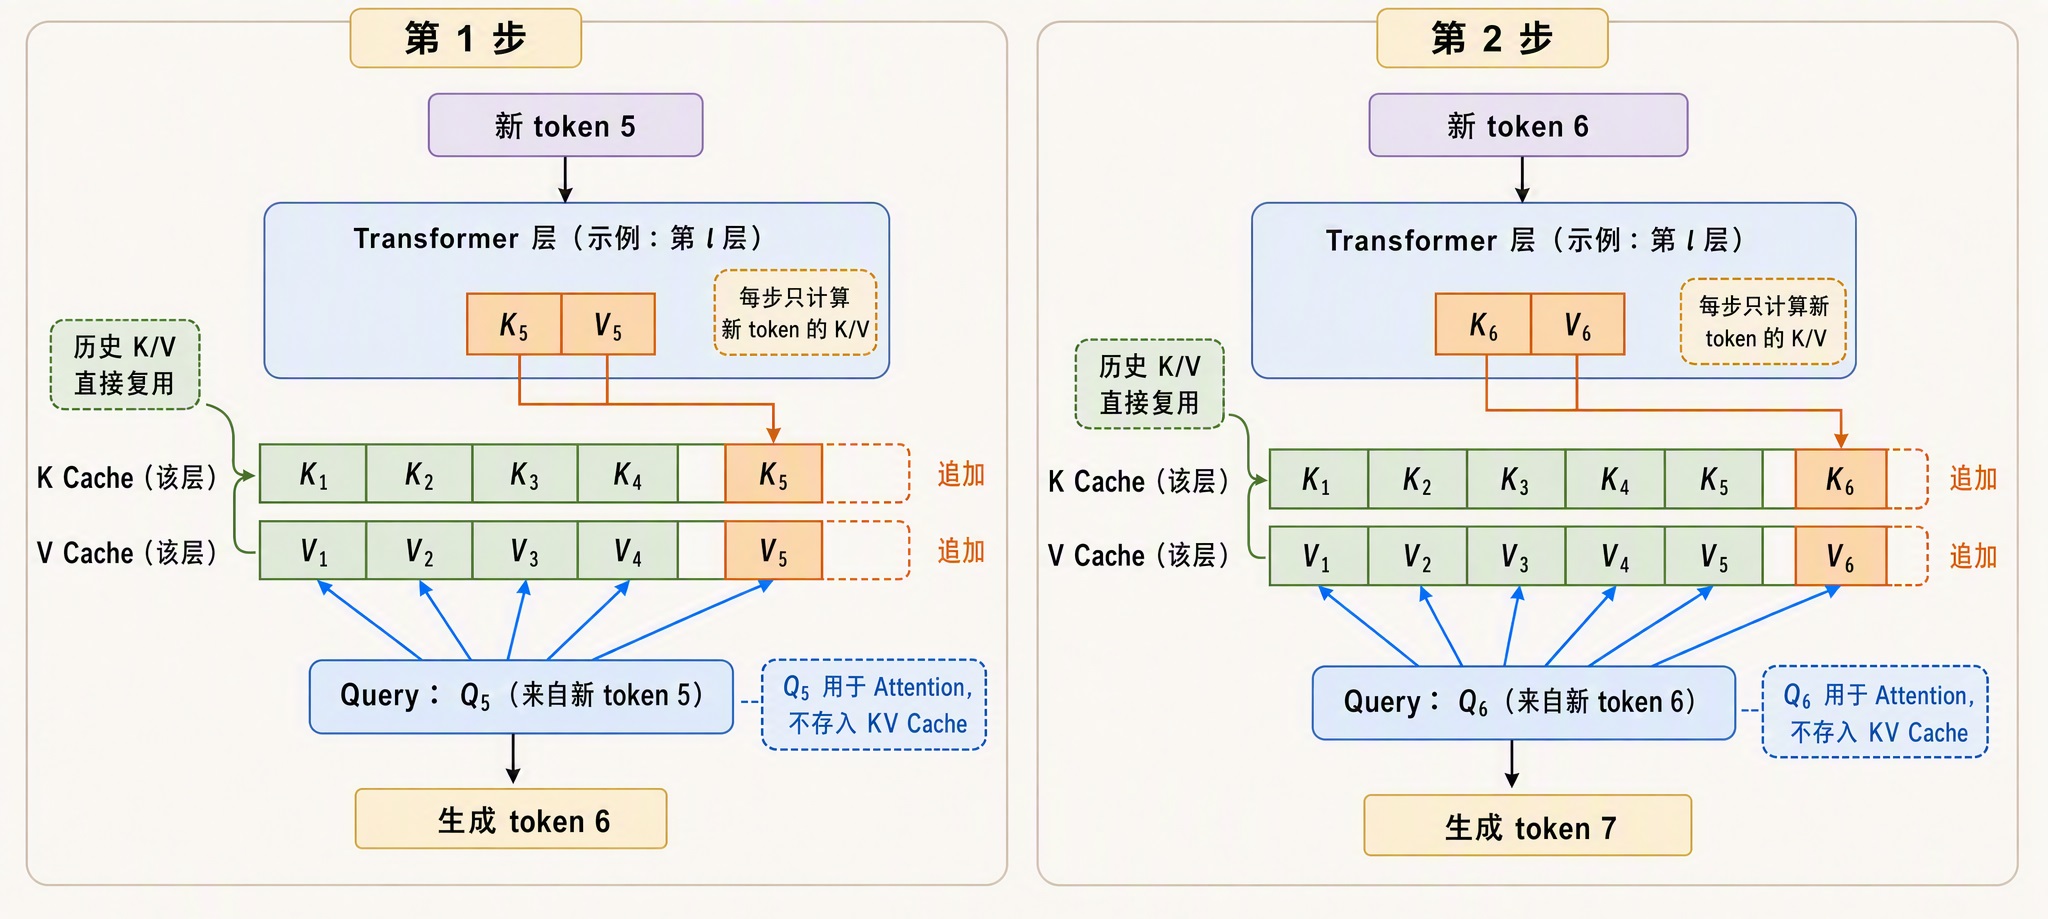
具体来说,每跑一步前向时,把每一层算出的 K、V 向量按 token 顺序追加到一块缓存里。下一步只需要把新生成的这一个 token 送进模型:它经过每一层时,算出自己新的 K、V 追加进缓存,再用自己的 Q 去和缓存里已有的全部 K、V 做注意力。历史 token 的 K、V 一次都不用重算。

逐 token 生成的循环里,缓存的追加过程如下图所示:

kv-cache-append-loop.jpg

有了这个缓存,每一步前向只处理 1 个新 token,生成 n 个 token 的总计算量从 O(n²) 降到了 O(n)。序列越长,省得越多,这也是长文本生成能跑得动的前提。

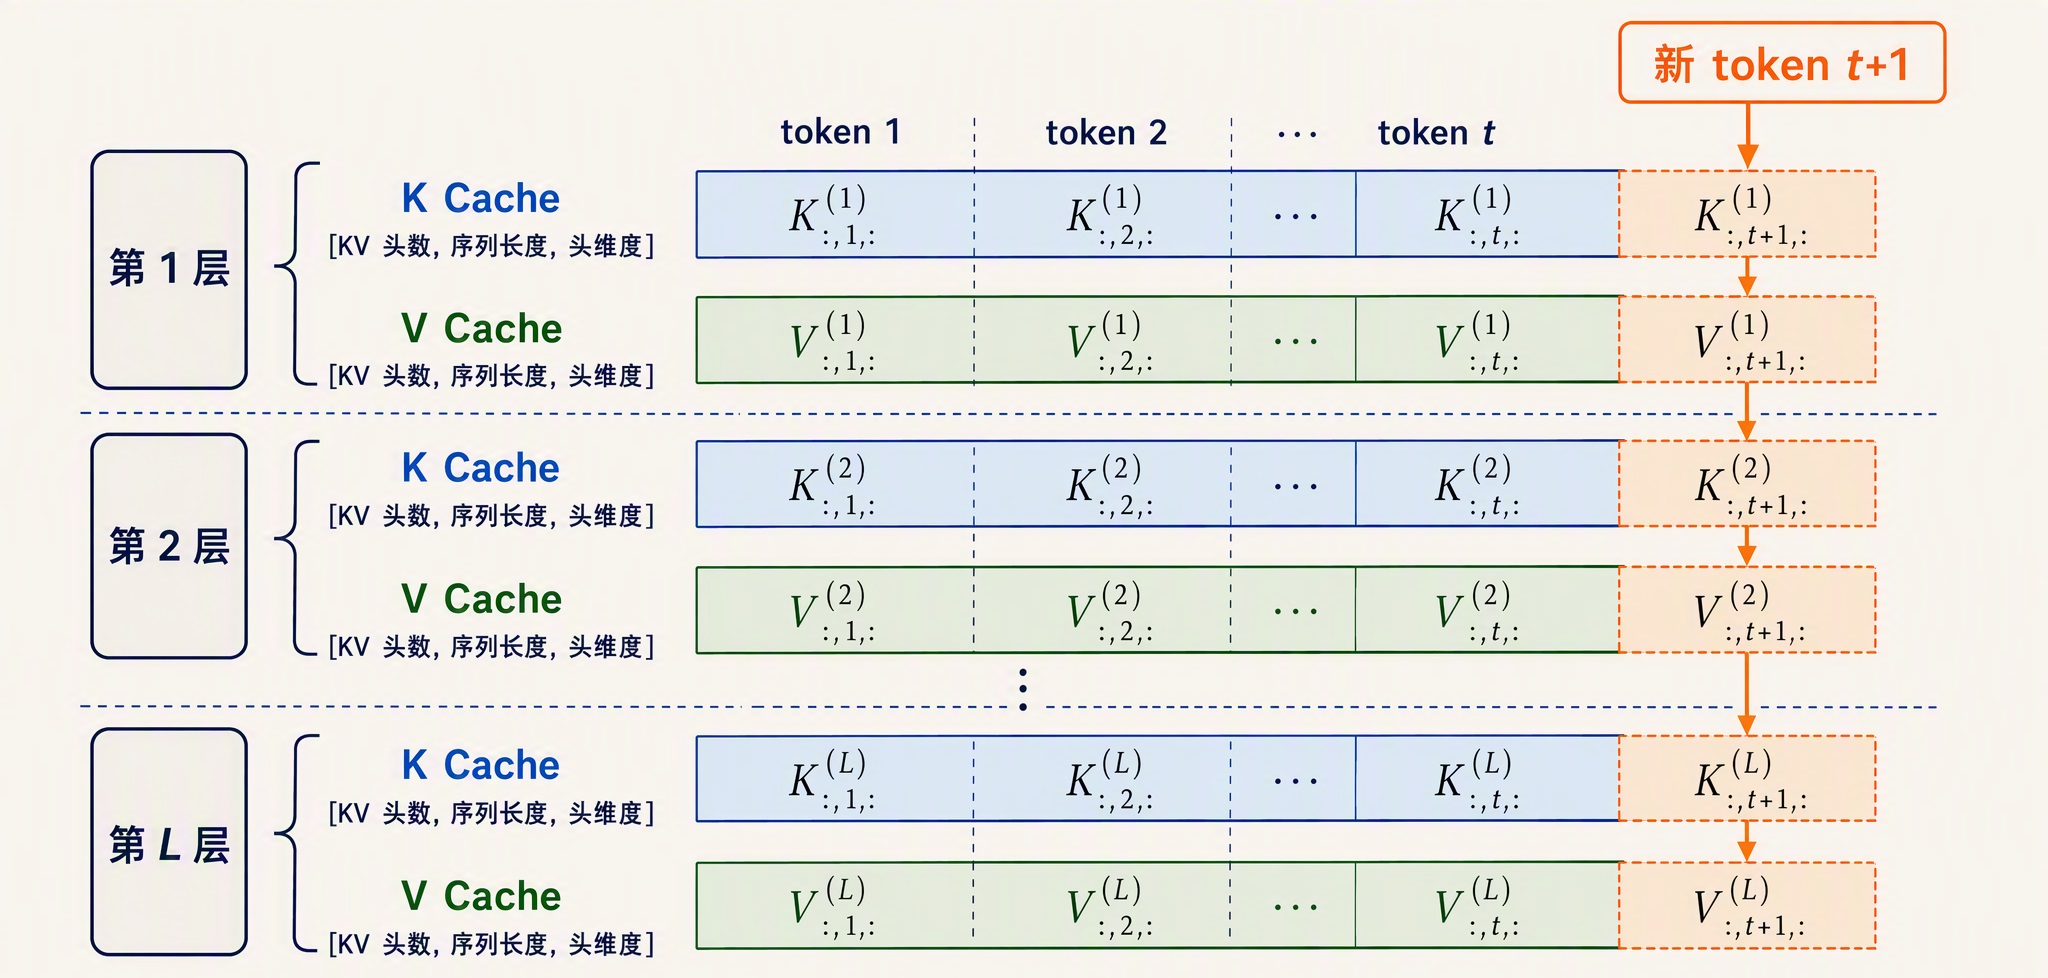
注意缓存是每一层各有一份的。模型有 L 层,就有 L 份 K 缓存和 L 份 V 缓存,每层缓存里按序列顺序存着所有历史 token 在该层的 K、V 向量。

缓存的整体结构如下图所示,每一层都维护着一份随序列增长的 K、V 矩阵:

kv-cache-layer-structure.jpg

可以把这个机制想象成一本笔记本:模型每读一个 token,就在每一层对应的页上记下它的 K、V,后面再提到它时直接翻笔记,不用重新理解一遍。

缓存与不缓存的对比如下:

对比项不用 KV Cache用 KV Cache
每步前向输入全部历史 token仅 1 个新 token
历史 K/V每步重算从缓存直接读
生成 n 个 token 的总计算量O(n²)O(n)
额外显存开销无随序列长度线性增长

可以看到,天下没有免费的午餐,计算量省下来了,代价是多了一块不断增长的显存占用。这是典型的以空间换时间。

KV Cache 显存占用

KV Cache 的大小可以精确推导。每个 token 在每一层要存一个 K 向量和一个 V 向量,每个向量的大小是 KV 头数乘上头维度。把各部分乘起来,一个请求的 KV Cache 占用为:

KV Cache 字节数 = 2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数

我们逐项解释下:

  • 2:K 和 V 各存一份
  • 层数:每层都有独立的缓存
  • KV 头数 × 头维度:一个 K 或 V 向量的元素个数,比如 32 个头、每头 128 维,就是 4096 个元素
  • 序列长度:prompt 长度加上已生成的 token 数,缓存随它线性增长
  • 每元素字节数:由存储精度决定,FP16(16 位浮点)是 2 字节,FP8 是 1 字节

拿一个 7B 模型为例,32 层、32 个 KV 头、128 头维度、FP16 精度,跑 4096 的上下文,显存占用为:

2 × 32 × 32 × 128 × 4096 × 2 字节 = 2147483648 字节 = 2 GiB

kv-cache-memory-formula.png

一个请求,光 KV Cache 就要 2 GiB。这个数是什么概念?7B 模型 FP16 的权重本身大约是 13 GiB,也就是说一条 4k 序列的缓存相当于模型权重的七分之一。

缓存随序列长度线性增长,把几个常见上下文长度都代入公式,同一个模型的显存占用是这样的:

上下文长度单请求 KV Cache相当于模型权重(约 13 GiB)
4k2 GiB约 1/7
8k4 GiB约 2/7
32k16 GiB超过权重本身
128k64 GiB近 5 倍权重

32k 上下文时缓存已经比模型权重还大,128k 时是权重的好几倍。

不仅如此,还有两个放大因素。一是这个公式是单个请求的账,服务端同时处理多少个并发请求,缓存总量就乘多少。二是序列长度在生成过程中一直涨,prompt 4k 不代表缓存停在 4k 对应的大小,生成的每个 token 都在往里追加。

下面这张图直观地画出了缓存随上下文长度的增长:

kv-cache-memory-growth.jpg

现在可以理解为什么长上下文的服务成本高了。上下文窗口从 4k 扩到 128k,模型本身没变,但每个请求的 KV Cache 膨胀了 32 倍。显存就那么多,缓存吃得越多,能同时容纳的并发请求就越少,服务的吞吐和成本都直接受影响。KV Cache 也因此成了推理时显存占用的大头。

给 KV Cache 瘦身

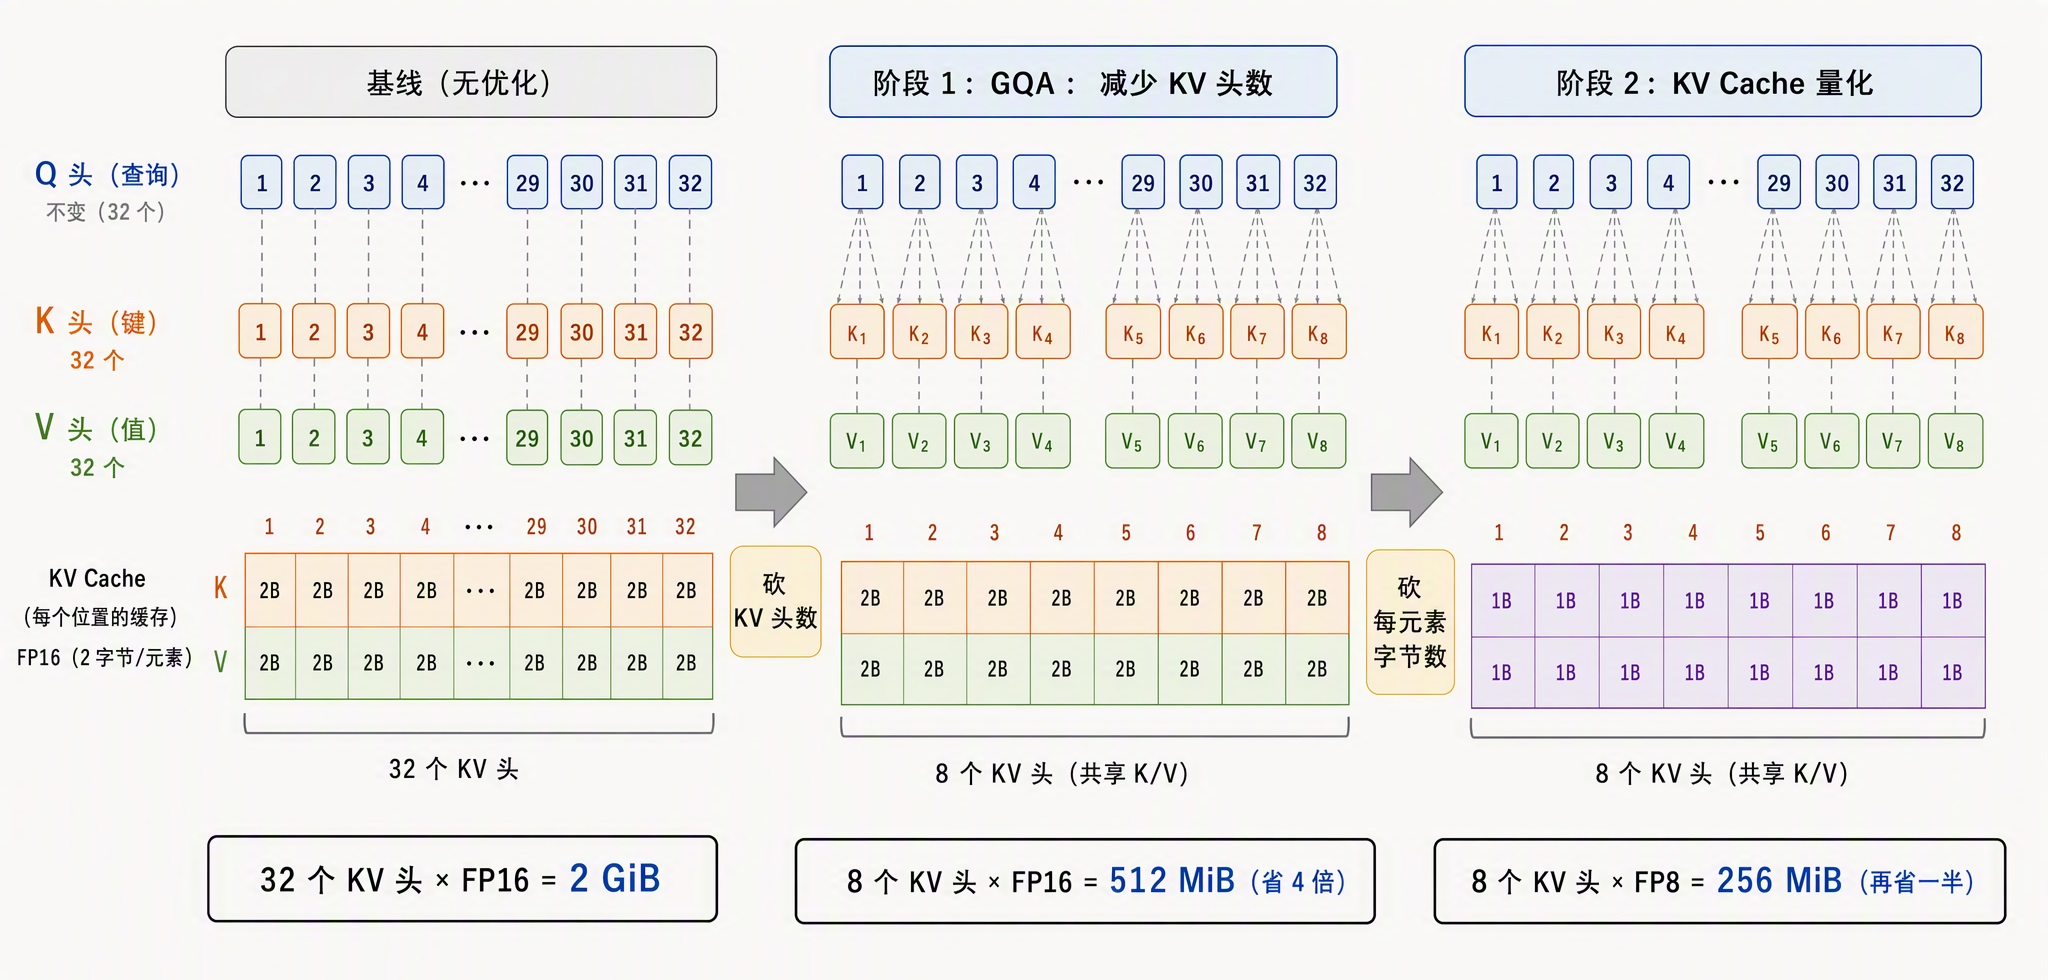
既然显存紧张,自然就有人想办法压缩 KV Cache。看公式的各个因子,有两条路最直接。

第一条是砍 KV 头数,这就是上一篇讲过的 GQA(Grouped-Query Attention,分组查询注意力)。标准的多头注意力里每个 Q 头配一个独立的 KV 头,GQA 让多个 Q 头共享一组 K、V,KV 头数就降下来了。还是上面那个 7B 模型,如果把 KV 头数从 32 砍到 8,其他不变,KV Cache 直接省 4 倍,4k 上下文从 2 GiB 降到 512 MiB。这也是现在主流开源模型(Llama 3、Qwen3、Gemma 等)几乎清一色用 GQA 的原因,它用很小的效果损失换来缓存的大幅缩水。GQA 出自 Google 2023 年的 GQA 论文,感兴趣的同学可以翻一翻。

第二条是砍 每元素字节数,也就是给 KV Cache 做量化。权重可以量化,缓存同样可以:从 FP16 降到 FP8 或 INT8,每个元素从 2 字节变 1 字节,缓存再省一半。两条路叠加,32 头变 8 头再乘上 FP8,缓存能压到原来的八分之一。transformers 的官方文档里就有量化缓存(Quantized Cache)的用法,vLLM 也支持 FP8 的 KV Cache。

kv-cache-compression.jpg

除了这两条路,还有滑动窗口(只保留最近的一段缓存)、跨层共享缓存等更激进的方案,核心思想都一样:缓存里的信息有冗余,不必全量精确保留。

实战 KV Cache

概念讲完,我们亲手跑一下,看看缓存长什么样。用 Hugging Face transformers 加载一个小模型 Qwen3-0.6B,它的配置是 28 层、8 个 KV 头、128 头维度,正好是个 GQA 模型。

transformers 的前向接口有个 use_cache 参数,打开后模型的输出里会带上 past_key_values,这就是 KV Cache。新版 transformers 把它封装成了 DynamicCache 对象,第 i 层的 K、V 分别通过 layers[i].keys 和 layers[i].values 访问。我们先对 prompt 做一次完整前向,再拿生成的新 token 做一次增量前向,对比两次缓存的形状:

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3-0.6B"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, dtype="auto")

prompt = "The quick brown fox"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# 第一次前向:处理完整 prompt
with torch.no_grad():
    out1 = model(**inputs, use_cache=True)
past1 = out1.past_key_values
print("缓存层数:", len(past1))
print("第 0 层 K 形状:", past1.layers[0].keys.shape)
print("第 0 层 V 形状:", past1.layers[0].values.shape)

# 第二次前向:只输入新 token,带上已有缓存
next_token = torch.argmax(out1.logits[0, -1, :]).reshape(1, 1)
with torch.no_grad():
    out2 = model(next_token, past_key_values=past1, use_cache=True)
past2 = out2.past_key_values
print("第二次前向后第 0 层 K 形状:", past2.layers[0].keys.shape)
print("第二次前向后第 0 层 V 形状:", past2.layers[0].values.shape)

运行结果如下:

缓存层数: 28
第 0 层 K 形状: torch.Size([1, 8, 4, 128])
第 0 层 V 形状: torch.Size([1, 8, 4, 128])
第二次前向后第 0 层 K 形状: torch.Size([1, 8, 5, 128])
第二次前向后第 0 层 V 形状: torch.Size([1, 8, 5, 128])

可以看到几个和理论完全对应的点:

  1. 缓存有 28 份:和模型的层数一致,每层独立存自己的 K、V
  2. 每层形状是 [batch, KV 头数, 序列长度, 头维度]:Qwen3-0.6B 是 8 个 KV 头、128 头维度,prompt 切成了 4 个 token,所以是 [1, 8, 4, 128]
  3. 第二次前向只输入了 1 个 token,但缓存从 4 涨到了 5:新 token 的 K、V 被追加到了历史缓存后面,注意力是在完整的 5 个 token 上算的

对照前面的显存公式,Qwen3-0.6B 每个 token 的缓存是 2 × 28 × 8 × 128 × 2 字节,约 112 KB,4k 上下文大约 448 MiB。

细心的读者会注意到,第一次前向和第二次前向有个明显的不对称:第一次一次性处理了 prompt 的全部 4 个 token,往缓存里写了 4 份 K、V;第二次只处理 1 个 token,缓存只涨了 1 格。这正是第一篇讲过的 Prefill 和 Decode 两个阶段:Prefill 一次性吃完整段 prompt、顺手填满缓存,Decode 每步只处理一个新 token、并往缓存里追加一格。

kv-cache-shape-prefill-decode.png

如果想更贴近底层地看这个机制,Sebastian Raschka 写过一篇 Understanding and Coding the KV Cache in LLMs,不用框架封装,从零手写了一个带 KV Cache 的生成循环,感兴趣的同学可以看看。

小结

今天我们学习了大模型推理中至关重要的 KV Cache 机制:

  1. 问题:自回归生成时,历史 token 的 K、V 是不变的常量,朴素做法每步重算整段序列,总计算量 O(n²)
  2. KV Cache 的思想:每层缓存所有历史 token 的 K、V,每步只为新 token 算一次并追加,总计算量降到 O(n),是典型的以空间换时间
  3. 显存占用:缓存大小 = 2 × 层数 × KV 头数 × 头维度 × 序列长度 × 每元素字节数。一个 7B 模型跑 4k 上下文,单请求约 2 GiB,32k 就是 16 GiB,长上下文和并发都会放大这块开销
  4. 瘦身手段:GQA 砍 KV 头数,量化砍每元素字节数,两者可以叠加
  5. 动手验证:transformers 里 use_cache=True 会返回 past_key_values,形状为 [batch, KV 头数, 序列长度, 头维度],随生成步数逐 token 增长

KV Cache 解决了计算重复的问题,但它自己成了显存大户。一个自然的问题是:既然每一步的缓存用量差别这么大,prefill 阶段一次性写入几千个 token 的 K、V,decode 阶段一步只写一个,这两个阶段的特征是不是应该分开对待?推理系统正是这么做的,这就是 Prefill 与 Decode 两个阶段的划分。我们明天继续。

参考


学习大模型推理的前向传播:Transformer 与注意力机制

在上一篇中,我们把一段文本切成了 token,查嵌入表把每个 token 变成向量,又讲了两种注入位置信息的做法:正弦编码直接加在嵌入向量上,RoPE 则作用在注意力计算里的 Q 和 K 上。到这里,一段文本已经变成一串带语义的向量,到达了模型的入口。

不过这串向量还只是原材料。接下来它要穿过几十层结构完全相同的 Transformer Block(Transformer 块),每过一层就被改写一次,最后被映射成词表大小的分数,模型才能从中挑出下一个 token。这个从输入向量一路算到输出分数的过程,就是 前向传播(Forward Pass)。它是整个推理过程的核心计算,今天我们就来学习这块知识。

前向传播全景

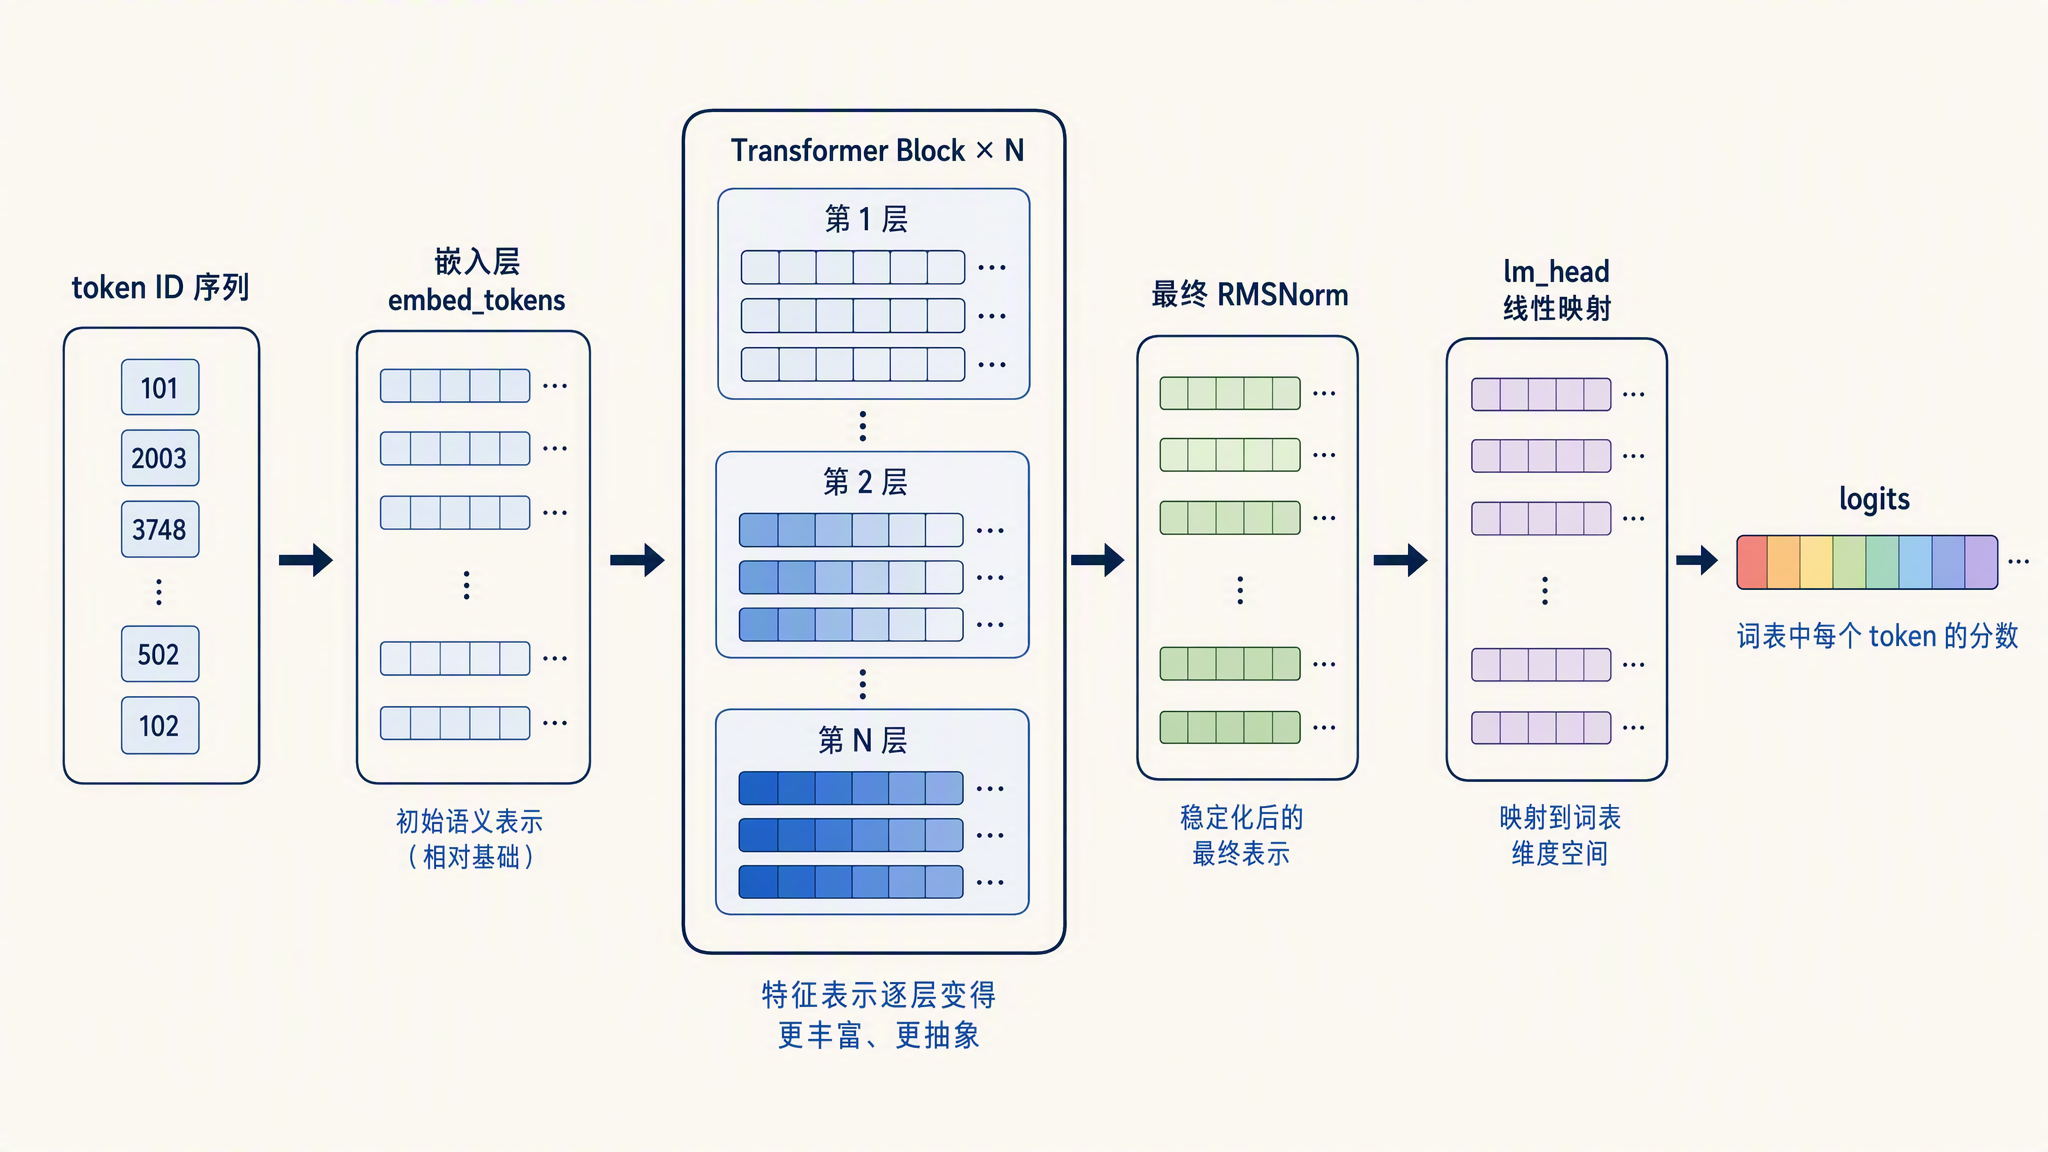
先看整体路线图:

forward-pass-overview.png

以 Qwen3-0.6B 为例走一遍这条链路:token id 先经过嵌入层,查表变成 1024 维的向量;然后向量依次穿过 28 层 Transformer Block,每一层的输入输出都是 1024 维,形状不变,内容却被改写一次;走出最后一层后先过一次 RMSNorm,最后由 lm_head 把 1024 维映射成 151936 个分数,词表里每个候选 token 各得一分。可以看到,向量只在首尾两头改变形状,中间的加工全部在 Block 里完成。

整条链路里,真正让模型变聪明的就是中间那 N 层 Block。Qwen3-0.6B 这样的小模型就有 28 层,更大的模型可以有 60 层、80 层甚至更多。每一层结构相同、参数不同,向量每过一层就被加工一次,表示越来越抽象。

今天的主要任务就是把一个 Block 拆开,看清里面的两个核心组件:注意力机制和前馈网络。

原始 Transformer 的结构

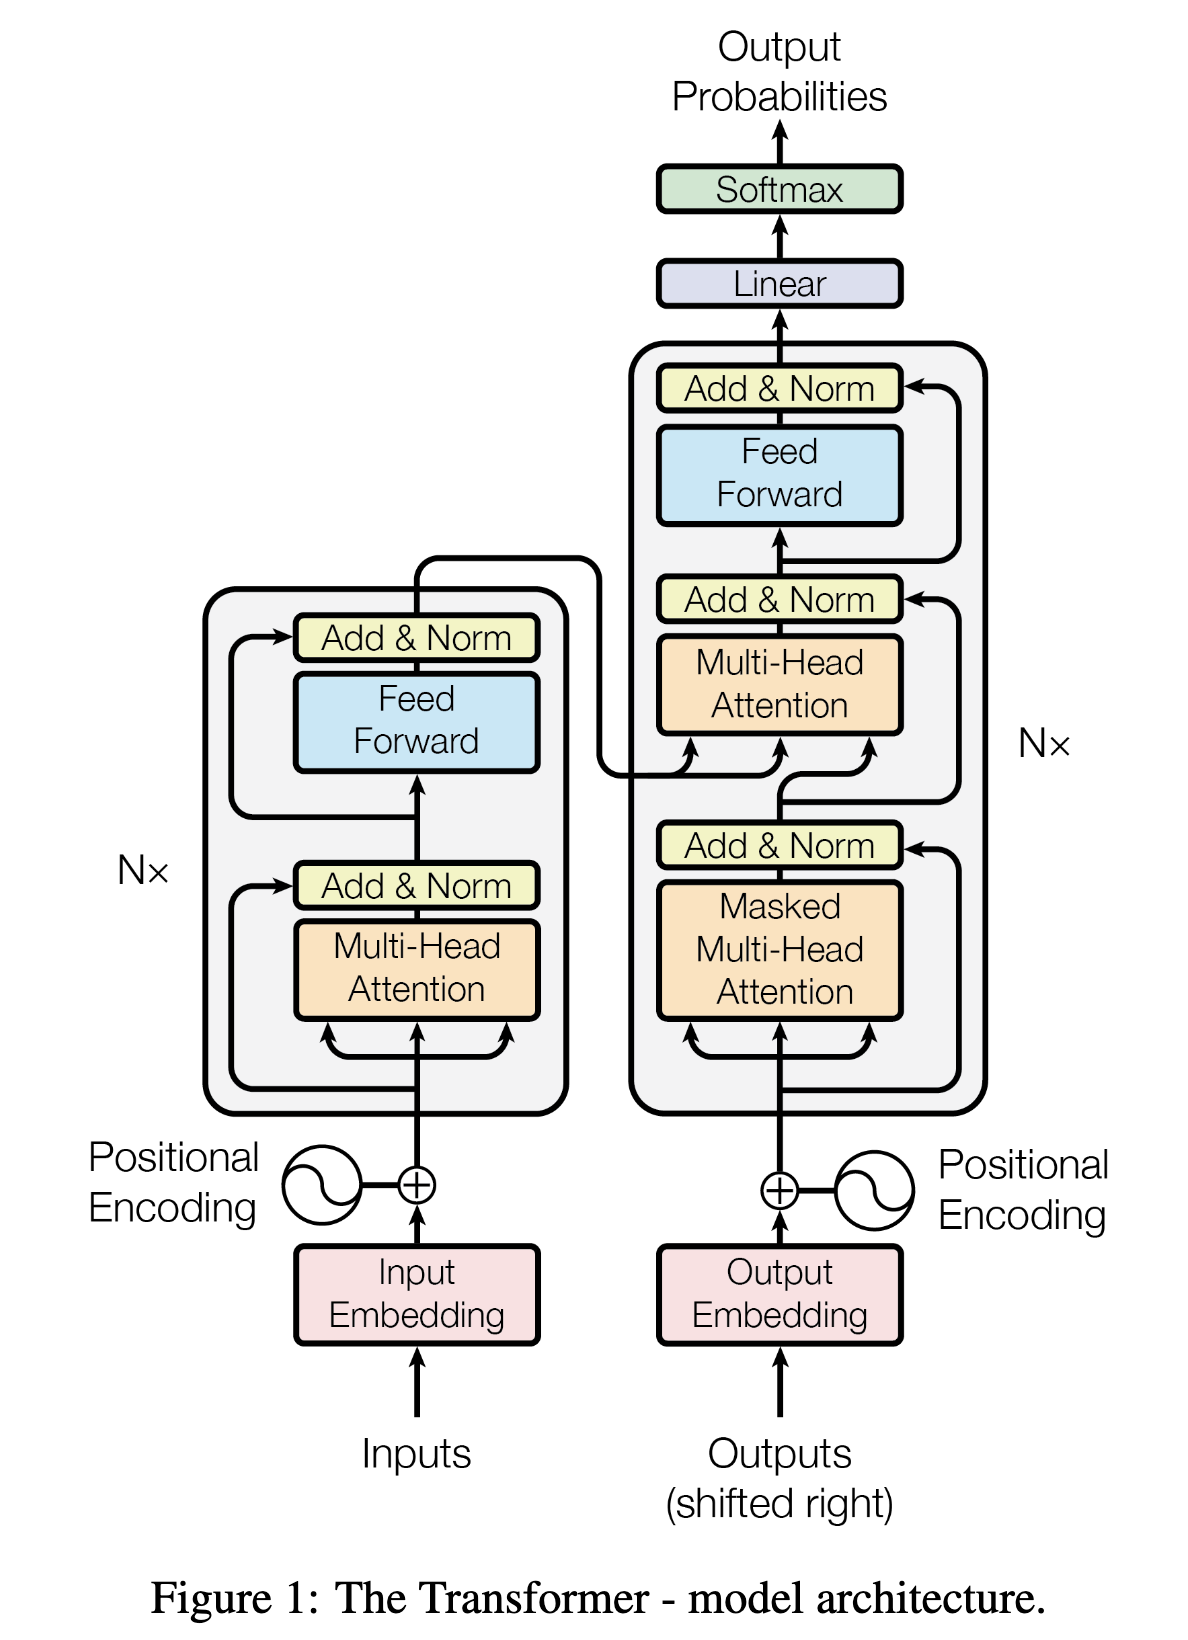
今天主流大模型的 Block 不是凭空设计的,它是从 2017 年 Transformer 原始论文 Attention Is All You Need 的架构一路演化来的。先看原文的经典架构图:

transformer.png

原始 Transformer 是为机器翻译设计的,整个模型分成左右两半。左边是 编码器(Encoder),负责读入源语言句子;右边是 解码器(Decoder),负责逐个生成目标语言的词。图底部的嵌入层加位置编码,就是上一篇讲的内容;最上方的 Linear 加 Softmax,则对应今天的 lm_head 和 softmax,我们后面学习。

重点看中间的 Block。编码器的 Block 分两段:多头注意力加前馈网络;解码器的 Block 分三段:带掩码的多头注意力、交叉注意力、前馈网络。交叉注意力(Cross Attention) 让解码器在生成每个词时参考编码器读到的源句子。每一段后面都跟着一个 Add & Norm,Add 是把子层的输出和输入做残差相加,Norm 是对相加的结果做 LayerNorm 归一化。注意这个顺序:先相加、再归一化,归一化作用在残差相加之后的主干上,这个写法叫 Post-Norm(后置归一化)。

不过,如今的大模型几乎都去掉了编码器,也就是 decoder-only(仅解码器) 架构。核心原因是它的预训练目标很简单,就是不断地预测下一个 token,海量文本不需要任何标注就能直接训练,规模容易堆上去。理解类任务也都可以改写成续写的形式,把问题写进输入、让模型接着写答案,一个模型就可以同时覆盖理解和生成。翻译这类原本适合编码器-解码器架构的任务,用续写同样能完成,编码器-解码器架构慢慢就成了少数派。

编码器没了,交叉注意力自然也被拿掉,一个 Block 就剩下两段:带掩码的多头注意力加前馈网络。接下来就看看这个两段式 Block 在今天的大模型里长什么样。

一个 Block 的内部结构

从原始架构到今天的主流开源大模型(LLaMA、Qwen、DeepSeek 等),Block 又做了两处改进:LayerNorm 换成了 RMSNorm,归一化从子层之后挪到了子层之前,也就是 Pre-Norm(前置归一化)。改完之后,各家的 Block 长得几乎一模一样:

transformer-block-prenorm.png

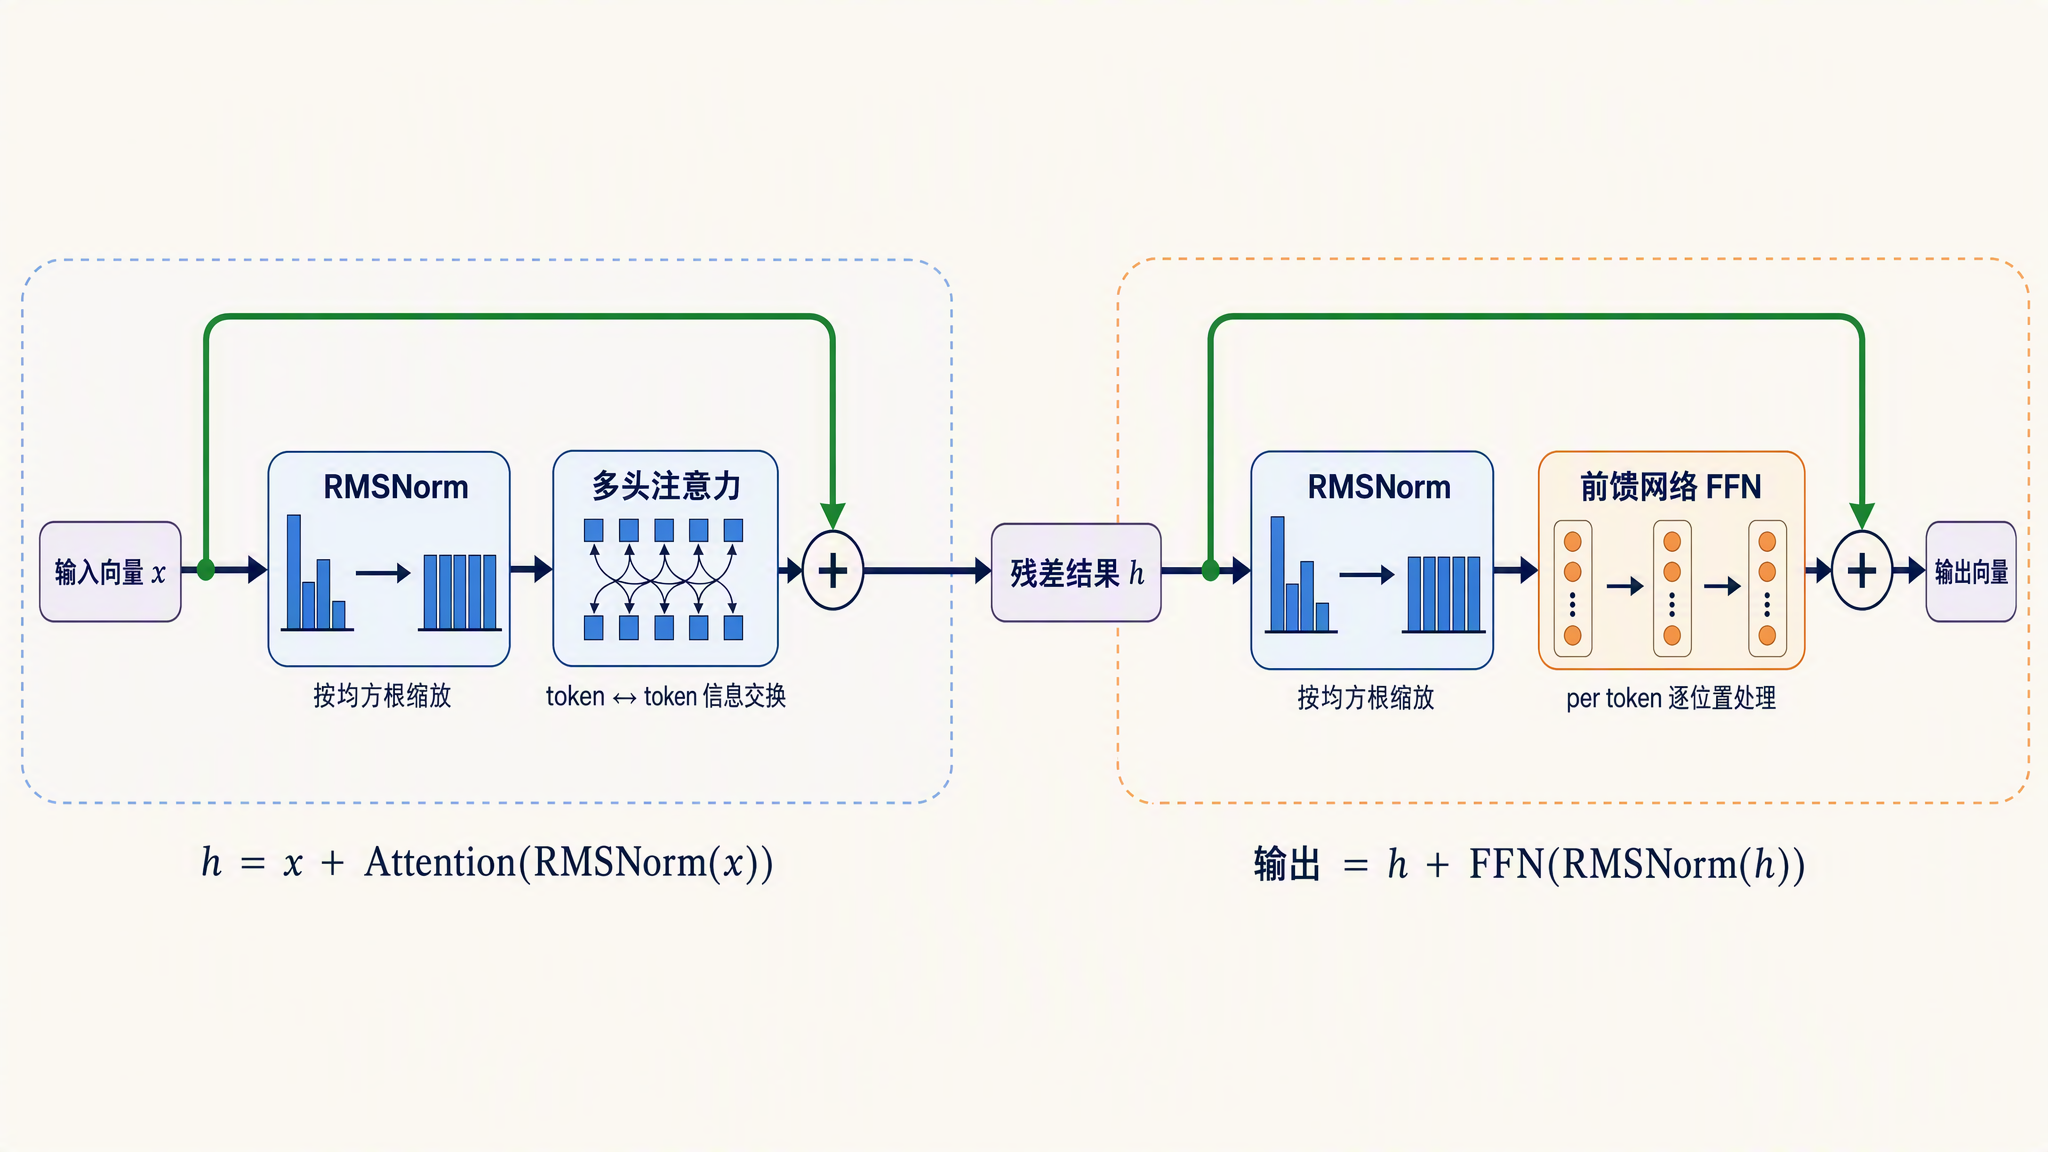
先不管具体怎么算,沿着箭头把这张图走一遍。一个 Block 分成前后两个阶段:前半段让 token 通过注意力交换信息,后半段让每个 token 进入前馈网络单独加工。

输入向量 x 先经过 RMSNorm,再进入多头注意力;注意力的结果和未经处理的 x 相加,得到中间结果 h。接着 h 再经过一次 RMSNorm 和前馈网络,处理结果与原来的 h 相加,得到这个 Block 的最终输出。写成两行就是:

h    = x + Attention(RMSNorm(x))
输出 = h + FFN(RMSNorm(h))

图中的黑色横线是正常的计算路径,绿色线路则绕过子层、直接连到加号。几十个 Block 叠起来时,每一层都重复这两次“先归一化、再计算、最后与原输入相加”的过程。

这条路线里包含三个搭建 Block 骨架的关键概念:绿色旁路叫残差连接,两次缩放操作叫 RMSNorm,而“归一化位于子层之前”的摆放方式就叫 Pre-Norm。下面按这个顺序逐个拆开。

残差连接:给信息留一条直通旁路

先看 残差连接(Residual Connection)。图里两条从上方绕过子层、汇入加号的绿色旁路就是残差连接,写法只有一行:

输出 = 输入 + 子层(输入)

这里的 子层(输入) 表示把输入向量交给子层(注意力或前馈网络)计算后得到的结果,可以把它看成一次函数调用。也就是说,子层不直接输出加工结果,而是输出一个修改量,叠加在原始输入上。原始信息始终原样保留在结果里,子层只需要学习该怎么改。

为什么需要这条旁路?这和训练有关。神经网络训练时靠 梯度(Gradient) 来更新参数,梯度可以理解为从输出端一路传回输入端的修正信号,告诉每个参数该往哪个方向调。这个信号每穿过一层都会被削弱一点,几十层叠下来,传到最前面几层时已经所剩无几,前面的层就学不动了,这就是梯度消失问题。

有了残差连接,情况就不一样了:加法这条路上没有任何变换,修正信号可以顺着旁路几乎无损地传回第一层,深层网络才训得动。这个技巧出自 2015 年何恺明等人的 ResNet 论文,原本用在 152 层的图像网络上,后来被 Transformer 继承,成了所有深层网络的标准配置。

可以打个比方:残差连接像传阅改稿,每个子层都在原稿上批注修改,原稿本身一直在;没有残差连接就像每层都把稿子重写一遍再往下传,传了几十层,原稿早就面目全非了。

RMSNorm:把数值缩放回稳定范围

残差旁路保住了原始信息,但主路径上的数值还需要保持稳定,这就是图中两个归一化模块的作用。向量每过一层子层,数值范围都会漂移,有的维度越乘越大,有的越压越小。几十层累积下来,数值可能大到溢出,也可能小到丢失精度,计算就不稳定了。归一化的作用就是定期把向量拉回一个稳定的数值范围。

前面讲原始 Transformer 时提过,它的 Add & Norm 里用的归一化方法是 LayerNorm(层归一化)。LayerNorm 分两步:先减均值,再除以标准差,相当于把考试成绩换算成标准分。

layernorm.png

效果是没啥问题,但每一步都要算均值和标准差两个统计量。后来 2019 年的 RMSNorm 论文 提出了一个简化:砍掉减均值这一步,只保留缩放,相当于直接按总分折算成百分比。少算一个统计量,计算更省,效果不降,现在主流模型都用它替代了 LayerNorm。

RMSNorm(Root Mean Square Layer Normalization,均方根层归一化) 的做法很朴素:算出整个向量的均方根,然后每个维度都除以它,等比缩放:

rmsnorm.png

其中 g 是一组可学习的缩放系数,每个维度一个,归一化之后由模型自己决定每个维度再放大多少;ε 是一个很小的数,防止除零。

写成代码也就几行:

import torch

def rms_norm(x, weight, eps=1e-6):
    rms = torch.sqrt(x.pow(2).mean(dim=-1, keepdim=True) + eps)
    return x / rms * weight

x = torch.tensor([1.0, 2.0, 3.0, 4.0])
print(rms_norm(x, torch.ones(4)))

输出结果:

tensor([0.3651, 0.7303, 1.0954, 1.4606])

可以看到,各维度的比例没变,但整体尺度被收回到了 1 附近。不管输入向量的数值飘到多大,过完 RMSNorm 都会回到这个量级。

Pre-Norm:归一化放在子层之前

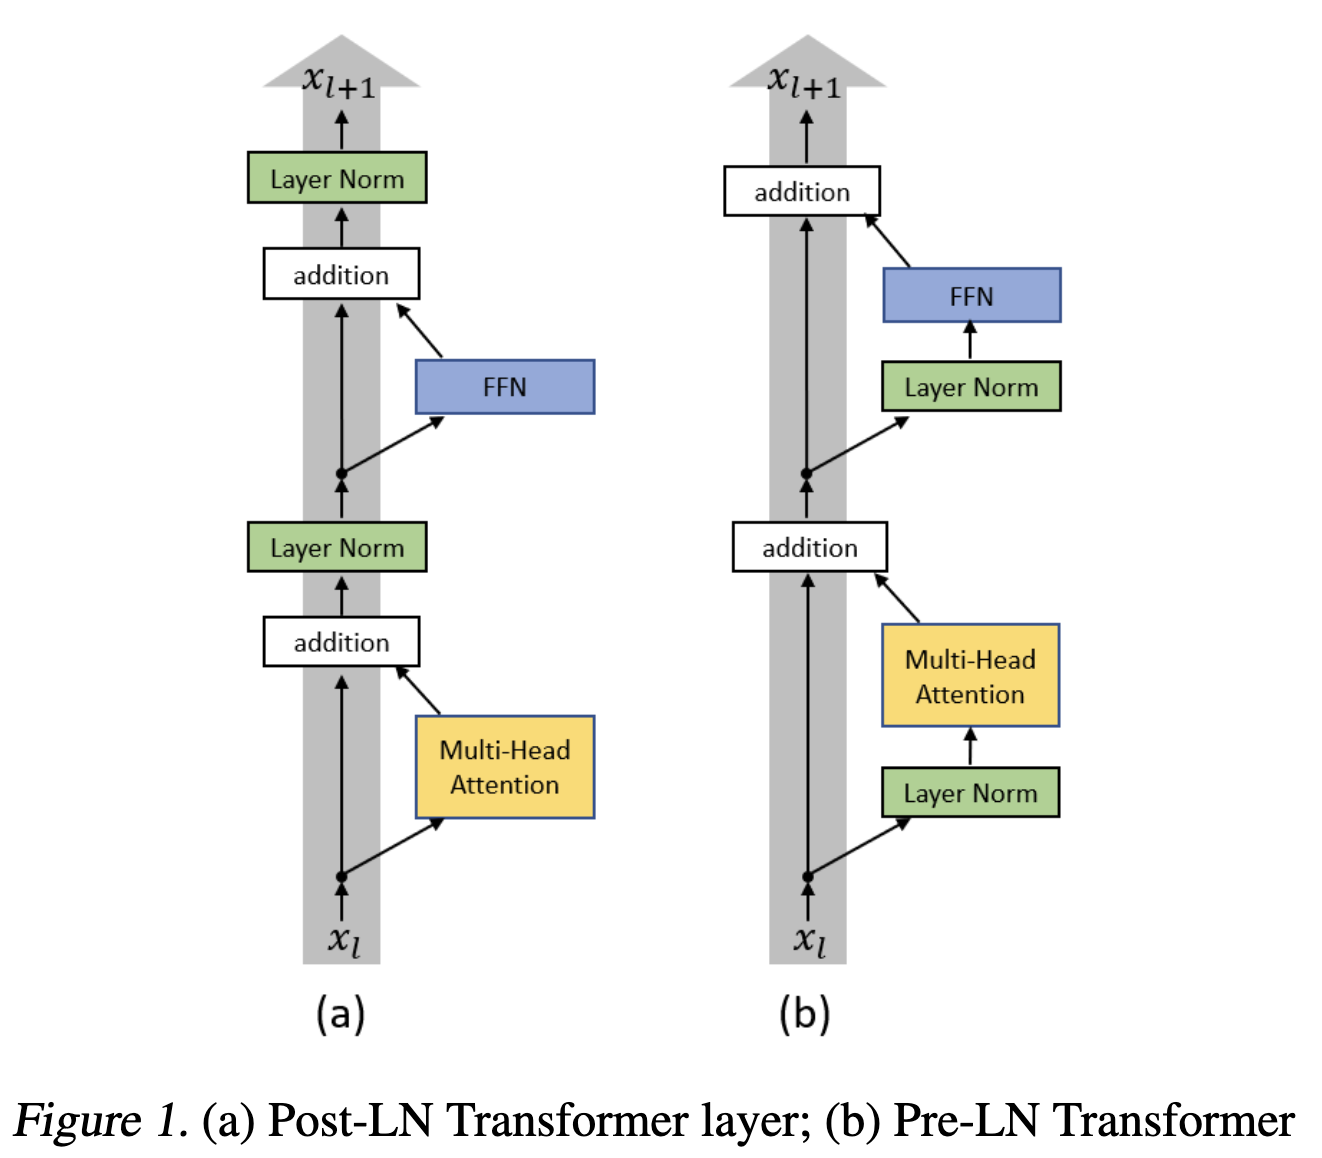
知道 RMSNorm 做什么之后,最后还要回答一个问题:它应该放在哪里?原始 Transformer 用的是 Post-Norm(后置归一化),先算子层、加残差,最后归一化;现在主流模型用的 Pre-Norm(前置归一化) 则把归一化挪到子层之前:

Post-Norm: 输出 = RMSNorm(输入 + 子层(输入))
Pre-Norm:  输出 = 输入 + 子层(RMSNorm(输入))

两者对比图如下所示:

post-vs-pre.png

区别看着只是顺序,影响却不小。Post-Norm 里归一化卡在残差旁路上,修正信号回传时每过一层都要被重新缩放一次,层数一深训练就容易不稳,需要很小心地调参才能训起来。Pre-Norm 把归一化挪进子层内部,残差旁路从第一层直通最后一层,信号回传畅通无阻。微软 2020 年的论文 On Layer Normalization in the Transformer Architecture 从梯度的角度对比了这两种结构,证明了 Pre-Norm 的梯度更稳定,后来的大模型几乎全部采用了 Pre-Norm 结构。

到这里,Block 的骨架就清楚了:残差连接负责保留原始信息和打通信号通路,RMSNorm 负责稳定数值尺度,Pre-Norm 则规定 RMSNorm 要放在子层之前。

搞清楚这些基础概念之后,我们再来看看骨架中真正加工信息的两个核心组件。前半段的注意力机制横向连接整段序列,让不同 token 互相查找和交换信息;后半段的前馈网络(FFN)不再混合 token,而是对每个位置的向量独立做非线性变换。两者一个负责“交流”,一个负责“思考”,共同完成一层 Block 的更新。下面先学习注意力,再回头看前馈网络。

注意力机制

先看第一个核心组件:注意力。它的计算可以拆成几步:给每个 token 生成 Query、Key、Value 三个向量,用 Query 和 Key 算注意力分数,再按分数对 Value 加权求和。下面一步步拆开看。

Query、Key、Value

进入注意力子层后,每个 token 的向量会分别乘以三个投影矩阵,得到三个新向量:Query(查询)、Key(键)、Value(值)。投影矩阵就是一组可学习的参数,向量乘上去相当于做一次坐标变换,让同一个 token 能够以三种不同的身份参与计算。

可以用查资料来类比这三个角色:

  • Query:这个 token 想找什么信息,相当于读者手里的问题
  • Key:这个 token 能提供什么信息的索引,相当于每本书封底的标签
  • Value:这个 token 实际携带的内容,相当于书的正文

qkv-analogy.jpg

注意力分数就是 Query 和 Key 的点积。点积是把两个向量对应位置相乘再相加,比如 (1, 2) 和 (1, 0) 的点积是 1×1+2×0=1。点积越大,说明两个向量方向越一致,也就是 Query 想找的和 Key 标注的越匹配。得到分数之后,再按分数对所有 token 的 Value 加权求和,信息就完成了交换。

拿到 Q 和 K 之后、算分数之前,其实还有一步:上一篇讲的 RoPE 就是在这里登场的,它按位置把 Q 和 K 的维度两两配对做旋转,位置信息由此进入注意力计算。V 不参与旋转,只负责携带内容。

缩放点积注意力

把上面的过程写成公式,就是原始 Transformer 论文里提出的 缩放点积注意力(Scaled Dot-Product Attention):

attention.png

逐项解释一下:

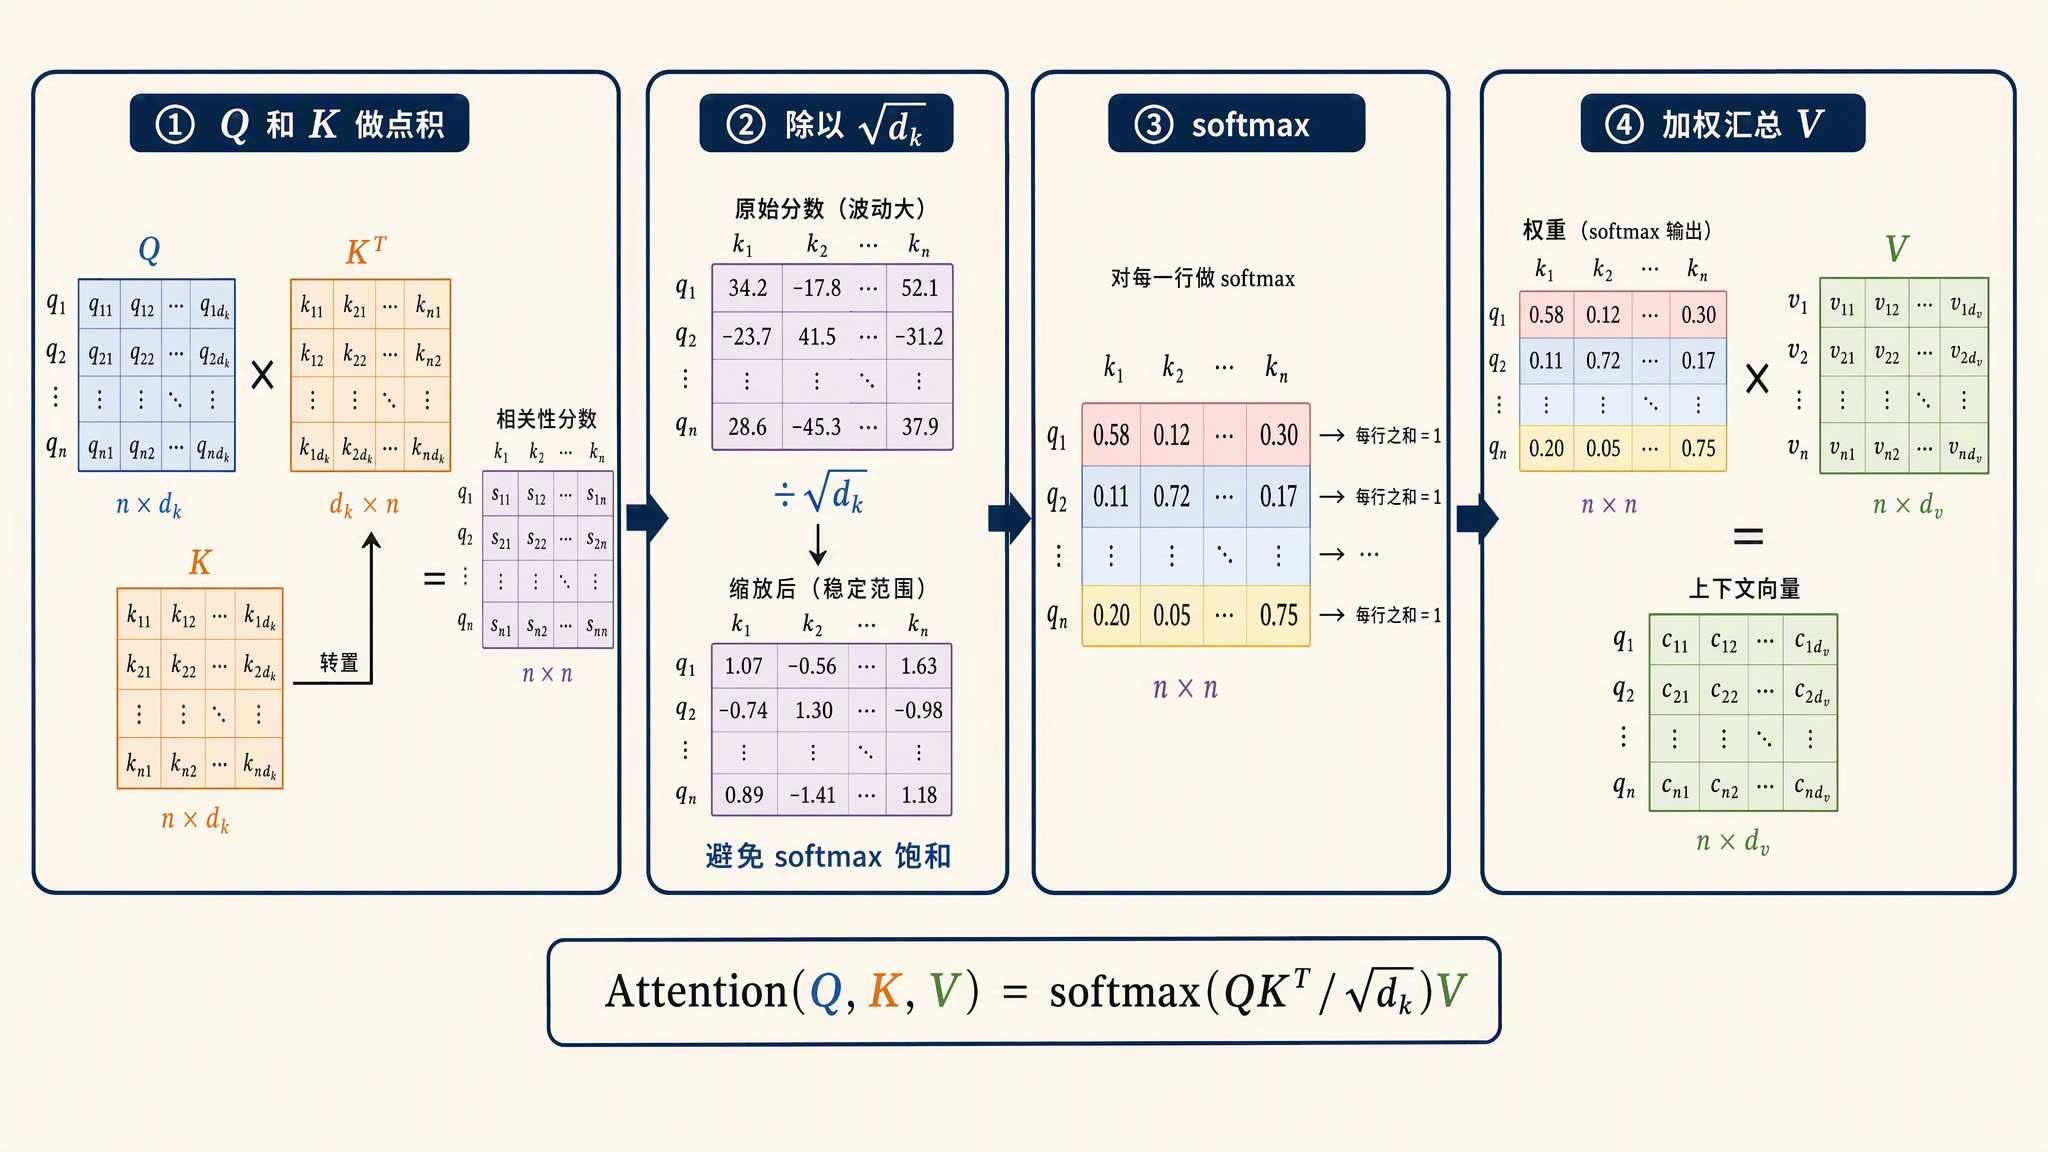
  • QK^T:拿每个 token 的 Q 和所有 token 的 K 做点积,得到一个 N×N 的分数矩阵,N 是序列长度。矩阵第 i 行第 j 列,表示第 i 个 token 对第 j 个 token 的关注程度
  • √d_k:d_k 是 Key 向量的维度。维度越高,点积的结果天然越大;点积太大,softmax 会被推到梯度接近 0 的饱和区,训练就学不动了。除以 √d_k 可以把分数的方差拉回到 1 附近,让 softmax 工作在敏感区间
  • softmax:对每一行做归一化,把分数变成和为 1 的权重。softmax 的做法是先对每个分数取指数(放大差距、保证非负),再除以整行的总和,这样每个权重都在 0 到 1 之间,加起来正好等于 1
  • 乘 V:按权重对所有 token 的 Value 加权求和,得到每个位置融合了上下文之后的新向量

scaled-dot-product-attention.jpg

手算一个小例子

公式看着抽象,我们拿 4 个 token 的小例子亲手算一遍。假设输入是「我 爱 吃 苹果」,为了能手算,把向量的维度压到 2。假设每个 token 的向量过完投影矩阵后,得到的 Q、K、V 如下:

tokenQueryKeyValue
我(1, 2)(1, 0)(1, 0)
爱(2, 1)(0, 1)(0, 1)
吃(3, 1)(1, 1)(2, 1)
苹果(1, 1)(2, 0)(1, 2)

两两点积,得到 4×4 的注意力分数矩阵:

分数K: 我K: 爱K: 吃K: 苹果
Q: 我1232
Q: 爱2134
Q: 吃3146
Q: 苹果1122

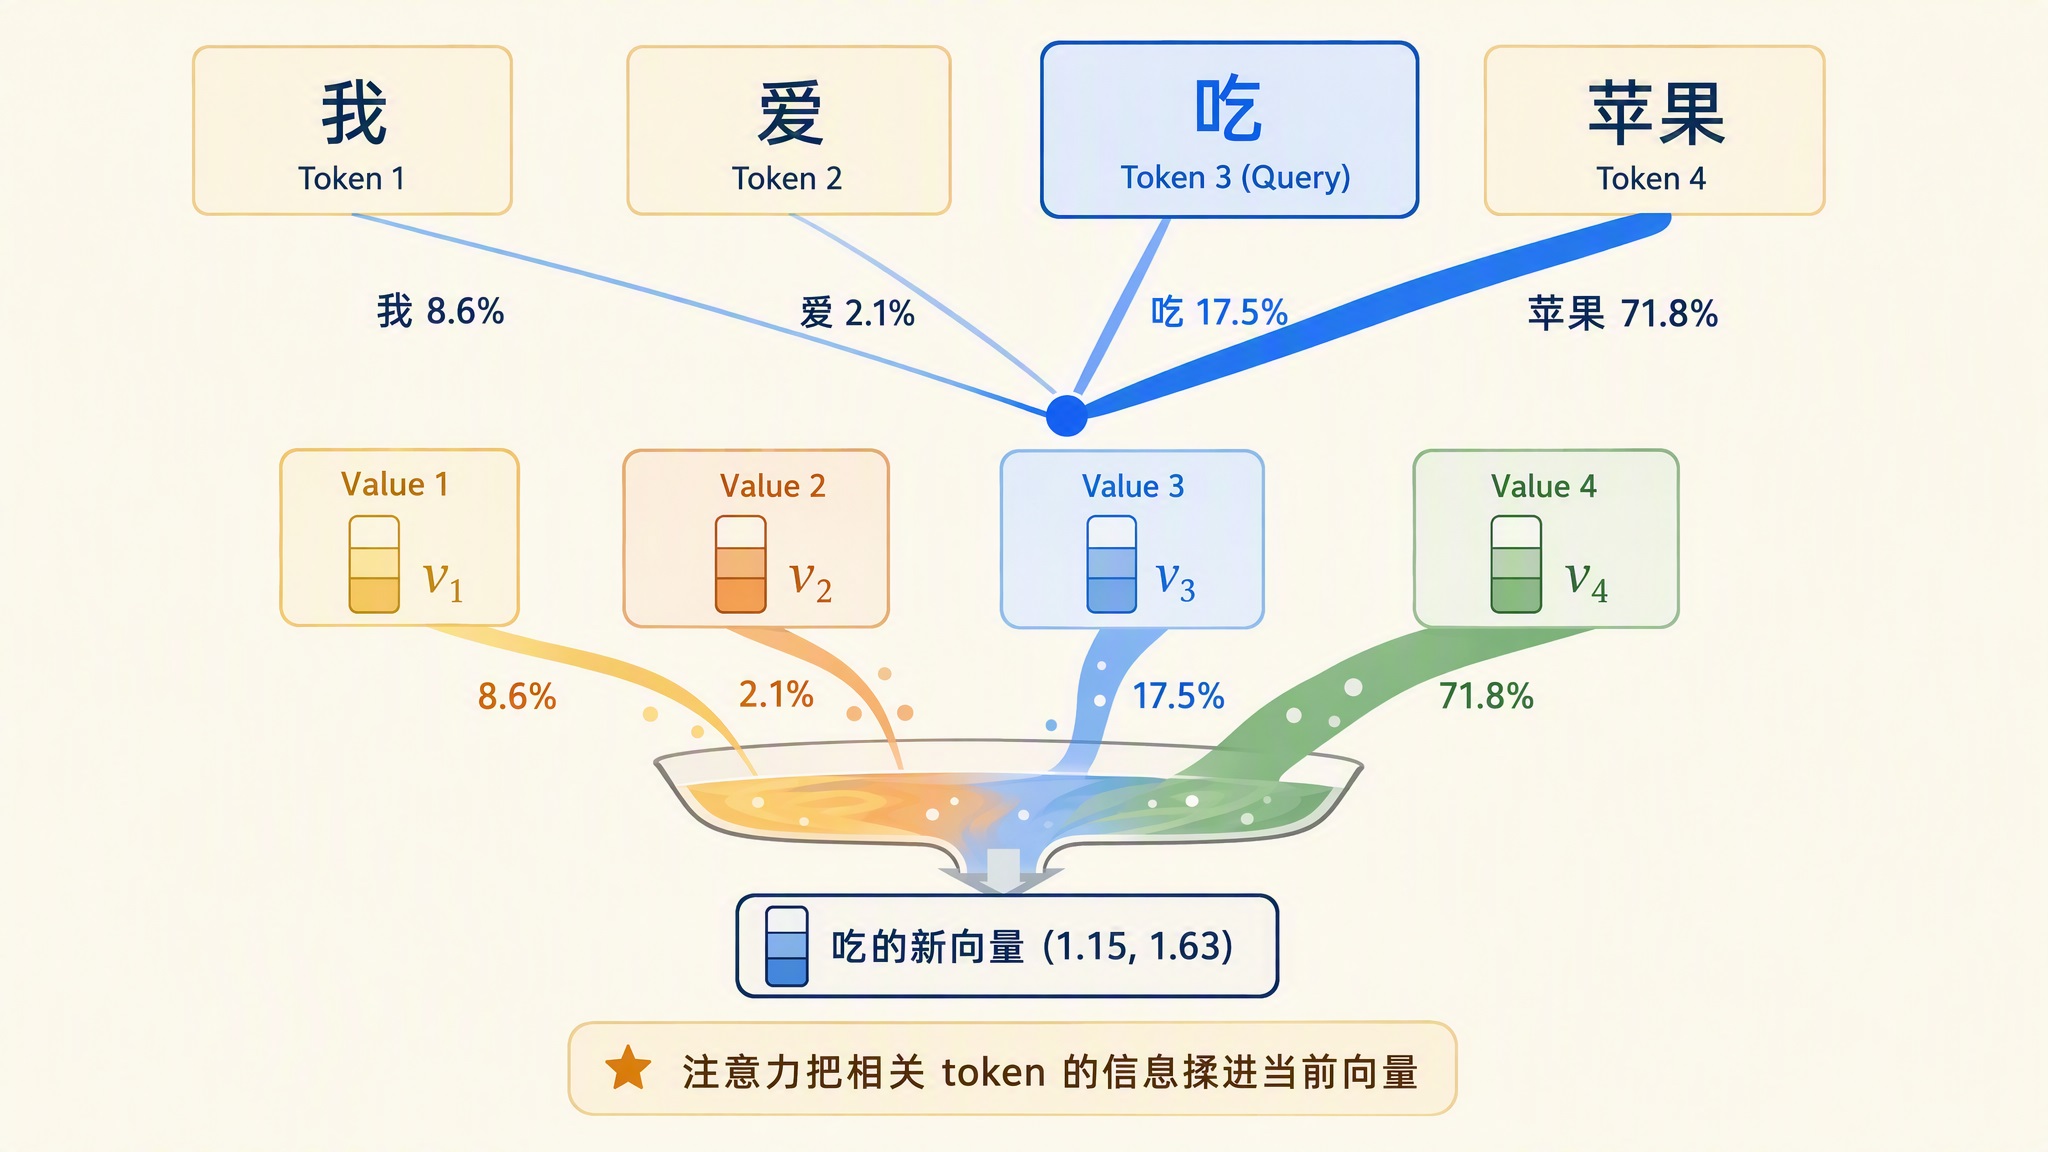
以「吃」这一行为例验算一下:Q(吃) = (3, 1),它和四个 Key 的点积分别是 3×1+1×0=3、3×0+1×1=1、3×1+1×1=4、3×2+1×0=6。

读这一行就能看到一个有意思的现象:「吃」对「苹果」的分数最高(6),其次是它自己(4)和「我」(3),对「爱」几乎不感兴趣(1)。这和我们的语言直觉吻合,一个动词最关心的问题就是谁在吃、吃什么。

接着按公式走。这里 d_k = 2,每个分数先除以 √2 ≈ 1.41,再对整行做 softmax,「吃」这一行的权重变成:

关注对象我爱吃苹果
权重0.0860.0210.1750.718

可以看到,「吃」把大约 72% 的注意力给了「苹果」,18% 留给自己,9% 给了「我」。最后拿这组权重对四个 token 的 Value 加权求和:0.086×(1, 0) + 0.021×(0, 1) + 0.175×(2, 1) + 0.718×(1, 2) = (1.15, 1.63),这就是「吃」这个位置的新向量,它里面已经揉进了主语和宾语的信息。

attention-hand-calculation.jpg

因果掩码

上面的例子里有一个破绽:「吃」在算注意力时看到了排在它后面的「苹果」。这在真实生成中是不允许的。模型是一个 token 一个 token 往外生成的,在「吃」这个位置决定下一个词的时候,「苹果」还不存在。如果训练时允许模型看未来,它就学会了抄答案,生成时必然露馅。

解决办法是 因果掩码(Causal Mask):在 softmax 之前,把分数矩阵的上三角全部置为负无穷。负无穷经过 softmax 后权重变成 0,相当于把这些位置直接屏蔽:

分数K: 我K: 爱K: 吃K: 苹果
Q: 我1-inf-inf-inf
Q: 爱21-inf-inf
Q: 吃314-inf
Q: 苹果1122

「我」只能看自己,「爱」能看前两个,「吃」能看前三个。重新算「吃」这一行,只对前三个分数(3、1、4)做缩放和 softmax,权重变成大约 0.306、0.074、0.620,「吃」的注意力就收敛到了它自己和「我」身上。加权求和得到的新向量是 0.306×(1, 0) + 0.074×(0, 1) + 0.620×(2, 1) = (1.55, 0.69),和没加掩码时的 (1.15, 1.63) 对比,「苹果」的贡献被完全挡掉了。

每个位置只看得到自己和左边的 token,这就是 GPT 这类 decoder-only 模型的标准约束。它保证了训练时的计算方式和生成时一致。

多头注意力

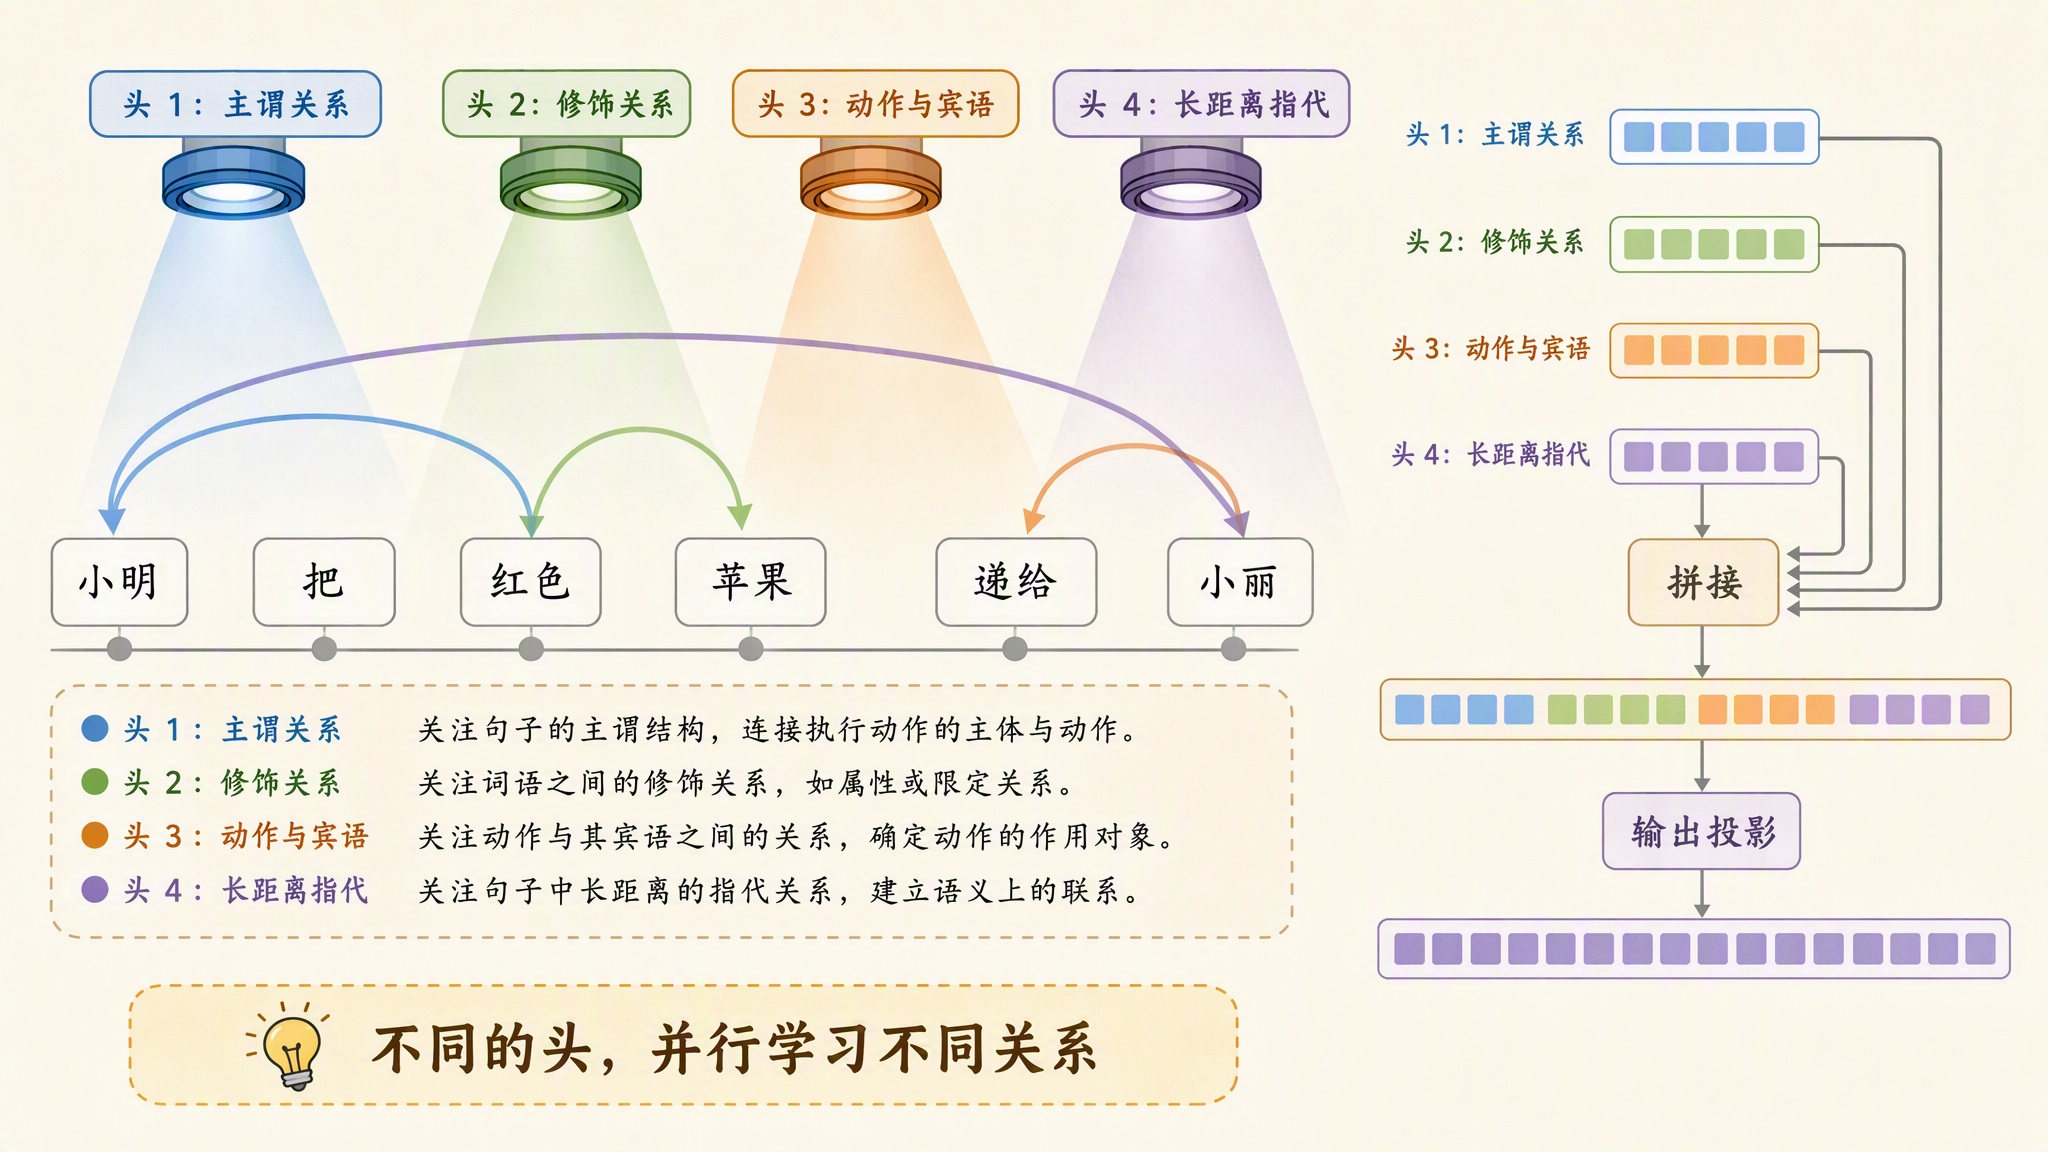
上面演示的注意力只有一个头,也就是一套 Q、K、V 投影算一份注意力分数。一个头只能学一种关注模式,比如例子里它学会了动词找宾语,但一句话里值得学的关系还有很多:指代、修饰、搭配、语序。一个头明显不够用。

多头注意力(Multi-Head Attention,MHA) 的做法是把向量切成多份,每一份用各自独立的 Q、K、V 投影并行算一遍注意力,最后把各头的结果拼接起来,再过一次输出投影。每个头有独立的参数,训练后会分化出不同的关注模式。

multi-head-attention.jpg

Qwen3-0.6B 有 16 个查询头,每个头的维度是 128,这些配置在 Qwen3 技术报告里都能查到。训练完成后,有的头擅长局部搭配,有的头擅长长距离依赖,各司其职。

从 MHA 到 GQA 到 MLA

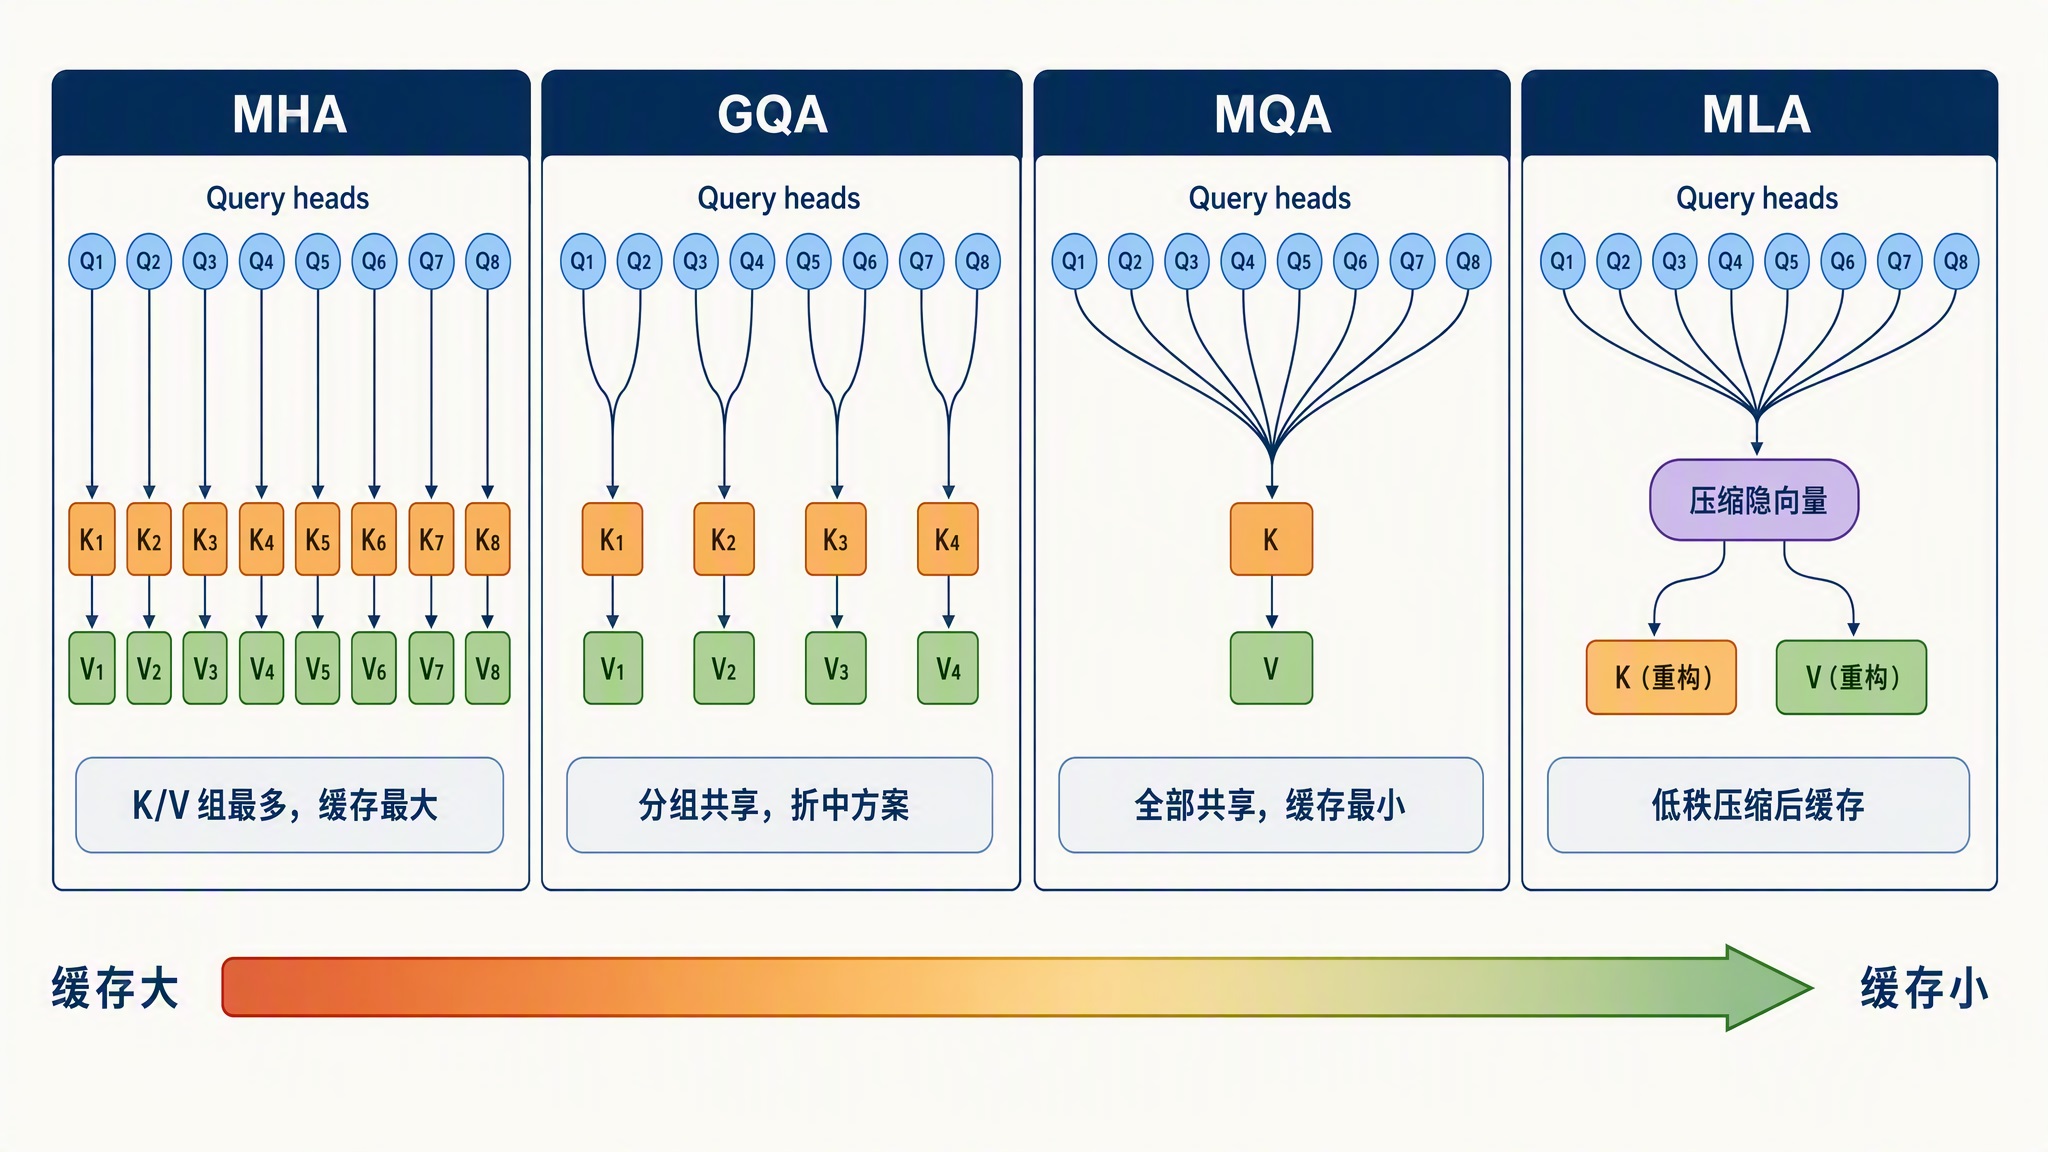
多头注意力效果好,但推理时要付出一个代价:每个头都有自己独立的 K 和 V。生成时为了不重算历史,所有历史 token 的 K、V 都要存在显存里,这份缓存就是我们常说的 KV Cache。头越多、层越深、序列越长,缓存就越大,显存很快吃紧。围绕这个矛盾,注意力头数的设计一路演进:

  • MHA:Q、K、V 头数相同,比如 16 个头就配 16 组 K、V。质量最好,缓存最大,早期的 GPT-3 就是这个结构。
  • MQA(Multi-Query Attention,多查询注意力):2019 年 Shazeer 在 Fast Transformer Decoding: One Write-Head is All You Need 里提出,让所有查询头共享同一组 K、V。缓存直接缩小到头数分之一,速度提升明显,但质量有损失。
  • GQA(Grouped-Query Attention,分组查询注意力):2023 年 Google 在 GQA 论文中提出的折中方案,把查询头分成若干组,每组共享一组 K、V。质量接近 MHA,缓存接近 MQA。LLaMA 3、Qwen3、Mistral 用的都是 GQA。
  • MLA(Multi-head Latent Attention,多头潜在注意力):DeepSeek 在 DeepSeek-V2 论文中提出的另一条路,不缓存完整的 K、V,而是把它们低秩压缩成一个隐向量存起来,推理时再还原。按论文的数据,DeepSeek-V2 的 KV 缓存比上一代 DeepSeek 67B 减少了 93.3%,效果还不输 MHA。

四种注意力方案的查询头与 K/V 共享关系如下图所示:

attention-variants.jpg

四种方案的取舍可以汇总成一张表:

方案K/V 组数KV 缓存大小代表模型
MHA等于查询头数最大GPT-3
GQA查询头数的几分之一中等LLaMA 3、Qwen3
MQA1最小Falcon
MLA压缩成隐向量比 GQA 更省DeepSeek-V2/V3

这里只需要建立一个印象:注意力头的设计,本质上是在质量和 KV 缓存开销之间做权衡。缓存到底怎么存、怎么管,我们留到下一篇展开。

前馈网络

注意力解决 token 之间的信息交换,前馈网络(Feed-Forward Network,FFN) 则是对每个 token 的向量单独做加工。注意力算完一轮,每个位置的向量里都揉进了上下文,接下来怎么把这些信息消化成更有用的表示,就是 FFN 要干的事。它的结构比注意力简单得多,我们一层层拆开看。

两层 MLP:先放大,再压回

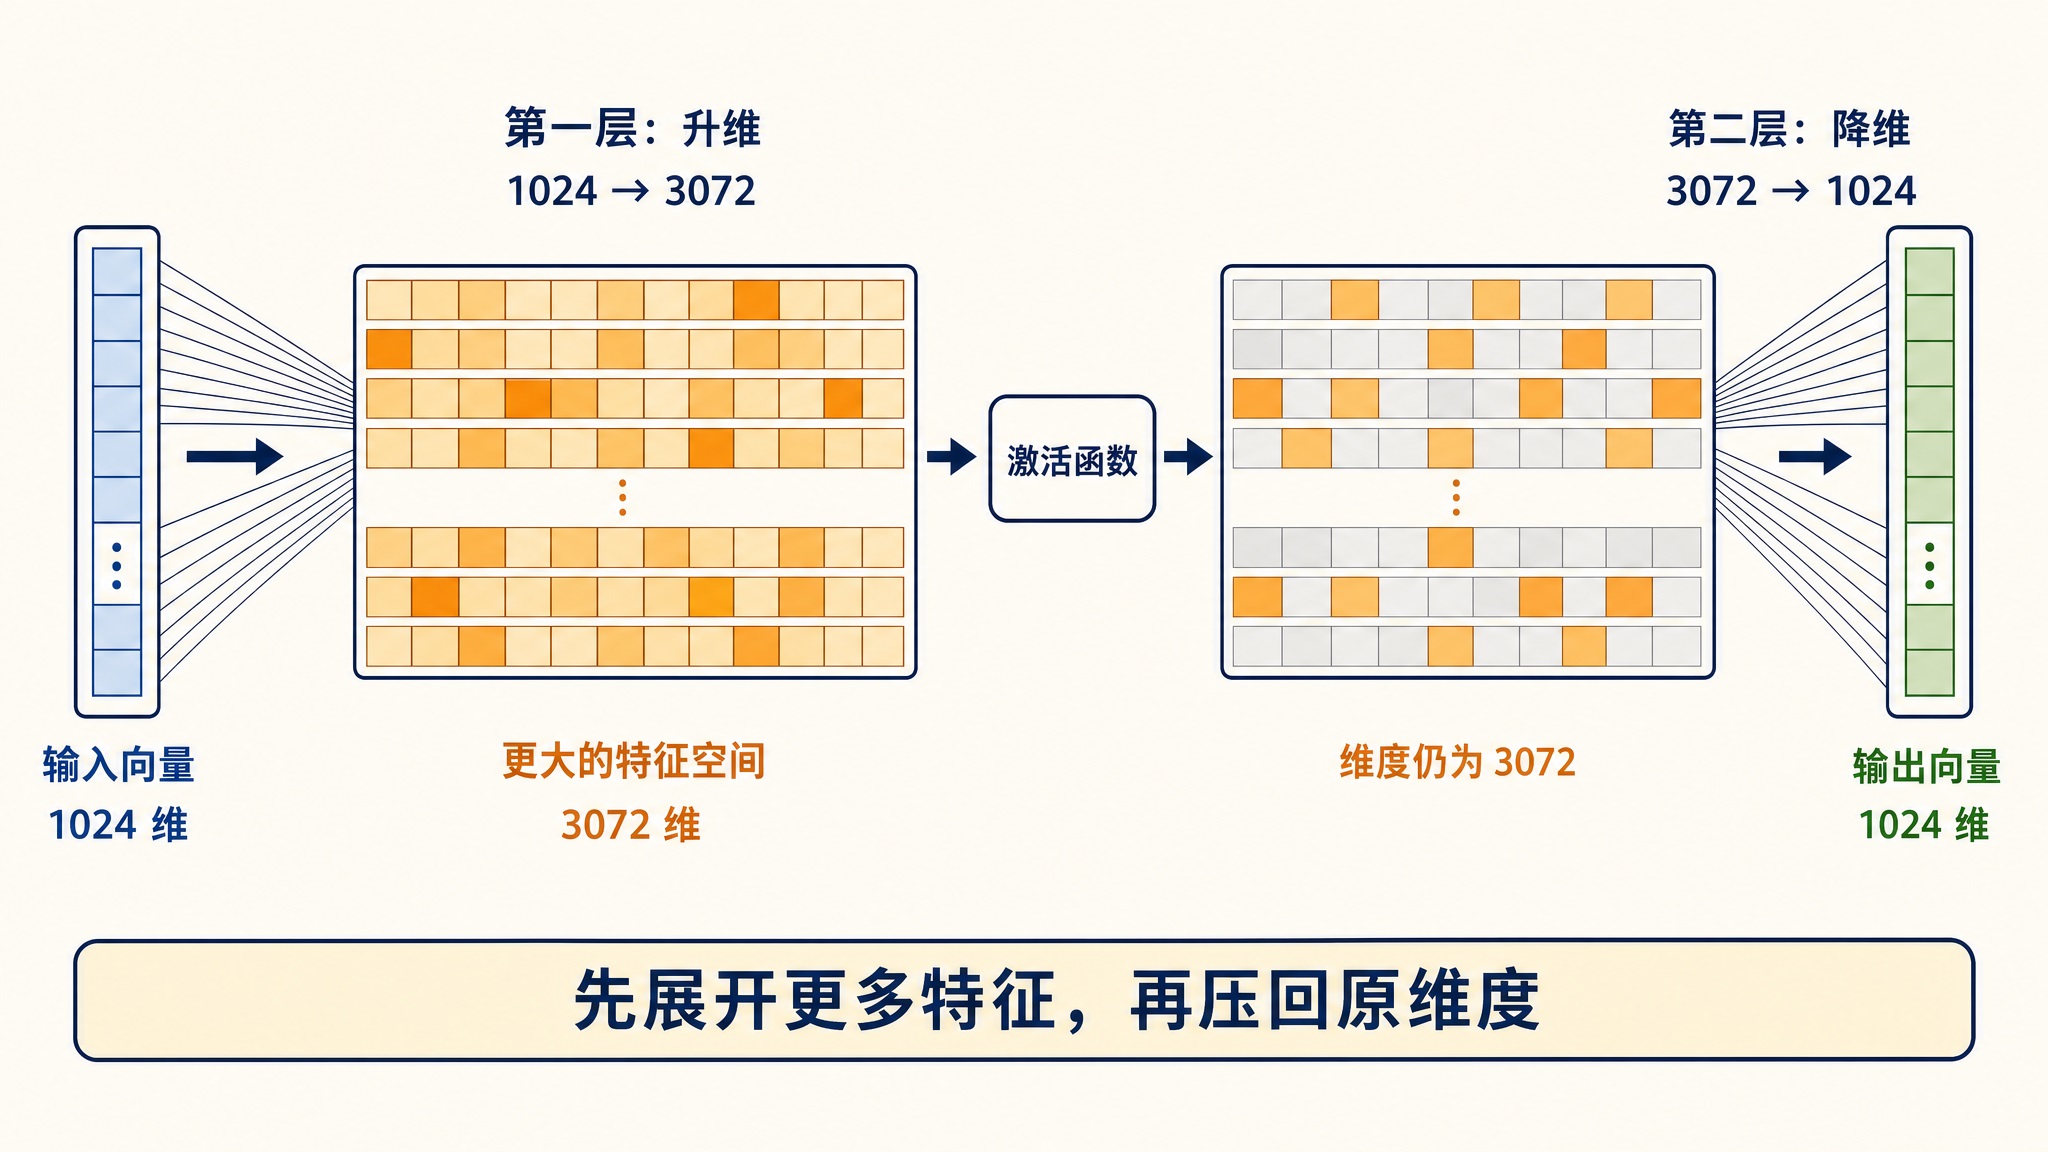
FFN 的结构是两层 MLP(Multi-Layer Perceptron,多层感知机),也就是矩阵乘法叠起来的全连接网络:先把维度放大,中间过一遍激活函数,再压回原来的维度。原始 Transformer 里就是 512 维放大到 2048 维再压回 512 维,Qwen3-0.6B 则是 1024 维放大到 3072 维再压回 1024 维,这个形状从 2017 年一直沿用到今天。

ffn-two-layer-mlp.jpg

为什么要先放大?一个直觉的解释是:1024 维的向量能容纳的特征有限,放大到 3072 维相当于摊到一张更大的工作台上,模型可以同时检测更多的模式,整理完再装回原来的盒子。

激活函数:非线性的来源

正如上一节所说,两层矩阵乘法之间还夹着一步:激活函数。它是逐元素起作用的非线性函数,也是网络能学会复杂模式的关键。如果没有它,两层矩阵乘法叠起来在数学上等价于一层,先放大再压回就失去了意义。

早期的 Transformer 用 ReLU(Rectified Linear Unit,线性整流单元),做法很直接:负数归零,正数原样通过。GPT 和 BERT 换成了 GELU(Gaussian Error Linear Unit,高斯误差线性单元),形状和 ReLU 类似但处处平滑,负数不再一刀切归零。现在主流模型用的是 SiLU(Sigmoid Linear Unit,Sigmoid 线性单元),它还有一个更广为人知的名字,Swish,也是同样的思路,公式是 x 乘以 sigmoid(x),sigmoid 是把任意实数压到 0 和 1 之间的 S 形函数。

用同一组输入对比一下这三个函数:

import torch
import torch.nn.functional as F

x = torch.tensor([-2.0, -0.5, 0.5, 2.0])

print(F.relu(x))
print(F.gelu(x))
print(F.silu(x))

输出结果:

tensor([0.0000, 0.0000, 0.5000, 2.0000])
tensor([-0.0455, -0.1543, 0.3457, 1.9545])
tensor([-0.2384, -0.1888, 0.3112, 1.7616])

可以看到,ReLU 把负数直接砍成 0,GELU 和 SiLU 则给小负数留了一点非零输出,整条曲线是平滑的。平滑的好处和训练有关:负半区的梯度不至于完全消失,参数更新更稳定。

activation-functions.png

SwiGLU:给 MLP 加一条门控分支

SwiGLU 出自 Shazeer 2020 年的论文 GLU Variants Improve Transformer,在 SiLU 的基础上又进了一步。它把 MLP 的放大从一路改成两路:gate_proj 和 up_proj 都负责把维度放大,gate 一路先过 SiLU 激活,再和 up 一路逐元素相乘,最后由 down_proj 压回原维度。

逐元素相乘这一步叫门控,思路来自更早的 GLU 家族:让一路输出充当另一路的开关,控制每个维度放行多少信息。gate 这路过完 SiLU 后,值小的维度会把 up 那路压下去,值大的维度则放行,模型由此学会哪些特征该留下、哪些该抑制。

swiglu-ffn.png

下面用代码模拟一遍这个过程,维度沿用 Qwen3-0.6B 的 1024 和 3072:

import torch
import torch.nn.functional as F

torch.manual_seed(0)
x = torch.randn(1024)          # 一个 token 的输入向量

gate_proj = torch.randn(3072, 1024)
up_proj = torch.randn(3072, 1024)
down_proj = torch.randn(1024, 3072)

gate = x @ gate_proj.T         # 1024 -> 3072
up = x @ up_proj.T             # 1024 -> 3072
hidden = F.silu(gate) * up     # 门控:两路逐元素相乘
out = hidden @ down_proj.T     # 3072 -> 1024

print(gate.shape, hidden.shape, out.shape)

输出结果:

torch.Size([3072]) torch.Size([3072]) torch.Size([1024])

可以看到,整个 FFN 的全部计算就是三次矩阵乘法加一次逐元素相乘。多了一路矩阵,参数量自然会涨,所以 SwiGLU 的中间维度通常取得比 ReLU 版本小一些,整体参数量和原来保持相当。记住 gate、up、down 这三个名字,等下看真实模型结构时会再遇到。

FFN 里存的是什么

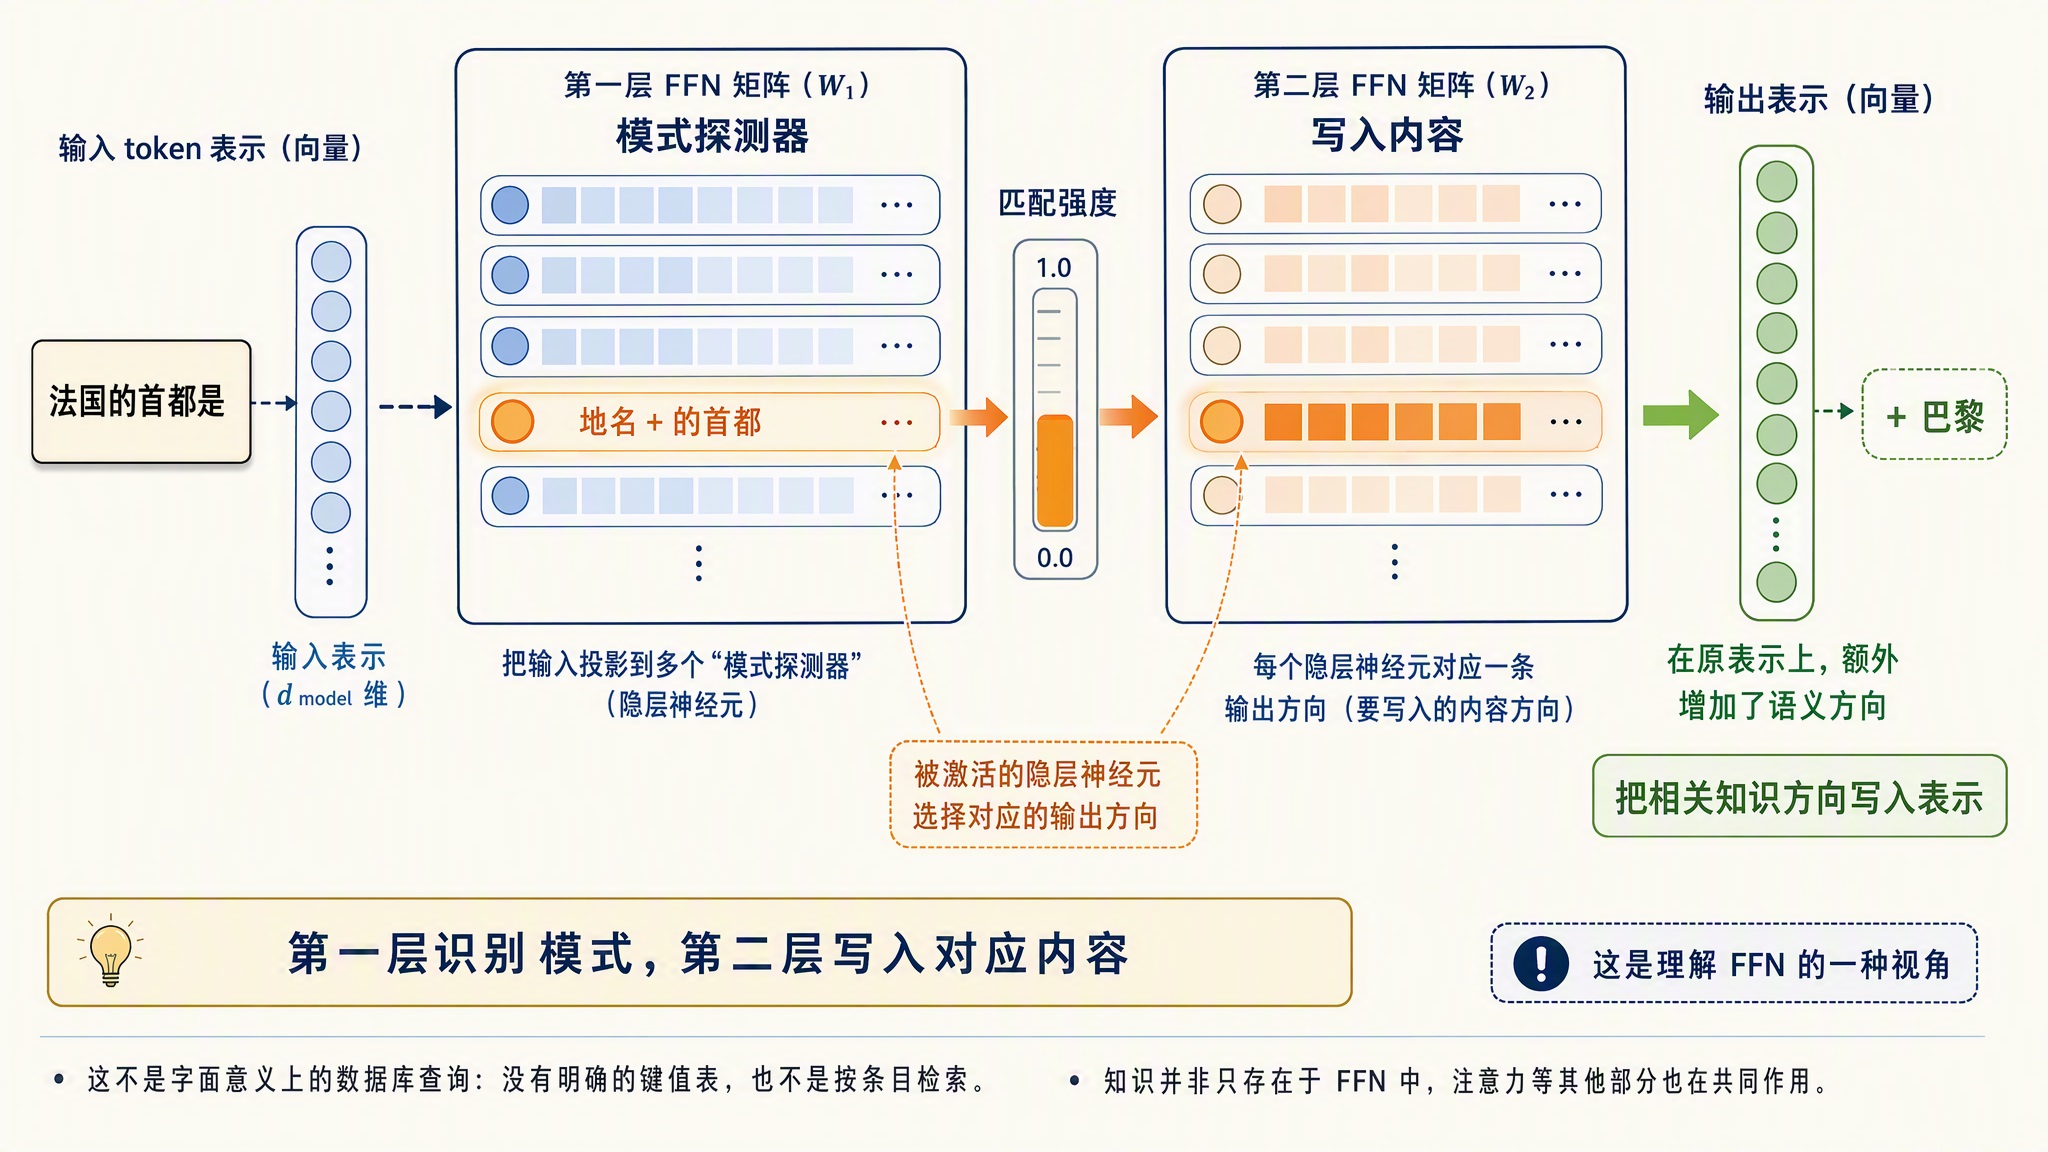
2020 年特拉维夫大学的一篇论文 Transformer Feed-Forward Layers Are Key-Value Memories 认为,FFN 可以看成一个小型的键值记忆库。第一层矩阵的每一行是一个模式探测器,比如识别输入里是否出现了地名加「的首都」这类模式;第二层矩阵的每一列对应一段要往输出里写入的内容,比如把「巴黎」这个方向的表示加进去。一层负责认模式,一层负责写结论,几十层叠起来,模型在预训练时读到的知识就这样存进了 FFN 的权重。

ffn-key-value-memory.jpg

这个视角也解释了为什么 FFN 的参数量比注意力多的多。注意力决定信息往哪流,FFN 才是真正装知识的地方。

混合专家:把一个 FFN 换成一排专家

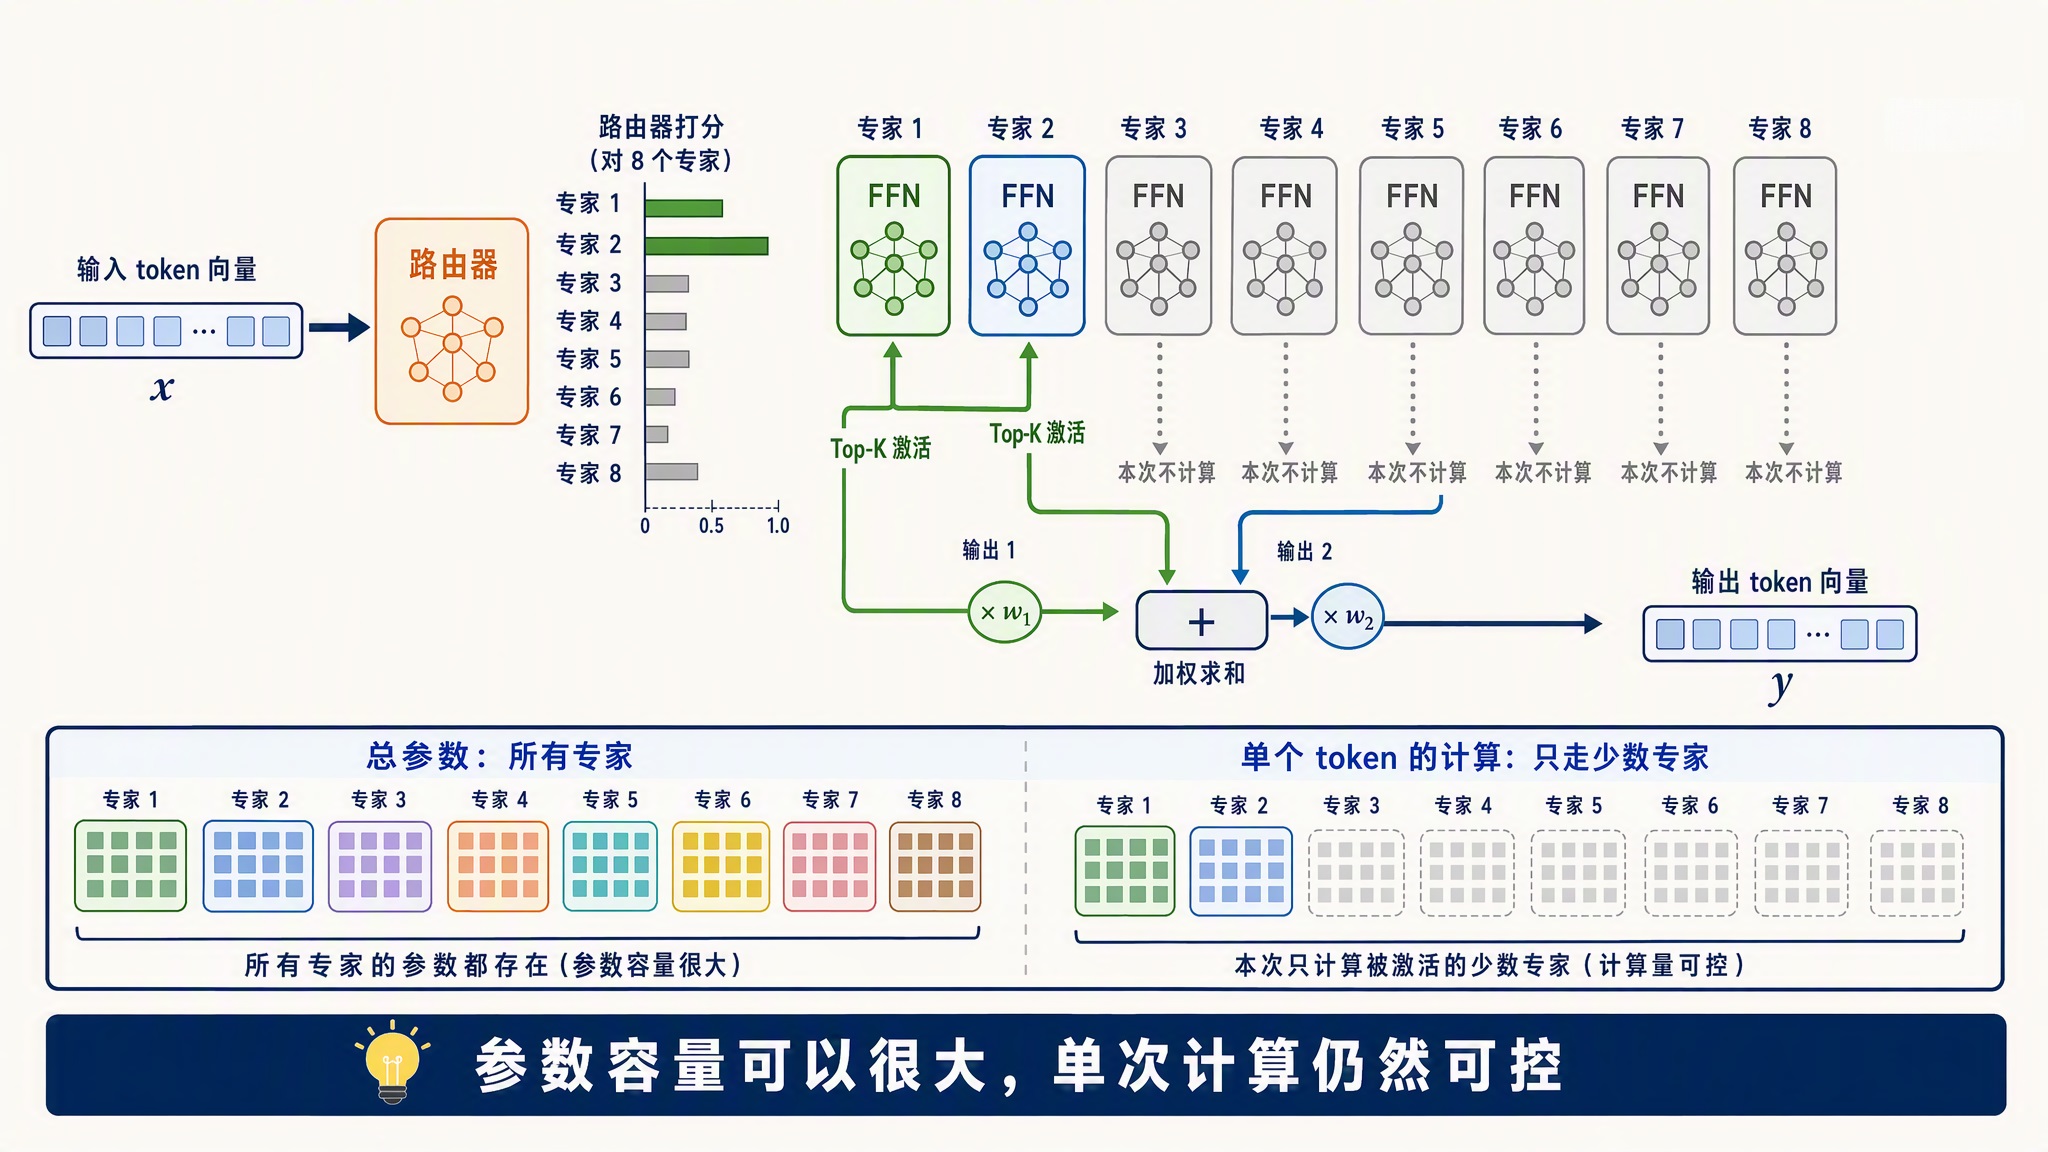
FFN 还有一个重要变体:混合专家(Mixture of Experts,MoE)。它把一个大的 FFN 换成一排小的专家 FFN,每个 token 进来后由路由器给所有专家打分,只激活分数最高的几个,其余不参与计算。

mixture-of-experts.jpg

这样做的好处是把参数量和计算量解耦了:总参数做得越大,能装的知识越多,但每个 token 实际消耗的计算只和激活的那几个专家有关。比如 DeepSeek-V3 总参数 6710 亿,每个 token 只激活 370 亿;Qwen3 系列的旗舰 Qwen3-235B-A22B 总参数 2350 亿,只激活 220 亿。

MoE 的细节今天不展开,知道它替换的是 Block 里 FFN 那一块就够了。

从最后一层到 logits

向量穿过全部 N 层 Block 后,还差两步才能变成下一个 token:

  1. 先过最后一次 RMSNorm,把数值分布再稳一遍
  2. 再过 lm_head,把向量从隐藏维度映射到词表维度,Qwen3 的词表大小是 151936

lm_head 是 language model head 的缩写,直译是语言模型的输出头。它本身只是一个线性层,也就是一个 151936×1024 的矩阵,不带别的计算。输入的 1024 维向量和这个矩阵相乘,相当于拿它分别和矩阵的每一行做点积;矩阵有 151936 行,每行对应词表里的一个 token,算出来的 151936 个点积就是这一轮的输出。

lm_head 的每一行可以理解为对应 token 的代表向量,点积越大,说明隐藏向量和这个 token 越像。模型挑下一个 token 的过程,本质上又是一次匹配打分,和注意力分数的思路一脉相承。

既然 lm_head 的每一行是 token 的代表向量,嵌入矩阵的每一行也是,这两份参数能不能干脆共用?Qwen3-0.6B 就是这么做的:它的 lm_head 和嵌入层共享同一个矩阵,这个设计叫权重绑定(weight tying),嵌入矩阵转置一下直接当输出层用,省掉一份 151936×1024 的参数。对小模型来说绑定是常见的做法。

lm_head 的输出叫 logits(未归一化分数):词表里每个候选 token 各得一个分数。分数本身还不是概率,要再过一次 softmax 才变成概率分布。实际生成时,推理框架会按温度、top-p 这些采样策略从分布里挑一个 token,拼到输入末尾,然后开始下一轮前向传播。

hidden-to-logits.png

再看 Qwen3-0.6B 的完整结构

Qwen3-0.6B 参数量小、结构标准,很适合拿来对照。我们继续以它为例,看看上面讲的各个组件在真实模型中是什么样的。

from transformers import AutoModelForCausalLM

model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-0.6B")
print(model)

输出如下,每个 Block 的内容相同,这里只展开第一个:

Qwen3ForCausalLM(
  (model): Qwen3Model(
    (embed_tokens): Embedding(151936, 1024)
    (layers): ModuleList(
      (0-27): 28 x Qwen3DecoderLayer(
        (self_attn): Qwen3Attention(
          (q_proj): Linear(in_features=1024, out_features=2048, bias=False)
          (k_proj): Linear(in_features=1024, out_features=1024, bias=False)
          (v_proj): Linear(in_features=1024, out_features=1024, bias=False)
          (o_proj): Linear(in_features=2048, out_features=1024, bias=False)
          (q_norm): Qwen3RMSNorm((128,), eps=1e-06)
          (k_norm): Qwen3RMSNorm((128,), eps=1e-06)
        )
        (mlp): Qwen3MLP(
          (gate_proj): Linear(in_features=1024, out_features=3072, bias=False)
          (up_proj): Linear(in_features=1024, out_features=3072, bias=False)
          (down_proj): Linear(in_features=3072, out_features=1024, bias=False)
          (act_fn): SiLU()
        )
        (input_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
        (post_attention_layernorm): Qwen3RMSNorm((1024,), eps=1e-06)
      )
    )
    (norm): Qwen3RMSNorm((1024,), eps=1e-06)
    (rotary_emb): Qwen3RotaryEmbedding()
  )
  (lm_head): Linear(in_features=1024, out_features=151936, bias=False)
)

对照今天讲的内容,逐行认一下:

  • embed_tokens:嵌入层,把词表里 151936 个 token 各映射成 1024 维向量,上一篇的主角
  • layers:28 个 Transformer Block 叠在一起,(0-27): 28 x 表示同一结构重复 28 次
  • q_proj / k_proj / v_proj:Query、Key、Value 的三个投影矩阵
  • q_proj 输出 2048 而 k_proj、v_proj 输出 1024:2048 = 16 头 × 128 维,1024 = 8 头 × 128 维。这组数字就是 GQA 的直接证据,16 个查询头配 8 组 K/V
  • o_proj:多头结果拼接后的输出投影,把 2048 维压回 1024 维
  • q_norm / k_norm:Qwen3 在 Q 和 K 上额外加的小 RMSNorm,用来稳定训练
  • gate_proj / up_proj / down_proj 加 SiLU:SwiGLU 结构的三件套,中间维度 3072
  • input_layernorm / post_attention_layernorm:Pre-Norm 结构里的两个 RMSNorm,分别在注意力和 FFN 之前
  • rotary_emb:RoPE 位置编码的实现,上一篇讲过
  • norm:所有 Block 走完之后最后一次归一化
  • lm_head:1024 维到 151936 维的线性映射,输出 logits

再顺手跑一次前向传播,看看 logits 长什么样:

import torch
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")
inputs = tokenizer("我爱吃苹果", return_tensors="pt")

with torch.no_grad():
    outputs = model(**inputs)

print(outputs.logits.shape)

结果如下:

torch.Size([1, 3, 151936])

输出形状的最后一维 151936 就是词表大小,中间一维 3 是这次分词得到的 token 数。每个位置都有一份完整的词表分数,但自回归生成只取最后一个位置的 logits 来决定下一个 token,前面位置的结果是顺带算出来的。

这里埋个彩蛋:这些被扔掉的分数并不是废品。后面讲到推理加速的时候,会有一项技术专门把它们捡起来当验收标准用,一次前向就能验好几个 token,到时候记得回来看这一行。

小结

今天我们把一个向量序列从嵌入层到 logits 的完整旅程走完了:

  1. Transformer Block 结构:现代 Block 从原始 Transformer 的解码器演化而来,拿掉了交叉注意力,剩下注意力和前馈网络两段。骨架上有三个关键设计:残差连接给信息和梯度留了一条直通旁路,深层网络才训得动;RMSNorm 按均方根做等比缩放,把数值拉回稳定范围;Pre-Norm 把归一化放在子层之前,让残差旁路畅通。主流模型的 Block 都是这套组合,整个模型就是几十个 Block 叠起来
  2. 注意力机制:每个 token 通过三个投影矩阵得到 Query、Key、Value,Q 和 K 的点积给出 token 之间的注意力分数,再按分数对所有 token 的 Value 加权求和,token 之间的信息交换就完成了
  3. 因果掩码:分数矩阵上三角置为负无穷,保证每个位置只能看到自己和左边的 token,训练和生成行为一致
  4. 注意力头的演进:MHA 到 MQA 到 GQA 再到 DeepSeek 的 MLA,一路都在压缩 KV 缓存,用更小的显存换尽量不掉的质量
  5. FFN 与 SwiGLU:对每个 token 单独加工的两层 MLP,先放大再压回,中间靠激活函数引入非线性;现在主流用带门控的 SwiGLU。FFN 占了模型约三分之二的参数,可以解读成模型的键值记忆库;MoE 版本把参数和计算解耦,每次只激活部分专家,DeepSeek、Qwen 的大模型都在用
  6. logits:最后一层出来后再过 RMSNorm 和 lm_head。lm_head 本质是一个词表大小的矩阵,每行是一个 token 的代表向量,输出就是隐藏向量和每个 token 的匹配分数,下一个 token 从这些分数里采出来

不过这里藏着一个小问题。今天我们一直在描述一遍前向传播,但生成是逐 token 进行的:每生成一个新 token,都要把变长了一位的整段序列重新送进模型。如果每一步都把历史 token 的 K、V 从头重算一遍,序列越长算得越慢,而且绝大部分计算是完全重复的。这个浪费怎么消除,就是下一篇的主角 KV Cache。我们明天继续。

参考


学习大模型推理的嵌入与位置编码

在上一篇中,我们看了分词器如何用 BPE 算法把一句话切成子词,再映射成一串整数,也就是 token id 序列。这串整数是分词阶段的终点,却不是模型计算的起点。

token id 说到底只是编号,和字典里每个词条的序号没有区别,编号本身不带任何语义信息。模型真正处理的是向量。今天这篇就来讲 token id 之后发生的事:它怎么先被嵌入层变成稠密向量,又怎么被位置编码注入顺序信息,最后才进入 Transformer 层参与计算。

嵌入层查表

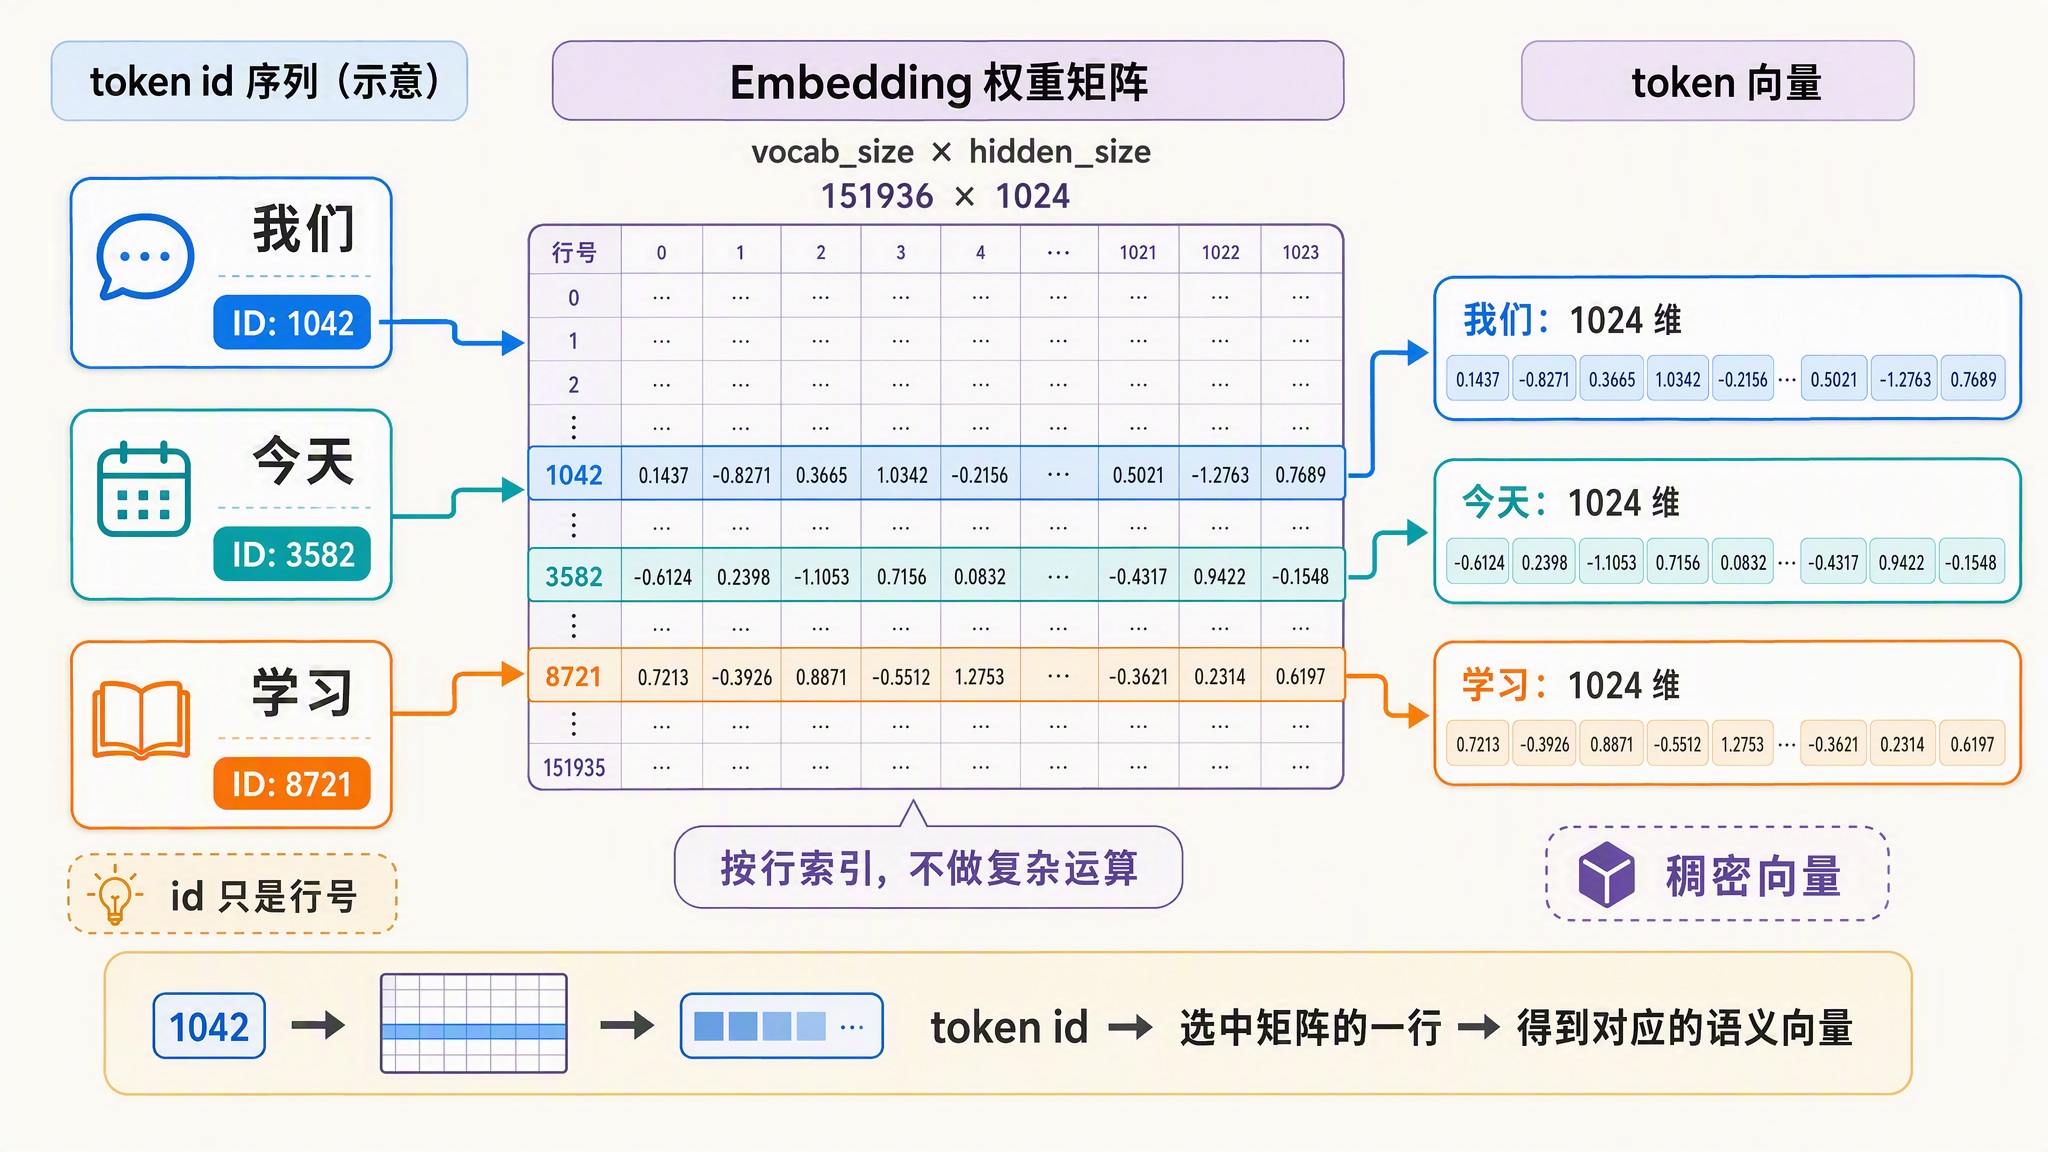
嵌入(Embedding) 是把离散的 token id 映射为连续向量的过程。它的实现非常直接:就是一张形状为 vocab_size × hidden_size 的二维矩阵,每一行对应词表里一个 token 的向量。token id 进来,按行号取出对应那一行,查表完成,没有任何复杂运算。

以 Qwen3-0.6B 为例,它 config 里的 vocab_size 是 151936,隐藏层维度是 1024,所以嵌入矩阵就是一个 151936 行、1024 列的浮点数表格。上一篇讲过,这个 vocab_size 比词表实际条目略多,多出来的是对齐预留位,不影响查表。每个 token 被表示成一个 1024 维的稠密向量(Dense Vector),即每个维度都是一个实数、没有大量零元素的向量。

embedding-lookup.jpg

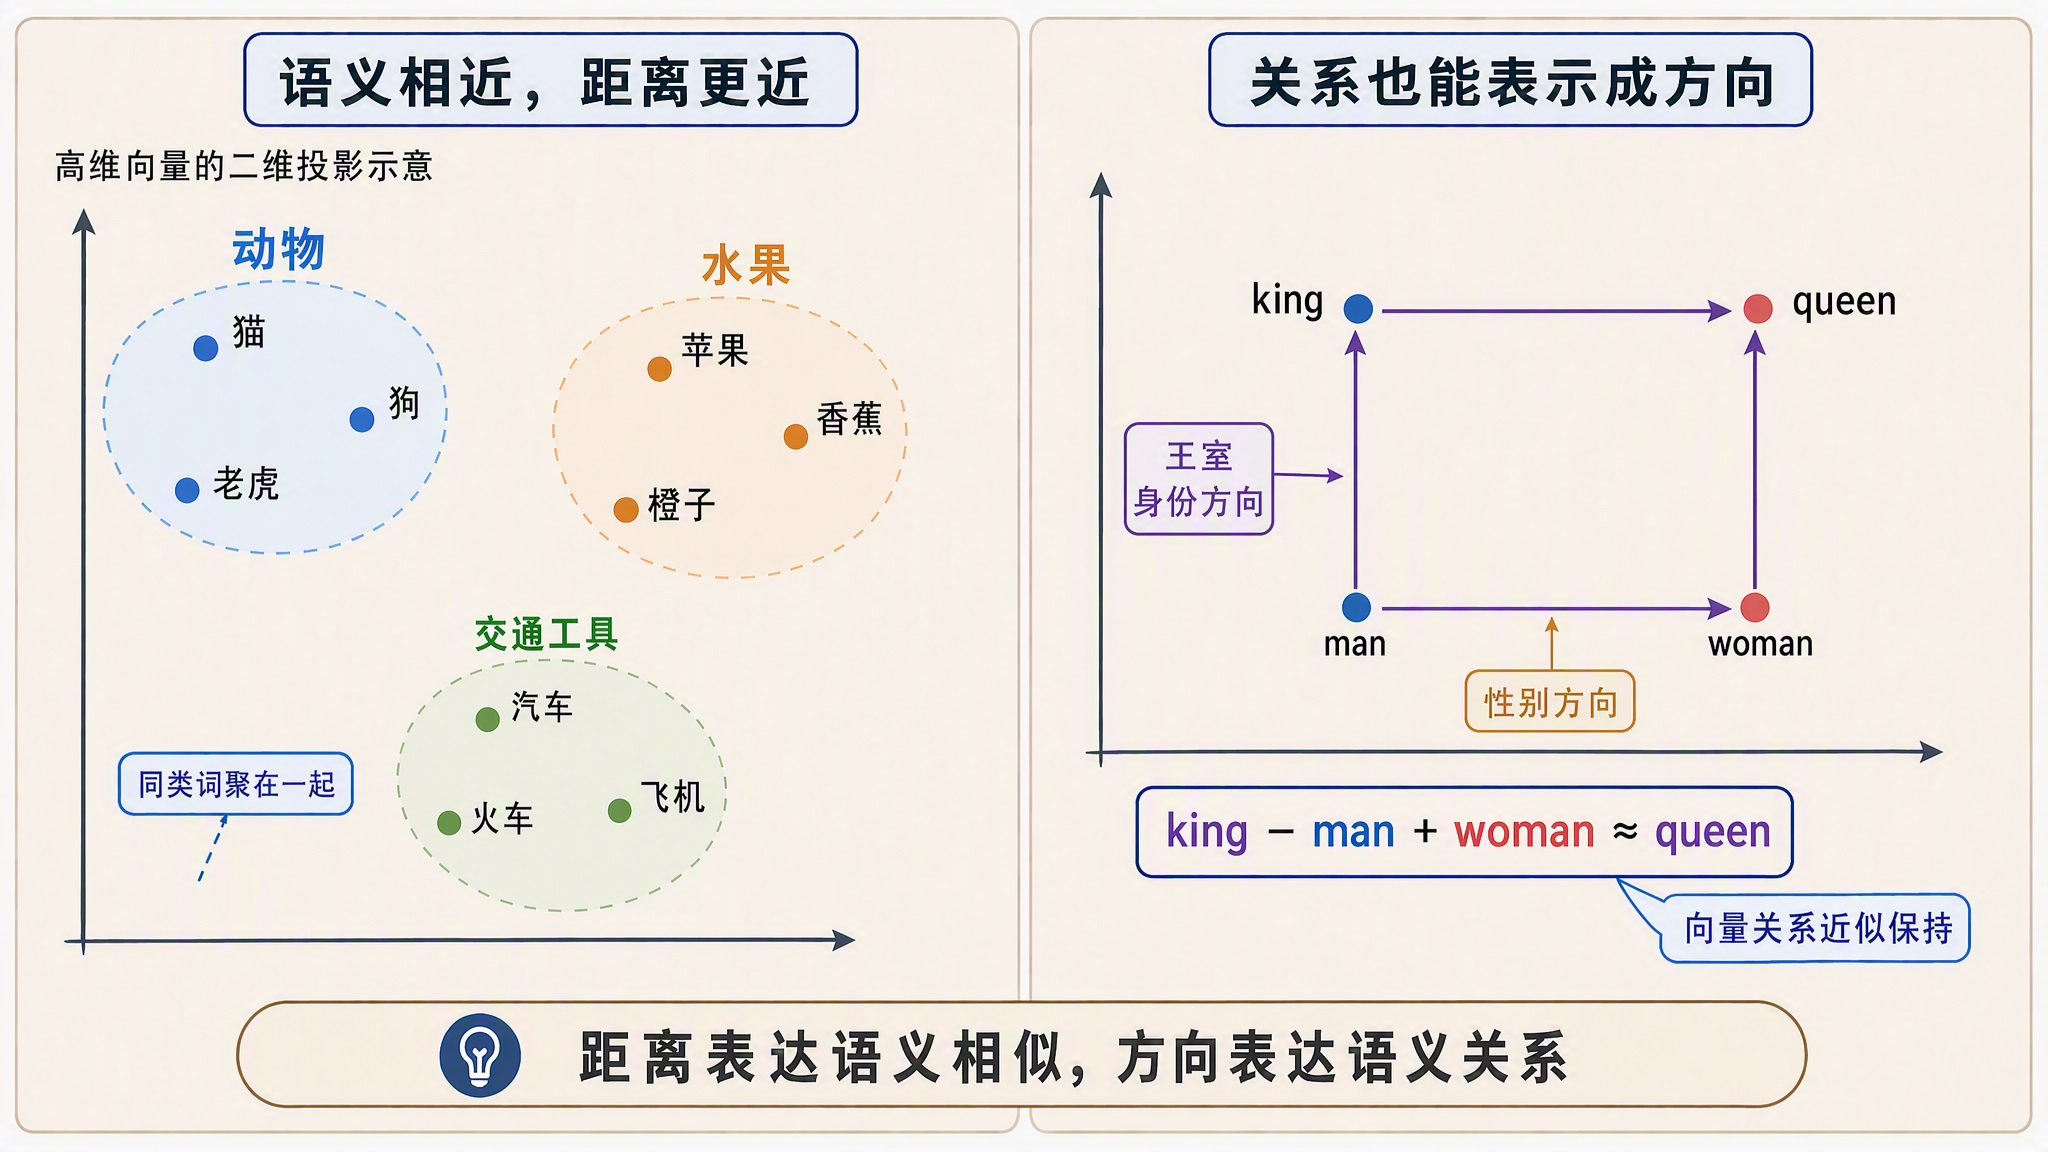
这张表是在训练过程中和模型其他参数一起学出来的。学出来的结果有一个著名性质:语义相近的词,向量在空间中也相近。这就是词向量(Word Embedding) 的语义性。2013 年 Mikolov 等人提出 word2vec,论文里给出了一个流传至今的例子:

king - man + woman ≈ queen

对 king 的向量减去 man 的向量、加上 woman 的向量,结果最接近的词是 queen。这说明向量里编码了性别、王室身份这类语义维度,词与词的关系变成了可以计算的向量运算。他们在随后的另一篇论文里用词类比任务对这类线性关系做了系统研究,比如国家与首都、形容词比较级、动词时态都能用向量加减算出来。

词向量在语义空间里的分布大致如下图所示:

word-vector-space.jpg

要注意的是,大模型词表里的单位是子词(subword)而不是完整的词,像 unbelief 会被拆成 un、belief 两个 token,各有各的向量。所以现代模型的嵌入表更像是子词向量表,词一级的语义靠模型后续层组合出来。

动手看看嵌入矩阵

下面我们通过一个简单的示例来体验下。用 Hugging Face transformers 加载 Qwen/Qwen3-0.6B,直接看它的嵌入层:

import torch
from transformers import AutoModelForCausalLM

model_name = "Qwen/Qwen3-0.6B"
model = AutoModelForCausalLM.from_pretrained(model_name, dtype=torch.float32)

# 输入嵌入层,本质就是一个 nn.Embedding
emb = model.get_input_embeddings()
print(emb.weight.shape)

输出:

torch.Size([151936, 1024])

可以看到,形状正是 vocab_size × hidden_size。词表里 15 万多个 token,每个都有自己专属的一行向量。

再验证一下语义性。取两组词算余弦相似度(Cosine Similarity),它衡量两个向量方向的接近程度,取值在 -1 到 1 之间,越接近 1 表示越相似:

import torch.nn.functional as F
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained(model_name)

def vec(word):
    # 这几个词都是单个 token,直接取出对应行的向量
    token_id = tokenizer.encode(word, add_special_tokens=False)[0]
    return emb.weight[token_id]

pairs = [("猫", "狗"), ("猫", "汽车")]
for a, b in pairs:
    sim = F.cosine_similarity(vec(a), vec(b), dim=0)
    print(f"{a} vs {b}: {sim.item():.4f}")

输出:

猫 vs 狗: 0.4233
猫 vs 汽车: 0.1562

「猫」和「狗」同为动物,向量方向明显比「猫」和「汽车」更接近。词向量的语义是统计意义上的相近,绝对数值谈不上大,但相对关系是清楚的。

注意力不知道顺序

嵌入向量解决了语义问题,但还有一个问题没解决:顺序。

大模型的核心是注意力机制,细节我们留到下一篇展开。这里只需要知道一点:注意力计算是把一批向量放在一起两两做点积,它关心的是向量的集合,不关心谁先谁后。把输入顺序打乱,只要还是那几个向量,算出来的结果就不变。这个性质有个专门的名字,叫置换等变(Permutation Equivariance):输入怎么排列,输出就怎么跟着排,计算本身对先后顺序零感知。

口说无凭,我们用 NumPy 手写一个最简注意力验证一下,Q、K、V 投影用随机矩阵代替:

这里的注意力实现做了大量简化,你不需要看懂每一行,注意力机制的细节下一篇会专门展开。现在只需关注实验的设计:同一批向量,打乱顺序送进去,看结果变不变。

import numpy as np

rng = np.random.default_rng(0)
d = 8
Wq, Wk, Wv = (rng.normal(size=(d, d)) for _ in range(3))  # 三个 8×8 投影矩阵

def attention(x):
    # 最简自注意力:softmax(QKᵀ/√d)V
    # @ 是矩阵乘法运算符:(4,8) @ (8,8) -> (4,8),一次算出所有 token 的投影
    # Wq, Wk, Wv 是可学习的参数(真实模型里从训练中学出来,这里用随机矩阵代替)
    q, k, v = x @ Wq, x @ Wk, x @ Wv
    # k.T 是转置,(4,8) @ (8,4) -> (4,4),得到 4 个 query 对 4 个 key 的两两打分表
    scores = q @ k.T / np.sqrt(d)
    # softmax:对每行分数先取 exp 再归一化,转成和为 1 的权重
    # 分数越高的 key 权重越大;减去最大值是为了防止 exp 数值溢出,不改变结果
    scores = np.exp(scores - scores.max(axis=-1, keepdims=True))
    weights = scores / scores.sum(axis=-1, keepdims=True)
    return weights @ v

x = rng.normal(size=(4, d))  # 4 个 token,每个 8 维
out1 = attention(x)

perm = [2, 0, 3, 1]          # 打乱后的 token 顺序
# 花式索引:用数组当下标,按给定顺序取行
# x[perm] 等价于 [x[2], x[0], x[3], x[1]],即打乱语序后的输入
out2 = attention(x[perm])

# argsort 求逆排列:inv[i] 表示原位置 i 的 token 被打乱到了哪里
# out2[inv] 把打乱的输出按原顺序排回去,这样才能和 out1 逐位置对比
inv = np.argsort(perm)
print(f"打乱前后的最大差异: {np.abs(out1 - out2[inv]).max():.2e}")

输出:

打乱前后的最大差异: 1.78e-15

打乱后每个位置的输出,和它原来位置的输出完全一致,差异是 10⁻¹⁵ 级别的浮点误差。注意力确实对顺序没有任何感知。

这会带来一个直观的问题。「狗咬人」和「人咬狗」用的是同样的三个字,分词后 token 集合一样,查出来的向量集合也一样。如果没有位置信息,在注意力看来这两句话完全等价,但它们的含义显然相反。中文是这样,英文里也一样。

所以必须在向量进入 Transformer 之前,把顺序信息注入进去,这就是位置编码(Positional Encoding) 要干的事。早期的循环(RNN)和卷积(CNN)结构天然按顺序读文本,而纯注意力结构本身没有顺序概念,位置信息只能显式注入。位置编码方案的好坏,直接影响模型对语序、指代、因果这类依赖顺序的语言现象的理解能力。

从文本到 Transformer 层的完整链路如下:

position-encoding-pipeline.png

位置编码的做法经历了几次演进,我们按时间线依次看。

正弦绝对位置编码

2017 年的 Transformer 原论文 Attention Is All You Need 用的是正弦位置编码(Sinusoidal Positional Encoding)。做法是给每个位置生成一个固定的向量,偶数维度填正弦值,奇数维度填余弦值,不同维度用不同频率。位置编码的维度和嵌入向量相同(都是论文里的 d_model),所以两者能直接相加,加出来的和就是带进模型的向量。

为什么偏偏是正弦和余弦?我们可以从最直接的想法倒推。给向量注入位置信息,最容易想到三个办法,但每个都有毛病:

  1. 直接用位置编号:把 0、1、2、3 这样的整数塞进向量。数值无界,位置到几千的时候,编号比嵌入值大好几个数量级,训练不稳定
  2. 编号归一化:除以序列长度压到 0 到 1 之间。数值有界了,但同一个值在不同长度的序列里含义不同,0.5 在 10 个词的句子里是第 5 个词,在 1000 个词的句子里是第 500 个词
  3. 二进制编码:把位置写成二进制数,每一位占一个维度。有界、唯一、和序列长度无关,前面几个问题都解决了,但每一位都在 0 和 1 之间硬跳变,不平滑

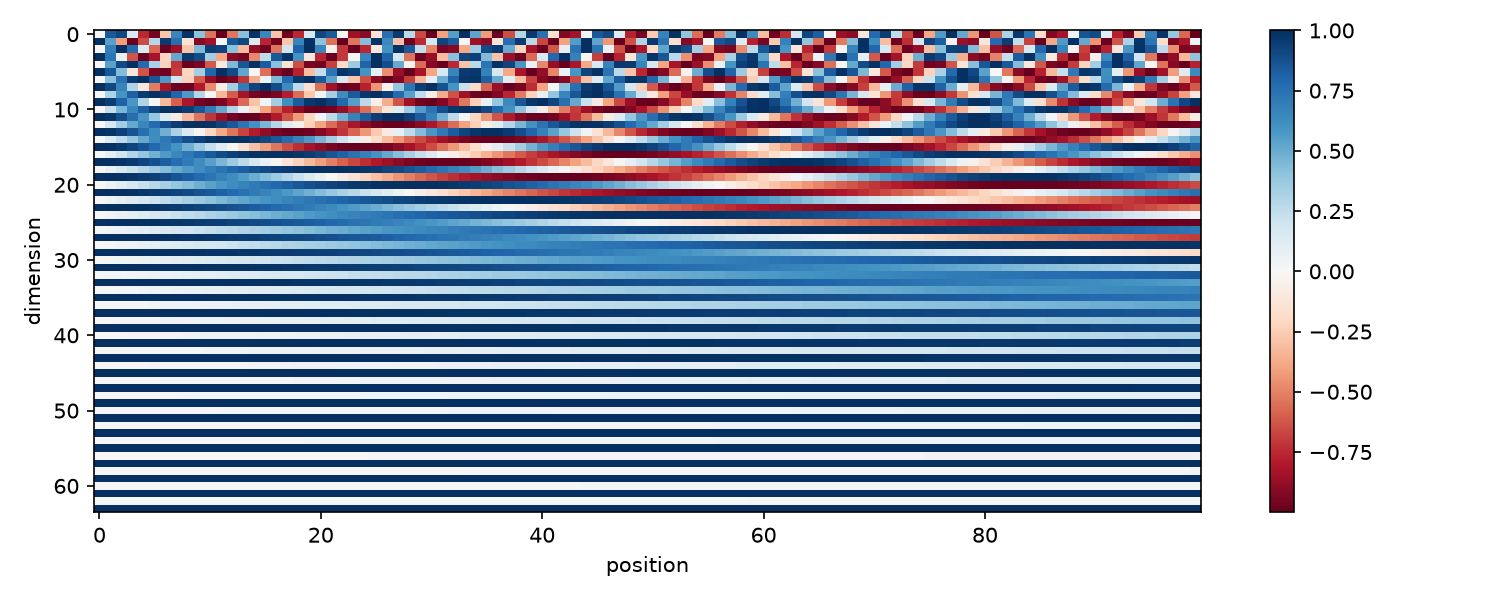
正弦编码可以看成二进制编码的连续版。二进制从低位到高位,翻转周期按 2、4、8、16 翻倍;正弦编码从低维到高维,波长同样按几何级数拉长,区别只是把硬跳换成了平滑的正弦波。

论文里的公式长这样:

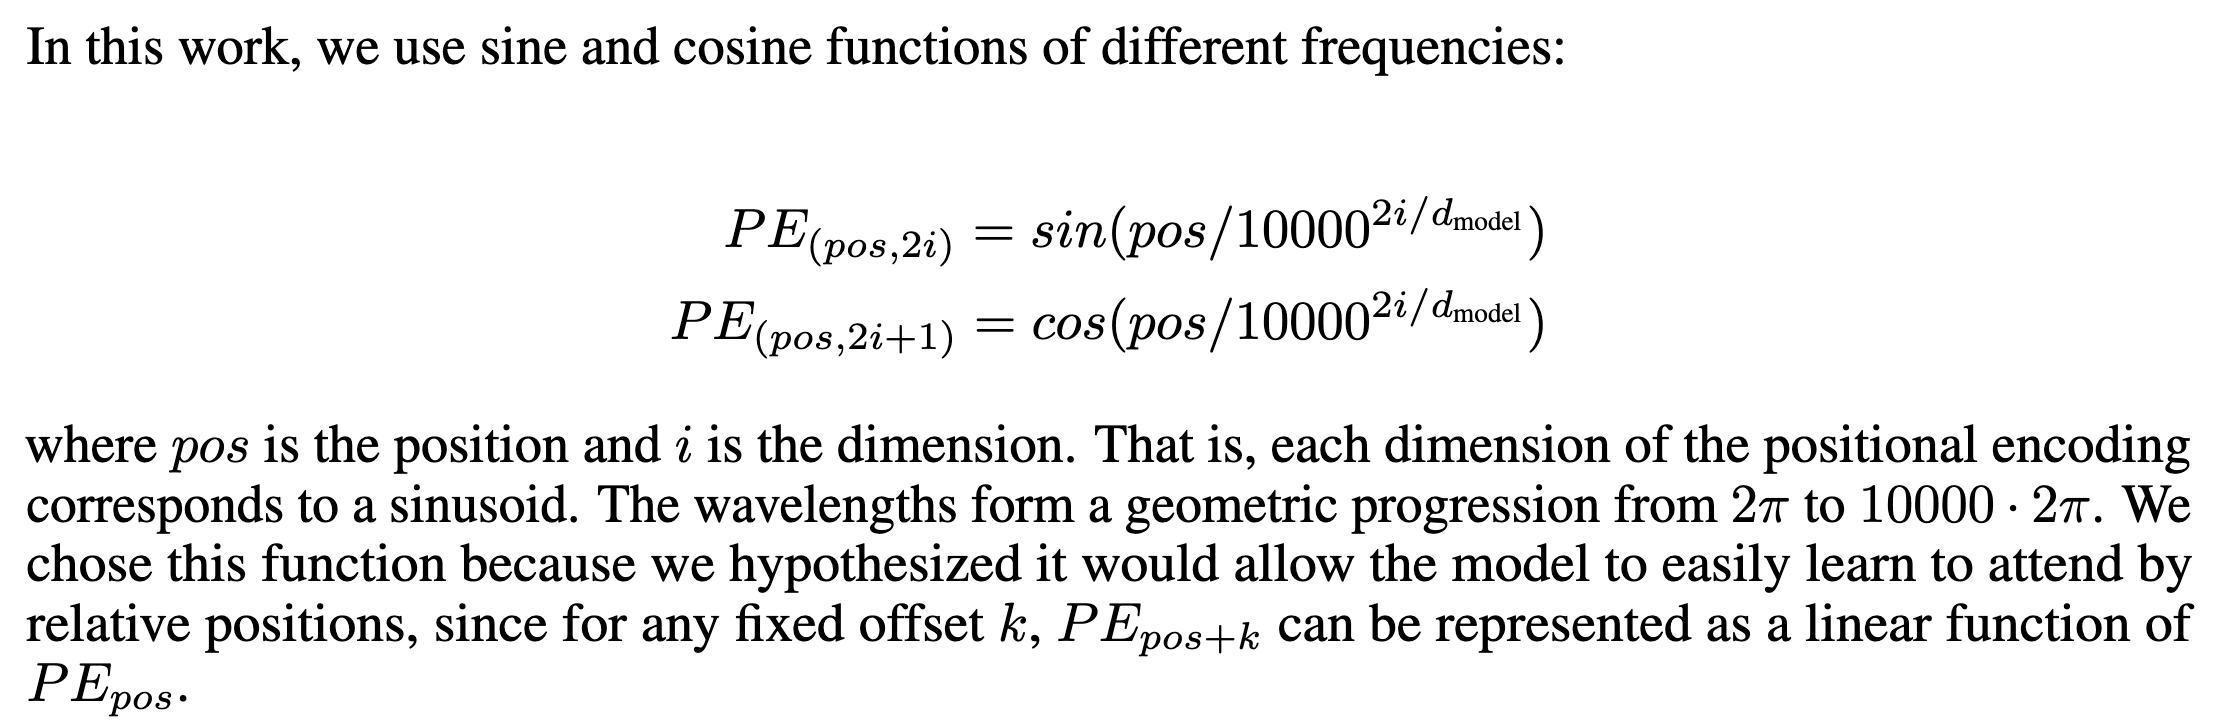
pe.png

公式里 pos 是位置编号,i 是维度编号。关键在分母 10000^(2i/d),把公式换个写法 sin(pos × ω),其中 ω = 1/10000^(2i/d),这个 ω 就是每个维度的频率:ω 越大,pos 每增加 1,正弦波走得越快;ω 越小,波走得越慢。维度编号 i 越大,指数越大,ω 就越小。以 8 维为例,四个维度对的频率和波长如下:

维度对 i频率 ω波长(约多少个位置)
016.3
10.163
20.01628
30.0016283

频率按 ω = 1/10000^(2i/d) 代入 i 和 d=8 算出;波长是波形走完一个周期需要的位置数,即 2π/ω。10000 恰好是 10⁴,d=8 时分母正好是 10 的整数次幂,所以数字格外整齐。

这就像钟表:秒针转得快,用来分辨相邻的秒;时针转得慢,用来定位大致在几点。只看一根针会有歧义,所有维度合起来,每个位置才有独一无二的指纹。

sinusoidal-position-encoding.png

论文中的两行公式看着唬人,代码实现其实很简单。我们用一个 8 维的迷你版本,把前几个位置的编码算出来看看:

import math

def sinusoidal_pe(pos, d_model=8):
    # 偶数维度填 sin,奇数维度填 cos,频率随维度指数下降
    return [
        math.sin(pos / 10000 ** (i / d_model)) if i % 2 == 0
        else math.cos(pos / 10000 ** ((i - 1) / d_model))
        for i in range(d_model)
    ]

for pos in range(4):
    print(f"位置 {pos}:", [round(x, 2) for x in sinusoidal_pe(pos)])

# 对比一下相邻位置和相隔很远的位置,编码差多少
def dist(a, b):
    return math.sqrt(sum((x - y) ** 2 for x, y in zip(a, b)))

for pos in list(range(1, 11)) + [100, 1000]:
    print(f"位置 0 和 {pos} 的距离:", round(dist(sinusoidal_pe(0), sinusoidal_pe(pos)), 2))

# 同样的间隔,换个起点再算一遍
for gap in [1, 5, 100]:
    a = dist(sinusoidal_pe(0), sinusoidal_pe(gap))
    b = dist(sinusoidal_pe(100), sinusoidal_pe(100 + gap))
    print(f"间隔 {gap}: 起点 0 算得 {a:.4f}, 起点 100 算得 {b:.4f}")

输出:

位置 0: [0.0, 1.0, 0.0, 1.0, 0.0, 1.0, 0.0, 1.0]
位置 1: [0.84, 0.54, 0.1, 1.0, 0.01, 1.0, 0.0, 1.0]
位置 2: [0.91, -0.42, 0.2, 0.98, 0.02, 1.0, 0.0, 1.0]
位置 3: [0.14, -0.99, 0.3, 0.96, 0.03, 1.0, 0.0, 1.0]
位置 0 和 1 的距离: 0.96
位置 0 和 2 的距离: 1.69
位置 0 和 3 的距离: 2.02
位置 0 和 4 的距离: 1.86
位置 0 和 5 的距离: 1.3
位置 0 和 6 的距离: 0.66
位置 0 和 7 的距离: 0.98
位置 0 和 8 的距离: 1.7
位置 0 和 9 的距离: 2.14
位置 0 和 10 的距离: 2.15
位置 0 和 100 的距离: 2.21
位置 0 和 1000 的距离: 2.4
间隔 1: 起点 0 算得 0.9641, 起点 100 算得 0.9641
间隔 5: 起点 0 算得 1.2962, 起点 100 算得 1.2962
间隔 100: 起点 0 算得 2.2097, 起点 100 算得 2.2097

从运行结果我们可以看到三个规律。一是不同维度的变化速度不同:前两个维度变得最快,位置每加 1 数值就明显不同;越靠后的维度变得越慢,最后一对几乎不动,和上面的频率表完全对得上。二是编码距离只和间隔有关,和起点无关:间隔同为 1,位置 0 到 1 和位置 100 到 101 算出的距离都是 0.9641,间隔 100 时两个起点都算得 2.2097。这不是巧合,用差角公式可以严格证明:每个维度对对距离平方的贡献是 2(1 − cos(ωk)),只含间隔 k,不含起点。也就是说,正弦编码的距离结构天生就是相对的。三是距离随间隔先升后饱和,不是越远越大:间隔从 1 到 3 距离升到 2.02,间隔 5 又回落到 1.30,间隔 1000 也只有 2.4,之后就在这个量级振荡,不再持续增大。原因还是周期性:每个维度对的贡献最大只有 4,波形转完一圈还会回来,合起来的距离自然有界。不过有界不等于撞车:两个不同位置的编码只是距离有上限,并不会变得相同,慢速维度上总差着一截。多频率组合保证的是每个位置的编码独一无二,而不是距离随间隔无限拉大。

不过这样看还不够直观,我们可以把更多位置和维度画成一张热力图:

import numpy as np
import matplotlib.pyplot as plt

d_model, max_pos = 64, 100
positions = np.arange(max_pos)[:, None]
omega = 1 / 10000 ** (2 * np.arange(d_model // 2) / d_model)
angles = positions * omega                    # (100, 32) 个角度

pe = np.zeros((max_pos, d_model))
pe[:, 0::2] = np.sin(angles)                  # 偶数维度填 sin
pe[:, 1::2] = np.cos(angles)                  # 奇数维度填 cos

plt.figure(figsize=(10, 4))
plt.imshow(pe.T, aspect="auto", cmap="RdBu")
plt.xlabel("position")
plt.ylabel("dimension")
plt.colorbar()
plt.show()

生成的图如下所示:

sinusoidal-heatmap.png

横轴是位置,纵轴是维度。低维区域条纹细密,波形高频振荡;高维区域几乎一整片不变,波长极长。每一列就是一个位置 64 个维度取值的组合,任意两列都不相同,这就是每个位置的指纹。

正弦位置编码有两个特点。一是不需要学习参数,公式直接算出来;二是位置之间存在数学上的线性关系:位置 pos + k 的编码等于位置 pos 的编码乘上一个只和 k 有关的矩阵,效果是把每个维度对旋转 k×ωᵢ 角度,模型有机会学出相对位置的概念。

这个线性关系用三角恒等式展开就能看到,对频率为 ω 的维度对:

sin-cos-pair.png

k 固定时,cos(ωk) 和 sin(ωk) 都是常数,所以 pos + k 的编码恰好是 pos 的编码在每个维度对上旋转 ωk 角度:

sin-cos-pair-2.png

不过它是绝对位置编码(Absolute Positional Encoding),每个位置的编码只跟自己的序号有关,加在语义向量上之后,语义和位置混在同一个向量空间里。

RoPE 旋转位置编码

现在主流的开源模型,包括 Qwen、Llama、DeepSeek、Gemma 等,用的都是 RoPE(Rotary Positional Embedding,旋转位置编码)。它由苏剑林在 2021 年的 RoFormer 论文中提出,论文标题是 Enhanced Transformer with Rotary Position Embedding。

上一节我们看到,正弦编码里位置平移 k 等价于把每个维度对旋转一个固定角度。RoPE 把这个关系反过来用:不给嵌入向量加位置信息,而是直接按位置旋转向量。注意力机制里,每个 token 的向量会被变换成 query 和 key 两种角色,靠它们的内积来两两打分。RoPE 的做法是把 query 和 key 向量按维度两两分组,每一组看成一个二维平面上的小箭头。位置为 m 的 token,把它的每组箭头都旋转一个与 m 成正比的角度,位置越靠后,转得越多。不同维度组的旋转速度不一样,类似钟表上时针、分针、秒针各转各的,所有维度组的旋转速度由同一个基底频率推出来。要注意旋转只发生在每层注意力的 query 和 key 上,嵌入层出来的向量本身不动。

旋转的效果如下图所示:

rope-rotation.png

旋转操作用矩阵写出来,就是线性代数里标准的二维旋转矩阵,每个维度对各乘一个:

R(θ) = [ cos θ  −sin θ ]
       [ sin θ   cos θ ]

角度 θ = m × ωᵢ,由 token 的位置 m 和这个维度对的频率 ωᵢ 共同决定,位置越靠后,角度越大。是不是很眼熟?和上一节正弦编码用的是一样的思想,区别只在:正弦编码把 sin、cos 的值直接加到嵌入向量上,RoPE 把它们组成旋转矩阵乘在 query 和 key 上。

为什么这样做有效?关键在于注意力算的是 query 和 key 的内积,而两个向量各自旋转之后,它们的内积只取决于转过的角度差。位置 m 的 query 和位置 n 的 key,内积里自动带上了 m - n 这个相对位置。模型不用关心每个 token 的绝对序号,就能知道两个 token 之间隔了多远。相对位置信息就这样自然地进了注意力分数。

我们可以用代码验证一下「内积只取决于角度差」:

def rotate(x, y, pos, omega=1.0):
    # 把二维箭头 (x, y) 按位置旋转 pos * omega 角度
    angle = pos * omega
    return (x * math.cos(angle) - y * math.sin(angle),
            x * math.sin(angle) + y * math.cos(angle))

def dot(a, b):
    # 二维向量的点积(内积):对应分量相乘再求和
    # 几何意义是 |a| × |b| × cos(夹角),方向越一致点积越大
    return a[0] * b[0] + a[1] * b[1]

q = (1.0, 0.0)
k = (0.8, 0.6)

# 两组不同的绝对位置,相对距离都是 2
print(round(dot(rotate(*q, 5), rotate(*k, 3)), 4))
print(round(dot(rotate(*q, 50), rotate(*k, 48)), 4))

# 相对距离变成 5,分数跟着变
print(round(dot(rotate(*q, 5), rotate(*k, 0)), 4))

输出:

0.2127
0.2127
-0.3484

前两个数一模一样:query 在位置 5、key 在位置 3,和 query 在位置 50、key 在位置 48,只要相对距离都是 2,注意力打出的分完全相同,绝对位置被旋转消掉了。第三个数说明相对距离一变,分数立刻跟着变。这里只看了一对维度,真实的 RoPE 是多对维度各自按不同速度旋转,总内积是所有维度对的结果之和,每一对都只和 m - n 有关。

实现时有一个细节:维度配对有两种方式,GPT-J 式的相邻配对(第 0、1 维一组,第 2、3 维一组)和 GPT-NeoX、Llama 式的前后半配对(第 0 维和第 d/2 维一组)。两者只是维度排列顺序不同,数学上完全等价,内积结果不受影响。

将 RoPE 和正弦绝对位置编码放在一起做个对比:

对比项正弦绝对位置编码RoPE
作用对象加在嵌入向量上旋转 query 和 key 向量
位置类型绝对位置内积中自然体现相对位置
可学习参数无无
语义与位置混在同一向量空间各走各的通道
典型使用者2017 年原始 TransformerQwen、Llama、DeepSeek 等

和正弦编码相比,RoPE 不是把位置向量加到嵌入上,而是直接作用在注意力的 query、key 上,语义向量和位置信息互不污染。加上实现简单、没有额外参数,它很快成了新模型的默认选择。苏剑林本人的博客科学空间上有一系列推导文章,想深入数学细节的同学可以去读。英文资料推荐 EleutherAI 的 Rotary Embeddings: A Relative Revolution,它从「内积只依赖相对位置」这个设计目标出发反推出旋转形式,他们的实验还发现 RoPE 的训练收敛更快。

RoPE 还有一个性质很符合直觉:两个 token 的相对距离越远,旋转带来的内积差异越杂乱,注意力分数整体呈衰减趋势。也就是说,模型天然更关注离自己近的 token。这种预先写进模型结构里的倾向叫归纳偏置(Inductive Bias),它和自然语言的局部性是一致的。

这个衰减趋势也可以用代码验证。取一个最干净的情形:q 和 k 在每个维度对上都是同向的单位向量,旋转后的内积就等于各维度对 cos((m − n) × ωᵢ) 之和,直接看它随距离的变化:

import numpy as np

d = 128
omega = 1 / 10000 ** (2 * np.arange(d // 2) / d)  # 64 个维度对的频率

for dist in [0, 1, 5, 10, 20, 50, 100, 200, 400]:
    score = np.cos(dist * omega).sum() / (d // 2)  # 归一化,满值为 1
    print(f"距离 {dist}: {score:.3f}")

输出:

距离 0: 1.000
距离 1: 0.970
距离 5: 0.737
距离 10: 0.669
距离 20: 0.608
距离 50: 0.546
距离 100: 0.477
距离 200: 0.306
距离 400: 0.278

距离 0 时内积满值 1,距离拉到 400 时降到 0.28,一路往下。真实的 q、k 方向各异,曲线会有波动,但衰减的整体趋势一致。

其他位置编码

除了正弦编码和 RoPE 这两条线,历史上还有两条路线也简单了解下。BERT 和早期的 GPT 用的是学习式绝对位置编码(Learned Absolute Positional Embedding),给每个位置编号也配一张可训练的查表,和词嵌入一样从数据里学。其实 Transformer 原论文就对比过这条路线,实验发现学习式和正弦版的效果几乎一样,最后选正弦版是出于一个前瞻考虑:公式编码有可能外推到比训练时更长的序列。学习式有个绕不过去的限制:表的长度在训练时就定死了,想支持更长的文本就得重新学,灵活性不如公式编码,后来主流模型基本都放弃了这条路线。

另一条是 ALiBi(Attention with Linear Biases,线性偏置注意力),论文标题叫 Train Short, Test Long。它不改任何向量,直接在注意力分数上减去一个和距离成正比的惩罚项,距离越远扣分越多,把「优先关注近处」写死在公式里。BLOOM、MPT 等模型采用过它,长度外推表现不错,但长程依赖场景下不如 RoPE 灵活,近年的新模型里已经很少见了。

几种代表性方案讲完,回过头总结下,一个好的位置编码应该满足下面这些条件:

  • 唯一性:每个位置要有独一无二的编码,不同位置不能撞车
  • 有界性:编码数值要有界,不能随位置编号无限膨胀,否则会淹没语义信息
  • 相对性:模型关心的往往是两个词隔多远,编码最好能表达相对距离
  • 可外推:训练时没见过的更长序列,推理时编码依然合理
  • 确定性:同样的位置永远算出同样的编码

用这几条标准对照一遍:学习式编码输在可外推,表长训练时就定死了;ALiBi 把相对性简化成线性距离惩罚,换来了外推,牺牲了长程依赖的灵活性;正弦编码五条都满足,但相对位置藏在加法里,要靠模型自己学出来;RoPE 也是五条都满足,相对位置还直接进了内积,这就是它成为主流的原因。

位置编码与上下文长度

位置编码还决定了一件工程上很实际的事:模型能处理多长的上下文。

训练时模型只见过有限范围内的位置。比如训练最大长度是 4096,那么 RoPE 里超出 4096 的旋转角度模型从没见过。推理时硬塞更长的文本,注意力分数会乱掉,生成质量明显下降。这就是位置编码的外推(Extrapolation) 问题,即模型在训练长度之外的表现。

我们看 Qwen3-0.6B 的配置里和位置相关的两个字段:

print(model.config.max_position_embeddings)
print(model.config.rope_parameters["rope_theta"])  # transformers 4.x 里是 config.rope_theta

输出:

40960
1000000

其中 max_position_embeddings 是模型位置编号的上限,Qwen3-0.6B 这里是 40960,比官方标称的 32K 原生上下文略留了余量。rope_theta 就是上一节说的那个基底频率,各维度组的旋转速度都由它推出来,Qwen3 把它从早期模型常用的 10000 调大到了 1000000,让高频维度的旋转放缓,为长上下文留余地。

围绕外推问题有一系列改进方法。位置插值(Position Interpolation,PI) 把长文本的位置等比压缩回训练窗口内;NTK-aware 缩放 调整 RoPE 的基底频率,让不同转速的维度组得到不同程度的拉伸。NTK 这个名字来自神经正切核(Neural Tangent Kernel) 的理论启发,最早是 Reddit 上的一篇社区帖子提出的。YaRN 名字是 Yet another RoPE extensioN 的缩写。它在 NTK 思路上对高频和低频分量区别处理,再加一个注意力温度系数,用少量微调就能把上下文窗口扩到训练长度的好几倍。YaRN 论文里把 LLaMA 系列扩到了 128K。Qwen3 官方也说明了通过 YaRN 可以把上下文从 32K 扩到 128K。这些方法涉及不少公式和细节,我们这里就点到为止了,感兴趣的同学可以进一步查阅相关资料。

小结

今天我们学习了 token id 之后的第一步:

  1. 嵌入层是一张 vocab_size × hidden_size 的查表,把 token id 变成稠密向量;训练让语义相近的词向量相近,经典的 king - man + woman ≈ queen 就是这种语义性的体现
  2. 动手用 Qwen3-0.6B 验证了嵌入矩阵的形状,并用余弦相似度对比了语义相近词与无关词的差异
  3. 注意力是置换等变的,本身不包含顺序信息,我们用 NumPy 最简注意力做了实验:打乱输入,输出只是跟着重排,逐位置的值完全不变
  4. 好的位置编码有五条标尺:唯一、有界、能表达相对距离、可外推、确定。正弦编码可以看成二进制编码的连续版,用一组几何级数的频率给每个位置生成独一无二的指纹
  5. RoPE 把「旋转」从正弦编码的副产品变成了主角:按位置旋转 query 和 key,让相对位置自然体现在内积里,我们还用代码验证了它的距离衰减性质
  6. 位置编码限制了上下文长度,位置插值、NTK、YaRN 等方法通过调整位置或旋转频率做长度外推

向量准备好了,位置信息也注入进去了,接下来就是真正的计算核心:这些向量进入 Transformer 层之后,注意力机制到底是怎么两两打分的,前向传播的完整数据流又长什么样。我们明天继续。

参考


学习大模型推理的分词:从文本到 Token

在上一篇中,我们把一次请求的完整旅程走了一遍,画出了整个系列的地图:你敲下的一句话先经过分词变成 token 序列,然后模型在 Prefill 阶段一口气读完问题,接着进入 Decode 循环一个 token 一个 token 地生成回答,每一步还要经过采样挑出下一个词,最后反分词把 token 还原成文字流式返回给你。

今天我们从地图的第一站开始,把分词这个环节单独拿出来学习。

为什么需要分词

神经网络的计算基本都是矩阵乘法,输入必须是一串数字。但用户给的是自然语言文本,中间需要一座桥把文字翻译成数字,这座桥就是分词(Tokenization)。分词做两件事:先把文本切成一个个片段,每个片段叫一个 token;再查一张对照表,把每个 token 换成一个整数编号,也就是 token id。

这张对照表叫词表(Vocabulary),它在模型训练之前就定好了,训练完成后固定不变。词表里的每个 id 对应模型嵌入层里的一行向量,模型实际读进去的就是这些向量。嵌入层的内容我们留到下一篇讲,今天只需要知道 id 是文本和模型之间的中间货币。

光说对照表可能有点抽象,直接打开它看看。用 Hugging Face transformers 库的 AutoTokenizer 加载分词器,模型选 Qwen3 系列最小的 Qwen3-0.6B,只下载分词器配置,10 MB 出头,不用下载模型权重:

from transformers import AutoTokenizer

# 加载 Qwen3-0.6B 的分词器
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")

# 词表就是一个「token 文本 → id」的大字典
vocab = tokenizer.get_vocab()
print(len(vocab))

# 按 id 排序,看看队头和队尾
vocab_by_id = sorted(vocab.items(), key=lambda kv: kv[1])
print(dict(vocab_by_id[:10]))
print(dict(vocab_by_id[-3:]))

运行结果:

151669
{'!': 0, '"': 1, '#': 2, '$': 3, '%': 4, '&': 5, "'": 6, '(': 7, ')': 8, '*': 9}
{'</tool_response>': 151666, '<think>': 151667, '</think>': 151668}

可以看到,词表就是一个 15 万多个条目的大字典。排在最前面的是标点符号这些 ASCII 字符,id 从 0 开始;排在最后面的是 <think> 这种不对应自然语言的条目,它们属于特殊 token,后面会专门讲。

细心的读者可以顺手试试 vocab["你好"],会发现查不到,报 KeyError 错误。这是因为词表的 key 并不是中文词汇,而是把 UTF-8 字节逐字节映射成可打印字符后的形式(GPT-2 传下来的做法,这样词表文件里不会出现不可见字符),比如「你好」的 6 个字节 b'\xe4\xbd\xa0\xe5\xa5\xbd' 映射后的 key 是 'ä½łå¥½',可以用 tokenizer.tokenize("你好") 来查。

还有一个细节:词表条目是 151669,而上一篇 config 里的 vocab_size 是 151936。前者是分词器词表的条目数,后者是嵌入表的行数,多出来的 267 行没有对应的 token,是把嵌入表凑成 128 的倍数做对齐的预留位,实际用不到。

整个过程可以用一张图概括:

why-tokenization.jpg

分词这一步发生在模型之外,由一个叫分词器(Tokenizer)的独立组件完成。每个模型发布时都会带上自己专属的分词器,不同模型的词表不一样,切分结果也不一样,所以分词器和模型必须配套使用,不能混着用。

Token 不一定是字或词

刚接触这个概念时,很多人会默认一个 token 就是一个字或者一个单词,其实都不是。Token(词元) 是分词器切出来的最小单位,它可能是整个词、词的一部分、单个字符,甚至字符的一部分。

我们用刚才加载的 Qwen3 分词器跑几个真实例子:

texts = ["我们今天来学习分词", "We are learning tokenization today", "unbelievable"]
for text in texts:
    ids = tokenizer.encode(text)
    # 逐个 decode 出 token 片段,把空格换成 ␣ 方便看
    tokens = [tokenizer.decode([i]).replace(" ", "␣") for i in ids]
    print(f'"{text}" → {len(ids)} 个 token:{" / ".join(tokens)}')

运行结果:

"我们今天来学习分词" → 6 个 token:我们 / 今天 / 来 / 学习 / 分 / 词
"We are learning tokenization today" → 6 个 token:We / ␣are / ␣learning / ␣token / ization / ␣today
"unbelievable" → 3 个 token:un / belie / vable

可以看到几个规律:

  • 常见中文词组是一个整体:「我们」「今天」「学习」各自占一个 token,但不太常见的组合会被拆开,「分词」就拆成了「分」和「词」
  • 常见英文单词是一个 token,长词会被拆成子词(Subword):tokenization 拆成 token 和 ization,unbelievable 拆成三段
  • 空格是有意义的:英文里单词前的空格通常会并进 token,上面用 ␣ 标出了空格,比如「␣today」整体是一个 token

text-to-tokens-concept.jpg

中英文的差异尤其值得关注。早期针对英文优化的分词器处理中文很浪费,一个汉字可能占 2 到 3 个 token;现在主流的多语言分词器(比如 Qwen 用的)对中文友好了很多,常见汉字和词组大约 1 个 token,生僻字仍然会拆得更碎。

这不是一个纯学术问题。API 计费按 token 算,上下文长度按 token 算,速率限制也按 token 算。同样一段话用中文写还是用英文写,token 数量可能差出一截,账单也跟着差一截。估算成本时拿字数当 token 数,是会算错的。

BPE:从数据压缩借来的算法

那分词器是怎么决定在哪里下刀的?目前主流大模型用的都是 BPE(Byte Pair Encoding,字节对编码) 或者它的变体。

BPE 的历史有点意思。它本来是 Philip Gage 在 1994 年提出的一个数据压缩算法,和自然语言处理没有关系。2016 年,Sennrich 等人在一篇机器翻译论文里把它改造成了子词切分方法,用来解决翻译模型遇到生僻词就抓瞎的问题,这篇论文后来拿了 ACL 2026 的 Test of Time 奖。2019 年 GPT-2 又把它改造成字节级 BPE(Byte-level BPE):不再以字符为起点,而是以 256 个字节为初始词表。这么一改,任何语言、任何符号、任何 emoji 都能被表示,彻底不会出现分词器不认识某个字的情况。

BPE 论文全名是 Neural Machine Translation of Rare Words with Subword Units,arXiv 编号 1508.07909。想了解从零实现一个 BPE 分词器长什么样,可以看 Sebastian Raschka 的 BPE from scratch 一文。

BPE 的核心思路就一句话:反复把语料里出现最频繁的相邻两个单位合并成一个新单位,直到词表达标。训练分词器的过程就是学出一张合并规则表,分词时按同样的规则顺序套用到新文本上。

用一个具体例子演示。假设我们的全部训练语料只有四个词:low 出现 5 次,lower 出现 2 次,newest 出现 6 次,widest 出现 3 次。初始状态每个词拆成单个字符,词尾加一个特殊标记表示单词结束:

low    → l o w </w>     (5 次)
lower  → l o w e r </w> (2 次)
newest → n e w e s t </w>(6 次)
widest → w i d e s t </w>(3 次)

然后开始循环:统计所有相邻对的出现次数,把最高频的一对合并,加入词表。前几轮的过程如下:

轮次最高频相邻对合并结果出现次数
1(e, s)es9
2(es, t)est9
3(l, o)lo7
4(lo, w)low7
5(n, e)ne6
6(ne, w)new6
7(new, est)newest6

表里省略了和词尾标记 </w> 的合并,比如 (est, </w>) 出现 9 次,实际顺序里它就排在第 3 轮,为了演示直观,我就去掉了。

几轮之后,est、low、newest 这些高频片段各自成了词表里的整体 token。训练好的分词器遇到新文本时,按学好的合并顺序逐条套用。最有价值的情况是遇到没见过的词,比如 slowest:s 开头的部分没有对应规则,退回单个字符,但后半段 low 和 est 都在词表里,最终切成 s + low + est。这就是子词切分的精髓:常见词走整体,生僻词拆成熟悉的零件,永远不会无法表示。

真实模型的词表规模远大于这个玩具例子。GPT-2 的词表是 50257 个 token,Qwen3 是 15 万多个。词表大,常见词和词组都能整体表示,同样文本切出来的 token 数就少,推理更省;但词表越大嵌入层参数越多,词表里冷门 token 的训练也越不充分,所以规模是权衡出来的。

整个训练循环可以画成这样:

bpe-training-loop.jpg

保存下来的这两个文件就在模型仓库里,随分词器一起下发:

$ ls  ~/.cache/huggingface/hub/models--Qwen--Qwen3-0.6B/snapshots/* 
config.json             merges.txt              tokenizer_config.json   vocab.json
generation_config.json  model.safetensors       tokenizer.json

这 7 个文件分两组,4 个属于分词器,3 个属于模型:

文件是什么
vocab.json词表,token(字节映射形式)到 id 的对照表
merges.txt合并规则表
tokenizer.json前两个文件的打包加强版,还包含预分词规则和特殊 token 定义,fast tokenizer 实际加载的是它
tokenizer_config.json分词器配置,包括特殊 token 的名字和聊天模板,后面聊天模板一节还会见到它
config.json模型结构配置,上一篇已经见过
generation_config.json生成的默认参数,temperature、top_p 这些的出厂值
model.safetensors模型权重本体,1.5 GB,推理的主角

只跑分词实验的话,AutoTokenizer 只需要前 4 个文件,总共 10 MB 出头;后 3 个是上一篇跑模型推理时下载的,和分词无关。

词表我们前面已经看过了,那么真实的合并规则长什么样呢?不妨打开 merges.txt 文件瞧瞧,它的开头是这样的:

#version: 0.2
Ġ Ġ
ĠĠ ĠĠ
i n
Ġ t
...
e r
...
def ine
def ault

每行一条规则,两个符号写在一行,表示分词时看到这两个相邻的单位就合并成一个,比如 i n 表示 i 后面跟着 n 时合并成 in。Ġ 是空格的字节映射形式,Ġ t 就是「空格加 t 合并成 ␣t」。可以看到后面还有 def ine、def ault 这种明显从代码语料里学出来的规则。顺序就是优先级:训练时越早学出的合并排得越靠前,分词新文本时从字节开始,反复挑当前序列里排名最靠前的对子来合并,保证切分结果和训练时的学习顺序一致。上面玩具例子里那张 7 轮的表,就是一个迷你版的 merges.txt。

用 transformers 观察分词

下面我们再来看一个示例,看看这个分词器面对一句中英文混合、还带标点 emoji 的话会怎么切:

from transformers import AutoTokenizer

# 加载 Qwen3-0.6B 的分词器
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-0.6B")

text = "你好,world!今天的 weather 真不错 😊"

# encode:文本 → token id 序列
ids = tokenizer.encode(text)
print(ids)

# 逐个看每个 token 对应的文本片段
for i in ids:
    print(i, repr(tokenizer.decode([i])))

# decode:token id 序列 → 还原成文本
print(tokenizer.decode(ids))

运行结果如下:

ids: [108386, 3837, 14615, 6313, 106560, 9104, 10236, 250, 253, 100832, 26525, 232]
108386 '你好'
3837 ','
14615 'world'
6313 '!'
106560 '今天的'
9104 ' weather'
10236 ' �'
250 '�'
253 '�'
100832 '不错'
26525 ' �'
232 '�'
decode: 你好,world!今天的 weather 真不错 😊

这 12 个 token 里有几个点值得注意:

  • 中文:「你好」「今天的」「不错」都是整体 token,但「真」连同前面空格这个组合没有对应的合并规则,被拆成了 3 个字节级 token。这不是分词器坏了,而是字节级 BPE 的兜底机制在起作用,词表里没有覆盖的组合会退回到字节表示
  • 英文:world 是整体 token,「 weather」带着前导空格一起算一个 token,和前面说的规律一致
  • 标点:中文逗号和感叹号各自独立成 token
  • emoji:笑脸连同前面的空格也被拆成了字节级 token,和「真」一样,都是词表没覆盖到组合时退回字节表示的结果

最后一行的 decode 输出和输入一字不差,说明 encode 之后再 decode 可以无损还原。旅程地图里的反分词环节,干的就是 decode 这件事。

特殊 token

词表里除了正常文本切出来的 token,还有一类特殊 token(Special Token),刚才词表队尾的 <think> 就属于这类。它们不对应任何自然语言文字,作用是充当结构标记,告诉模型一段文本从哪里开始、到哪里结束、哪里是补齐的空白。最常见的三个:

特殊 token全称作用
BOSBeginning of Sequence标记序列开头
EOSEnd of Sequence标记序列结束,模型生成出它就停止
PADPadding批处理时把短序列补齐到同样长度

其中 EOS 很重要,上一篇讲过 Decode 循环是一个 token 一个 token 地生成,那模型怎么知道该停了?答案就是训练时教会它在回答结束时生成 EOS,推理引擎检测到这个 id 就终止循环。

各家模型用哪些特殊 token、取什么名字并不统一。可以打印出来看看 Qwen3 的情况:

print(tokenizer.bos_token)  # None
print(tokenizer.eos_token)  # <|im_end|>
print(tokenizer.pad_token)  # <|endoftext|>

可以看到 Qwen3 没有 BOS,EOS 用的是 <|im_end|>,PAD 用的是 <|endoftext|>。

聊天模板

平时我们在对话框里打字,很容易以为那句话原封不动就进了模型。其实没有。你发出去的每一条消息,都会先被包进一个固定格式里,这个格式就是聊天模板(Chat Template)。

聊天模型是在多轮对话数据上训练出来的,训练数据里每轮对话都有明确的角色标记,谁是系统提示、谁是用户、谁是助手,边界清清楚楚。推理时必须用同样的格式包装输入,模型才知道现在轮到谁说话了。用 apply_chat_template 看一下 Qwen3 实际拼出来的字符串:

messages = [
    {"role": "system", "content": "你是一个有帮助的助手。"},
    {"role": "user", "content": "什么是分词?"},
]
text = tokenizer.apply_chat_template(
    messages, tokenize=False, add_generation_prompt=True
)
print(text)

输出如下:

<|im_start|>system
你是一个有帮助的助手。<|im_end|>
<|im_start|>user
什么是分词?<|im_end|>
<|im_start|>assistant

可以看到,每条消息被 <|im_start|> 加角色名开头、<|im_end|> 结尾包住,最后还追加了一个 <|im_start|>assistant 的开头,这就是 add_generation_prompt=True 的作用,相当于把话头递给模型:接下来该你说了。模型生成回答后输出 <|im_end|>,EOS 检测到,Decode 循环结束。

chat-template-wrapping.jpg

这个格式其实不是 Qwen 自创的,它是 OpenAI 在 2023 年发布 ChatGPT API 时提出的 ChatML(Chat Markup Language),im 是 instant message 的缩写。Qwen 系列沿用了这套格式。

不同模型的聊天模板差别很大,比如和 Llama 3 对比一下:

Qwen(ChatML 风格)Llama 3
一轮开始`<\im_start\>` 加角色名`<\start_header_id\> 角色名 <\end_header_id\>`
一轮结束`<\im_end\>``<\eot_id\>`
序列开头无`<\begin_of_text\>`

功能上等价,写法完全不同。所以不能把 Qwen 的模板套给 Llama 用,格式错了模型表现会明显变差。同样也不能拿这套模板机制去套 base 模型:base 模型训练时没见过 <|im_start|> 这些标记,你把对话格式喂给它,它只会顺着往下续写文本,而不是回答你的问题。

base 模型是预训练完就直接发布的模型,训练目标只有一个:根据上文预测下一个 token。它学的是文本本身的分布,所以只会续写。对话模型(Chat 或 Instruct 模型)是在 base 模型的基础上,再用带角色标记的对话数据做微调和对齐,才学会按格式回答。从模型名字能看出来,比如 Qwen3-0.6B 是对话模型,对应的 Qwen3-0.6B-Base 就是 base 模型。

上下文窗口与 token 计数

最后把 token 和两个工程上天天打交道的概念连起来。

第一个是上下文窗口(Context Window),它指模型一次能处理的 token 总数上限,输入加输出一起算。Qwen3-0.6B 原生支持 32K token 的上下文,通过 YaRN(一种基于 RoPE 缩放的上下文长度扩展方法)扩展可以到 128K。

第二个是计费。API 厂商按 token 报价,输入输出分开计价。写应用时预估成本、控制超长文本,第一步都是先数 token。数 token 的方法很简单,用模型对应的分词器 encode 一下看长度就行。如果你用的是 OpenAI 的模型,它家开源了一个快速的 BPE 分词库 tiktoken,两行就能数出来:

import tiktoken
enc = tiktoken.encoding_for_model("gpt-4o")
print(len(enc.encode("你好,world!")))

OpenAI 还提供了一个在线的 Tokenizer 页面,把文本粘进去就能直观看到切分结果和数量,适合不想写代码的时候随手验证:

openai-tokenizer.png

要注意的是 tiktoken 只适用于 OpenAI 自家模型,数 Qwen、Llama 的 token 还是得用各家自己的分词器。词表不同,数出来的结果也不一样。

小结

今天我们把推理旅程的第一站走完了,要点如下:

  1. 为什么分词:模型只认识数字,分词器负责把文本切成 token 再查词表换成 id,它是文本和模型之间的中间货币
  2. Token 不是字也不是词:是切分出来的最小单位,常见词整体一个,长词拆子词,生僻内容退回字节;中英文 token 效率不同,直接影响计费和上下文容量
  3. BPE 算法:源自数据压缩,经 Sennrich 等人引入 NLP、GPT-2 发展到字节级,核心就是反复合并最高频相邻对
  4. 特殊 token:BOS、EOS、PAD 是结构标记,EOS 同时承担着终止 Decode 循环的职责
  5. 聊天模板:用户消息进模型前会被包成带角色的对话格式,Qwen 用 <|im_start|> 和 <|im_end|>,Llama 用另一套,这也是 base 模型和 chat 模型表现差异的来源之一

现在我们已经能把一句话变成一串 token id 了。但 id 只是编号,模型真正吃的是每个 id 对应的向量,而且这些向量里还得想办法带上位置信息,不然模型分不清「你打我」和「我打你」。嵌入和位置编码就是下一篇的主题,我们明天继续。

参考