Fork me on GitHub

2025年11月

重温 Java 21 之密钥封装机制 API

密钥封装(Key Encapsulation) 是一种现代加密技术,它使用非对称或公钥加密来保护对称密钥。传统的做法是使用公钥加密随机生成的对称密钥,但这需要 填充(Paddings) 并且难以证明安全,密钥封装机制(Key Encapsulation Mechanism,KEM) 另辟蹊径,使用公钥的属性来推导相关的对称密钥,不需要填充。

KEM 的概念是由 Crammer 和 Shoup 在 Design and Analysis of Practical Public-Key Encryption Schemes Secure against Adaptive Chosen Ciphertext Attack 这篇论文中提出的,后来 Shoup 将其提议为 ISO 标准,并于 2006 年 5 月接受并发布为 ISO 18033-2。

经过多年的发展,KEM 已经在多个密码学领域有所应用:

Java 平台中现有的加密 API 都无法以自然的方式表示 KEM,第三方安全提供商的实施者已经表达了对标准 KEM API 的需求。于是,Java 21 引入了一种新的 KEM API,使应用程序能够自然且方便地使用 KEM 算法。

对称加密

上面对 KEM 的描述中涉及大量现代密码学的概念,为了对 KEM 有一个更直观的认识,我们不妨快速浏览一遍密码学的发展历史。

我们经常会在各种讲述一二战的谍战片中看到破译电报的片段,当时使用的密码算法在现在看来是非常简单的,几乎所有的密码系统使用的都是 对称加密(Symmetric Cryptography) 算法,也就是说使用相同的密钥进行消息的加密与解密,因为这个特性,我们也称这个密钥为 共享密钥(Shared Secret Key)。
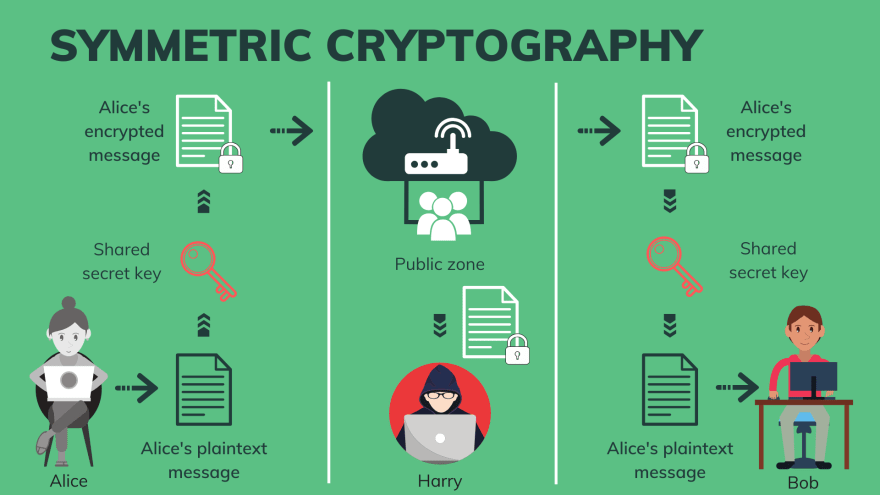
symmetric-crypto.png

常见的对称加密算法有:DES、3DES、AES、Salsa20 / ChaCha20、Blowfish、RC6、Camelia 等。

其中绝大多数都是 块密码算法(Block Cipher) 或者叫 分组密码算法,这种算法一次只能加密固定大小的块(例如 128 位);少部分是 流密码算法(Stream Cipher),流密码算法将数据逐字节地加密为密文流。为了实现加密任意长度的数据,我们通常需要将分组密码算法转换为流密码算法,这被称为 分组密码的工作模式,常用的工作模式有:ECB(电子密码本)、CBC(密码块链接)、CTR(计数器)、CFB(密文反馈模式)、OFB(输出反馈模式)、GCM(伽罗瓦/计数器模式)) 等。

分组密码的工作模式其背后的主要思想是把明文分成多个长度固定的组,再在这些分组上重复应用分组密码算法,以实现安全地加密或解密任意长度的数据。某些分组模式(如 CBC)要求将输入拆分为分组,并使用填充算法(例如添加特殊填充字符)将最末尾的分组填充到块大小,也有些分组模式(如 CTR、CFB、OFB、CCM、EAX 和 GCM)根本不需要填充,因为它们在每个步骤中,都直接在明文部分和内部密码状态之间执行异或(XOR)运算。

因此我们在使用对称加密时,往往要指定 工作模式(Modes) 和 填充模式(Paddings) 这两个参数,下面是使用 Java 标准库提供的接口实现 AES 加密和解密的示例:

private static void testAES() throws Exception {

  // 1. 生成对称密钥
  KeyGenerator keyGenerator = KeyGenerator.getInstance("AES");
  keyGenerator.init(new SecureRandom());
  Key secretKey =  keyGenerator.generateKey();

  // 1. 使用固定密钥:128 位密钥 = 16 字节
  // SecretKey secretKey = new SecretKeySpec("1234567890abcdef".getBytes(), "AES");

  // 2. 加密
  Cipher cipher = Cipher.getInstance("AES/ECB/PKCS5Padding");
  cipher.init(Cipher.ENCRYPT_MODE, secretKey);
  byte[] encrypted = cipher.doFinal("hello".getBytes());

  // 3. 解密
  cipher.init(Cipher.DECRYPT_MODE, secretKey);
  byte[] decrypted = cipher.doFinal(encrypted);
  System.out.println(new String(decrypted));
}

我们首先通过 KeyGenerator 生成一个对称密钥(也可以直接使用 SecretKeySpec 来定义一个固定的密钥,但是要注意密钥的长度),然后通过 算法名称/工作模式/填充模式 来获取一个 Cipher 实例,这里使用的是 AES 算法,ECB 分组模式以及 PKCS5Padding 填充模式,关于其他算法和模式可参考 Java Security Standard Algorithm Names。得到 Cipher 实例后,就可以对数据进行加密和解密,可以看到,这里加密和解密使用的是同一个密钥。

对称加密算法的问题有两点:

  • 需要安全的通道进行密钥交换,早期最常见的是面对面交换密钥,一旦密钥泄露,数据将完全暴露;
  • 每个点对点通信都需要使用不同的密钥,密钥的管理会变得很困难,如果你需要跟 100 个朋友安全通信,你就要维护 100 个不同的对称密钥;

综上,对称加密会导致巨大的 密钥交换 跟 密钥保存与管理 的成本。

密钥交换协议

为了解决对称加密存在的两大问题,密码学家们前仆后继,想出了各种各样的算法,其中最关键的一个是 Whitfield Diffie 和 Martin Hellman 在 1976 年公开发表的一种算法,也就是现在广为人知的 Diffie–Hellman 密钥交换(Diffie–Hellman Key Exchange,DHKE) 算法。
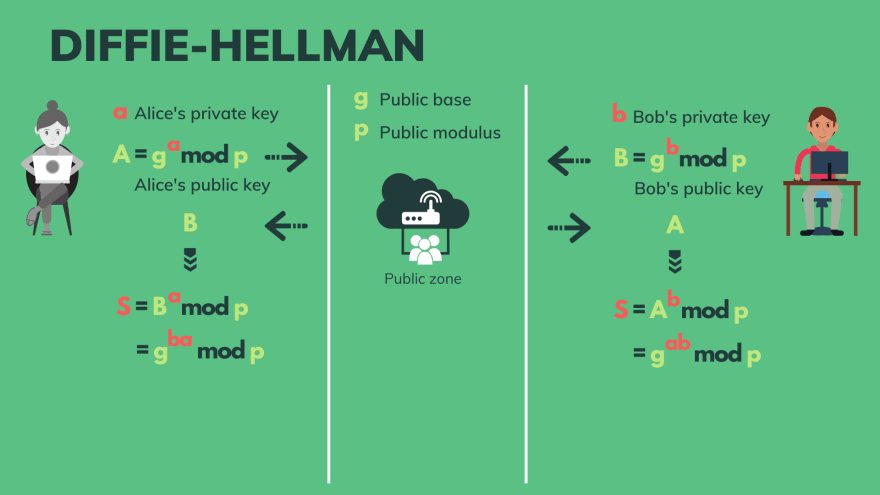
dhke.png

上图是经典 DHKE 协议的整个过程,其基本原理涉及到数学中的 模幂(Modular Exponentiations) 和 离散对数(Discrete Logarithms) 的知识。

模幂是指求 g 的 a 次幂模 p 的值,其中 g a p 均为整数,公式如下:

A = (g^a) mod p

而离散对数是指在已知 g p 和模幂值 A 的情况下,求幂指数 a 的逆过程。

我们通过将 p 设置为一个非常大的质数,使用计算机计算上述模幂的值是非常快的,但是求离散对数却非常困难,这也就是所谓的 离散对数难题(Discrete Logarithm Problem,DLP)。

在 DHKE 协议中,Alice 和 Bob 首先约定好两个常数 g 和 p,这两个数所有人都可见。然后他们分别生成各自的私钥 a 和 b,这两个值各自保存,不对外公开。他们再分别使用各自的私钥计算出模幂 A 和 B,这两个值就是他们的公钥:

A = (g^a) mod p
B = (g^b) mod p

接着,Alice 将 A 发送给 Bob,Bob 将 B 发送给 Alice,接受到彼此的公钥之后,他们使用自己的私钥来计算模幂:

S1 = (B^a) mod p
S2 = (A^b) mod p

根据模幂的数学性质,我们可以得知 S1 和 S2 是相等的!

S1 = (B^a) mod p = (g^b)^a mod p = ( g^(b*a) ) mod p
S2 = (A^b) mod p = (g^a)^b mod p = ( g^(a*b) ) mod p

至此 Alice 和 Bob 就协商出了一个共享密钥,这个密钥可以在后续的通讯中作为对称密钥来加密通讯内容。可以看到,尽管整个密钥交换过程是公开的,但是任何窃听者都无法根据公开信息推算出密钥,这就是密钥交换协议的巧妙之处。

下面的代码演示了如何在 Java 中实现标准的 DHKE 协议:

private static void testKeyAgreement() throws Exception {

  // 1. Alice 和 Bob 分别生成各自的密钥对
  KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("DH");
  keyPairGen.initialize(512);
  KeyPair keyPairAlice = keyPairGen.generateKeyPair();
  KeyPair keyPairBob = keyPairGen.generateKeyPair();

  // 2. Alice 根据 Bob 的公钥协商出对称密钥
  KeyAgreement keyAgreement = KeyAgreement.getInstance("DH");
  keyAgreement.init(keyPairAlice.getPrivate());
  keyAgreement.doPhase(keyPairBob.getPublic(), true);
  byte[] secretKey1 = keyAgreement.generateSecret();

  // 3. Bob 根据 Alice 的公钥协商出对称密钥
  keyAgreement.init(keyPairBob.getPrivate());
  keyAgreement.doPhase(keyPairAlice.getPublic(), true);
  byte[] secretKey2 = keyAgreement.generateSecret();

  // 4. 比较双方的密钥是否一致
  System.out.println("Alice Secret key: " + HexFormat.of().formatHex(secretKey1));
  System.out.println("Bob Secret key: " + HexFormat.of().formatHex(secretKey2));
}

这里首先通过 KeyPairGenerator 为 Alice 和 Bob 分别生成密钥对(密钥对中包含了一个私钥和一个公钥,也就是上文中的 a/b 和 A/B),然后使用 KeyAgreement.getInstance("DH") 获取一个 KeyAgreement 实例,用于密钥协商,Alice 根据 Bob 的公钥协商出对称密钥 S1,Bob 根据 Alice 的公钥协商出对称密钥 S2,根据输出结果可以看到 S1 和 S2 是相等的。

非对称加密

从第一次世界大战、第二次世界大战到 1976 年这段时期密码的发展阶段,被称为 近代密码阶段。1976 年是密码学的一个分水岭,在 Whitfield Diffie 和 Martin Hellman 这篇论文 中,他们不仅提出了 DHKE 算法,还提出了 公钥密码学(Public- Key Cryptography) 的概念。

公钥密码学中最核心的部分是 非对称加密(Asymmetric Encryption) 算法,和 DHKE 算法类似,它也是基于两个不同的密钥来实现加密和解密,一个称为公钥,另一个称为私钥,其中公钥可以公开,任何人都能访问;但和 DHKE 不同的是,DHKE 中的公钥只是用于协商出一个对称密钥,用于后续通讯的加解密,而在非对称加密中,不需要密钥协商,消息的发送者可以直接使用接受者的公钥对数据进行加密,而加密后的数据只有私钥的持有者才能将其解密。
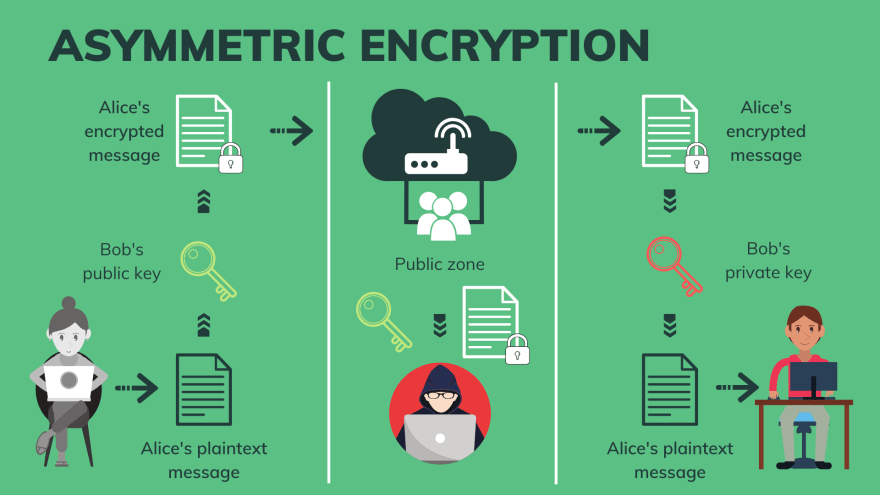
asymmetric-encryption.png

非对称加密算法的这种神奇特性,使得通讯双发不需要预先协商密钥,因此非常适合在多方通信中使用;也使得公钥密码学的概念很快就深入人心,它极大地推动了现代密码学的发展,为 数字签名 和 数字证书 提供了理论基础,特别是 公钥基础设施(PKI) 体系的建立,实现安全的身份验证和数据保护。

可以说,非对称加密是密码学领域一项划时代的发明,它宣告了近代密码阶段的终结,是现代密码学的起点。


最著名的非对称加密算法非 RSA 莫属,它是 1977 年由三位美国数学家 Ron Rivest、Adi Shamir 和 Leonard Adleman 共同设计的,这种算法以他们名字的首字母命名。RSA 算法涉及不少数论中的基础概念和定理,比如 互质、欧拉函数、模反元素、中国余数定理、费马小定理 等,网上有大量的文章介绍 RSA 算法原理,感兴趣的同学可以查阅相关的资料。

不过对于初学者来说,这些原理可能显得晦涩难懂,不妨玩一玩下面这个数学小魔术:

首先,让 A 任意想一个 3 位数,并把这个数乘以 91,然后将积的末三位告诉 B,B 就可以猜出 A 想的是什么数字。比如 A 想的是 123,那么他就计算出 123 * 91 = 11193,并把结果的末三位 193 告诉 B。那么 B 要怎么猜出对方的数字呢?其实很简单,只需要把对方说的数字再乘以 11,乘积的末三位就是 A 刚开始想的数了。可以验证一下,193 * 11 = 2123,末三位正是对方所想的秘密数字!

这个小魔术的道理其实很简单,由于 91 * 11 = 1001,而任何一个三位数乘以 1001 后,末三位显然都不变,例如 123 * 1001 = 123123。

这个例子直观地展示了非对称加密算法的工作流程:A 和 B 可以看做消息的发送方和接受方,其中 91 是 B 的公钥,123 是 A 要发送的消息,123 * 91 就好比使用公钥加密,193 就是加密后的密文;而 11 是 B 的私钥,193 * 11 就是使用私钥解密。

RSA 算法的本质就是上面这套思想,只不过它不是简单的乘法计算,而是换成了更加复杂的指数和取模运算。

下面继续使用 Java 代码来实现 RSA 的加密和解密:

private static void testRSA() throws Exception {

  // 1. Bob 生成密钥对
  KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("RSA");
  keyPairGen.initialize(2048);
  KeyPair keyPairBob = keyPairGen.generateKeyPair();

  // 2. Alice 使用 Bob 的公钥加密数据
  Cipher cipher1 = Cipher.getInstance("RSA");
  cipher1.init(Cipher.ENCRYPT_MODE, keyPairBob.getPublic());
  byte[] encrypted = cipher1.doFinal("hello".getBytes());

  // 3. Bob 使用自己的私钥解密数据
  Cipher cipher2 = Cipher.getInstance("RSA");
  cipher2.init(Cipher.DECRYPT_MODE, keyPairBob.getPrivate());
  byte[] decrypted = cipher2.doFinal(encrypted);

  System.out.println(new String(decrypted));
}

这里的代码和对称加密如出一辙,都是先通过 Cipher.getInstance() 获取一个 Cipher 实例,然后再通过它对数据进行加密和解密;和对称加密不同的是,这里加密用的是 Bob 的公钥,而解密用的是 Bob 的私钥。

其实,根据非对称加密的性质,我们不仅可以 公钥加密,私钥解密,而且也可以 私钥加密,公钥解密,不过用私钥加密的信息所有人都能够用公钥解密,这看起来貌似没啥用,但是密码学家们却发现它大有用处,由于私钥加密的信息只能用公钥解密,也就意味着这个消息只能是私钥持有者发出的,其他人是不能伪造或篡改的,所以我们可以把它用作 数字签名,数字签名在数字证书等应用中。

除了 RSA 算法,还有一些其他重要的非对称加密算法,比如 Rabin 密码、ElGamal 密码 以及基于椭圆曲线的 ECC 密码(Elliptic Curve Cryptography) 等。

后量子密码学

非对称加密算法的安全性,基本上都是由不同的数学难题保障的,比如:

这些数学难题暂时都没有好方法解决,所以这些非对称加密算法暂时仍然被认为是安全的;一旦这些数学难题被破解,那么这些加密算法就不再安全了。

近年来,随着 量子计算机 的不断发展,很多运行于量子计算机的量子算法被提出来,其中最著名的是数学家彼得·秀尔于 1994 年提出的 秀尔算法,可以在多项式时间内解决整数分解问题。

这也就意味着,如果攻击者拥有大型量子计算机,那么他可以使用秀尔算法解决整数分解问题,从而破解 RSA 算法。不仅如此,后来人们还发现,使用秀尔算法也可以破解离散对数和椭圆曲线等问题,这导致目前流行的公钥密码系统都是 量子不安全(quantum-unsafe) 的。如果人类进入量子时代,这些密码算法都将被淘汰。

密码学家们估算认为,破解 2048 位的 RSA 需要 4098 个量子比特与 5.2 万亿个托佛利门,目前还不存在建造如此大型量子计算机的科学技术,因此现有的公钥密码系统至少在未来十年(或更久)依然是安全的。尽管如此,密码学家已经积极展开了后量子时代的密码学研究,也就是 后量子密码学(Post-quantum Cryptography,PQC)。

目前已经有一些量子安全的公钥密码系统问世,但是由于它们需要更长的密钥、更长的签名等原因,并没有被广泛使用。这些量子安全的公钥密码算法包括:NewHope、NTRU、BLISS、Kyber 等,有兴趣的同学可以自行查阅相关文档。

混合密码系统

非对称加密好处多多,既可以用来加密和解密,也可以用来签名和验证,而且还大大降低了密钥管理的成本。不过非对称加密也有不少缺点:

  • 使用密钥对进行加解密,算法要比对称加密更复杂;而且一些非对称密码系统(如 ECC)不直接提供加密能力,需要结合使用更复杂的方案才能实现加解密;
  • 只能加解密很短的消息;
  • 加解密非常缓慢,比如 RSA 加密比 AES 慢 1000 倍;

为了解决这些问题,现代密码学提出了 混合密码系统(Hybrid Cryptosystem) 或 混合公钥加密(Hybrid Public Key Encryption,HPKE) 的概念,将对称加密和非对称加密的优势相结合,好比同时装备电动机和发动机两种动力系统的混合动力汽车。发送者首先生成一个对称密码,使用这个对称密码来加密消息,然后使用接受者的公钥来加密对称密码;接受者首先使用自己的私钥解密出对称密码,然后再用对称密码解密消息。这里的对称密码也被称为 会话密钥(Session Key)。

下面的代码演示了 Alice 是如何利用 Bob 的公钥将一个 AES 对称密钥发送给 Bob 的:

private static void testRSA_AES() throws Exception {

  // 1. Bob 生成密钥对
  KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("RSA");
  keyPairGen.initialize(2048);
  KeyPair keyPair = keyPairGen.generateKeyPair();

  // 2. Alice 生成一个对称密钥
  KeyGenerator keyGen = KeyGenerator.getInstance("AES");
  keyGen.init(256);
  SecretKey secretKey = keyGen.generateKey();

  // 3. Alice 使用 Bob 的公钥加密对称密钥
  Cipher cipher1 = Cipher.getInstance("RSA");
  cipher1.init(Cipher.ENCRYPT_MODE, keyPair.getPublic());
  byte[] secretKeyEncrypted = cipher1.doFinal(secretKey.getEncoded());

  // 4. Bob 使用自己的私钥解密出对称密钥
  Cipher cipher2 = Cipher.getInstance("RSA");
  cipher2.init(Cipher.DECRYPT_MODE, keyPair.getPrivate());
  byte[] secretKeyDecrypted = cipher2.doFinal(secretKeyEncrypted);

  // 5. 比较双方的密钥是否一致
  System.out.println("Alice Secret key: " + HexFormat.of().formatHex(secretKey.getEncoded()));
  System.out.println("Bob Secret key: " + HexFormat.of().formatHex(secretKeyDecrypted));
}

可以看出,在混合密码系统中,非对称加密算法的作用和上文中的 DHKE 一样,只是用于密钥交换,并不用于加密消息,这和 DHKE 的工作原理几乎是一样的,所以严格来说,DHKE 也算是一种混合密码系统,只是两种密钥交换的实现不一样罢了。如何将会话密钥加密并发送给对方,就是 密钥封装机制(Key Encapsulation Mechanisms,KEM) 要解决的问题。

密钥封装机制

综上所述,密钥封装机制就是一种基于非对称加密的密钥交换技术,其主要目的是在不直接暴露私钥的情况下安全地传输会话密钥。

在 KEM 中,发起方运行一个封装算法产生一个会话密钥以及与之对应的 密钥封装消息(key encapsulation message),这个消息在 ISO 18033-2 中被称为 密文(ciphertext),随后发起方将密钥封装消息发送给接收方,接收方收到后,使用自己的私钥进行解封,从而获得相同的会话密钥。一个 KEM 由三部分组成:

  • 密钥对生成函数:由接收方调用,用于生成密钥对,包含公钥和私钥;
  • 密钥封装函数:由发送方调用,根据接收方的公钥产生一个会话密钥和密钥封装消息,然后发送方将密钥封装消息发送给接收方;
  • 密钥解封函数:由接收方调用,根据自己的私钥和接受到的密钥封装消息,计算出会话密钥。

其中第一步可以由现有的 KeyPairGenerator API 完成,但是后两步 Java 中暂时没有合适的 API 来自然的表示,这就是 JEP 452 被提出的初衷。通过 密钥封装机制 API(KEM API) 可以方便的实现密钥封装和解封:

private static void testKEM() throws Exception {

  // 1. Bob 生成密钥对
  KeyPairGenerator keyPairGen = KeyPairGenerator.getInstance("X25519");
  KeyPair keyPair = keyPairGen.generateKeyPair();

  // 2. Alice 根据 Bob 的公钥生成一个 Encapsulated 对象,这个对象里包含了:
  //  * 共享密钥 shared secret
  //  * 密钥封装消息 key encapsulation message
  //  * 可选参数 optional parameters
  //  然后 Alice 将密钥封装消息发送给 Bob
  KEM kem1 = KEM.getInstance("DHKEM");
  Encapsulator sender = kem1.newEncapsulator(keyPair.getPublic());
  Encapsulated encapsulated = sender.encapsulate();
  SecretKey k1 = encapsulated.key();

  // 3. Bob 根据自己的私钥和 Alice 发过来的密钥封装消息,计算出共享密钥
  KEM kem2 = KEM.getInstance("DHKEM");
  Decapsulator receiver = kem2.newDecapsulator(keyPair.getPrivate());
  SecretKey k2 = receiver.decapsulate(encapsulated.encapsulation());

  // 4. 比较双方的密钥是否一致
  System.out.println(Base64.getEncoder().encodeToString(k1.getEncoded()));
  System.out.println(Base64.getEncoder().encodeToString(k2.getEncoded()));
}

从代码可以看出密钥封装机制和混合密码系统有点像,但是看起来要更简单一点,省去了使用 KeyGenerator.generateKey() 生成对称密钥的步骤,而是使用密钥封装算法直接给出,至于这个密钥封装算法可以抽象成任意的实现,可以是密钥生成算法,也可以是随机数算法。

从 Java 文档 中可以看到 KEM 算法暂时只支持 DHKEM 这一种。但是 KEM API 提供了 服务提供商接口(Service Provider Interface,SPI),允许安全提供商在 Java 代码或本地代码中实现自己的 KEM 算法,比如 RSA-KEM、ECIES-KEM、PSEC-KEM、PQC-KEM 等。
重温 Java 21 之禁用代理的动态加载

Java Agent 通常被直译为 Java 代理,它是一个 jar 包,这个 jar 包很特别,不能独立运行,而是要依附到我们的目标 JVM 进程中。它利用 JVM 提供的 Instrumentation API 来修改已加载到 JVM 中的字节码,从而实现很多高级功能,比如:

Java Agent 简单示例

为了对 Java Agent 的概念有一个更直观的认识,我们从一个简单的示例入手,从零开始实现一个 Java Agent。先创建如下目录结构:

├── pom.xml
└── src
  └── main
    ├── java
    │   └── com
    │     └── example
    │       └── AgentDemo.java
    └── resources
      └── META-INF
        └── MANIFEST.MF

包含三个主要文件:

  • pom.xml - Maven 项目的配置文件
  • AgentDemo.java - Java Agent 的入口类
  • MANIFEST.MF - 元数据文件,用于描述打包的 JAR 文件中的各种属性和信息

Java Agent 的入口类定义如下:

package com.example;

import java.lang.instrument.Instrumentation;

public class AgentDemo {

  public static void premain(String agentArgs, Instrumentation inst) {
    System.out.println("premain");
  }
}

我们知道,常规 Java 程序的入口方法是 main 函数,而 Java Agent 的入口方法是 premain 函数。其中,String agentArgs 是传递给 Agent 的参数,比如当我们运行 java -javaagent:agent-demo.jar=some-args app.jar 命名时,参数 agentArgs 的值就是字符串 some-args;另一个参数 Instrumentation inst 是 JVM 提供的修改字节码的接口,我们可以通过这个接口定位到希望修改的类并做出修改。

Instrumentation API 是 Java Agent 的核心,它可以在加载 class 文件之前做拦截,对字节码做修改(addTransformer),也可以在运行时对已经加载的类的字节码做变更(retransformClasses 或 redefineClasses);Instrumentation 的英文释义是插桩或植入,所以这个操作又被称为 字节码插桩,由于这个操作非常的底层,一般会配合一些字节码修改的库,比如 ASM、Javassist、Byte Buddy 等。关于 Instrumentation API 是一个较为艰深复杂的话题,本文为简单起见,没有深入展开,感兴趣的同学可以自行查找相关资料。

有了 Java Agent 的入口类之后,我们还需要告诉 JVM 这个入口类的位置,可以在 MANIFEST.MF 元数据文件中通过 Premain-Class 参数来描述:

Premain-Class: com.example.AgentDemo

打包的时候,要注意将 MANIFEST.MF 文件一起打到 jar 包里,这可以通过打包插件 maven-assembly-plugin 来实现:

<plugin>
  <groupId>org.apache.maven.plugins</groupId>
  <artifactId>maven-assembly-plugin</artifactId>
  <version>3.6.0</version>
  <configuration>
    <descriptorRefs>
      <descriptorRef>jar-with-dependencies</descriptorRef>
    </descriptorRefs>
    <archive>
      <manifestFile>src/main/resources/META-INF/MANIFEST.MF</manifestFile>
    </archive>
  </configuration>
  <executions>
    <execution>
      <phase>package</phase>
      <goals>
        <goal>single</goal>
      </goals>
    </execution>
  </executions>
</plugin>

最后,执行 mvn clean package 打包命令,生成 target/agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar 文件,我们就得到了一个最简单的 Java Agent 了。

Java Agent 的两种加载方式

Java Agent 最常见的使用方式是在运行 java 命令时通过 -javaagent 参数指定要加载的 Agent 文件:

$ java -javaagent:agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar Hello.java

这种方式被称为 静态加载(static loading)。在这种情况下,Java Agent 和应用程序一起启动,并在运行主程序的 main 方法之前先调用 Java Agent 的 premain 方法,下面是程序的运行结果:

premain
Hello

既然有静态加载,自然就有动态加载。动态加载(dynamic loading) 指的是将 Java Agent 动态地加载到已运行的 JVM 进程中,当我们不希望中断生产环境中已经运行的应用程序时,这个特性非常有用。

我们先正常启动一个 Java 应用程序:

$ java Hello.java
Hello

通过 jps 得到该程序的 PID,然后使用 Java 的 Attach API 附加(attach) 到该程序上:

String pidOfOtherJVM = "3378";
VirtualMachine vm = VirtualMachine.attach(pidOfOtherJVM);

附加成功后得到 VirtualMachine 实例,VirtualMachine 提供了一个 loadAgent() 方法用于动态加载 Java Agent:

File agentJar = new File("/com.docker.devenvironments.code/agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar");
vm.loadAgent(agentJar.getAbsolutePath());

// do other works

vm.detach();

查看应用程序的日志,可以发现如下报错:

Failed to find Agent-Class manifest attribute from /com.docker.devenvironments.code/agent-demo.jar

这是因为目前我们这个 Java Agent 还不支持动态加载,动态加载的入口并不是 premain 函数,而是 agentmain 函数,我们在 AgentDemo 类中新增代码如下:

...
  public static void agentmain(String agentArgs, Instrumentation inst) {
    System.out.println("agentmain");
  }
...

并在 MANIFEST.MF 文件中新增 Agent-Class 参数:

Agent-Class: com.example.AgentDemo

重新打包,并再次动态加载,可以在应用程序中看到日志如下:

WARNING: A Java agent has been loaded dynamically (/com.docker.devenvironments.code/agent-demo-1.0-SNAPSHOT-jar-with-dependencies.jar)
WARNING: If a serviceability tool is in use, please run with -XX:+EnableDynamicAgentLoading to hide this warning
WARNING: If a serviceability tool is not in use, please run with -Djdk.instrument.traceUsage for more information
WARNING: Dynamic loading of agents will be disallowed by default in a future release
agentmain

可以看到 agentmain 函数被成功执行,动态加载生效了。

禁用 Java Agent 的动态加载

在上面的应用程序日志中,我们可以看到几行 WARNING 提示,这其实就是 Java 21 引入的新内容了,当 JVM 检测到有 Java Agent 被动态加载,就会打印这几行警告信息,告知用户动态加载机制将在未来的版本中默认禁用。如果不想看到这样的日志,可以在启动应用程序时加上 -XX:+EnableDynamicAgentLoading 选项:

$ java -XX:+EnableDynamicAgentLoading Hello.java

那么 Java 21 为什么要禁用 Java Agent 的动态加载呢?这就要提到 Java 所追求的 Integrity by Default 原则了。Integrity 一般被翻译为 完整性,片面的理解就是要保证我们程序中的任何内容,包括数据或代码都是完整的、没有被篡改的。而 Instrumentation API 通过修改已加载到 JVM 中的字节码来改变现有应用程序,在不更改源代码的情况下改变应用程序的行为。当我们静态加载 Java Agent 时,这并不是什么大问题,因为这是用户明确且有意的使用;然而,动态加载则是间接的,它超出了用户的控制范围,可能对用户的应用程序造成严重破坏,很显然并不符合完整性原则。

因此,作为应用程序的所有者,必须有意识地、明确地决定允许和加载哪些 Java Agent:要么使用静态加载,要么通过 -XX:+EnableDynamicAgentLoading 选项允许动态加载。


重温 Java 21 之向量 API

向量 API 最初由 JEP 338 提出,并作为孵化 API 集成到 Java 16 中,在 Java 17 到 20 中,又经过了 JEP 414、JEP 417、JEP 426、JEP 438 四次的孵化,这次在 Java 21 中,已经是第六次孵化了。

向量 API 又被称为 Vector API,要注意,这里讲的并不是 Java 中的 Vector 集合类,而是一种专门用于向量计算的全新 API。尽管这个 API 还在孵化期,并没有正式发布,但是这项技术很值得我们提前学习和了解,因为这项技术代表了 Java 语言发展的一个重要方向,在未来一定会有着重要的影响。随着生成式人工智能的发展,Embedding 技术也如日中天,它将各种类型的数据(如文本、图像、声音等)转换为高维数值向量,从而实现对数据特征和语义信息的表示。Embedding 技术在个性化推荐、多模态检索和自然语言处理等领域中发挥着重要作用,而这些场景都离不开向量计算。

什么是向量?

向量是数学和物理学中的一个基本概念,具有大小和方向两个属性,比如物理学中的力就是向量。向量可以有多种不同的表示方式:

  • 在代数中,一般印刷用黑体的小写英文字母来表示(比如 a、b、c 等),手写用在 a、b、c 等字母上加一箭头(→)表示;
  • 在几何中,向量可以形象化地表示为带箭头的线段,箭头所指的方向代表向量的方向,线段长度则代表向量的大小;
  • 在坐标系中,向量可以用点的坐标位置来表示,比如平面直角坐标系中的向量可以记为 (x, y),空间直角坐标系中的向量可以记为 (x, y, z),多维空间以此类推;此外,向量也可以使用矩阵来表示;
  • 在计算机科学中,向量可以被理解为一个数字列表或数组,这在编程语言中尤为常见。

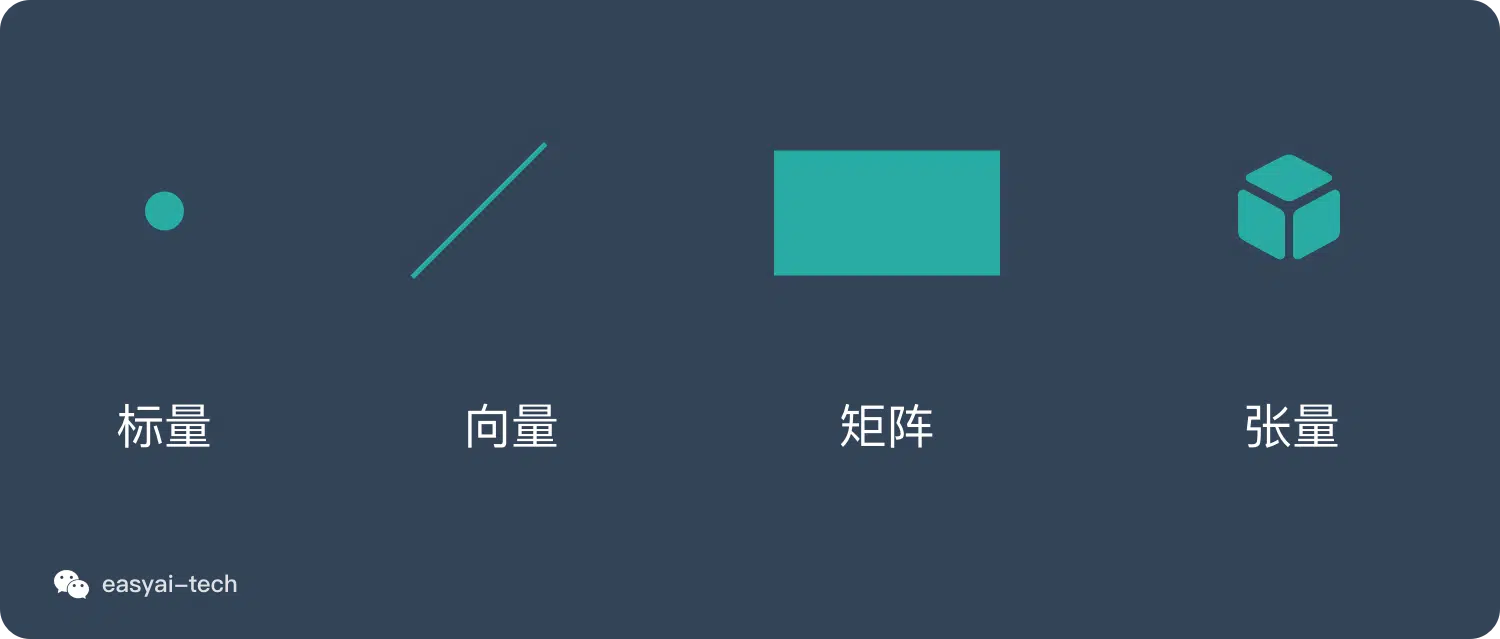
和向量这个概念相对应的,还有标量、矩阵、张量等概念,这几个概念可以代表不同的维度,一般用点线面体来类比:

  • 点——标量(scalar)
  • 线——向量(vector)
  • 面——矩阵(matrix)
  • 体——张量(tensor)

vector.png

标量计算 vs. 向量计算

标量就是一个数字,在 Java 中通常可以表示为一个整数或浮点数等,我们所熟知的算术运算基本上都是作用于标量之上的,比如下面的代码对 a 和 b 两个标量求和:

int a = 1;
int b = 1;
int c = a + b;

如果将 a 和 b 换成向量,也就是数组,该如何求和呢?最简单的方法是使用 for 循环依次相加数组中对应的元素:

int[] a = new int[] {1, 2, 3, 4};
int[] b = new int[] {1, 2, 3, 4};
int[] c = new int[4];
for (int i = 0; i < a.length; i++) {
  c[i] = a[i] + b[i];
}

很显然这不是什么高明的做法,仔细观察上面的代码就会发现,对于数组中每个元素的相加是互不影响的,那么我们能不能并行计算呢?一种有效的解决方法是使用 并行流(Parallel Stream):

IntStream.range(0, a.length)
  .parallel()
  .forEach(i -> c[i] = a[i] + b[i]);

另一种解决方法就是我们将要学习的 向量 API(Vector API):

IntVector aVector = IntVector.fromArray(IntVector.SPECIES_128, a, 0);
IntVector bVector = IntVector.fromArray(IntVector.SPECIES_128, b, 0);
IntVector cVector = aVector.add(bVector);

注意,由于向量 API 并没有正式发布,运行时需要手动加上 jdk.incubator.vector 模块:

$ java --add-modules jdk.incubator.vector VectorDemo.java

向量 API 定义了专门的向量类,比如这里的 IntVector,并提供了 fromArray 方法方便我们将数组转换为向量,然后再通过 aVector.add(bVector) 执行两个向量的加法运算。

除了加法运算,向量 API 还提供了一组方法来执行各种其他的向量计算:

  • 算术运算(Arithmetic Operations)

    • 加法:vector1.add(vector2)
    • 减法:vector1.sub(vector2)
    • 乘法:vector1.mul(vector2)
    • 除法:vector1.div(vector2)
  • 逐元素操作(Element-Wise Operations)

    • 绝对值:vector.abs()
    • 负数:vector.neg()
    • 平方根:vector.sqrt()
    • 指数:vector.exp()
    • 对数:vector.log()
  • 规约运算(Reductions)

    • 元素之和:vector.reduce(VectorOperators.ADD)
    • 最小元素:vector.reduce(VectorOperators.MIN)
    • 最大元素:vector.reduce(VectorOperators.MAX)
    • 平均值:vector.reduce(VectorOperators.ADD).mul(1.0 / vector.length())
  • 逻辑运算(Logical Operations)

    • 与:vector1.and(vector2)
    • 或:vector1.or(vector2)
    • 非:vector.not()
  • 比较操作(Comparisons)

    • 等于:vector1.eq(vector2)
    • 小于:vector1.lt(vector2)
    • 大于:vector1.compare(VectorOperators.GT, vector2)

单指令多数据(SIMD)

使用向量 API 来执行向量计算,不仅代码精简,容易理解,而且它还有另一个好处,那就是性能提升。尽管使用并行流也能提升一定的性能,但是并行流和向量 API 是两种完全不同的优化技术,前者使用多线程在不同的 CPU 核上并行计算,而后者通过 SIMD 技术,在单个 CPU 周期内对多个数据同时执行相同操作,从而达到并行计算的目的。

SIMD(Single Instruction, Multiple Data,单指令多数据) 是一种并行处理技术,它的核心思想是将一个控制器与多个处理单元结合在一起,使得这些处理单元可以针对不同的数据同时执行相同的操作,简单来说就是一个指令能够同时处理多个数据。这与传统的 SISD(Single Instruction, Single Data,单指令单数据) 形成对比,在后者中,一个指令只能处理一个数据。

在上面那个向量求和的例子中,我们先是使用 for 循环实现:

for (int i = 0; i < a.length; i++) {
  c[i] = a[i] + b[i];
}

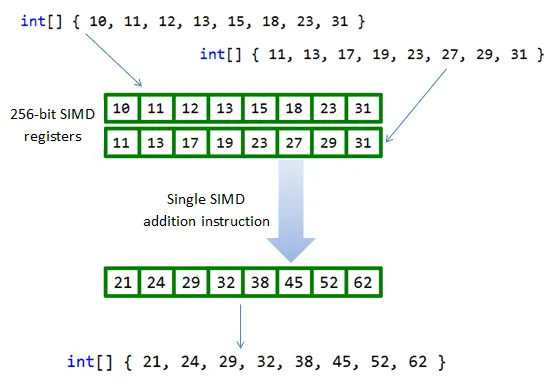
数组中的每个元素将使用(大致)1 个 CPU 指令进行计算,这意味着我们需要 4 个指令或 4 个 CPU 周期才能完成计算,这就是典型的 SISD。而使用向量 API 可以将向量的计算编译为对应 CPU 架构上的 SIMD 指令集,只要 1 个指令即可完成向量计算:

simd.png

在实际应用中,许多现代处理器都支持 SIMD 指令集,如 Intel 的 MMX、SSE 和 AVX,ARM 的 NEON 和 SVE 等,这些指令集能够显著提升程序的执行效率,特别是在需要大量数值计算的场景下。不过使用这些指令集的门槛并不低,通常涉及到汇编语言或一些特殊的函数库,比如 Intel 的跨平台函数库 IPP(Integrated Performance Primitives) 或使用 内置函数 (Intrinsic function) 等。

相比于传统的手写 SIMD 代码,Java 的向量 API 提供了更高的可读性和维护性,开发者可以使用熟悉的 Java 语法和类型系统,无需处理底层寄存器和指令,编写出简洁明了的、平台无关的、高性能的向量计算代码。

其实,在向量 API 提出之前,Java 已经在 SIMD 上探索了很长一段时间了,比如 HotSpot 的 自动向量化(Auto-Vectorization) 功能,它将标量操作转换为 超字操作(SuperWord Operations),然后再映射到 SIMD 指令。然而,这个过程完全依赖 JIT,并没有什么可靠的方法来保证编写的代码一定可以使用 SIMD 指令优化,有些代码甚至根本无法进行优化,开发人员必须深入了解 HotSpot 的自动向量化算法及其限制,才能实现可靠的性能提升。向量 API 使得这个过程完全由开发人员自己控制,因此可以写出更加可预测、更加稳健的代码。

我们可以通过 -XX:-UseSuperWord 参数关闭 HotSpot 的自动向量化功能。

使用向量 API

在学习了向量的基础知识之后,接下来我们将继续深入学习向量 API 的使用。

上面介绍向量计算时,我们已经学习了向量 API 的基本用法,使用 IntVector 实现两个向量相加。这个示例为了易于理解,做了简单处理,并没有考虑在实际使用时的边界情况,假设我们将 a 和 b 两个数组改成 10 个数字:

int[] a = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int[] b = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
IntVector aVector = IntVector.fromArray(IntVector.SPECIES_128, a, 0);
IntVector bVector = IntVector.fromArray(IntVector.SPECIES_128, b, 0);
IntVector cVector = aVector.add(bVector);

运行后得到的结果 c 仍然是 [2, 4, 6, 8],后面新加的数字并没有计算。这是因为每个向量的存储空间有限,并不能一次存下所有的数据。这里涉及向量 API 的一个重要概念:向量种类(Vector Species),它是 数据类型(Data Types) 和 向量形状(Vector Shapes) 的组合;所谓数据类型就是 Java 的基础类型,比如 byte、short、int、long 这些整数类型和 float、double 浮点类型,而所谓向量形状就是向量的位大小或位数;比如这里的向量种类为 IntVector.SPECIES_128,它代表数据类型为 int,向量形状为 128 位;而我们知道,一般情况下 int 值的大小为 32 位,所以这个向量一次只能存储 128/32 = 4 个 int 值,这也被形象地称为 通道(Lanes),表示向量一次可以处理的数据个数。

知道这一点后,我们就可以写出更加通用的向量计算代码了。首先我们需要将数据按通道数分组,然后一组一组的进行处理:

int[] a = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int[] b = new int[] {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
int[] c = new int[10];
int lanes = IntVector.SPECIES_128.length();
int loopBound = IntVector.SPECIES_128.loopBound(a.length);
for (int i = 0; i < loopBound; i += lanes) {
  IntVector aVector = IntVector.fromArray(IntVector.SPECIES_128, a, i);
  IntVector bVector = IntVector.fromArray(IntVector.SPECIES_128, b, i);
  IntVector cVector = aVector.add(bVector);
  cVector.intoArray(c, i);
}
for (int i = loopBound; i < a.length; i++) {
  c[i] = a[i] + b[i];
}
IntStream.of(c).forEach(x -> System.out.println(x));

我们可以注意到,在遍历时 i 每次增加 lanes,它的值等于 IntVector.SPECIES_128.length(),也就是通道数,一般来说该值等于 4,所以我们是按 4 个一组进行处理的。但是要注意数据不一定能被通道数完全整除,比如这里 10 个数字,前 8 个可以分为两组处理掉,还剩下 2 个怎么办呢?这时我们只能使用最原始的标量计算来处理了。

此外,在实际编码时向量种类不建议写死,可以使用 IntVector.SPECIES_PREFERRED 替代,它会根据平台自动选择最合适的向量种类:

static final VectorSpecies<Integer> SPECIES = IntVector.SPECIES_PREFERRED;

可以看出尽管向量 API 的使用有不少好处,但是我们也需要谨慎对待:

  • 首先,在使用向量 API 时,数据对齐是一个重要的考虑因素,不对齐的数据访问可能会导致性能下降。开发者需要确保数据在内存中的对齐方式,以充分发挥 SIMD 指令的优势;
  • 另外,向量 API 有硬件依赖性,它依赖于底层硬件支持的 SIMD 指令集,许多功能可能在其他平台和架构上不可用,性能也可能会有所不同。开发者需要了解目标平台的特性,并进行适当的性能优化。

小结

今天我们学习了 Java 21 中的 向量 API(Vector API),这个特性从 Java 16 开始就已引入,一直在不断演进和完善。学习内容总结如下:

  1. 向量计算基础 - 向量是数学和物理学中的基本概念,在计算机科学中被表示为数组或列表。向量计算相比标量计算,通过一次性处理多个数据元素,显著提高了计算效率,这正是现代高性能计算的关键所在;
  2. SIMD 优势 - 向量 API 充分利用现代处理器的 SIMD(单指令多数据)指令集特性,如 Intel 的 AVX 和 ARM 的 NEON,相比于手写汇编或使用低级 Unsafe API,向量 API 提供了更高的可读性、更好的可维护性和更可靠的性能保证;
  3. 向量 API 的使用:虽然向量 API 带来了性能提升,但我们在使用时也需要关注数据对齐、硬件依赖性等问题,需要根据目标平台的特性进行适当的优化,这样才能充分发挥向量计算的优势;

随着生成式人工智能的快速发展,Embedding 技术和向量计算在推荐系统、多模态检索、自然语言处理等领域的应用日益广泛,向量 API 为 Java 在这些领域的应用提供了基础,有望推动 Java 在 AI 和数据科学领域的进一步发展。


重温 Java 21 之作用域值

作用域值(Scoped Values) 是 Loom 项目提出的另一个重要特性,它提供了一种隐式方法参数的形式,允许在大型程序的各个部分之间安全地共享数据,而无需将它们作为显式参数添加到调用链中的每个方法中。作用域值通常是作为一个公共静态字段,因此可以从任何方法中访问到。如果多个线程使用相同的作用域值,则从每个线程的角度来看,它可能包含不同的值。

如果您熟悉 线程本地变量(thread-local variables),这听起来会很熟悉,事实上,作用域值正是为了解决使用线程本地变量时可能遇到的一些问题,在某些情况下可以将其作为线程本地变量的现代替代品。

一个例子

在 Web 应用开发中,一个经典的场景是获取当前已登录的用户信息,下面的代码模拟了大概的流程:

public class UserDemo {
    
  public static void main(String[] args) {

    // 从 request 中获取用户信息
    String userId = getUserFromRequest();
    
    // 查询用户详情
    String userInfo = new UserService().getUserInfo(userId);
    System.out.println(userInfo);
  }

  private static String getUserFromRequest() {
    return "admin";
  }

  static class UserService {
    public String getUserInfo(String userId) {
      return new UserRepository().getUserInfo(userId);
    }
  }

  static class UserRepository {
    public String getUserInfo(String userId) {
      return String.format("%s:%s", userId, userId);
    }
  }
}

在接收到请求时,首先对用户进行身份验证,然后得到用户信息,这个信息可能被很多地方使用。在这里我们使用方法参数将用户信息传递到其他要使用的地方,可以看到,userId 参数从 UserDemo 传到 UserService 又传到 UserRepository。

在一个复杂的应用程序中,请求的处理可能会延伸到数百个方法,这时,我们需要为每一个方法添加 userId 参数,将用户传递到最底层需要用户信息的方法中。很显然,额外的 userId 参数会使我们的代码很快变得混乱,因为大多数方法不需要用户信息,甚至可能有一些方法出于安全原因根本不应该能够访问用户。如果在调用堆栈的某个深处我们还需要用户的 IP 地址怎么办?那么我们将不得不再添加一个 ip 参数,然后通过无数的方法传递它。

使用 ThreadLocal 线程本地变量

解决这一问题的传统方法是使用 ThreadLocal,它是线程本地变量,只要线程不销毁,我们随时可以获取 ThreadLocal 中的变量值。

public class UserDemoThreadLocal {
    
  private final static ThreadLocal<String> USER = new ThreadLocal<>();
  
  public static void main(String[] args) {
    
    // 从 request 中获取用户信息
    String userId = getUserFromRequest();
    USER.set(userId);

    // 查询用户详情
    String userInfo = new UserService().getUserInfo();
    System.out.println(userInfo);
  }

  private static String getUserFromRequest() {
    return "admin";
  }

  static class UserService {
    public String getUserInfo() {
      return new UserRepository().getUserInfo();
    }
  }

  static class UserRepository {
    public String getUserInfo() {
      String userId = USER.get();
      return String.format("%s:%s", userId, userId);
    }
  }
}

这里我们定义了一个名为 USER 的 ThreadLocal 全局变量,获取完用户信息之后将其存入 USER 中,然后在 UserRepository 中直接从 USER 中获取。尽管看起来像普通变量,但线程本地变量的特点是每个线程都有一个独立实例,它的值取决于哪个线程调用其 get 或 set 方法来读取或写入其值。使用线程本地变量,可以方便地在调用堆栈上的方法之间共享数据,而无需使用方法参数。

注意,ThreadLocal 只能在单个线程中共享数据,如果内部方法中创建了新线程,我们可以使用 InheritableThreadLocal,它是 ThreadLocal 的子类,主要用于子线程创建时自动继承父线程的 ThreadLocal 变量,方便必要信息的进一步传递。

使用 ScopedValue 作用域值

不幸的是,线程本地变量存在许多设计缺陷,无法避免:

  • 不受限制的可变性(Unconstrained mutability) - 线程本地变量都是可变的,它的值可以随意被更改,任何能够调用线程本地变量的 get 方法的代码都可以随时调用该变量的 set 方法;但是往往更常见的需求是从一个方法向其他方法简单的单向数据传输,就像上面的示例一样;对线程本地变量的任意修改可能导致类似意大利面条的数据流以及难以察觉的错误;
  • 无限寿命(Unbounded lifetime) - 一旦线程本地变量通过 set 方法设值,这个值将在线程的整个生命周期中被保留,直到调用 remove 方法,不幸的是,开发人员经常忘记调用 remove 方法;如果使用了线程池,如果没有正确清除线程本地变量,可能会将一个线程的变量意外地泄漏到另一个不相关的线程中,导致潜在地安全漏洞;此外,忘记清理线程局部变量还可能导致内存泄露;
  • 昂贵的继承(Expensive inheritance) - 当使用大量线程时,我们通常会使用 InheritableThreadLocal 让子线程自动继承父线程的线程本地变量,子线程无法共享父线程使用的存储空间,这会显著增加程序的内存占用;特别是在虚拟线程推出之后,这个问题变得更为显著,因为虚拟线程足够廉价,程序中可能会创建成千上万的虚拟线程,如果一百万个虚拟线程中的每一个都有自己的线程局部变量副本,很快就会出现内存不足的问题。

作用域值(Scoped Values) 就是为解决这些问题而诞生的新概念。

  • 首先,作用域值是不可变的,它的值无法更改,单向的数据传输使得代码流程更清晰;
  • 另外,作用域值只在有限范围内使用,用完立即释放,不存在忘记清理的问题,所以也不会导致内存泄露;
  • 最后,作用域值更轻量,由于它是不可变的,所以父线程和子线程可以复用一个实例,再多的虚拟线程也不会有内存不足的问题。

下面用 ScopedValue 对上面的代码进行重写:

public class UserDemoScopedValue {
    
  final static ScopedValue<String> USER = ScopedValue.newInstance();

  public static void main(String[] args) {
    // 从 request 中获取用户信息
    String userId = getUserFromRequest();
    ScopedValue.where(USER, userId)
      .run(() -> {
        // 查询用户详情
        String userInfo = new UserService().getUserInfo();
        System.out.println(userInfo);
      });
  }

  private static String getUserFromRequest() {
    return "admin";
  }

  static class UserService {
    public String getUserInfo() {
      return new UserRepository().getUserInfo();
    }
  }

  static class UserRepository {
    public String getUserInfo() {
      String userId = USER.get();
      return String.format("%s:%s", userId, userId);
    }
  }
}

我们首先调用 ScopedValue.where(USER, userId),它用于将作用域值和某个对象进行绑定,然后调用 run() 方法,它接受一个 lambda 表达式,从该表达式直接或间接调用的任何方法都可以通过 get() 方法读取作用域值。

作用域值仅在 run() 调用的生命周期内有效,在 run() 方法完成后,绑定将被销毁。这种有界的生命周期,使得数据从调用方传输到被调用方(直接和间接)的单向传输一目了然。

作用域值的重绑定

上面说过,作用域值是不可变的,没有任何方法可以更改作用域值,但是我们可以重新绑定作用域值:

private static final ScopedValue<String> X = ScopedValue.newInstance();

void foo() {
  ScopedValue.where(X, "hello").run(() -> bar());
}

void bar() {
  System.out.println(X.get()); // prints hello
  ScopedValue.where(X, "goodbye").run(() -> baz());
  System.out.println(X.get()); // prints hello
}

void baz() {
  System.out.println(X.get()); // prints goodbye
}

在这个例子中,foo() 方法将作用域值 X 绑定为 hello,所以在 bar() 方法中使用 X.get() 获得的是 hello;但是接下来,我们重新将 X 绑定为 goodbye,再去调用 baz() 方法,这时在 baz() 方法中使用 X.get() 得到的就是 goodbye 了;不过值得注意的是,当 baz() 方法结束后,重新回到 bar() 方法,使用 X.get() 获得的仍然是 hello,说明作用域值并没有被修改。

作用域值的线程继承

在使用 ThreadLocal 的时候,我们通常会使用 InheritableThreadLocal 让子线程自动继承父线程的线程本地变量,那么作用域值如何实现线程继承呢?可惜的是,并不存在 InheritableScopedValue 这样的类,Java 21 提供了另一种解决方案:结构化并发 API(JEP 428)。

StructuredTaskScope 是结构化并发中的核心类,它的使用方法如下:

try (var scope = new StructuredTaskScope.ShutdownOnFailure()) {
  Supplier<String> user = scope.fork(() -> USER.get());
  scope.join().throwIfFailed();
  System.out.println("task scope: " + user.get());
} catch (Exception ex) {
}

其中 scope.fork() 方法用于创建子线程,父线程中的作用域值会自动被 StructuredTaskScope 创建的子线程继承,子线程中的代码可以使用父线程中为作用域值建立的绑定,而几乎没有额外开销。与线程局部变量不同,父线程的作用域值绑定不会被复制到子线程中,因此它的性能更高,也不会消耗过多的内存。

子线程的作用域值绑定的生命周期由 StructuredTaskScope 提供的 fork/join 模型控制,scope.join() 等待子线程结束,当线程结束后绑定就会自动销毁,避免了使用线程本地变量时出现无限生命周期的问题。

结构化并发也是 Java 21 中的一项重要特性,我们将在后面的笔记中继续学习它的知识。


重温 Java 21 之虚拟线程

虚拟线程(Virtual Thread) 是 Java 21 中最突出的特性之一,作为 Loom 项目的一部分,开发人员对这个特性可谓期待已久。它由预览特性变成正式特性经历了两个版本的迭代,第一次预览是 Java 19 的 JEP 425 ,第二次预览是 Java 20 的 JEP 436,在 Java 21 中虚拟线程特性正式发布。

虚拟线程 vs. 平台线程

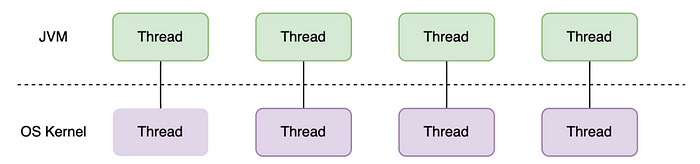
在引入虚拟线程之前,我们常使用 java.lang.Thread 来创建 Java 线程,这个线程被称为 平台线程(Platform Thread),它和操作系统的内核线程是一对一的关系,由内核线程调度器负责调度。

platform-threads.png

为了提高应用程序的性能和系统的吞吐量,我们将添加越来越多的 Java 线程,下面是一个模拟多线程的例子,我们创建 10 万个线程,每个线程模拟 I/O 操作等待 1 秒钟:

private static void testThread() {
  long l = System.currentTimeMillis();
  try(var executor = Executors.newCachedThreadPool()) {
    IntStream.range(0, 100000).forEach(i -> {
      executor.submit(() -> {
        Thread.sleep(Duration.ofSeconds(1));
        // System.out.println(i);
        return i;
      });
    });
  }
  System.out.printf("elapsed time:%d ms", System.currentTimeMillis() - l);
}

这里的 10 万个线程对应着 10 万个内核线程,这种通过大量的线程来提高系统性能是不现实的,因为内核线程成本高昂,不仅会占用大量资源来处理上下文切换,而且可用数量也很受限,一个线程大约消耗 1M~2M 的内存,当系统资源不足时就会报错:

$ java ThreadDemo.java
Exception in thread "pool-2-thread-427" java.lang.OutOfMemoryError: Java heap space
  at java.base/java.util.concurrent.SynchronousQueue$TransferStack.snode(SynchronousQueue.java:328)
  at java.base/java.util.concurrent.SynchronousQueue$TransferStack.transfer(SynchronousQueue.java:371)
  at java.base/java.util.concurrent.SynchronousQueue.poll(SynchronousQueue.java:903)
  at java.base/java.util.concurrent.ThreadPoolExecutor.getTask(ThreadPoolExecutor.java:1069)
  at java.base/java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1130)
  at java.base/java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:642)
  at java.base/java.lang.Thread.runWith(Thread.java:1596)
  at java.base/java.lang.Thread.run(Thread.java:1583)

于是人们又发明了各种线程池技术,最大程度地提高线程的复用性。下面我们使用一个固定大小为 200 的线程池来解决线程过多时报错的问题:

private static void testThreadPool() {
  long l = System.currentTimeMillis();
  try(var executor = Executors.newFixedThreadPool(200)) {
    IntStream.range(0, 100000).forEach(i -> {
      executor.submit(() -> {
        Thread.sleep(Duration.ofSeconds(1));
        // System.out.println(i);
        return i;
      });
    });
  }
  System.out.printf("elapsed time:%d ms", System.currentTimeMillis() - l);
}

在使用固定大小的线程池后,不会出现创建大量线程导致报错的问题,任务可以正常完成。但是这里的线程池却成了我们应用程序最大的性能瓶颈,程序运行花费了 50 秒的时间:

$ java ThreadDemo.java
elapsed time:50863 ms

按理说每个线程耗时 1 秒,无论是多少个线程并发,总耗时应该都是 1 秒,很显然这里并没有发挥出硬件应有的性能。

为了充分利用硬件,研究人员转而采用线程共享的方式,它的核心想法是这样的:我们并不需要在一个线程上从头到尾地处理一个请求,当执行到等待 I/O 操作时,可以将这个请求缓存到池中,以便线程可以处理其他请求,当 I/O 操作结束后会收到一个回调通知,再将请求从池中取出继续处理。这种细粒度的线程共享允许在高并发操作时不消耗大量线程,从而消除内核线程稀缺而导致的性能瓶颈。

这种方式使用了一种被称为 异步编程(Asynchronous Programming) 的风格,通过所谓的 响应式框架(Reactive Frameworks) 来实现,比如著名的 Reactor 项目一直致力于通过响应式编程来提高 Java 性能。但是这种风格的代码难以理解、难以调试、难以使用,普通开发人员只能对其敬而远之,只有高阶开发人员才能玩得转,所以并没有得到普及。

所以 Java 一直在寻找一种既能有异步编程的性能,又能编写起来简单的方案,最终虚拟线程诞生。

虚拟线程由 Loom 项目提出,最初被称为 纤程(Fibers),类似于 协程(Coroutine) 的概念,它由 JVM 而不是操作系统进行调度,可以让大量的虚拟线程在较少数量的平台线程上运行。我们将上面的代码改成虚拟线程非常简单,只需要将 Executors.newFixedThreadPool(200) 改成 Executors.newVirtualThreadPerTaskExecutor() 即可:

private static void testVirtualThread() {
  long l = System.currentTimeMillis();
  try(var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    IntStream.range(0, 100000).forEach(i -> {
      executor.submit(() -> {
        Thread.sleep(Duration.ofSeconds(1));
        // System.out.println(i);
        return i;
      });
    });
  }
  System.out.printf("elapsed time:%d ms", System.currentTimeMillis() - l);
}

运行结果显示,虚拟线程使得程序的性能得到了非常显著的提升,10 万个线程全部运行只花费 1 秒多的时间:

$ java ThreadDemo.java
elapsed time:1592 ms

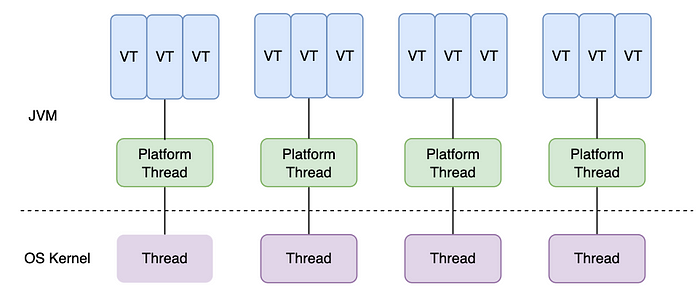
虚拟线程的数量可以远大于平台线程的数量,多个虚拟线程将由 JVM 调度在某个平台线程上执行,一个平台线程可以在不同的时间执行不同的虚拟线程,当虚拟线程被阻塞或等待时,平台线程可以切换到另一个虚拟线程执行。

虚拟线程、平台线程和系统内核线程的关系图如下所示:

virtual-threads.png

值得注意的是,虚拟线程适用于 I/O 密集型任务,不适用于计算密集型任务,因为计算密集型任务始终需要 CPU 资源作为支持。如果测试程序中的任务不是等待 1 秒钟,而是执行一秒钟的计算(比如对一个巨大的数组进行排序),那么程序不会有明显的性能提升。因为虚拟线程不是更快的线程,它们运行代码的速度与平台线程相比并无优势。虚拟线程的存在是为了提供更高的吞吐量,而不是速度(更低的延迟)。

创建虚拟线程

为了降低虚拟线程的使用门槛,官方尽力复用原有的 java.lang.Thread 线程类,让我们的代码可以平滑地过渡到虚拟线程的使用。下面列举几种创建虚拟线程的方式:

通过 Thread.startVirtualThread() 创建

Thread.startVirtualThread(() -> {
  System.out.println("Hello");
});

使用 Thread.ofVirtual() 创建

Thread.ofVirtual().start(() -> {
  System.out.println("Hello");
});

上面的代码通过 start() 直接启动虚拟线程,也可以通过 unstarted() 创建一个未启动的虚拟线程,再在合适的时机启动:

Thread thread = Thread.ofVirtual().unstarted(() -> {
  System.out.println("Hello");
});
thread.start();

和 Thread.ofVirtual() 对应的是 Thread.ofPlatform(),用于创建平台线程。

通过 ThreadFactory 创建

ThreadFactory factory = Thread.ofVirtual().factory();
Thread thread = factory.newThread(() -> {
  System.out.println("Hello");
});
thread.start();

通过 Executors.newVirtualThreadPerTaskExecutor() 创建

try(var executor = Executors.newVirtualThreadPerTaskExecutor()) {
  executor.submit(() -> {
    System.out.println("Hello");
  });
}

这种方式和传统的创建线程池非常相似,只需要改一行代码就可以把之前的线程池切换到虚拟线程。

很有意思的一点是,这里我们并没有指定虚拟线程的数量,这是因为虚拟线程非常廉价非常轻量,使用后立即就被销毁了,所以根本不需要被重用或池化。

正是由于虚拟线程非常轻量,我们可以在单个平台线程中创建成百上千个虚拟线程,它们通过暂停和恢复来实现线程之间的切换,避免了上下文切换的额外耗费,兼顾了多线程的优点,简化了高并发程序的复杂,可以有效减少编写、维护和观察高吞吐量并发应用程序的工作量。

调试虚拟线程

JDK 长期以来一直提供调试、分析和监控线程的机制,这些机制对于故障排查、维护和优化是必不可少的,JDK 提供了很多工具来实现这点,这些工具现在对虚拟线程也提供了同样的支持。

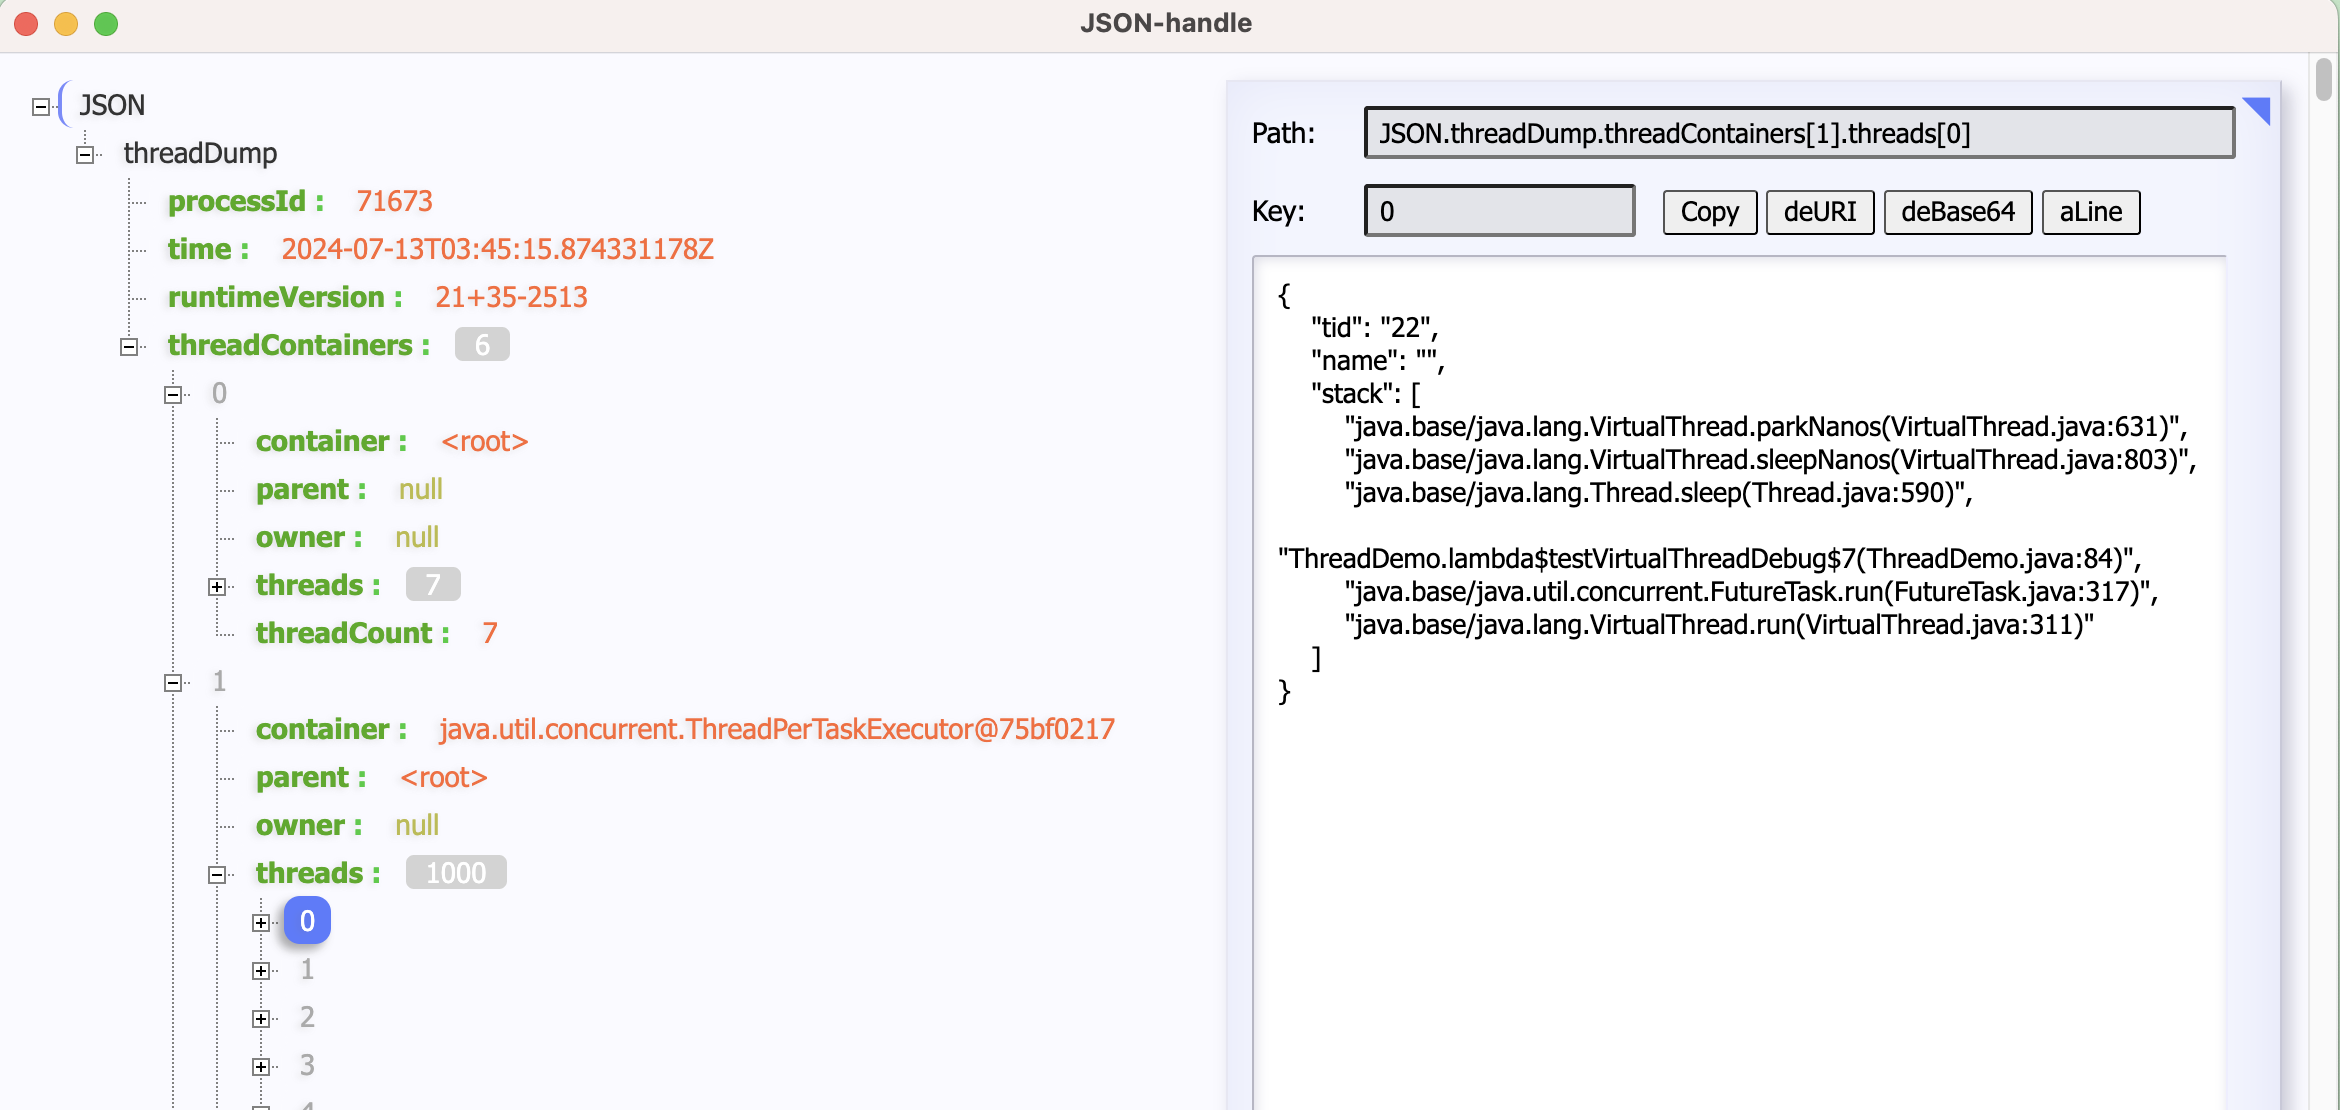
比如 jstack 或 jcmd 是流行的线程转储工具,它们可以打印出应用程序的所有线程,这种扁平的列表结构对于几十或几百个平台线程来说还可以,但对于成千上万的虚拟线程来说已经不适合了,于是在 jcmd 中引入了一种新的线程转储方式,以 JSON 格式将虚拟线程与平台线程一起打印:

$ jcmd <pid> Thread.dump_to_file -format=json <file>

以下是这样的线程转储的示例:

virtual-threads-dump.png

小结

今天我们学习了 Java 21 中最令人期待的特性之一:虚拟线程(Virtual Thread),这是 Loom 项目从预览到正式发布的重要里程碑。

虚拟线程由 JVM 而非操作系统调度,可以让大量的虚拟线程在较少的平台线程上运行。这种设计使得我们可以创建成百上千甚至百万个虚拟线程而无需担心资源耗尽,虚拟线程之间通过暂停和恢复来实现切换,避免了传统线程上下文切换带来的额外开销。

虚拟线程特别适合 I/O 密集型的应用程序,对于网络服务、数据库连接、文件读写等涉及 I/O 操作的场景,虚拟线程能够带来显著的性能提升。然而需要注意的是,虚拟线程并不能提升 CPU 密集型任务的处理能力,因为其本质上并不是更快的线程,而是通过更高效的线程调度来提高吞吐量。

虚拟线程的推出标志着 Java 在并发编程领域的一次重大进步,它有望改变 Java 应用程序的构建方式,使得开发者能够更加轻松地编写高吞吐量、易于维护的并发应用程序。随着生态中越来越多的框架和库对虚拟线程的支持,相信虚拟线程会逐步成为 Java 并发编程的首选方案。


重温 Java 21 之未命名模式和变量

未命名模式和变量也是一个预览特性,其主要目的是为了提高代码的可读性和可维护性。

在 Java 代码中,我们偶尔会遇到一些不需要使用的变量,比如下面这个例子中的异常 e:

try { 
  int i = Integer.parseInt(s);
  System.out.println("Good number: " + i);
} catch (NumberFormatException e) { 
  System.out.println("Bad number: " + s);
}

这时我们就可以使用这个特性,使用下划线 _ 来表示不需要使用的变量:

try { 
  int i = Integer.parseInt(s);
  System.out.println("Good number: " + i);
} catch (NumberFormatException _) { 
  System.out.println("Bad number: " + s);
}

上面这个这被称为 未命名变量(Unnamed Variables)。

顾名思义,未命名模式和变量包含两个方面:未命名模式(Unnamed Patterns) 和 未命名变量(Unnamed Variables)。

未命名模式(Unnamed Patterns)

在上一篇笔记中,我们学习了什么是 记录模式(Record Pattern) 以及 instanceof 和 switch 两种模式匹配。未命名模式允许在模式匹配中省略掉记录组件的类型和名称。下面的代码展示了如何在 instanceof 模式匹配中使用未命名模式这个特性:

if (obj instanceof Person(String name, _)) {
  System.out.println("Name: " + name);
}

其中 Person 记录的第二个参数 Integer age 在后续的代码中没用到,于是用下划线 _ 把类型和名称都代替掉。我们也可以只代替 age 名称,这被称为 未命名模式变量(Unnamed Pattern Variables):

if (obj instanceof Person(String name, Integer _)) {
  System.out.println("Name: " + name);
}

这个特性也可以在 switch 模式匹配中使用:

switch (b) {
  case Box(RedBall _), Box(BlueBall _) -> processBox(b);
  case Box(GreenBall _)                -> stopProcessing();
  case Box(_)                          -> pickAnotherBox();
}

这里前两个 case 是未命名模式变量,最后一个 case 是未命名模式。

未命名变量(Unnamed Variables)

未命名变量的使用场景更加丰富,除了上面在 catch 子句中使用的例子外,下面列举了一些其他的典型场景。

在 for 循环中使用:

int acc = 0;
for (Order _ : orders) {
  if (acc < LIMIT) { 
    ... acc++ ...
  }
}

在赋值语句中使用:

Queue<Integer> q = ... // x1, y1, z1, x2, y2, z2, ...
while (q.size() >= 3) {
  var x = q.remove();
  var y = q.remove();
  var _ = q.remove();
  ... new Point(x, y) ...
}

在 try-with-resource 语句中使用:

try (var _ = ScopedContext.acquire()) {
  // No use of acquired resource
}

在 lambda 表达式中使用:

stream.collect(
  Collectors.toMap(String::toUpperCase, _ -> "NODATA")
)

未命名类和实例 Main 方法(预览版本)

除了未命名模式和变量,Java 21 还引入了一个 未命名类和实例 Main 方法 预览特性。相信所有学过 Java 的人对下面这几行代码都非常熟悉吧:

public class Hello {
  public static void main(String[] args) {
    System.out.println("Hello");
  }
}

通常我们初学 Java 的时候,都会写出类似这样的 Hello World 程序,不过作为初学者的入门示例,这段代码相比其他语言来说显得过于臃肿了,给初学者的感觉就是 Java 太复杂了,因为这里掺杂了太多只有在开发大型应用的时候才会涉及到的概念:

  • 首先 public class Hello 这行代码涉及了类的声明和访问修饰符,这些概念可以用于数据隐藏、重用、访问控制、模块化等,在大型复杂应用程序中很有用;但是对于一个初学者,往往是从变量、控制流和子程序的基本编程概念开始学习的,在这个小例子中,它们毫无意义;
  • 其次,main() 函数的 String[] args 这个参数主要用于接收从命令行传入的参数,但是对于一个初学者来说,在这里它显得非常神秘,因为它在代码中从未被使用过;
  • 最后,main() 函数前面的 static 修饰符是 Java 类和对象模型的一部分,这个概念这对初学者也很不友好,甚至是有害的,因为如果要在代码中添加一个新的方法或字段时,为了访问它们,我们必须将它们全部声明成 static 的,这是一种既不常见也不是好习惯的用法,要么就要学习如何实例化对象。

为了让初学者可以快速上手,Java 21 引入了未命名类和实例 Main 方法这个特性,这个特性包含两个部分:

  1. 增强了 Java 程序的 启动协议(the launch protocol),使得 main 方法可以没有访问修饰符、没有 static 修饰符和没有 String[] 参数:
class Hello { 
  void main() { 
    System.out.println("Hello");
  }
}

这样的 main 方法被称为 实例 Main 方法(instance main methods)。

  1. 实现了 未命名类(unnamed class) 特性,使我们可以不用声明类,进一步简化上面的代码:
void main() {
  System.out.println("Hello");
}

在 Java 语言中,每个类都位于一个包中,每个包都位于一个模块中。而一个未命名的类位于未命名的包中,未命名的包位于未命名的模块中。

小结

今天我们学习了 Java 21 中的 未命名模式和变量 以及 未命名类和实例 Main 方法 两个特性:

  • 未命名模式和变量 通过使用下划线 _ 来表示那些不需要使用的模式变量和普通变量,消除了编译器对未使用变量的警告,使得代码意图更加明确;
  • 未命名类和实例 Main 方法 这个特性则着眼于降低 Java 的学习曲线,通过简化程序的启动协议,使得初学者可以无需掌握访问修饰符、static 修饰符、类的概念等高级特性,就能快速编写简单的 Java 程序;

这两个特性的引入虽然看似微不足道,但都体现了 Java 语言设计者的用心,他们在保持语言强大功能的同时,也在努力让 Java 变得更加易于上手。


重温 Java 21 之外部函数和内存 API

外部函数和内存 API(Foreign Function & Memory API,简称 FFM API) 是 Java 17 中首次引入的一个重要特性,经过了 JEP 412 和 JEP 419 两个孵化版本,以及 JEP 424 和 JEP 434 两个预览版本,在 Java 21 中,这已经是第三个预览版本了。

在 Java 22 中,这个特性终于退出了预览版本。

近年来,随着人工智能、数据科学、图像处理等领域的发展,我们在越来越多的场景下接触到原生代码:

  • Off-CPU Computing (CUDA, OpenCL)
  • Deep Learning (Blas, cuBlas, cuDNN, Tensorflow)
  • Graphics Processing (OpenGL, Vulkan, DirectX)
  • Others (CRIU, fuse, io_uring, OpenSSL, V8, ucx, ...)

这些代码不太可能用 Java 重写,也没有必要,Java 急需一种能与本地库进行交互的方案,这就是 FFM API 诞生的背景。FFM API 最初作为 Panama 项目 中的核心组件,旨在改善 Java 与本地代码的互操作性。FFM API 是 Java 现代化进程中的一个重要里程碑,标志着 Java 在与本地代码互操作性方面迈出了重要一步,它的引入也为 Java 在人工智能、数据科学等领域的应用提供了更多的可能性,有望加速 Java 在这些领域的发展和应用。

FFM API 由两大部分组成:外部函数接口(Foreign Function Interface,简称 FFI) 和 内存 API(Memory API),FFI 用于实现 Java 代码和外部代码之间的相互操作,而 Memory API 则用于安全地管理堆外内存。

使用 JNI 调用外部函数

在引入外部函数之前,如果想要实现 Java 调用外部函数库,我们需要借助 JNI (Java Native Interface) 来实现。下面的代码是一个使用 JNI 调用外部函数的例子:

public class JNIDemo {
    static {
        System.loadLibrary("JNIDemo");
    }

    public static void main(String[] args) {
        new JNIDemo().sayHello();
    }

    private native void sayHello();
}

其中 sayHello 函数使用了 native 修饰符,表明这是一个本地方法,该方法的实现不在 Java 代码中。这个本地方法可以使用 C 语言来实现,我们首先需要生成这个本地方法对应的 C 语言头文件:

$ javac -h . JNIDemo.java

javac 命令不仅可以将 .java 文件编译成 .class 字节码文件,而且还可以生成本地方法的头文件,参数 -h . 表示将头文件生成到当前目录。这个命令执行成功后,当前目录应该会生成 JNIDemo.class 和 JNIDemo.h 两个文件,JNIDemo.h 文件内容如下:

/* DO NOT EDIT THIS FILE - it is machine generated */
#include <jni.h>
/* Header for class JNIDemo */

#ifndef _Included_JNIDemo
#define _Included_JNIDemo
#ifdef __cplusplus
extern "C" {
#endif
/*
 * Class:     JNIDemo
 * Method:    sayHello
 * Signature: ()V
 */
JNIEXPORT void JNICALL Java_JNIDemo_sayHello
  (JNIEnv *, jobject);

#ifdef __cplusplus
}
#endif
#endif

正如我们所看到的,在这个头文件中定义了一个名为 Java_JNIDemo_sayHello 的函数,这个名称是根据包名、类名和方法名自动生成的。有了这个自动生成的头文件,我们就可以在 C 语言里实现这个这个方法了,于是接着创建一个 JNIDemo.c 文件,编写代码:

#include "jni.h"
#include "JNIDemo.h"
#include <stdio.h>

JNIEXPORT void JNICALL Java_JNIDemo_sayHello(JNIEnv *env, jobject jobj) {
    printf("Hello World!\n");
}

这段代码很简单,直接调用标准库中的 printf 输出 Hello World!。

然后使用 gcc 将这个 C 文件编译成动态链接库:

$ gcc -I${JAVA_HOME}/include -I${JAVA_HOME}/include/darwin -dynamiclib JNIDemo.c -o libJNIDemo.dylib

这个命令会在当前目录下生成一个名为 libJNIDemo.dylib 的动态链接库文件,这个库文件正是我们在 Java 代码中通过 System.loadLibrary("JNIDemo") 加载的库文件。

注意这里我用的是 Mac 操作系统,动态链接库的名称必须以 lib 为前缀,以 .dylib 为扩展名,其他操作系统的命令略有区别。

Linux 系统:

$ gcc -I${JAVA_HOME}/include -I${JAVA_HOME}/include/linux -shared JNIDemo.c -o libJNIDemo.so

Windows 系统:

$ gcc -I${JAVA_HOME}/include -I${JAVA_HOME}/include/win32 -shared JNIDemo.c -o JNIDemo.dll

至此,我们就可以运行这个 Hello World 的本地实现了:

$ java -cp . -Djava.library.path=. JNIDemo

以上步骤演示了如何使用 JNI 调用外部函数,这只是 JNI 的一个简单示例,更多 JNI 的高级功能,比如实现带参数的函数,在 C 代码中访问 Java 对象或方法等,可以参考 Baeldung 的这篇教程。

外部函数接口(Foreign Function Interface)

从上面的过程可以看出,JNI 的使用非常繁琐,一个简单的 Hello World 都要费好大劲:首先要在 Java 代码中定义 native 方法,然后从 Java 代码派生 C 头文件,最后还要使用 C 语言对其进行实现。Java 开发人员必须跨多个工具链工作,当本地库快速演变时,这个工作就会变得尤为枯燥乏味。

除此之外,JNI 还有几个更为严重的问题:

  • Java 语言最大的特性是跨平台,所谓 一次编译,到处运行,但是使用本地接口需要涉及 C 语言的编译和链接,这是平台相关的,所以丧失了 Java 语言的跨平台特性;
  • JNI 桩代码非常难以编写和维护,首先,JNI 在类型处理上很糟糕,由于 Java 和 C 的类型系统不一致,比如聚合数据在 Java 中用对象表示,而在 C 中用结构体表示,因此,任何传递给 native 方法的 Java 对象都必须由本地代码费力地解包;另外,假设某个本地库包含 1000 个函数,那么意味着我们要生成 1000 个对应的 JNI 桩代码,这么大量的 JNI 桩代码非常难以维护;
  • 由于本地代码不受 JVM 的安全机制管理,所以 JNI 本质上是不安全的,它在使用上非常危险和脆弱,JNI 错误可能导致 JVM 的崩溃;
  • JNI 的性能也不行,一方面是由于 JNI 方法调用不能从 JIT 优化中受益,另一方面是由于通过 JNI 传递 Java 对象很慢;这就导致开发人员更愿意使用 Unsafe API 来分配堆外内存,并将其地址传递给 native 方法,这使得 Java 代码非常不安全!

多年来,已经出现了许多框架来解决 JNI 遗留下来的问题,包括 JNA、JNR 和 JavaCPP。这些框架通常比 JNI 有显著改进,但情况仍然不尽理想,尤其是与提供一流本地互操作性的语言相比。例如,Python 的 ctypes 包可以动态地包装本地库中的函数,而无需任何胶水代码,Rust 则提供了从 C/C++ 头文件自动生成本地包装器的工具。

FFI 综合参考了其他语言的实现,试图更加优雅地解决这些问题,它实现了对外部函数库的原生接口,提供了一种更高效更安全的方式来访问本地内存和函数,从而取代了传统的 JNI。

下面的代码是使用 FFI 实现和上面相同的 Hello World 的例子:

public class FFIDemo {
    public static void main(String[] args) throws Throwable {
        Linker linker = Linker.nativeLinker();
        SymbolLookup symbolLookup = linker.defaultLookup();
        MethodHandle printf = linker.downcallHandle(
            symbolLookup.find("printf").orElseThrow(), 
            FunctionDescriptor.of(ValueLayout.JAVA_LONG, ValueLayout.ADDRESS)
        );
        try (Arena arena = Arena.ofConfined()) {
            MemorySegment hello = arena.allocateUtf8String("Hello World!\n");
            printf.invoke(hello);
        }
    }
}

注意,Java 22 中取消了 Arena::allocateUtf8String() 方法,改成了 Arena::allocateFrom() 方法。

相比于 JNI 的实现,FFI 的代码要简洁优雅得多。这里的代码涉及三个 FFI 中的重要接口:

  • Linker
  • SymbolLookup
  • FunctionDescriptor

其中 SymbolLookup 用于从已加载的本地库中查找外部函数的地址,Linker 用于链接 Java 代码与外部函数,它同时支持下行调用(从 Java 代码调用本地代码)和上行调用(从本地代码返回到 Java 代码),FunctionDescriptor 用于描述外部函数的返回类型和参数类型,这些类型在 FFM API 中可以由 MemoryLayout 对象描述,例如 ValueLayout 表示值类型,GroupLayout 表示结构类型。

通过 FFI 提供的接口,我们可以生成对应外部函数的方法句柄(MethodHandle),方法句柄是 Java 7 引入的一个抽象概念,可以实现对方法的动态调用,它提供了比反射更高的性能和更灵活的使用方式,这里复用了方法句柄的概念,通过方法句柄的 invoke() 方法就可以实现外部函数的调用。

这里我们不再需要编写 C 代码,也不再需要编译链接生成动态库,所以,也就不存在平台相关的问题了。另一方面,FFI 接口的设计大多数情况下是安全的,由于都是 Java 代码,因此也受到 Java 安全机制的约束,虽然也有一部分接口是不安全的,但是比 JNI 来说要好多了。

OpenJDK 还提供了一个 jextract 工具,用于从本地库自动生成 Java 代码,有兴趣的同学可以尝试一下。

使用 ByteBuffer 和 Unsafe 访问堆外内存

上面说过,FFM API 的另一个主要部分是 内存 API(Memory API),用于安全地管理堆外内存。其实在 FFIDemo 的示例中我们已经见到内存 API 了,其中 printf 打印的 Hello World!\n 字符串,就是通过 Arena 这个内存 API 分配的。

但是在学习内存 API 之前,我们先来复习下 Java 在之前的版本中是如何处理堆外内存的。

内存的使用往往和程序性能挂钩,很多像 TensorFlow、Ignite、Netty 这样的类库,都对性能有很高的要求,为了避免垃圾收集器不可预测的行为以及额外的性能开销,这些类库一般倾向于使用 JVM 之外的内存来存储和管理数据,这就是我们常说的 堆外内存(off-heap memory)。

使用堆外内存有两个明显的好处:

  • 使用堆外内存,也就意味着堆内内存较小,从而可以减少垃圾回收次数,以及垃圾回收停顿对于应用的影响;
  • 在 I/O 通信过程中,通常会存在堆内内存和堆外内存之间的数据拷贝操作,频繁的内存拷贝是性能的主要障碍之一,为了极致的性能,一份数据应该只占一份内存空间,这就是所谓的 零拷贝,直接使用堆外内存可以提升程序 I/O 操作的性能。

ByteBuffer 是访问堆外内存最常用的方法:

private static void testDirect() {
    ByteBuffer bb = ByteBuffer.allocateDirect(10);
    bb.putInt(0);
    bb.putInt(1);
    bb.put((byte)0);
    bb.put((byte)1);

    bb.flip();

    System.out.println(bb.getInt());
    System.out.println(bb.getInt());
    System.out.println(bb.get());
    System.out.println(bb.get());
}

上面的代码使用 ByteBuffer.allocateDirect(10) 分配了 10 个字节的直接内存,然后通过 put 写内存,通过 get 读内存。

可以注意到这里的 int 是 4 个字节,byte 是 1 个字节,当写完 2 个 int 和 2 个 byte 后,如果再继续写,就会报 java.nio.BufferOverflowException 异常。

另外还有一点值得注意,我们并没有手动释放内存。虽然这个内存是直接从操作系统分配的,不受 JVM 的控制,但是创建 DirectByteBuffer 对象的同时也会创建一个 Cleaner 对象,它用于跟踪对象的垃圾回收,当 DirectByteBuffer 被垃圾回收时,分配的堆外内存也会一起被释放,所以我们不用手动释放内存。

ByteBuffer 是异步编程和非阻塞编程的核心类,从 java.nio.ByteBuffer 这个包名就可以看出这个类是为 NIO 而设计,可以说,几乎所有的 Java 异步模式或者非阻塞模式的代码,都要直接或者间接地使用 ByteBuffer 来管理数据。尽管如此,这个类仍然存在着一些无法摆脱的限制:

  • 首先,它不支持手动释放内存,ByteBuffer 对应内存的释放,完全依赖于 JVM 的垃圾回收机制,这对于一些像 Netty 这样追求极致性能的类库来说并不满足,这些类库往往需要对内存进行精确的控制;
  • 其次,ByteBuffer 使用了 Java 的整数来表示存储空间的大小,这就导致,它的存储空间最多只有 2G;在网络编程的环境下,这可能并不是一个问题,但是在处理超过 2G 的文件时就不行了,而且像 Memcahed 这样的分布式缓存系统,内存 2G 的限制明显是不够的。

为了突破这些限制,有些类库选择了访问堆外内存的另一条路,使用 sun.misc.Unsafe 类。这个类提供了一些低级别不安全的方法,可以直接访问系统内存资源,自主管理内存资源:

private static void testUnsafe() throws Exception {
    Field f = Unsafe.class.getDeclaredField("theUnsafe");
    f.setAccessible(true);
    Unsafe unsafe = (Unsafe) f.get(null);
    
    long address = unsafe.allocateMemory(10);
    unsafe.putInt(address, 0);
    unsafe.putInt(address+4, 1);
    unsafe.putByte(address+8, (byte)0);
    unsafe.putByte(address+9, (byte)1);
    System.out.println(unsafe.getInt(address));
    System.out.println(unsafe.getInt(address+4));
    System.out.println(unsafe.getByte(address+8));
    System.out.println(unsafe.getByte(address+9));
    unsafe.freeMemory(address);
}

Unsafe 的使用方法和 ByteBuffer 很像,我们使用 unsafe.allocateMemory(10) 分配了 10 个字节的直接内存,然后通过 put 写内存,通过 get 读内存,区别在于我们要手动调整内存地址。

使用 Unsafe 操作内存就像是使用 C 语言中的指针一样,效率虽然提高了不少,但是很显然,它增加了 Java 语言的不安全性,因为它实际上可以访问到任意位置的内存,不正确使用 Unsafe 类会使得程序出错的概率变大。

注意,默认情况下,我们无法直接使用 Unsafe 类,直接使用的话会报下面这样的 SecurityException 异常:

Exception in thread "main" java.lang.SecurityException: Unsafe
        at jdk.unsupported/sun.misc.Unsafe.getUnsafe(Unsafe.java:99)
        at ByteBufferDemo.testUnsafe(ByteBufferDemo.java:33)
        at ByteBufferDemo.main(ByteBufferDemo.java:10)

所以上面的代码通过反射的手段,使得我们可以使用 Unsafe。

说了这么多,总结一句话就是:ByteBuffer 安全但效率低,Unsafe 效率高但是不安全。此时,就轮到 内存 API 出场了。

内存 API(Memory API)

内存 API 基于前人的经验,使用了全新的接口设计,它的基本使用如下:

private static void testAllocate() {
    try (Arena offHeap = Arena.ofConfined()) {
        MemorySegment address = offHeap.allocate(8);
        address.setAtIndex(ValueLayout.JAVA_INT, 0, 1);
        address.setAtIndex(ValueLayout.JAVA_INT, 1, 0);
        System.out.println(address.getAtIndex(ValueLayout.JAVA_INT, 0));
        System.out.println(address.getAtIndex(ValueLayout.JAVA_INT, 1));
    }
}

这段代码使用 Arena::allocate() 分配了 8 个字节的外部内存,然后写入两个整型数字,最后再读取出来。下面是另一个示例,写入再读取字符串:

private static void testAllocateString() {
    try (Arena offHeap = Arena.ofConfined()) {
        MemorySegment str = offHeap.allocateUtf8String("hello");
        System.out.println(str.getUtf8String(0));
    }
}

这段代码使用 Arena::allocateUtf8String() 根据字符串的长度动态地分配外部内存,然后通过 MemorySegment::getUtf8String() 将其复制到 JVM 栈上并输出。

这两段代码中的 Arena 和 MemorySegment 是内存 API 的关键,MemorySegment 用于表示一段内存片段,既可以是堆内内存也可以是堆外内存;Arena 定义了内存资源的生命周期管理机制,它实现了 AutoCloseable 接口,所以可以使用 try-with-resource 语句及时地释放它管理的内存。

Arena.ofConfined() 表示定义一块受限区域,只有一个线程可以访问在受限区域中分配的内存段。除此之外,我们还可以定义其他类型的区域:

  • Arena.global() - 全局区域,分配的区域永远不会释放,随时可以访问;
  • Arena.ofAuto() - 自动区域,由垃圾收集器自动检测并释放;
  • Arena.ofShared() - 共享区域,可以被多个线程同时访问;

Arena 接口的设计经过了多次调整,在最初的版本中被称为 ResourceScope,后来改成 MemorySession,再后来又拆成了 Arena 和 SegmentScope 两个类,现在基本上稳定使用 Arena 就可以了。

除 Arena 接口,内存 API 还包括了下面这些接口,主要可以分为两大类:

  • Arena、MemorySegment、SegmentAllocator - 这几个接口用于控制外部内存的分配和释放
  • MemoryLayout、VarHandle - 这几个接口用于操作和访问结构化的外部内存

内存 API 试图简化 Java 代码操作堆外内存的难度,通过它可以实现更高效的内存访问方式,同时可以保障一定的安全性,特别适用于下面这些场景:

  • 大规模数据处理:在处理大规模数据集时,内存 API 的直接内存访问能力将显著提高程序的执行效率;
  • 高性能计算:对于需要频繁进行数值计算的任务,内存 API 可以减少对象访问的开销,从而实现更高的计算性能;
  • 与本地代码交互:内存 API 的使用可以使得 Java 代码更方便地与本地代码进行交互,结合外部函数接口,可以实现更灵活的数据传输和处理。

相信等内存 API 正式发布之后,之前使用 ByteBuffer 或 Unsafe 的很多类库估计都会考虑切换成使用内存 API 来获取性能的提升。

小结

今天我们学习了 外部函数和内存 API(Foreign Function & Memory API) 这一重要特性,它在 Java 17 开始引入,经过多个版本的迭代,在 Java 21 中是第三个预览版本,并在 Java 22 中正式发布。

FFM API 由两个部分组成:

  1. 外部函数接口(FFI) - 提供了一种比 JNI 更加优雅、安全和高效的方式来调用本地代码,消除了繁琐的 JNI 桩代码编写,使得 Java 与本地库的交互更加直观和类型安全;相比 JNI 的种种限制(跨平台性差、难以维护、性能低下),FFI 通过方法句柄动态生成对应的本地函数调用,既保证了 Java 的跨平台特性,又提供了更好的安全性和性能;
  2. 内存 API - 提供了一套统一的、安全的、高效的堆外内存管理方案,它汲取了 ByteBuffer 的安全性优势和 Unsafe 的高性能优点,同时避免了两者的缺陷,通过 Arena 的生命周期管理和 MemorySegment 的内存访问抽象,实现了既安全又高效的堆外内存操作;

FFM API 的推出为 Java 打开了与本地代码交互的新大门,为 Java 在人工智能、数据科学、图像处理等需要调用本地库的领域提供了强有力的支持,有望加速 Java 在这些领域的发展和应用。随着 Java 生态中越来越多的高性能库(如 TensorFlow、CUDA 等)的本地绑定逐步迁移到 FFM API,Java 开发者将能够更加便捷地利用这些强大的库来构建高性能应用。